


Python数据分析标准流程:从数据获取到可视化的五个关键步骤
详细拆解Python数据分析的标准执行流程,从数据获取、数据清洗、探索性分析、指标计算到数据可视化呈现五个核心步骤,提供可复用的工程代码与实战注意事项。
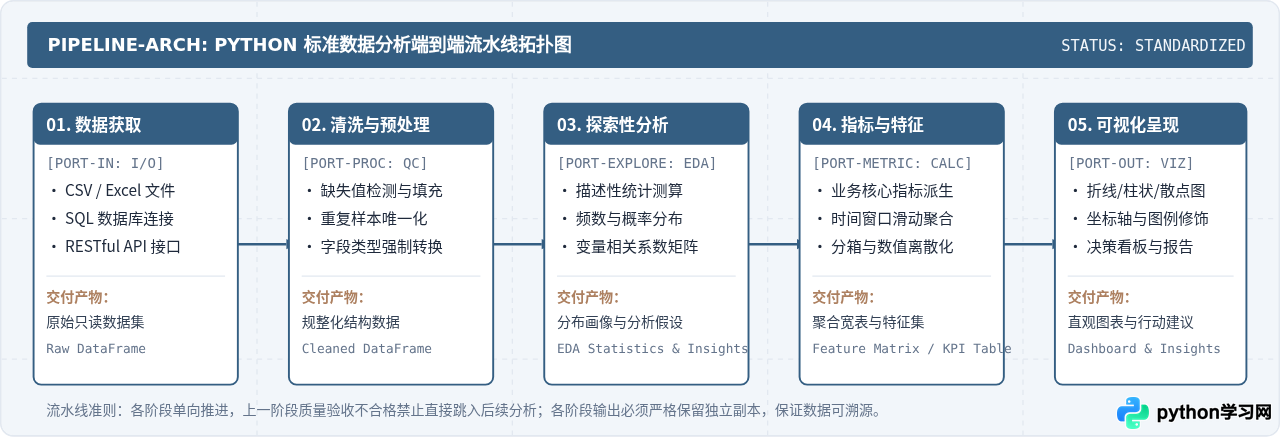
第一步:数据获取与载入(Data Acquisition)
数据获取是整个分析流程的起点。该阶段的核心目标是从不同的持久化存储介质或网络接口中读取数据,并在内存中构建具备统一行列索引的 pandas.DataFrame。
实际工程中,数据通常来源于本地文件系统(CSV、Excel、Parquet)、关系型数据库(MySQL、PostgreSQL)或远程服务端提供的 RESTful 接口。在调用读取函数时,必须明确指定字符编码(如 utf-8 或 gbk)、缺失值标识符以及分块载入策略,避免因隐式默认参数导致截断或乱码。
import pandas as pd
from sqlalchemy import create_engine

# 1. 读取本地 CSV 文件(指定编码与关键参数)
df_csv = pd.read_csv(
    'orders_2026.csv',
    encoding='utf-8',
    parse_dates=['order_time'],
    na_values=['NA', 'null', '']
)

# 2. 从关系型数据库执行参数化 SQL 读取
engine = create_engine('mysql+pymysql://reader:pwd@10.0.1.5:3306/analytics_db')
sql_query = """
    SELECT user_id, order_id, total_amount, status, created_at
    FROM order_master
    WHERE created_at >= '2026-01-01'
"""
df_sql = pd.read_sql(sql_query, con=engine)

# 3. 初始结构检验(严禁遗漏的固定自检)
print(f"载入样本量:{df_csv.shape[0]} 行,{df_csv.shape[1]} 列")
print(df_csv.info())pd.read_csv(),否则可能导致单机内存溢出(OOM)。建议使用 chunksize 参数进行流式分批读取,或者在入库前先转换为列式存储格式 Parquet,既能提升读取效率,又能显著压缩内存占用。
第二步:数据清洗与预处理(Data Cleaning & Preprocessing)
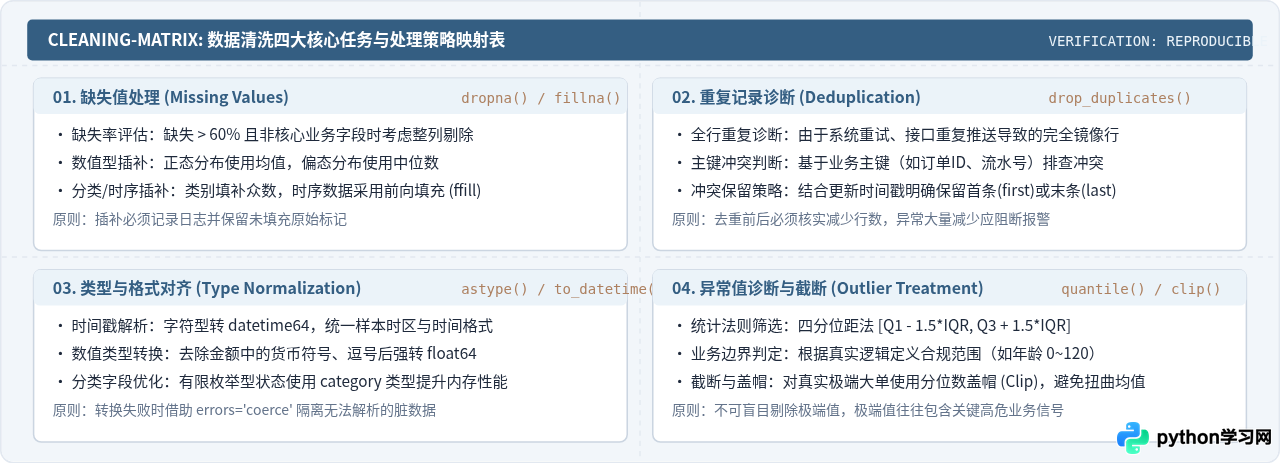
现实业务产生的数据通常充斥着“脏数据”:字段缺失、主键重复、数据类型错误以及异常偏离极大值。未经清洗的数据直接进入分析或建模环节,会得出完全偏离实际的荒谬结论,即经典的“垃圾进,垃圾出”(Garbage in, Garbage out)。
清洗步骤应按严格逻辑展开:首先核验主键与关键维度的唯一性,剔除冗余重复记录;其次统计评估缺失值比例,根据业务含义决定删除或插补;接着进行类型强转,确保数值参与数学计算、时间支持时序切片;最后通过统计分布(如四分位距 IQR)诊断并规范异常值。
# 1. 重复项核验与去除
initial_rows = len(df_csv)
df_clean = df_csv.drop_duplicates(subset=['order_id'], keep='last').copy()
print(f"剔除重复订单数:{initial_rows - len(df_clean)}")

# 2. 缺失值诊断与针对性填补
# 查看各字段缺失百分比
missing_rate = df_clean.isnull().mean() * 100
print("缺失率统计(%):\n", missing_rate)

# 对金额字段使用中位数填充,并新增指示变量标记填充行
median_amount = df_clean['total_amount'].median()
df_clean['amount_imputed'] = df_clean['total_amount'].isnull().astype(int)
df_clean['total_amount'] = df_clean['total_amount'].fillna(median_amount)

# 剔除下单时间缺失的关键行(核心时间无法推断)
df_clean = df_clean.dropna(subset=['order_time'])

# 3. 字段类型显式转换
df_clean['order_time'] = pd.to_datetime(df_clean['order_time'])
df_clean['status'] = df_clean['status'].astype('category')

# 4. 异常值检测与盖帽处理(IQR 法)
Q1 = df_clean['total_amount'].quantile(0.25)
Q3 = df_clean['total_amount'].quantile(0.75)
IQR = Q3 - Q1
upper_bound = Q3 + 3.0 * IQR  # 采用较宽松的 3 倍 IQR 识别极端离群值

# 对超出上限的极大值实施盖帽截断
df_clean['total_amount_clipped'] = df_clean['total_amount'].clip(lower=0, upper=upper_bound)第三步:探索性数据分析(Exploratory Data Analysis, EDA)
探索性数据分析(EDA)是了解数据内部结构、检验业务常识、发现未知异常的核心环节。在清洗完毕后,绝不能急于套用高级模型或绘制花哨图表,而应系统性地从低维到高维逐步观察数据表现。
EDA 包含三个递进层次:
- 单变量分析:分别考察数值型字段的集中趋势(均值、中位数)、离散程度(标准差、分位数)与偏度;观察分类型字段的频数分布与头部集中度。
- 双变量交叉分析:研究数值与数值之间的线性相关性(如相关系数矩阵),或者分类变量与数值变量之间的组间差异(如不同用户等级的客单价分布)。
- 多维聚合透视:借助数据透视表(
pivot_table)与分组函数(groupby),在时间周期、地区、产品类目等多维度交叉切片下观察业务规律。
# 1. 单变量基础描述性统计
stats_summary = df_clean['total_amount'].describe(percentiles=[0.05, 0.25, 0.5, 0.75, 0.95])
print("金额描述统计:\n", stats_summary)

# 2. 状态分类统计(占比)
status_ratio = df_clean['status'].value_counts(normalize=True) * 100
print("\n订单状态分布率(%):\n", status_ratio)

# 3. 按星期与时段的多维透视分析(构建业务热力矩阵前置数据)
df_clean['weekday'] = df_clean['order_time'].dt.day_name()
df_clean['hour'] = df_clean['order_time'].dt.hour

pivot_result = pd.pivot_table(
    df_clean,
    values='total_amount',
    index='weekday',
    columns='status',
    aggfunc=['count', 'mean'],
    fill_value=0
)
print("\n透视表概览(前3行):\n", pivot_result.head(3))第四步:指标计算与特征提炼(Metrics & Feature Engineering)
原始数据通常只记录了最基础的原子事务(如某一笔订单产生的时间和金额),但业务决策真正关心的往往是更高维度的复合指标。第四步的任务是把原始字段加工为能够准确衡量业务表现的衡量指标或建模特征。
该步骤包含三类典型的工程操作:
- 业务复合指标计算:如客单价(总金额 / 总人数)、转化率(完成阶段数 / 初始阶段数)、客均购买频次等。
- 时序窗口特征衍生:利用
rolling()和shift()计算 7 日移动平均线、环比增长率、累计滚动金额,平滑周期波动。 - 离散分箱与类别标记:使用
pd.cut()或pd.qcut()将连续金额划分为不同档位(如低客单、中客单、高客单),将细颗粒度用户沉淀为可管理的客群画像。
# 1. 业务指标派生:提取日期维度
df_clean['order_date'] = df_clean['order_time'].dt.date

# 2. 按日聚合计算大盘核心 KPI
daily_kpi = df_clean.groupby('order_date').agg(
    total_gmv=('total_amount', 'sum'),
    order_count=('order_id', 'nunique'),
    active_users=('user_id', 'nunique')
).reset_index()

# 派生关键复合指标:日客单价 (AOV)
daily_kpi['aov'] = daily_kpi['total_gmv'] / daily_kpi['order_count']

# 3. 滑动窗口指标:计算 7 天移动平均成交额
daily_kpi['gmv_ma7'] = daily_kpi['total_gmv'].rolling(window=7, min_periods=1).mean()

# 4. 环比增长率计算(相比前 1 天)
daily_kpi['gmv_growth_rate'] = daily_kpi['total_gmv'].pct_change() * 100

print(daily_kpi.tail(4))第五步:数据可视化与结果呈现(Data Visualization & Reporting)
可视化是数据分析全流程的“最后一公里”。图表的核心任务不是追求绚丽的视觉效果,而是以最高的信噪比向读者或管理层传递准确的定量事实与分析结论。
优秀的分析可视化需遵循明确的选型与排版规则:
- 匹配图表形态与信息意图:展示连续时间趋势首选折线图;展示分类大小对比选用横向或纵向柱状图;探索两连续变量分布形态采用散点图;展示离散程度与异常值分布采用箱线图。
- 严禁视觉误导:对比柱状图的数值起始坐标轴必须从 0 开始,严禁截断 Y 轴以刻意夸大微弱差距;折线图比例应当保持协调,避免极端拉高 Y 轴造成波动虚高。
- 完备工程标注:所有图表必须明确标注图表标题、坐标轴名称、量纲单位(如万元、百分比)、图例说明以及关键极值的文本数据标签。
import matplotlib.pyplot as plt

# 样式环境设置
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 创建画布与子图布局
fig, ax1 = plt.subplots(figsize=(10, 4.8), dpi=100)

# 绘制主轴:每日 GMV 柱状图
color_bar = '#345E82'
ax1.bar(daily_kpi['order_date'], daily_kpi['total_gmv'], color=color_bar, alpha=0.7, label='单日 GMV (元)')
ax1.set_xlabel('日期', fontsize=11, labelpad=8)
ax1.set_ylabel('成交额 GMV (元)', color=color_bar, fontsize=11)
ax1.tick_params(axis='y', labelcolor=color_bar)
ax1.grid(axis='y', linestyle='--', alpha=0.3)

# 绘制次轴:客单价趋势折线图
ax2 = ax1.twinx()
color_line = '#AD8060'
ax2.plot(daily_kpi['order_date'], daily_kpi['aov'], color=color_line, marker='o', linewidth=2, label='客单价 AOV (元)')
ax2.set_ylabel('客单价 AOV (元)', color=color_line, fontsize=11)
ax2.tick_params(axis='y', labelcolor=color_line)

# 设置标题与图例
plt.title('2026年1月业务运行态势:大盘GMV与客单价双轴走势图', fontsize=13, pad=16, fontweight='bold')
fig.tight_layout()

# 保存高质量图表
plt.savefig('daily_business_trend.png', dpi=300, bbox_inches='tight')
plt.close()全流程质量验证与交付闭环
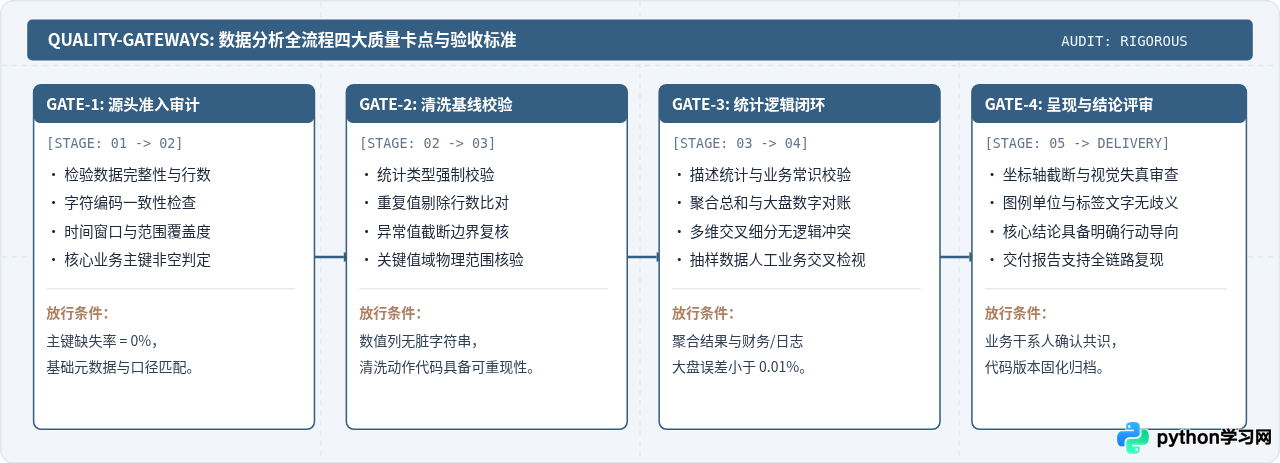
为了确保分析产物在团队协作或工程化运行中稳定可靠,标准流程通常在各节点之间建立“阶段质量把关点(Quality Gateways)”,构筑严密的闭环校验体系。
步骤总结与工程落地清单
梳理 Python 数据分析的五个关键步骤,其实质是推动数据由未处理的原始状态,经过规范清洗与多维挖掘,最终提纯为可执行的业务决策。下表汇总了各步骤的标准工具链与关键交付产物:
| 阶段序号 | 关键步骤 | 核心 Python 库与方法 | 核心产出物 | 常见失误警示 |
|---|---|---|---|---|
| 步骤 01 | 数据获取 | pandas.read_csv, SQLAlchemy |
原始数据帧 (Raw DataFrame) | 未指定编码造成乱码;大文件一次性读取引发内存崩溃 |
| 步骤 02 | 清洗预处理 | dropna, fillna, astype, clip |
规整数据帧 (Clean DataFrame) | 直接原地修改原始数据;盲目用均值填补偏态分布 |
| 步骤 03 | 探索性分析 | describe, corr, groupby, pivot_table |
统计量摘要与业务假设矩阵 | 跳过单变量分布直接做相关性;被辛普森悖论误导 |
| 步骤 04 | 指标与特征 | rolling, pct_change, cut, agg |
大盘 KPI 表与特征衍生矩阵 | 指标口径未与业务部门对齐;未来数据穿越(数据泄露) |
| 步骤 05 | 可视化呈现 | matplotlib.pyplot, seaborn |
业务分析看板与行动决策报告 | 截断 Y 轴造成视觉欺骗;图表缺乏单位量纲与图例 |
遵循这套标准流程,无论是面对日常业务经营分析、临时专题排查,还是搭建周期性运行的自动化分析脚本,都能够确保分析链路清晰、统计逻辑严密,并使分析成果具备扎实的决策指导价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















