


Python交互式解释器与脚本运行模式有什么区别
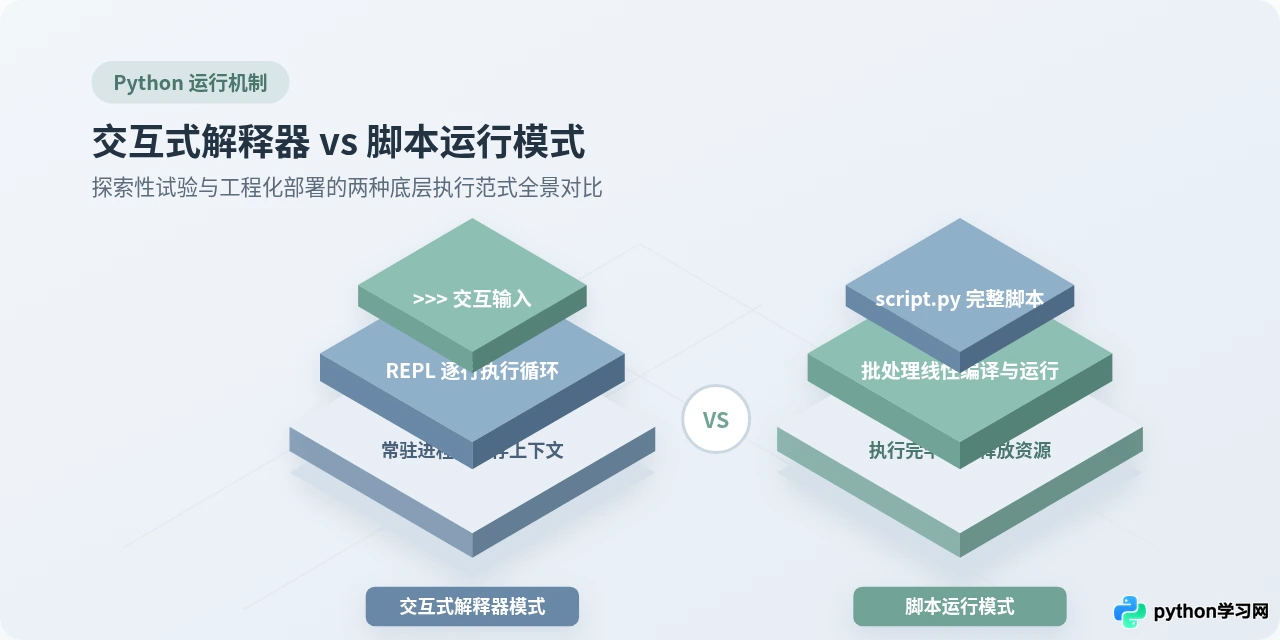
深入对比Python交互式解释器(REPL)与脚本运行模式的核心区别。从执行机制、内存生命周期、操作步骤、表达式求值到实际选型场景,通过直观的等距图示与实操代码,助你彻底理清两者的边界与高效协同方法。
.py 文件一次性顺序编译并批处理执行,运行完毕即退出进程并彻底释放系统资源,是工程化开发、自动化作业与生产部署的标准形态。
一、执行机制与进程生命周期的本质不同
初学者在学习 Python 时,往往会交替使用终端里的 >>> 提示符和编辑器里的 .py 代码文件。要准确理解两者的差异,首先必须从它们的底层执行机制与进程生命周期切入。
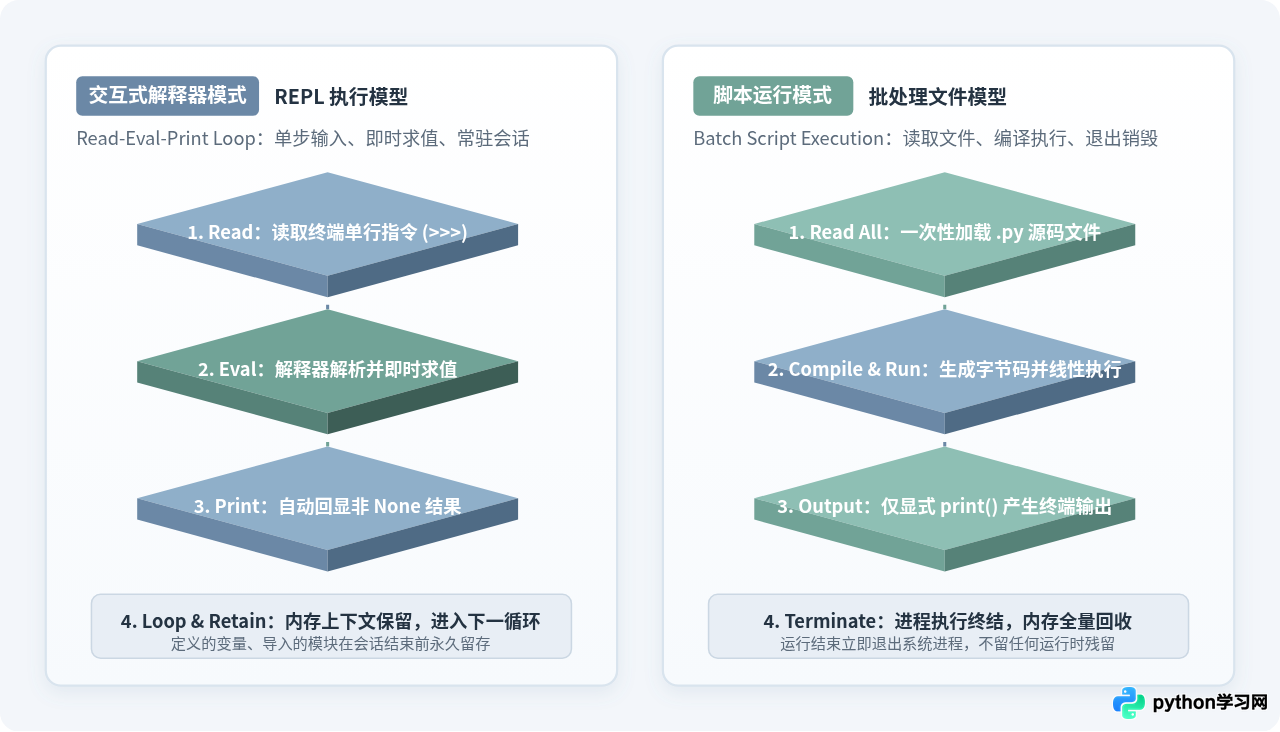
交互式解释器全称为 REPL(Read-Eval-Print Loop,读取-求值-输出-循环)。当你直接在终端中敲入 python 并回车时,操作系统会启动一个持久驻留的 Python 进程:
- Read(读取):等待用户在
>>>提示符后输入单条语句或复合代码块。 - Eval(求值):将输入的代码片段动态编译为字节码并放入当前全局命名空间求值。
- Print(打印):若表达式产生有意义的非
None返回值,解释器会自动将其字符串表示格式化并回显到终端屏幕上。 - Loop(循环):回到
>>>状态,保留此前的所有变量、函数定义与导入模块,等待下一条指令。
与此相对,脚本运行模式采用的是批处理(Batch Execution)模型。执行命令为 python filename.py,其运行轨迹是线性的:Python 解释器启动一个新进程,自顶向下一次性读取文件中的所有代码,从第一行顺序执行到最后一行;当代码执行完毕(或遇到未捕获的严重错误)后,进程立刻终止,操作系统随即回收该进程占用的全部内存。
二、日常操作流程与调试排错的差异
由于执行机制不同,两者在日常开发中的操作步骤与排错心智模型存在明显分歧。我们通过具体操作过程来进行对比。
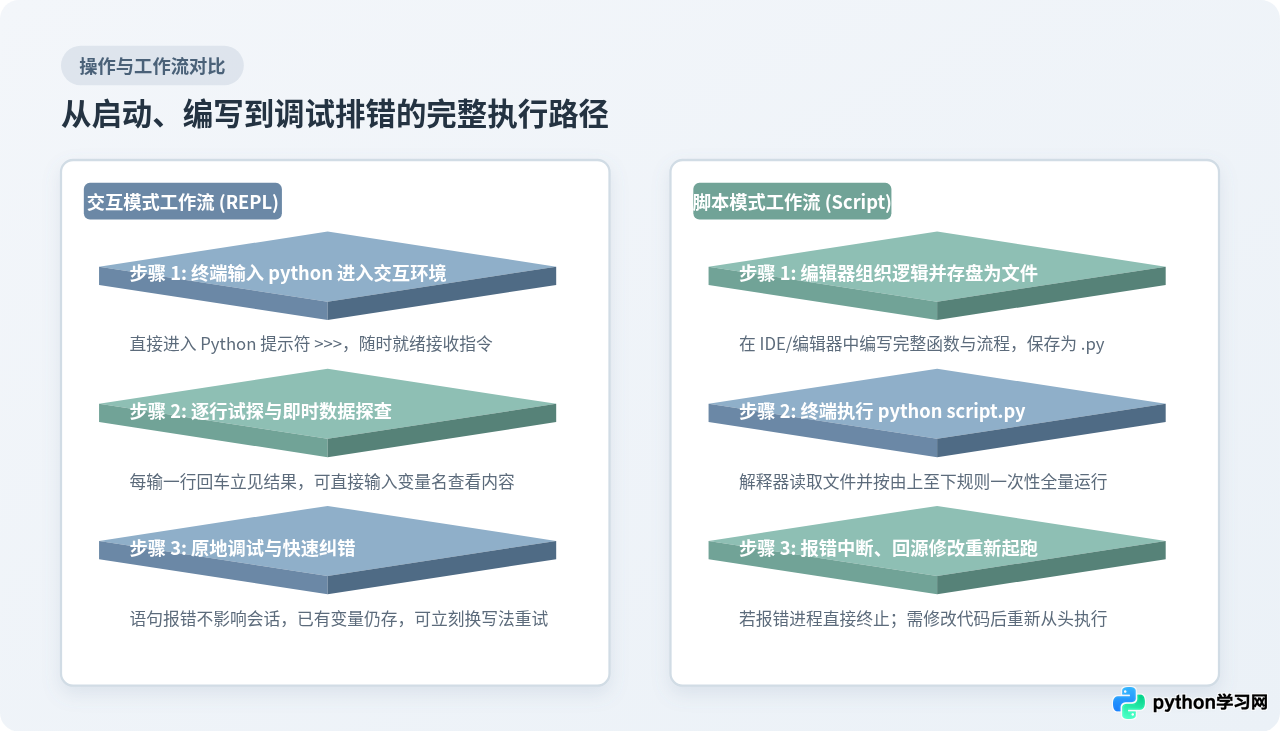
1. 交互式解释器的操作步骤
打开系统终端(Terminal / PowerShell),无需创建任何文件,直接键入:
python[Clang 14.0.3] on darwin
Type "help", "copyright", "credits" or "license" for more information.
>>>
此时即可逐行键入代码并即时观察反馈:
>>> data = [1, 2, 3, 4, 5]
>>> sum(data)
15
>>> len(data)
5
如果在第 3 行输错了函数名,例如写成了 summ(data),解释器只会打印错误追溯(Traceback)信息,并不会退出:
>>> summ(data)
NameError: name 'summ' is not defined. Did you mean: 'sum'?
>>>
先前的变量 data 依然完整保存在内存中,你可以直接输入正确的代码继续测试。要退出交互式环境,只需输入 exit() 或按下快捷键 Ctrl+D(Windows 下为 Ctrl+Z 后按回车)。
2. 脚本运行模式的操作步骤
在脚本模式下,操作流程包含“编辑”、“存盘”和“命令行调用”三个离散步骤:
- 使用代码编辑器(如 VS Code、PyCharm)新建一个文本文件,保存为
calc.py。 - 在文件中输入完整逻辑,必须明确调用输出函数:
# calc.py 示例源码 data = [1, 2, 3, 4, 5] total = sum(data) print(f"数据总和为: {total}") - 在操作系统命令行中切换至该文件所在目录,调用解释器执行:
python calc.py终端示例输出数据总和为: 15
如果脚本在执行中途遭遇报错,整个 Python 进程会立即中断,控制权返还给操作系统的 Shell,代码运行中产生的所有中间数据随之蒸发。排查问题必须回到编辑器中修改源文件,重新保存后再全量执行一次。
三、深层语言行为与执行细节的对比
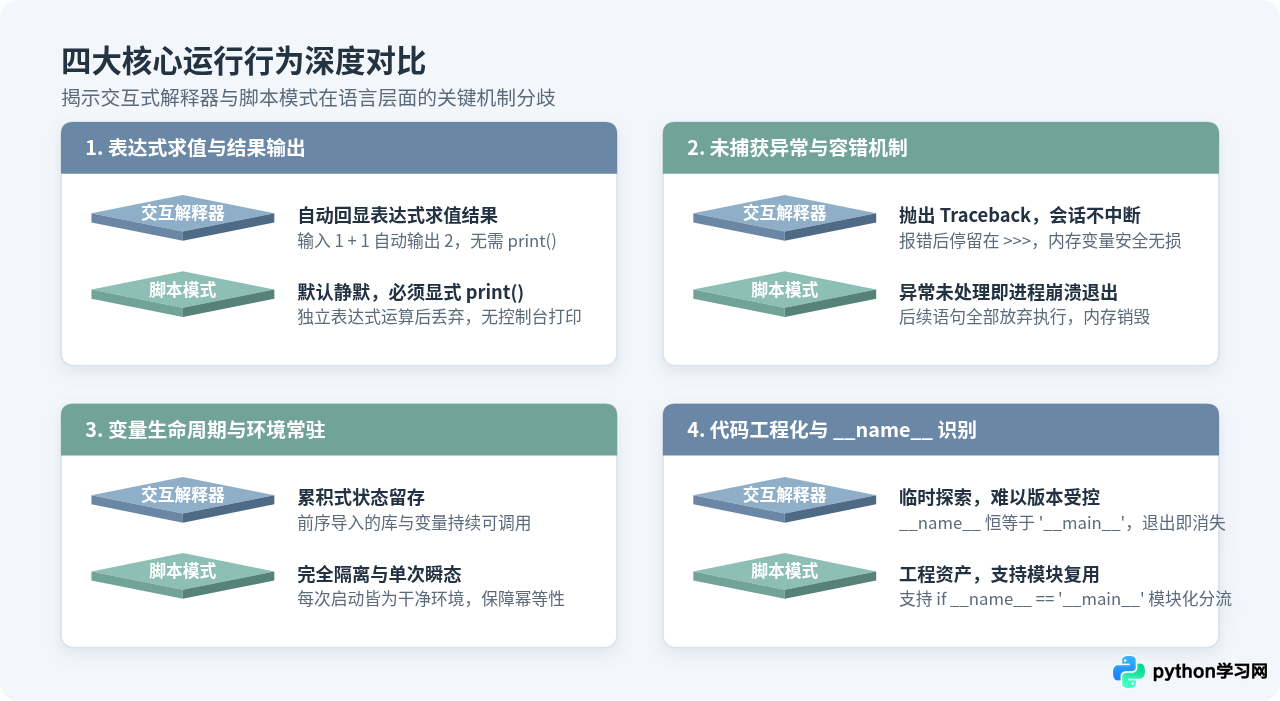
许多刚从交互式环境转向写脚本的读者,常会遇到“为什么在交互环境里好好的代码,写成脚本就不动了”或“为什么脚本能跑但交互解释器里行为不一致”的问题。这主要是由以下四个核心行为差异造成的:
1. 表达式的自动求值与回显输出
在交互模式中,任何独立的表达式只要计算结果不是 None,解释器都会调用该对象的 repr() 方法自动打印在终端上:
>>> "hello world".upper()
'HELLO WORLD'
然而在脚本模式中,独立表达式的求值结果会被直接丢弃。如果在 main.py 中仅写 "hello world".upper(),运行时不会在终端产生任何输出。在脚本模式中,一切控制台显示都必须由 print() 或日志模块显式触发。
2. 未捕获异常的容忍度与扩散范围
在交互式环境中,每一条输入指令都被包裹在一个内层的异常捕获机制中。当代码抛出 KeyError、IndexError 或自定义异常时,解释器仅仅是打印错误日志,接着重新回到 >>> 提示符。当前会话的命名空间完全不受损坏。
而在脚本运行模式中,一旦任何未被 try...except 捕获的异常抛出至顶层,Python 运行时会立刻中止程序执行并退出进程。后续所有代码都不会被执行。
3. 变量生命周期与副作用累积
交互式解释器的环境是累积式的。你在两小时前定义的变量或导入的模块,只要未被显式 del 或重新赋值,依然驻留在当前命名空间中。这虽然方便了逐步试探,但也带来了潜在风险:你可能会无意中使用之前残存的全局变量,导致逻辑产生偶发性隐患。
脚本运行模式每次启动都是完全崭新、隔离的内存环境。所有全局变量和模块导入都严格按照当前文件的代码重新走一遍,确保了程序执行的确定性与幂等性。
4. __name__ 变量与模块化分流
在 Python 中,每个模块都拥有内置属性 __name__:
- 在交互式解释器中,无论你如何操作,当前运行模块的
__name__恒等于'__main__'。 - 在脚本运行模式中,如果该文件是作为入口由
python script.py直接运行,其__name__同样为'__main__';但当该文件被其他代码通过import script导入时,其__name__会自动变为文件的模块名'script'。
这也正是标准 Python 脚本中常见 if __name__ == '__main__': 结构的原因——它能够确保这部分初始化或测试逻辑只有在直接以脚本模式运行时才触发,被作为库导入时保持静默。
四、对比汇总表与实际选型依据
为了让不同场景下的技术选型更加直观,下表总结了两种模式的核心维度对照:
| 对比维度 | 交互式解释器模式 (REPL) | 脚本运行模式 (Script Mode) |
|---|---|---|
| 代码载体 | 终端动态标准输入(无文件或临时交互) | 磁盘中持久保存的 .py 文本文件 |
| 执行方式 | 单行/代码块逐行实时解释并反馈 | 全量文件顺序批处理执行 |
| 输出机制 | 表达式非 None 时自动回显 |
必须通过 print() 或日志库显式输出 |
| 异常表现 | 打印 Traceback,会话不中断,状态保留 | 顶层异常直接触发程序崩溃并退出 |
| 状态生命周期 | 持续常驻内存,直至手动 exit() |
执行完毕后立即终结进程并全量回收 |
| 版本管理 | 无法使用 Git 进行版本受控与协作 | 标准工程文本,便于 Git 分支追踪与审查 |
| 核心优势 | 即时反馈、免建文件、探索学习成本极低 | 逻辑严谨、结果可重现、便于构建复杂系统 |
五、高效开发实践:两者的协同使用技巧
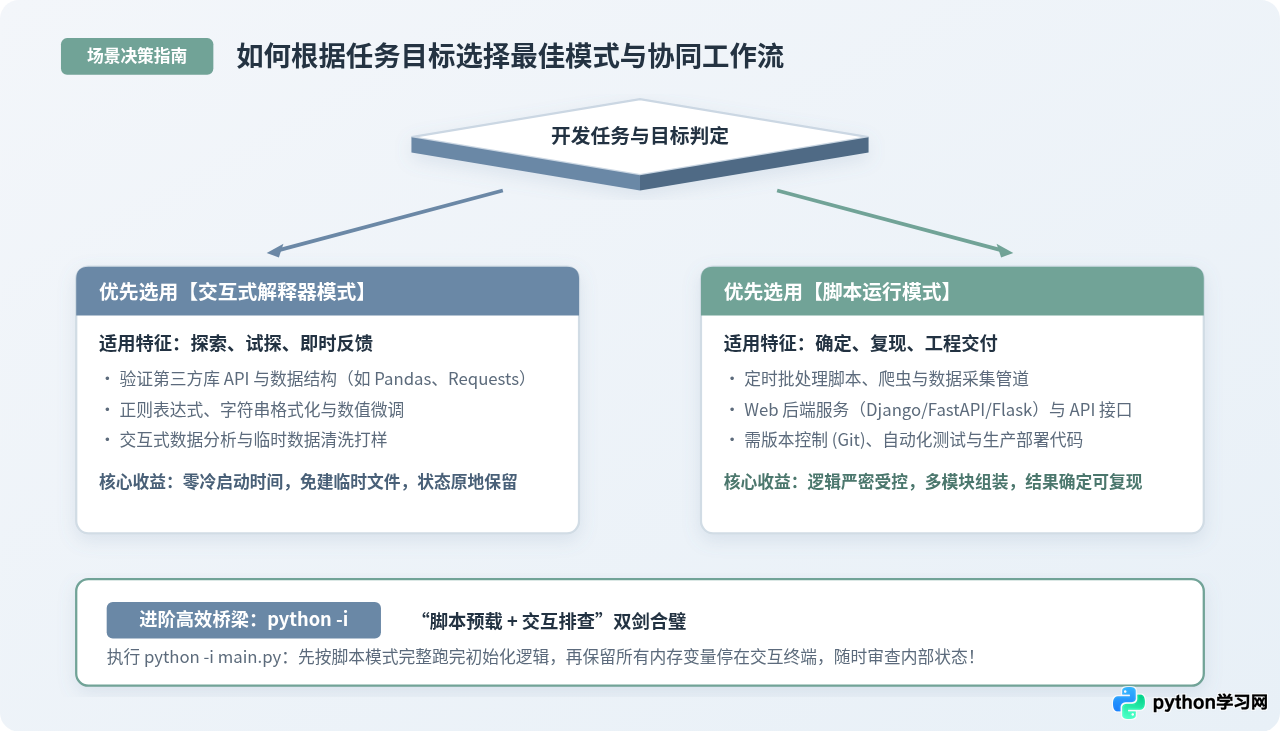
在实际生产开发中,资深开发者从不把这两种模式割裂开来,而是将二者紧密融合:
当你编写了一个包含繁重初始化逻辑(例如读取大文件、连接数据库或定义了许多辅助类)的脚本 analysis.py,但想要在运行后探查中间结果时,可以使用:
python -i analysis.pyPython 会先以脚本模式跑完 analysis.py 的全部逻辑,但在执行完毕后并不退出,而是就地切入交互式解释器。此时脚本中初始化的所有对象、数据变量都完好保存在当前内存中,你可以直接在 >>> 下敲入变量名进行深度切片分析。
自 Python 3.7 起,标准库内置了 breakpoint() 函数。当脚本运行到这一行时,会自动挂起程序执行并打开一个类似交互解释器的调试会话(PDB),允许你当场打印变量、逐步单步执行或调用函数,极大提升了排错效率。
总结而言,交互式解释器负责“探索与验证”,帮助你快速厘清未知 API、验证算法原型;而脚本运行模式负责“固化与工程”,将验证成熟的逻辑组织为结构化模块,保障长期稳定运行。掌握两者背后的运作机理,便能在日常 Python 编程与工程开发中游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















