


Python爬虫怎么处理JavaScript动态加载内容
本文详细讲解Python爬虫处理JavaScript动态渲染与加载内容的三种主流方法:抓包逆向直接请求真实接口、使用Playwright无头浏览器自动化以及源码内嵌数据提取,提供完整代码示例、选型对比与排查流程。
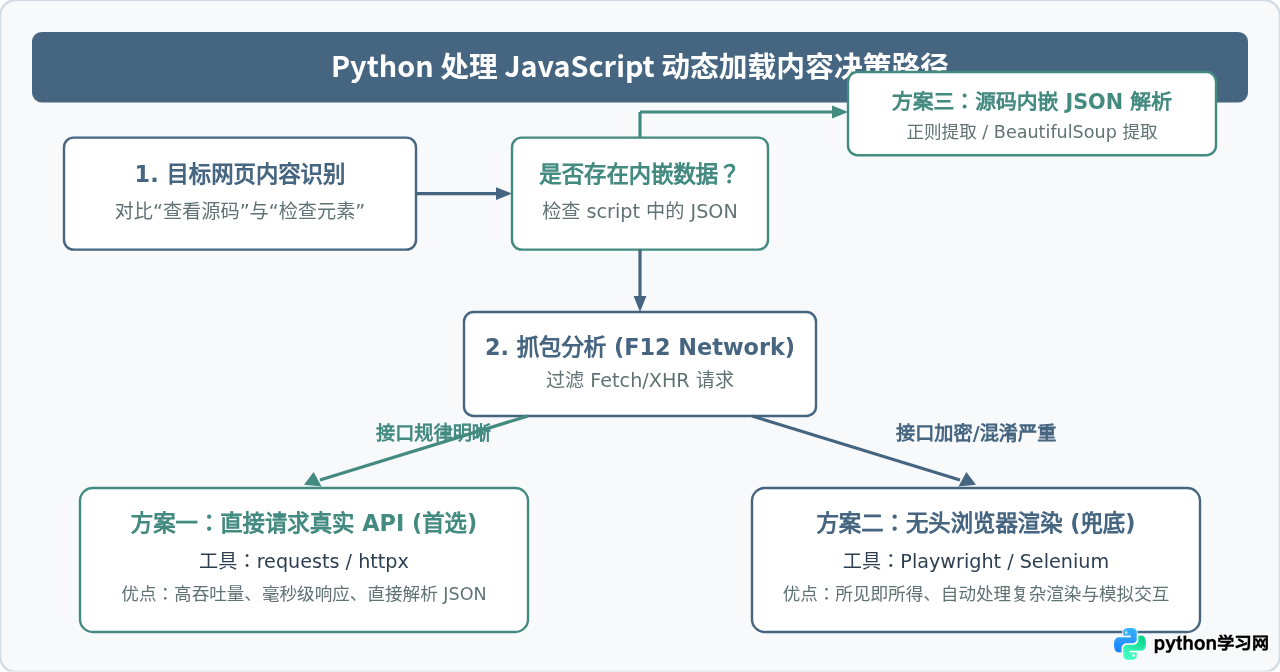
使用 Python 进行网页抓取时,经常会遇到在浏览器中能清晰看到文字和列表,但通过 requests.get() 获取到的网页源码中却没有这些内容的情况。这是因为现代网页普遍采用前后端分离架构,页面初始返回的只是轻量级 HTML 骨架和 JavaScript 脚本,具体业务数据是在浏览器执行 JavaScript 后,通过异步请求或前端模版动态渲染到 DOM 树中的。要获取这类动态加载的内容,核心解决思路主要有三条:一是通过浏览器开发者工具抓包定位背后的真实 API 并直接发起网络请求;二是使用 Playwright 或 Selenium 等无头浏览器在本地完成完整的渲染与交互;三是直接从页面源代码中提取内嵌的初始化 JSON 数据。本文将逐步演示如何识别动态加载机制,并针对不同场景给出具体可执行的实现方案。
一、如何排查内容是否为 JavaScript 动态加载
在编写爬虫代码前,第一步是确认目标数据究竟是随 HTML 静态直出,还是由 JavaScript 脚本动态生成的。判断方法非常简单且确定:
- 对比源代码与页面呈现:在浏览器中打开目标网页,选中需要爬取的一小段文字并复制。随后右键点击页面空白处选择“查看网页源代码”(快捷键 Ctrl+U 或 Cmd+Option+U)。在打开的纯源码页面中按 Ctrl+F 搜索该段文字。如果在源代码中完全搜不到,但页面上确实显示了该内容,则可以确定该内容是由 JavaScript 动态加载或渲染生成的。
- 检查元素面板(Elements):右键点击目标文字选择“检查”(Inspect)。在 Elements 面板中可以看到完整的 DOM 树,因为该面板展示的是浏览器解析执行所有脚本后最终形成的页面状态。静态爬虫直接抓取的是网络响应的原始文本,无法获得在 DOM 中动态追加的节点。
- 禁用 JavaScript 测试:在浏览器的开发者工具设置中临时禁用 JavaScript(Settings > Debugger > Disable JavaScript)并刷新页面。如果刷新后目标内容消失,说明页面重度依赖客户端 JS 动态渲染。
二、方案一:抓包分析并直接请求真实 API 接口(优先推荐)
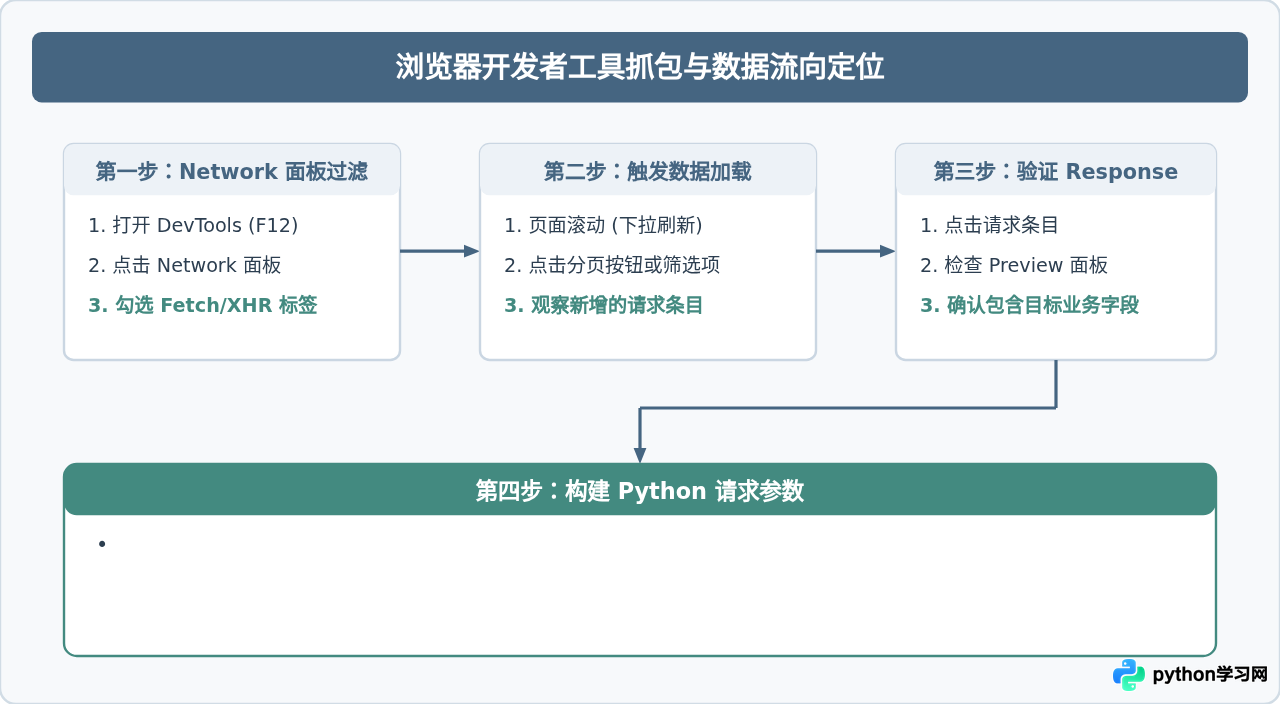
很多初学者一遇到动态内容就立刻启动 Selenium 或 Playwright,这往往会导致程序运行缓慢、消耗大量服务器内存。在大部分现代 Web 应用中,JavaScript 动态渲染的本质是向后端服务器发送异步请求(Ajax / Fetch),拿到 JSON 格式的数据后再填充进 HTML 模板。因此,最优雅、最高效的处理方式是:绕过 HTML 渲染,直接抓包找到背后的数据接口并用 Python 发起请求。
实战操作与代码示例
假设我们抓取某电商或新闻资讯网站的瀑布流列表,在开发者工具的 Network 过滤出形如 https://example.com/api/v1/articles?category=tech&page=1 的接口。我们直接使用 Python 标准的 requests 库发起调用:
import requests

def fetch_dynamic_articles(page=1):
    api_url = "https://example.com/api/v1/articles"

    params = {
        "category": "tech",
        "page": page,
        "page_size": 20
    }

    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Referer": "https://example.com/articles",
        "Accept": "application/json, text/plain, */*"
    }

    try:
        response = requests.get(api_url, params=params, headers=headers, timeout=10)
        response.raise_for_status()
        data = response.json()

        articles = data.get("data", {}).get("items", [])
        for item in articles:
            title = item.get("title")
            article_id = item.get("id")
            pub_date = item.get("publish_date")
            print(f"[{article_id}] {title} - {pub_date}")

        return articles
    except requests.exceptions.RequestException as e:
        print(f"请求发生异常: {e}")
        return []

if __name__ == "__main__":
    fetch_dynamic_articles(page=1)
关键提示:抓包方案的请求耗时通常在 50~200 毫秒之间,且可以直接得到纯净的 JSON 字典或列表,省去了用 XPath 或 CSS 选择器解析复杂 HTML 树的繁琐工作,是工业级爬虫的首选策略。
三、方案二:使用现代无头浏览器自动化(Playwright 与 Selenium)
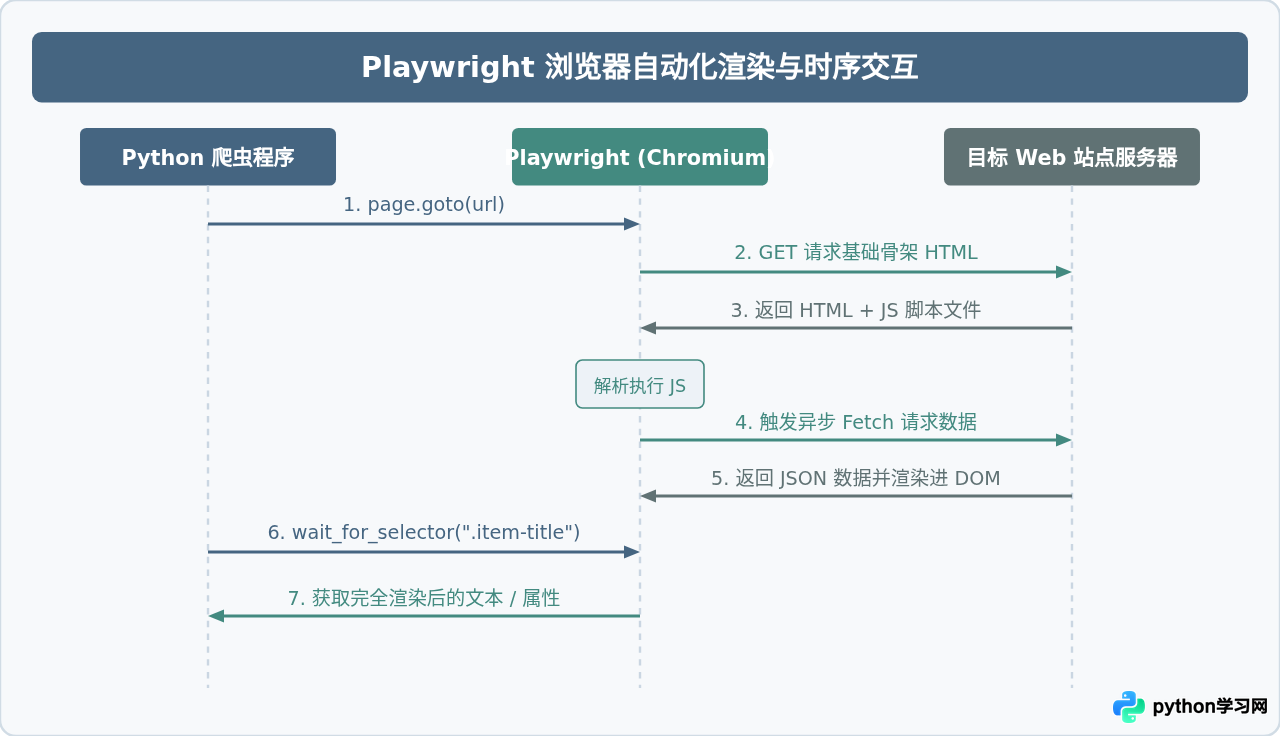
当目标网站对 API 接口施加了复杂的参数加密(例如动态 Token、时间戳哈希签名、WebAssembly 混淆),或者数据并非来自 Ajax 接口而是由前端复杂逻辑即时运算生成时,逆向接口的成本会急剧增加。此时,使用无头浏览器(Headless Browser)驱动完整的页面生命周期是最直接、稳妥的解决方案。
在目前的 Python 生态中,推荐优先使用 Playwright 而非传统的 Selenium。Playwright 原生支持异步、执行速度更快、内置智能等待机制,并且对网络事件拦截更加友好。
安装与核心代码实现
首先通过终端安装 Playwright 及其内置的浏览器内核:
pip install playwright
playwright install chromium
随后编写 Python 代码,启动无头 Chromium 实例并设置显式等待:
from playwright.sync_api import sync_playwright

def crawl_with_playwright(target_url):
    with sync_playwright() as p:
        # 启动 Chromium 浏览器,headless=True 表示无界面模式
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
        )
        page = context.new_page()

        print(f"正在访问: {target_url}")
        page.goto(target_url, wait_until="domcontentloaded")

        # 关键步骤:显式等待动态渲染的关键元素节点出现
        target_selector = ".product-item .product-title"
        try:
            page.wait_for_selector(target_selector, timeout=10000)

            # 若页面存在滚动懒加载,可执行页面滚动脚本
            page.evaluate("window.scrollTo(0, document.body.scrollHeight);")
            page.wait_for_timeout(1000)  # 等待滚动加载完成

            # 批量提取渲染好的元素内容
            elements = page.query_selector_all(target_selector)
            results = []
            for el in elements:
                text = el.inner_text().strip()
                if text:
                    results.append(text)
                    print(f"提取到内容: {text}")

            return results
        except Exception as e:
            print(f"等待元素超时或提取失败: {e}")
            return []
        finally:
            browser.close()

if __name__ == "__main__":
    crawl_with_playwright("https://example.com/products")
四、方案三:解析页面源码中的内嵌初始化数据
许多基于现代化前端框架(如 Next.js、Nuxt.js、Vue SSR 或 React SSR)构建的网站,在服务端生成页面时,为了避免客户端初次加载时出现闪烁,会把首屏完整数据直接序列化成 JSON 字符串,放在 HTML 中的某个 <script> 标签里,例如:
<script id="__NEXT_DATA__" type="application/json">{"props":{...}}</script><script>window.__INITIAL_STATE__ = {"user":{...},"list":[...]};</script>
在这种情况下,既不需要复杂的抓包逆向,也不需要运行消耗庞大的无头浏览器,只需用普通的 requests 拿到 HTML 字符串,配合 BeautifulSoup 或 正则表达式 直接把这段 JSON 提取出来即可。
import json
import re
import requests
from bs4 import BeautifulSoup

def extract_embedded_state(url):
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
    }
    response = requests.get(url, headers=headers)
    soup = BeautifulSoup(response.text, "html.parser")

    # 场景 A: 存在带有固定 ID 的 JSON script 标签 (常见于 Next.js)
    script_tag = soup.find("script", id="__NEXT_DATA__")
    if script_tag and script_tag.string:
        data = json.loads(script_tag.string)
        page_props = data.get("props", {}).get("pageProps", {})
        return page_props

    # 场景 B: 数据赋值给全局变量 window.__INITIAL_STATE__
    pattern = re.compile(r"window\.__INITIAL_STATE__\s*=\s*(\{.*?\});", re.DOTALL)
    match = pattern.search(response.text)
    if match:
        json_str = match.group(1)
        data = json.loads(json_str)
        return data

    return None
五、三种方案的对比与技术选型
在面对不同的爬虫项目时,应当根据目标网站的防御强度、抓取规模与性能要求灵活选择方案:
| 对比维度 | 抓包请求真实 API | Playwright 无头渲染 | 源码内嵌 JSON 提取 |
|---|---|---|---|
| 单页抓取耗时 | 约 50 ~ 200 ms | 约 1.5 ~ 5 s | 约 100 ~ 300 ms |
| 并发与吞吐能力 | 极高,支持千级协程并发 | 较低,受限于浏览器进程数 | 极高,支持千级协程并发 |
| 单进程内存占用 | 约 30 ~ 50 MB | 约 300 ~ 800 MB (每个浏览器实例) | 约 40 ~ 60 MB |
| 解析难度 | 直接处理字典,结构极佳 | 需写选择器,易受前端改版影响 | 直接 loads 字典,字段完整 |
| 面对复杂加密 | 需逆向 JS 签名生成算法 | 浏览器自动计算,直接绕过加密 | 无加密,随 HTML 直接返回 |
六、关键操作细节与常见错误避坑
- 切勿使用硬编码
time.sleep():在编写浏览器自动化脚本时,部分初学者喜欢使用time.sleep(5)等待页面渲染。这种做法非常低效且不稳定,因为网络波动可能导致 5 秒仍未加载完,而网络良好时又白白浪费时间。务必使用wait_for_selector()或wait_for_function()等显式等待机制,元素出现即立即向下执行。 - 防止无头浏览器内存泄露:长期运行的爬虫脚本如果频繁
launch()浏览器而不及时释放,会导致大量僵尸 Chromium 进程常驻后台。应当复用同一个Browser实例,通过创建和销毁独立的BrowserContext与Page来隔离抓取会话。 - 规避 WebDriver 特征检测:许多反爬系统会检查
navigator.webdriver属性。使用 Playwright 时,可配合playwright-stealth扩展包或通过修改启动参数抹除指纹标记,提升采集中断的容错率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















