


Python网络爬虫应用详解:从数据采集到清洗存储的全流程
本文系统拆解Python网络爬虫的工程落地全链路,涵盖基于Requests的数据采集、DOM树形解析与节点提取、文本正则清洗与去重校验,以及CSV与SQLite数据库的持久化写入与生产级防踩坑实践。
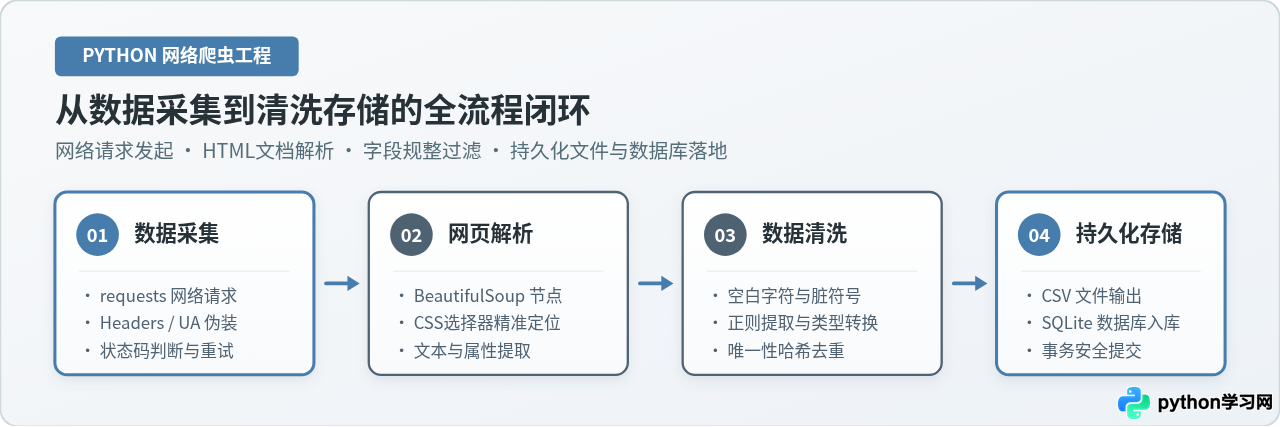
网络爬虫的标准执行流程与核心阶段
在设计一个稳定可靠的爬虫应用前,需要明确各个模块之间的依赖关系与职责边界。一个松耦合的爬虫系统不应将网络请求、HTML解析和数据库写入混杂在同一个函数中,而应通过标准数据形态在四个独立阶段间顺次流转。
各个阶段的衔接逻辑十分明确:采集模块输出未经修饰的原始HTML文本;解析模块将文本解析为内存中的DOM对象并抽取关键字段字典;清洗模块负责对脏字符串执行脱敏、去除换行、类型强转与判空;最终由存储模块将纯净的数据写入持久化介质中。
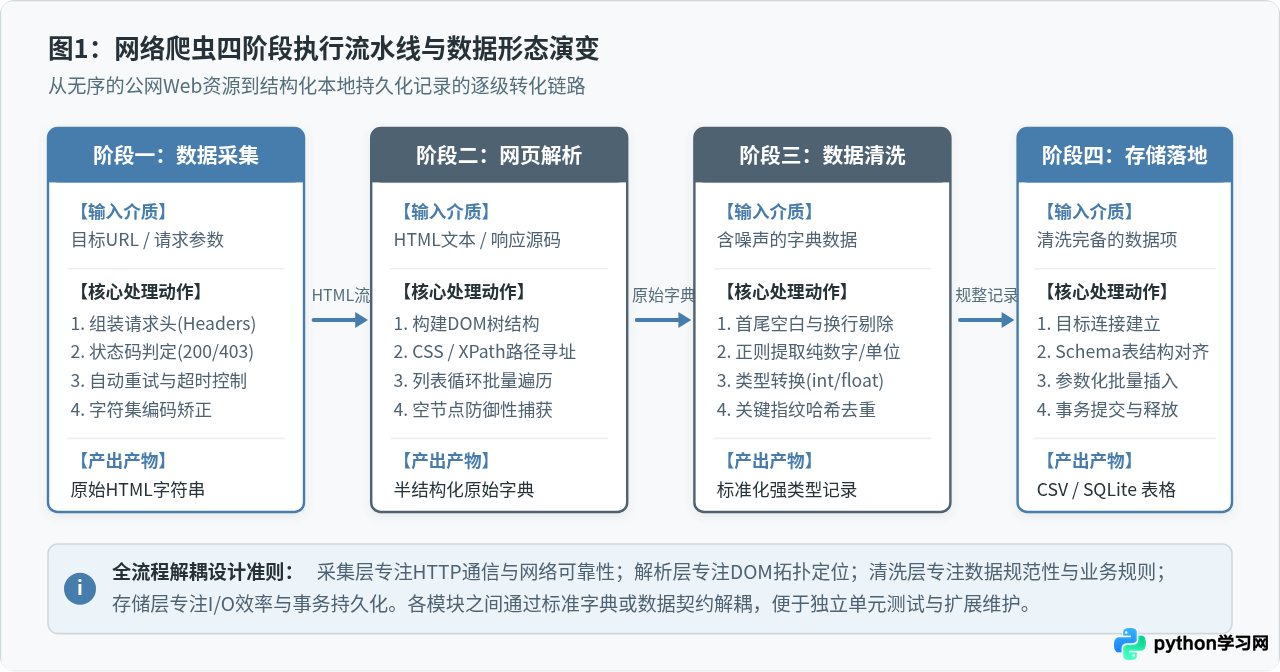
了解数据在流水线中的演变过程后,可以逐层构建每个模块的具体实现,首先从面向外部网络通信的数据采集阶段开始。
数据采集:HTTP请求构建、状态判断与反爬应对
数据采集阶段的核心目标,是向目标Web服务器发出合法、合规的HTTP请求,并稳定获取完整的响应文本。在Python中,requests库是构建此类同步HTTP通信的标准工具。
1. 基础请求头组装与客户端伪装
绝大多数Web服务都会检测HTTP请求头中的User-Agent属性,默认的Python脚本请求头会暴露诸如python-requests/x.x.x的特征标识,极易被防火墙直接拦截返回403状态码。因此,必须在请求头中配置标准浏览器的User-Agent。
import requests

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
}
url = "https://example.com/books"
response = requests.get(url, headers=headers, timeout=10)
2. 状态码判定、超时设置与指数退避重试
实际网络请求经常遭遇不可控的瞬时丢包、服务波动或速率限制。如果不指定timeout参数,程序可能会在底层TCP握手阶段无限期挂起;如果不对返回的HTTP状态码进行校验,后续解析模块就会因为解析到报错页面或空白页而发生异常崩溃。
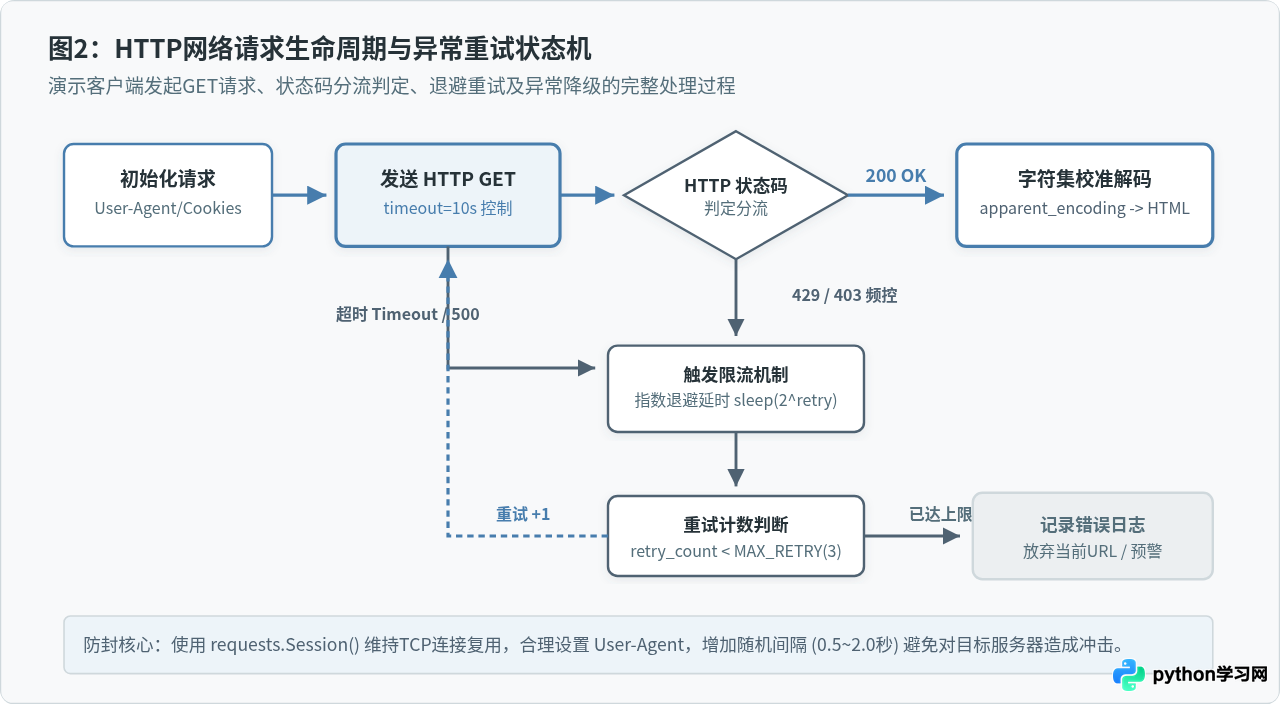
为了保障采集程序的健壮性,通常将HTTP请求封装为一个带有自动重试与状态码校验的专用函数:
import time
import requests
from requests.exceptions import RequestException

def fetch_page(url: str, session: requests.Session, max_retries: int = 3) -> str:
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    }
    for attempt in range(1, max_retries + 1):
        try:
            response = session.get(url, headers=headers, timeout=8)
            # 状态码分流判断
            if response.status_code == 200:
                # 自动基于HTTP报头与内容判定准确字符集,防止中文乱码
                response.encoding = response.apparent_encoding
                return response.text
            elif response.status_code in (429, 403):
                # 遭遇频控或鉴权拦截,延长等待时间后重试
                wait_seconds = 2 ** attempt
                time.sleep(wait_seconds)
            else:
                return ""
        except RequestException:
            if attempt == max_retries:
                return ""
            time.sleep(1.5 * attempt)
return ""requests.get() 会为每个请求重复执行 TCP 三次握手与 TLS 协商,消耗大量本地端口并增加延迟。在爬取多页面列表时,始终使用 session = requests.Session() 发起请求,以复用底层 TCP 连接池。
网页解析:从HTML文本到结构化字段
当获取到合法的HTML字符串后,下一步就是通过解析器将纯文本转换为层次分明的文档对象模型(DOM)树,并通过路径或特征选择器提取出所需的结构化字段。BeautifulSoup4结合lxml解析器在容错能力与提取效率上达到了极佳的平衡。
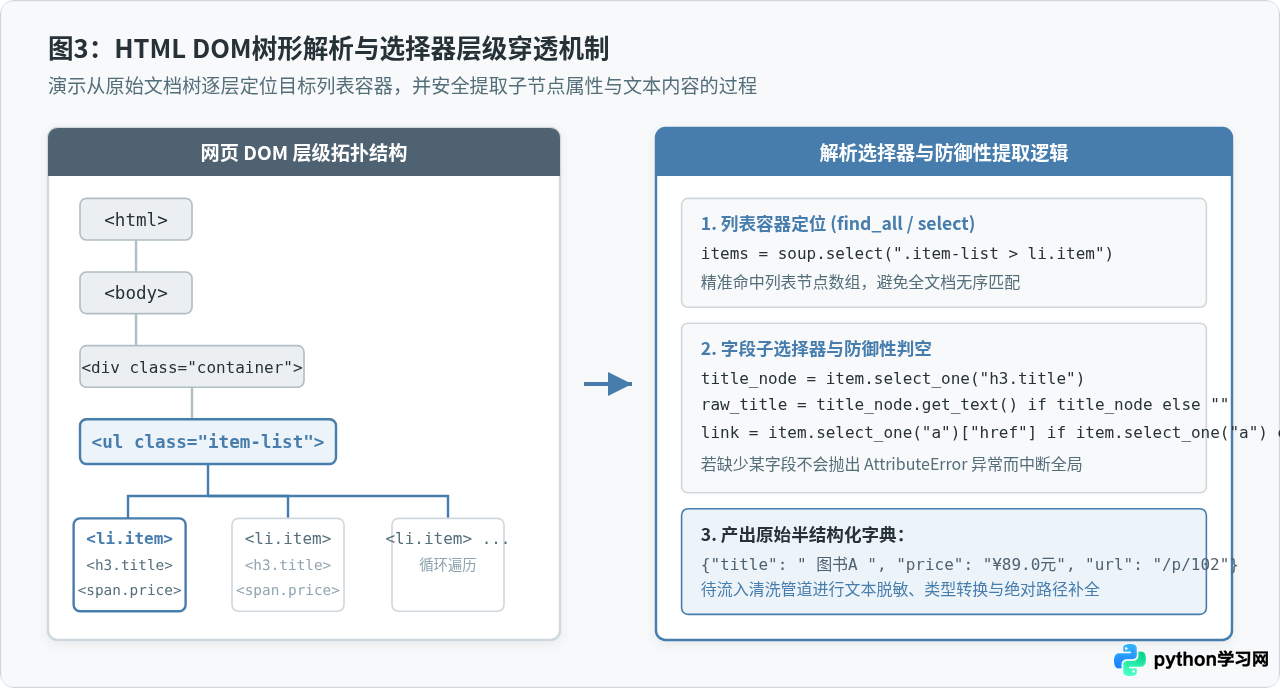
1. 容器定位与列表遍历
网页列表通常具有明确的重复DOM骨架,解析的第一步永远是定位外层容器,并提取所有的卡片节点。避免使用全局通配匹配,防止将广告栏或推荐位的同名标签混入主数据中。
from bs4 import BeautifulSoup

def parse_html_items(html_content: str) -> list[dict]:
    if not html_content:
        return []

    soup = BeautifulSoup(html_content, "lxml")
    item_nodes = soup.select("ul.item-list > li.item")
    extracted_records = []

    for item in item_nodes:
        # 防御性解析:对每个子节点执行显式判空
        title_tag = item.select_one("h3.title")
        price_tag = item.select_one("span.price")
        link_tag = item.select_one("a.detail-link")
        date_tag = item.select_one("span.publish-date")

        raw_record = {
            "raw_title": title_tag.get_text() if title_tag else "",
            "raw_price": price_tag.get_text() if price_tag else "",
            "raw_link": link_tag["href"] if (link_tag and link_tag.has_attr("href")) else "",
            "raw_date": date_tag.get_text() if date_tag else "",
        }
        extracted_records.append(raw_record)

return extracted_recordsitem.select_one("span.price").text。一旦目标页面某一行数据由于前端渲染缺失了 span.price,select_one() 将返回 None,直接调用 .text 会触发 AttributeError: 'NoneType' object has no attribute 'text',导致爬虫程序直接终止。使用条件表达式进行三元判空是保证长效运行的基本习惯。
数据清洗:规整、校验与去重转换
从网页直接抽取的字段绝大部分属于“脏数据”:包含多余的首尾空格、换行符(
、 )、货币符号、相对URL路径以及非标准的日期格式。清洗管道的职责是将这些非标字符串转换为强类型的干净实体。
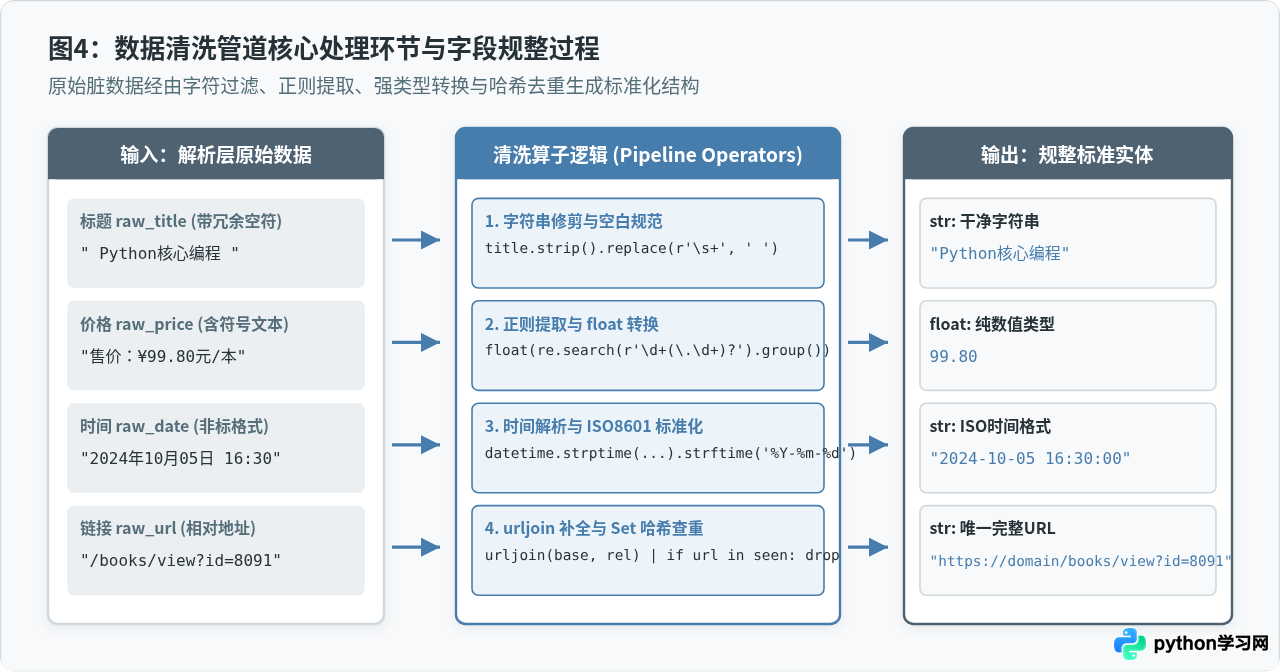
1. 核心字段清洗算子实现
清洗环节重点处理四类变换:
- 文本规范化:去除首尾空白字符,并将文本内部连续的空白压缩为单个空格。
- 数值纯净化:通过正则表达式从形如“¥128.50元”的文本中扣出浮点数字,并完成类型转换。
- URL补全:利用
urllib.parse.urljoin将相对地址拼接为完整的可访问绝对地址。 - 时间格式化:将自然语言格式的时间文本解析并重构为标准
YYYY-MM-DD格式。
import re
from datetime import datetime
from urllib.parse import urljoin

BASE_URL = "https://example.com"

def clean_record(raw: dict) -> dict | None:
    # 1. 标题清洗:若标题为空则视为无效行放弃
    raw_title = raw.get("raw_title", "")
    title = re.sub(r"\s+", " ", raw_title).strip()
    if not title:
        return None

    # 2. 价格正则抽取与强类型转换
    raw_price = raw.get("raw_price", "")
    price_match = re.search(r"\d+(?:\.\d+)?", raw_price)
    price = float(price_match.group()) if price_match else 0.0

    # 3. 链接路径补全
    raw_link = raw.get("raw_link", "")
    detail_url = urljoin(BASE_URL, raw_link.strip()) if raw_link else ""

    # 4. 时间格式统一
    raw_date = raw.get("raw_date", "").strip()
    try:
        # 兼容 "2024年10月05日"
        date_obj = datetime.strptime(raw_date, "%Y年%m月%d日")
        clean_date = date_obj.strftime("%Y-%m-%d")
    except ValueError:
        clean_date = datetime.now().strftime("%Y-%m-%d")

    return {
        "title": title,
        "price": price,
        "url": detail_url,
        "publish_date": clean_date,
    }
2. 数据去重过滤
网络页面往往存在交叉链接,列表翻页过程中也容易产生重叠记录。使用Python内存中的 set 维护已爬取实体的唯一主键指纹(例如条目的规范化URL或内容MD5哈希),可以在数据进入存储阶段前完成轻量化去重:
seen_urls = set()

def is_duplicate(item: dict, seen_set: set) -> bool:
    target_url = item.get("url")
    if not target_url or target_url in seen_set:
        return True
    seen_set.add(target_url)
    return False
持久化存储:CSV与SQLite数据库落地
数据清洗完成后,需要将其安全落地到存储介质。对于小规模数据采集任务,本地结构化文件(CSV)便携且易于用Excel打开查看;对于需要支持高频查询、增量更新与数据完整性约束的场景,轻量级嵌入式关系数据库 SQLite 则是首选方案。
存储方案对比与选型依据
| 存储方式 | 适用数据规模 | 主要优势 | 限制与注意事项 |
|---|---|---|---|
| CSV / JSONL | 10万行以内 | 无需安装外部服务,文件随拷随走,易于与Pandas无缝对接 | 不支持并发事务写入,不支持按主键做快速增量更新或索引查找 |
| SQLite | 1000万行以内 | 轻量单文件数据库,内置事务支持(ACID),支持建立B-Tree索引与主键冲突更新 | 多进程并发写时容易遇到数据库锁(database locked),需配置合理的超时 |
1. 写入 CSV 文件
写入CSV时,必须显式指定 newline="" 与 encoding="utf-8-sig"。其中 utf-8-sig 带BOM头,可以确保Windows下的Excel直接打开时不会出现中文字符乱码:
import csv

def save_to_csv(records: list[dict], filepath: str):
    if not records:
        return
    fieldnames = ["title", "price", "url", "publish_date"]
    with open(filepath, mode="w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(records)
2. 写入 SQLite 数据库
使用SQLite时,必须在入库前定义好表结构Schema,并利用 executemany() 进行批量参数化写入。参数化写入可以自动转义特殊字符,彻底规避SQL注入风险:
import sqlite3

def init_database(db_path: str):
    conn = sqlite3.connect(db_path)
    cursor = conn.cursor()
    cursor.execute("""
        CREATE TABLE IF NOT EXISTS books (
            id INTEGER PRIMARY KEY AUTOINCREMENT,
            title TEXT NOT NULL,
            price REAL,
            url TEXT UNIQUE,
            publish_date TEXT
        )
    """)
    conn.commit()
    conn.close()

def save_to_sqlite(records: list[dict], db_path: str):
    if not records:
        return
    conn = sqlite3.connect(db_path)
    cursor = conn.cursor()
    sql = """
        INSERT OR IGNORE INTO books (title, price, url, publish_date)
        VALUES (:title, :price, :url, :publish_date)
    """
    try:
        cursor.executemany(sql, records)
        conn.commit()
    except sqlite3.Error as e:
        conn.rollback()
        raise e
    finally:
        conn.close()
全流程完整串联示例与生产级避坑指南
在厘清了采集、解析、清洗和存储的实现之后,我们可以通过一个模块化的控制器函数将整条数据链路串联起来,形成一个具备实战生产能力的爬虫程序。
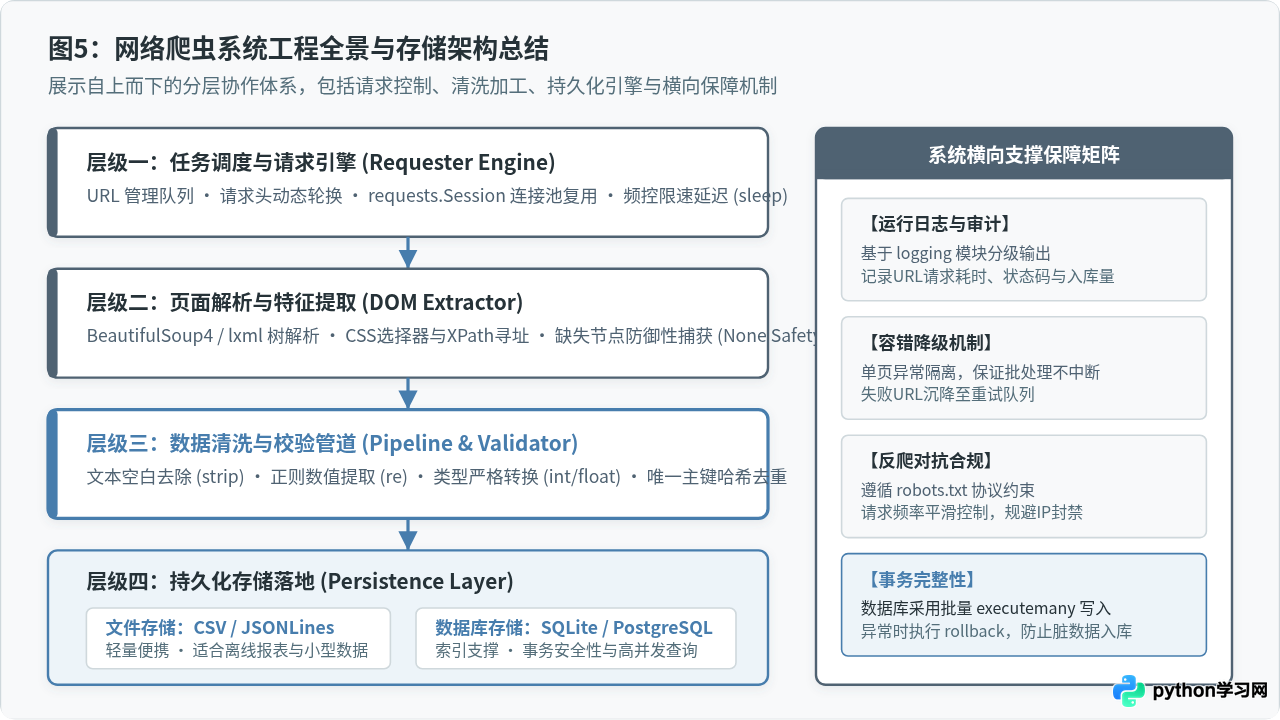
完整端到端可执行代码框架
import time
import requests
from bs4 import BeautifulSoup
import re
from datetime import datetime
from urllib.parse import urljoin
import sqlite3

class WebScraperPipeline:
    def __init__(self, db_path: str = "scraped_data.db"):
        self.db_path = db_path
        self.session = requests.Session()
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36"
        })
        self.seen_urls = set()
        self._init_db()

    def _init_db(self):
        with sqlite3.connect(self.db_path) as conn:
            conn.execute("""
                CREATE TABLE IF NOT EXISTS articles (
                    id INTEGER PRIMARY KEY AUTOINCREMENT,
                    title TEXT NOT NULL,
                    price REAL,
                    url TEXT UNIQUE,
                    publish_date TEXT,
                    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
                )
            """)

    def fetch(self, url: str) -> str:
        try:
            resp = self.session.get(url, timeout=10)
            if resp.status_code == 200:
                resp.encoding = resp.apparent_encoding
                return resp.text
        except requests.RequestException:
            pass
        return ""

    def parse(self, html: str) -> list[dict]:
        if not html:
            return []
        soup = BeautifulSoup(html, "lxml")
        raw_items = []
        for node in soup.select(".article-item"):
            t = node.select_one(".title")
            p = node.select_one(".price")
            l = node.select_one("a")
            d = node.select_one(".date")
            raw_items.append({
                "raw_title": t.get_text() if t else "",
                "raw_price": p.get_text() if p else "",
                "raw_url": l["href"] if (l and l.has_attr("href")) else "",
                "raw_date": d.get_text() if d else "",
            })
        return raw_items

    def clean(self, raw: dict, base_url: str) -> dict | None:
        title = re.sub(r"\s+", " ", raw.get("raw_title", "")).strip()
        if not title:
            return None

        price_match = re.search(r"\d+(?:\.\d+)?", raw.get("raw_price", ""))
        price = float(price_match.group()) if price_match else 0.0

        raw_url = raw.get("raw_url", "").strip()
        full_url = urljoin(base_url, raw_url) if raw_url else ""
        if not full_url or full_url in self.seen_urls:
            return None
        self.seen_urls.add(full_url)

        return {
            "title": title,
            "price": price,
            "url": full_url,
            "publish_date": datetime.now().strftime("%Y-%m-%d")
        }

    def store(self, records: list[dict]):
        if not records:
            return
        sql = """
            INSERT OR IGNORE INTO articles (title, price, url, publish_date)
            VALUES (:title, :price, :url, :publish_date)
        """
        with sqlite3.connect(self.db_path) as conn:
            conn.executemany(sql, records)

    def run(self, target_urls: list[str]):
        for url in target_urls:
            html = self.fetch(url)
            raw_list = self.parse(html)
            clean_records = []
            for item in raw_list:
                cleaned = self.clean(item, url)
                if cleaned:
                    clean_records.append(cleaned)
            self.store(clean_records)
            time.sleep(1.0)  # 礼貌抓取间隔

if __name__ == "__main__":
    # 示例运行调用
    pipeline = WebScraperPipeline("production.db")
    pipeline.run(["https://example.com/page/1", "https://example.com/page/2"])
实战避坑与合规原则
- 尊重 robots.txt 与服务负载:在对任何网站开展采集前,优先查看
/robots.txt了解允许抓取的目录范围。爬虫必须在每次请求之间添加随机睡眠间隔(如time.sleep(random.uniform(1.0, 2.5))),切忌并发突发压垮目标服务器。 - 动态渲染应对策略:若目标页面的关键内容是由前端 JavaScript 异步接口渲染(抓取到的HTML源码中无目标节点),不要强行使用正则表达式猜测,应优先在浏览器开发者工具(F12)的 Network 面板查找其真实的 JSON 数据接口;若接口带有复杂签名,再考虑使用 Playwright 或 Selenium 等无头浏览器方案。
- 字符编码混乱排查:如果解析出的文本出现形如
ä或“锟斤拷”等乱码,切忌直接盲改代码,应打印response.encoding与response.apparent_encoding,优先采用apparent_encoding赋值后再读取response.text,或直接读取response.content.decode('utf-8', 'ignore')。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















