


Python交互式解释器与直接运行脚本有什么区别

在 Python 编程实践中,开发者既可以在终端直接输入 python 进入带有 >>> 提示符的交互式解释器,也可以编写好 .py 文件并通过 python script.py 命令直接运行。二者的根本区别在于执行生命周期与运行时状态的持续性:交互式解释器采用“读取-求值-打印-循环”(REPL)机制,按行增量编译并持续保留全局命名空间与内存对象;而直接运行脚本则是将整个文件一次性编译并按序执行,任务完成后或遭遇未捕获异常时立即终止进程并完全回收系统资源。理解这两者的机制差异,是高效调试代码与构建可靠工程软件的基础。
一、执行生命周期与架构流程差异
Python 解释器在不同启动模式下的底层运行逻辑具有明显分工。在交互模式中,解释器将终端作为直接交互接口,用户每输入一个独立语句或代码块,解释器便对其单独进行语法树解析、字节码编译和求值,随后立即返回提示符等待下一条指令。而在脚本执行模式中,解释器将指定的文件视为一个完整的编译单元,必须预先完成整体语法分析,再从文件的第一行代码顺序执行至最后一行。
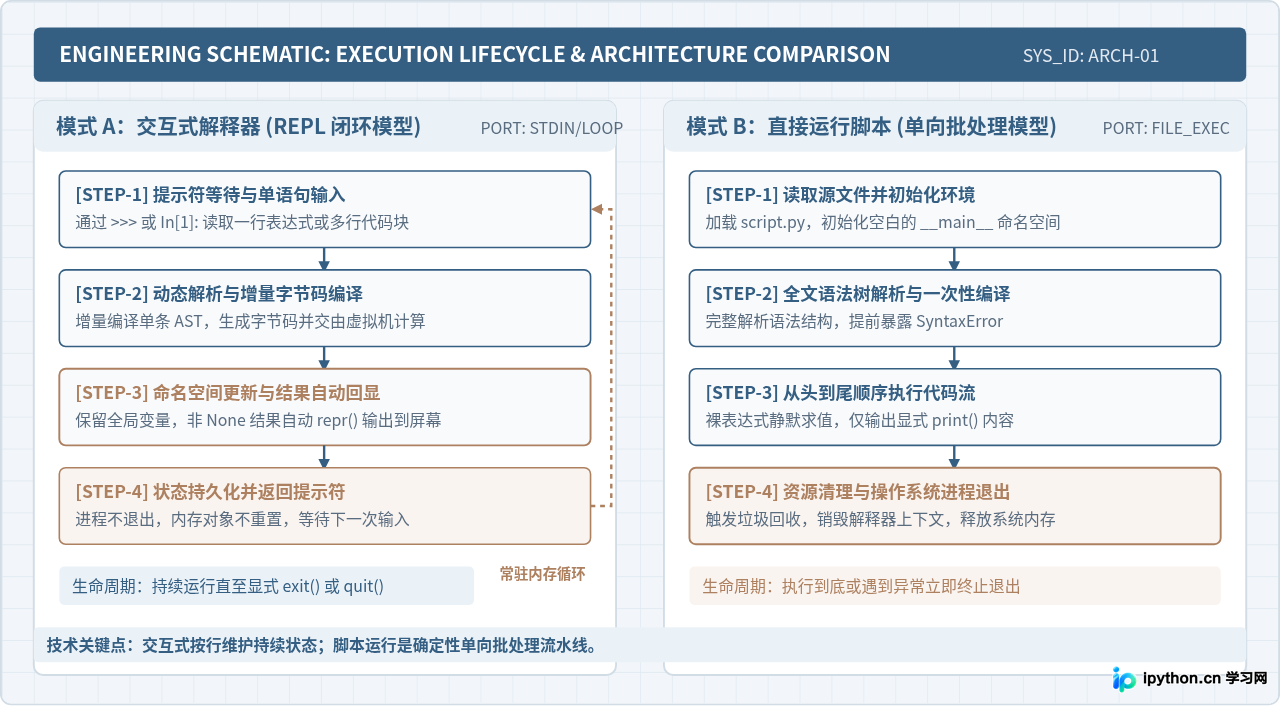
在直接运行脚本时,解释器在正式执行任何具体语句前,就会对整个文件进行一次词法与语法扫描。如果在文件末尾存在一处拼写或括号缺失导致的语法错误(SyntaxError),整篇脚本将在第 1 行代码执行前直接报错终止;但在交互式环境中,语法检查仅针对当前敲入的代码块,前面已成功执行的代码和变量状态已经实实在在地生效并驻留在内存中。
二、变量作用域与内存状态驻留机制
状态的持久性是交互式解释器最具价值的特性之一。在交互式会话期间,全局命名空间(即 globals() 字典)是一个持续增长的活体容器。用户导入的第三方库、定义的函数、实例化的类对象以及赋值的变量,均常驻于 Python 虚拟机的堆内存中,只要会话未被关闭,后续指令均可直接引用这些对象,无需重复执行昂贵的初始化操作。
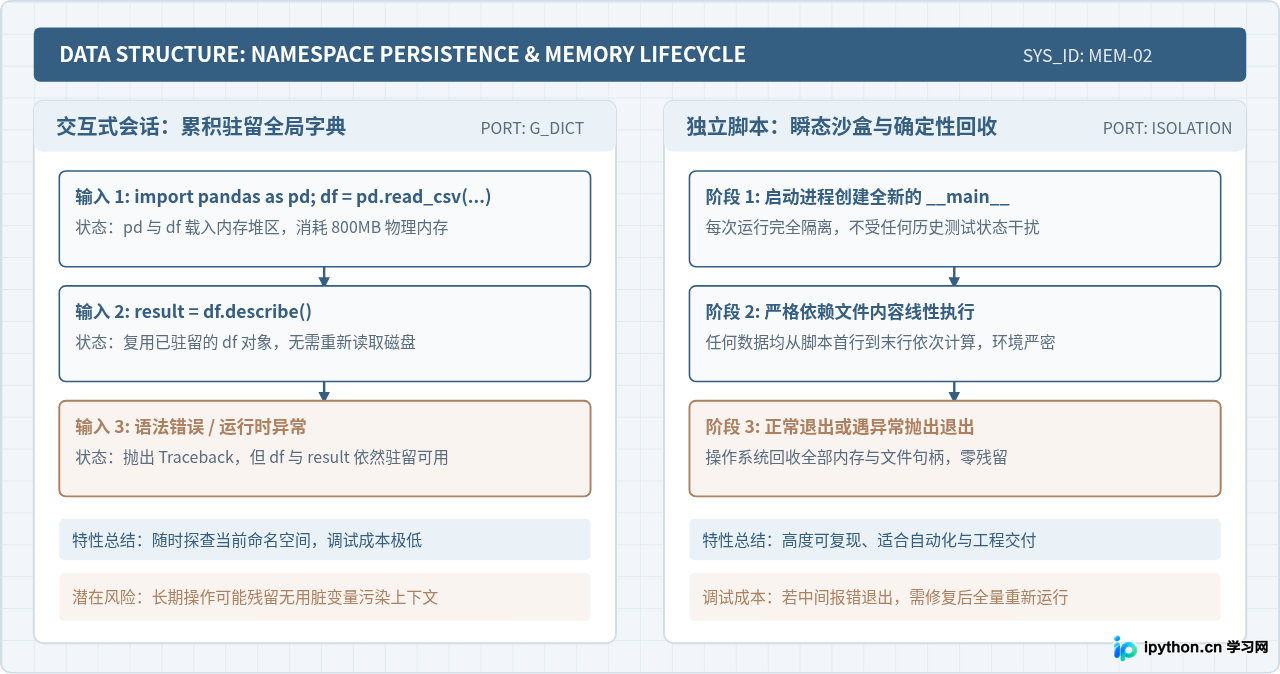
例如在进行复杂数据分析或机器学习模型推理时,加载一份庞大的数据集往往需要数秒乃至数分钟:
# 在交互式解释器中执行
>>> import pandas as pd
>>> df = pd.read_csv('heavy_dataset.csv')  # 仅需等待载入一次
>>> df.shape
(500000, 24)
>>> df.head(3)  # 之后可以反复尝试不同切片和计算,无需重新读取文件
如果将上述逻辑写在独立脚本 process.csv.py 中并直接运行:每次通过命令行敲击 python process.csv.py,Python 进程都会经历“分配全新内存空间 → 从磁盘全量读取 CSV → 执行计算 → 退出进程并释放内存”的完整流程。这种完全隔离的机制保障了每次运行的环境纯洁性,但同时也失去了交互探查时的快速迭代优势。
三、表达式求值与结果回显差异
在日常书写代码时,最直观的体验差异体现在终端输出机制上。在交互式解释器中,只要用户输入的语句属于“表达式”(Expression)且求值结果不是 None,解释器内部的 sys.displayhook 钩子函数就会自动拦截该结果,调用其内置的 repr() 方法并将格式化文本直接回显在终端屏幕上。同时,Python 还提供了特殊的单下划线变量 _,用于自动保存最近一次表达式的计算结果。
# 交互式解释器的表达式回显与 _ 特殊变量
>>> 25 * 4
100
>>> _ + 50
150
>>> text = "hello python"
>>> text.upper()
'HELLO PYTHON'
而在直接运行脚本时,Python 不会自动触发 sys.displayhook。在脚本文件中书写裸表达式(如单独一行 25 * 4 或 text.upper())虽然语法合法,但其计算结果会被解释器直接丢弃,终端没有任何可见字符。在脚本中呈现数据,必须显式调用 print() 函数或使用日志输出模块:
# 脚本文件 script_output.py 中的标准做法
text = "hello python"
text.upper()  # 静默求值,不会产生任何终端输出

print(text.upper())  # 显式输出:HELLO PYTHON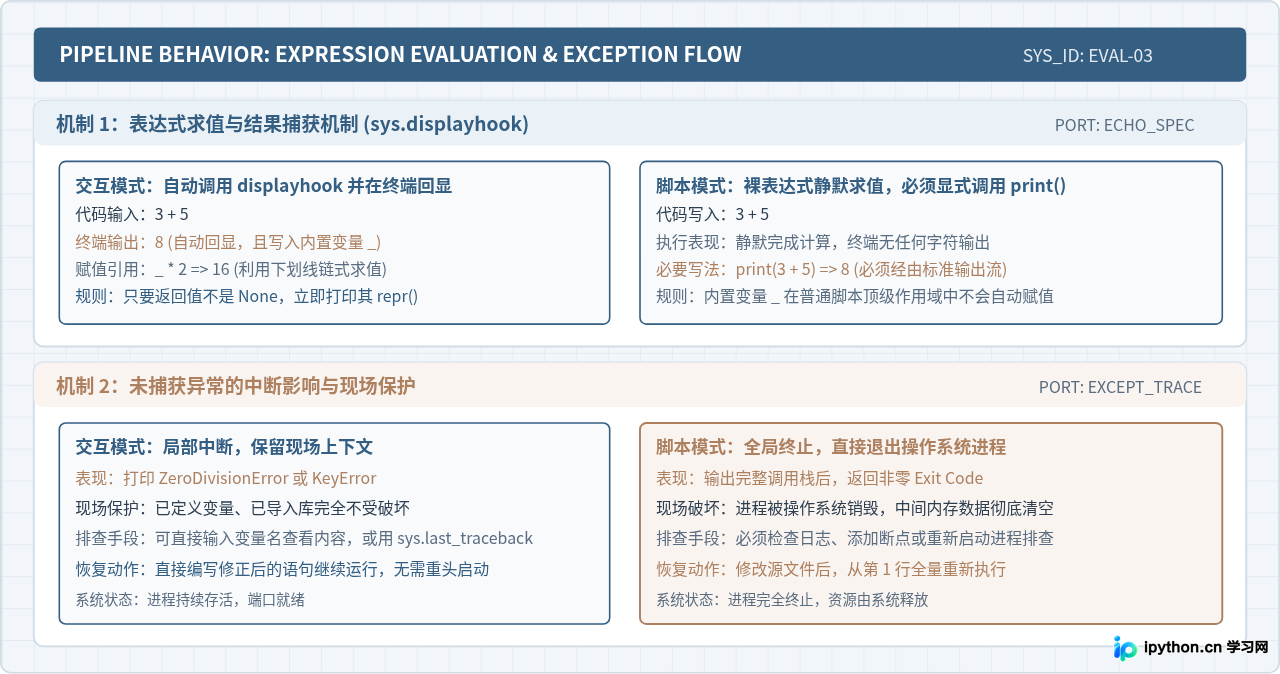
四、异常中断与调试排查现场保护
代码在运行过程中发生未捕获异常时,两种运行模式的表现有着本质差别:
- 交互式解释器现场保留:当某条语句触发
KeyError或ZeroDivisionError时,解释器仅在屏幕上输出标准回溯信息(Traceback),但并不会杀死当前会话。此前已经创建的各种变量、数据库连接、已加载的数据结构仍然完好无损地保存在内存中。开发者可以立即输入变量名查看数据内部状态,分析报错原因,并直接输入修正后的代码继续运行。 - 直接运行脚本进程销毁:脚本在没有编写
try...except保护的情况下抛出异常,Python 虚拟机会打印错误调用栈并立刻向操作系统返回非零退出码。整个进程瞬间终止,所有中间计算结果与局部变量直接随内存释放而蒸发。如果需要定位问题,通常必须重新添加打印日志,或者在代码中显式插入breakpoint()进入 pdb 调试器后重新完整运行。
五、两种模式的核心特性横向对照
为了便于在工程开发中进行技术选型和判断,下表系统总结了两种模式在各维度的关键技术差异:
| 对比维度 | 交互式解释器 (REPL) | 直接运行脚本 (python file.py) |
|---|---|---|
| 代码执行粒度 | 按单行或输入块增量解析执行 | 以整个文件为单位预先编译并顺序执行 |
| 内存状态保留 | 在整个终端会话期间持续常驻 | 脚本运行完毕或报错后随进程退出立即释放 |
| 表达式求值回显 | 非 None 结果自动打印,支持 _ 暂存 |
裸表达式静默求值,必须显式调用 print() |
| 异常中断后果 | 打印错误但保留环境现场,会话不终止 | 未捕获异常导致整个 Python 进程崩溃退出 |
| 入口识别 __name__ | 顶级作用域固定为 '__main__' |
入口文件为 '__main__',被导入时为模块名 |
| 代码持久化 | 临时会话,窗口关闭即完全消失 | 物理保存在磁盘文件,支持版本控制与审计 |
六、开发场景与工程选型指导
在真实的软件工程与数据科学工作中,交互式解释器与脚本运行并不是相互替代的关系,而是形成了一个分工明确的闭环工作流。
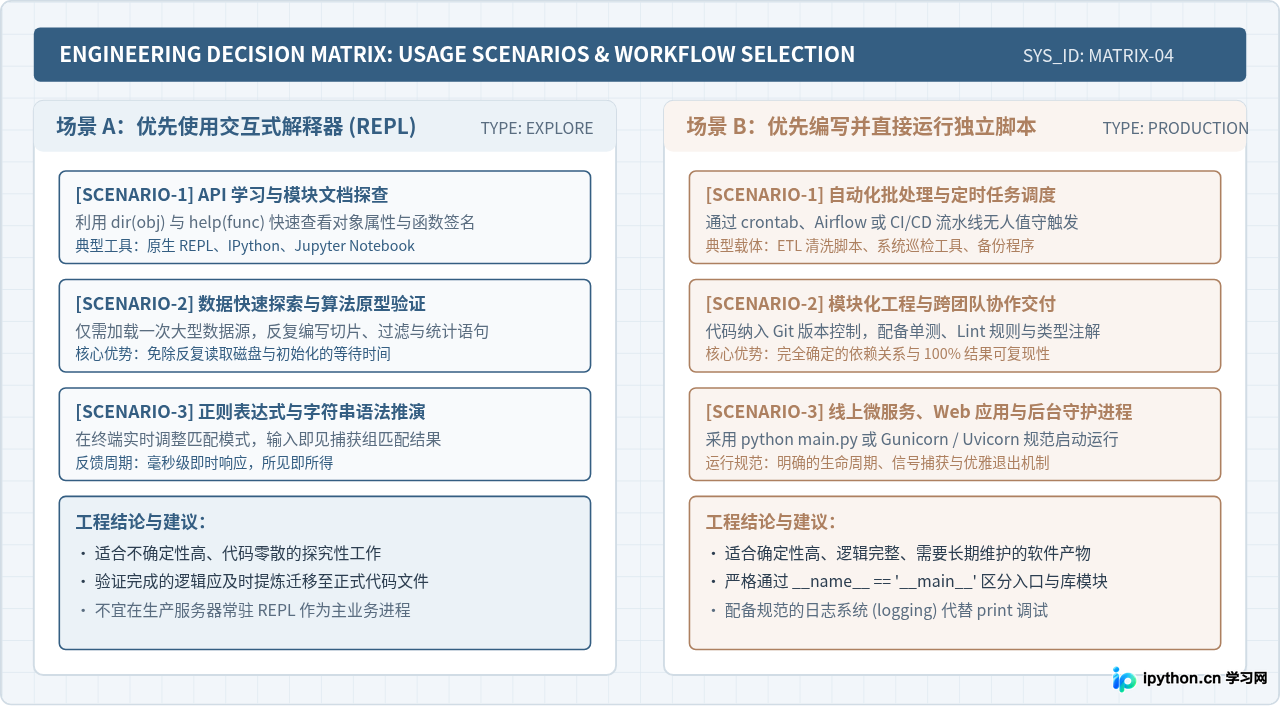
1. 适合使用交互式解释器的典型场景
- 语法与标准库即时探查:当记不清某个函数的参数顺序或返回值格式时,无需查阅网页文档,直接在终端中调用
dir(math)或help(str.split)即可获得最准确的就地文档。 - 算法逻辑与正则表达式微调:在编写复杂的正则提取或数据转换逻辑时,可以在解释器中准备一小段测试字符串,反复修改正则模式并观察匹配效果,获得毫秒级的即时反馈。
- 数据科学初期探索:借助增强型交互工具(如 IPython 或 Jupyter),在内存中保留大型表格对象,逐步执行数据清洗、统计分析和特征工程。
2. 适合编写并直接运行脚本的典型场景
- 自动化定时作业:无论是 Linux 系统下的
crontab,还是分布式调度器(如 Airflow、Celery),都依赖稳定、确定且能返回明确退出状态码的独立脚本文件。 - 生产业务系统与微服务:Web 服务(如基于 FastAPI 或 Django 构建的应用)需要标准化的入口文件、可复现的依赖管理以及严格的进程监控。
- 团队工程协作与交付:所有经过交互式验证的成熟逻辑,最终都必须整理进规范的模块与类中,编写完整的单元测试并纳入持续集成流水线。
七、实用技巧:桥接两者优势的 -i 参数
许多初学者往往忽视了 Python 命令行提供的一个实用参数:-i(Interactive 模式)。如果在运行脚本时附加该参数,例如执行:
python -i data_pipeline.pyPython 会先像普通脚本一样自顶向下完整执行 data_pipeline.py 中的所有代码。当脚本执行完毕(或者执行到报错位置)后,进程不会直接退出,而是就地停留在当前的交互式提示符 >>> 之中。此时,脚本中已经计算出的所有变量、函数和实例对象都保存在当前命名空间内,开发者可以直接通过终端对刚刚运行结束的代码现场进行细致探查与增量实验。这一机制完美兼顾了脚本的代码复用性与解释器的即时交互能力,是日常定位疑难缺陷的高效手段。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















