


Python基础语法详解:变量、数据类型与运算符
深度解析Python核心基础语法:从变量的引用标签机制,到数值、字符串、列表等核心数据类型的分类与可变性,再到算术、比较、逻辑运算符的运算规则与短路机制,结合完整内联SVG图示与避坑指南。
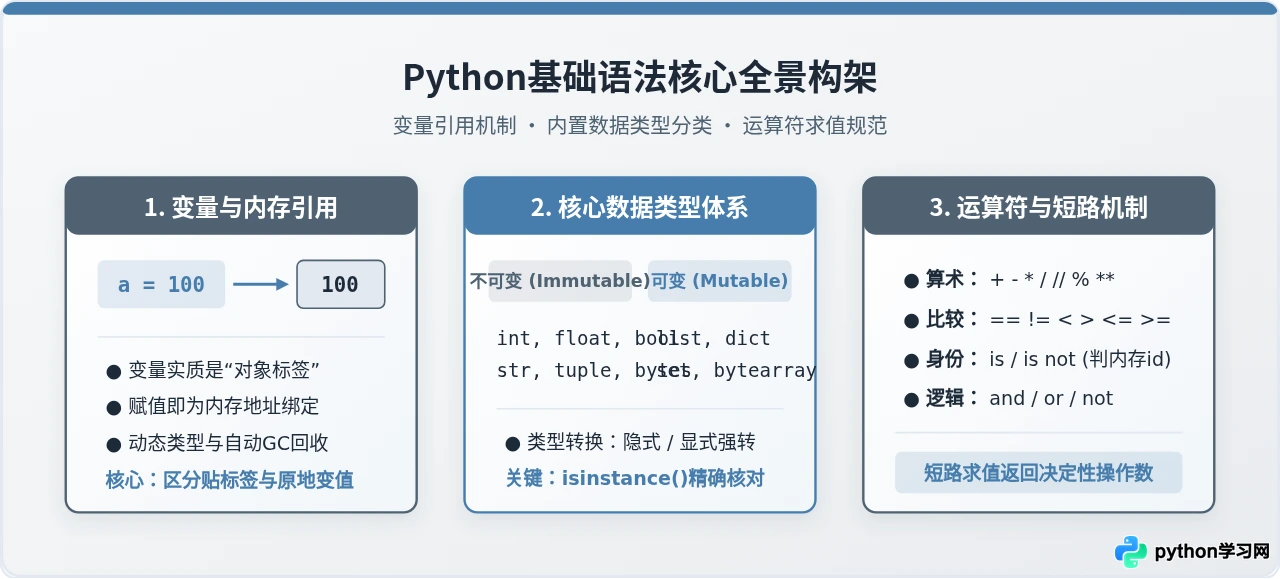
一、变量的本质:不是容器,而是“对象标签”
在许多编译型语言(如 C/C++)中,变量常被比作“盒子”:定义变量相当于向系统申请一块固定大小和类型的物理内存格子,赋值就是把数据填进格子里。但在 Python 中,这种比喻会导致严重的逻辑认知偏差。
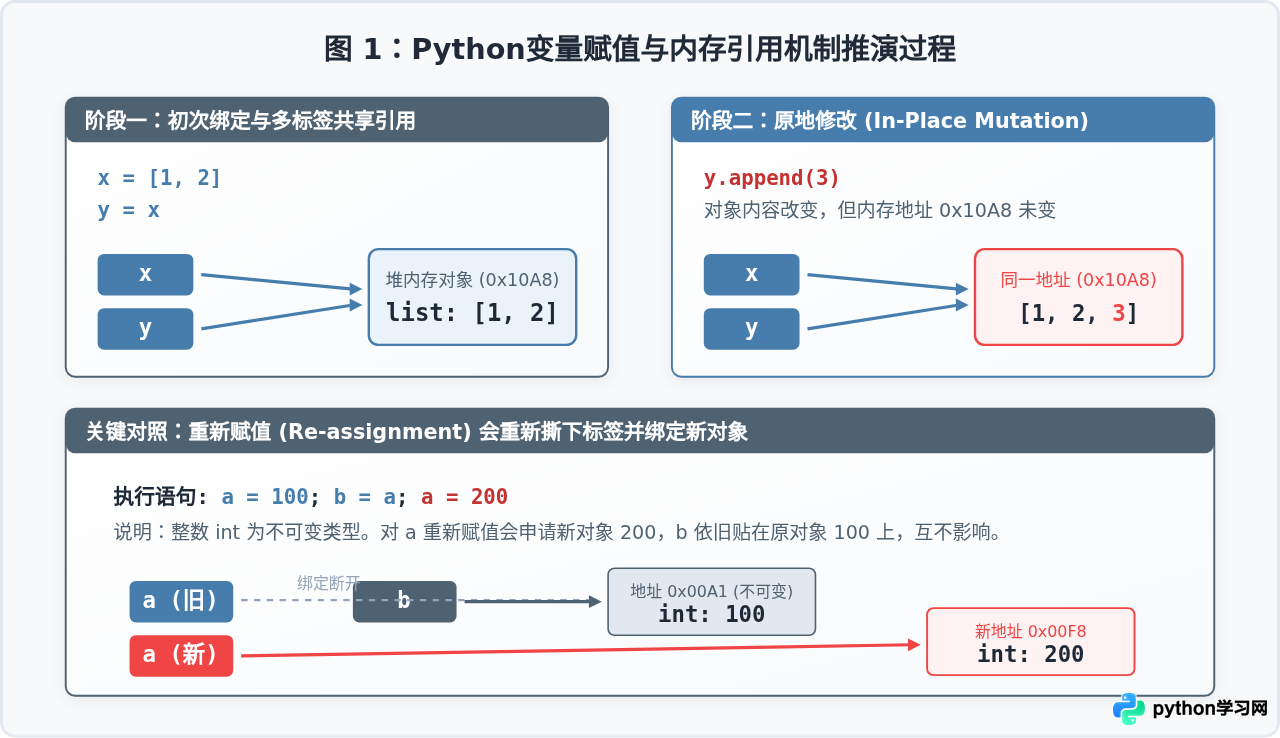
Python 的变量本质上是“便利贴”或“引用标签”。在 Python 中,所有数据(无论是整数、字符串还是复杂的列表、函数)都是独立存在于堆内存中的“对象”(Object)。当执行赋值语句时,Python 解释器先在内存中构建右侧的对象,然后将左侧的变量名像贴标签一样,与该对象的内存地址绑定起来。
1. 变量赋值与引用的三步推导过程
观察以下两段看似相似的代码,执行结果却截然不同:
# 场景 A:不可变整数对象的赋值与重新绑定
a = 100
b = a
a = 200
print("a:", a, "b:", b)
# 示例输出: a: 200 b: 100

# 场景 B:可变列表对象的引用共享与原地修改
x = [1, 2]
y = x
y.append(3)
print("x:", x, "y:", y)
# 示例输出: x: [1, 2, 3] y: [1, 2, 3]
要理解为什么 y.append(3) 会导致 x 的内容同步变化,必须理解 Python 解释器内部执行步骤:
- 步骤一(对象创建):解释器读取等号右侧表达式
[1, 2],在内存中分配地址(例如0x10A8),构建一个列表对象,包含指针分别指向元素 1 和 2。 - 步骤二(初次绑定):解释器处理变量名
x,在当前命名空间中将x映射到内存地址0x10A8。 - 步骤三(引用复制):执行
y = x。注意,这里完全没有复制列表数据本身,只是把x指向的地址0x10A8复制给了y。此时x与y贴在了同一个物理对象上。 - 步骤四(原地修改与再赋值差异):当调用
y.append(3)时,是在0x10A8原地(in-place)扩充数据,因此通过标签x查看自然也是[1, 2, 3];而若执行y = [9, 9],则是创建新对象并将y撕下来贴到新对象上,此时x不受任何影响。
2. 变量命名与多变量操作惯例
在编写 Python 代码时,变量命名遵循以下规则与约定:
- 语法强制限制:变量名必须以字母(a-z, A-Z)或下划线(
_)开头,后续字符只能是字母、数字(0-9)或下划线。大小写敏感(user与User是两个不同变量),且严禁使用 Python 关键字(如class,def,if,for等)。 - PEP 8 命名规范:普通变量与函数名采用小写蛇形命名法(
snake_case,例如student_count);常量(逻辑上不应修改的变量)采用全大写蛇形命名(例如MAX_RETRY_TIMES = 3)。 - 多变量解包赋值:Python 支持优雅的多变量一次性解包。例如交换两变量值无需临时变量:
a, b = b, a,其底层是先在右侧构造一个元组(b, a),随后按序解包绑定给左侧标识符。
二、核心数据类型体系及其内存行为
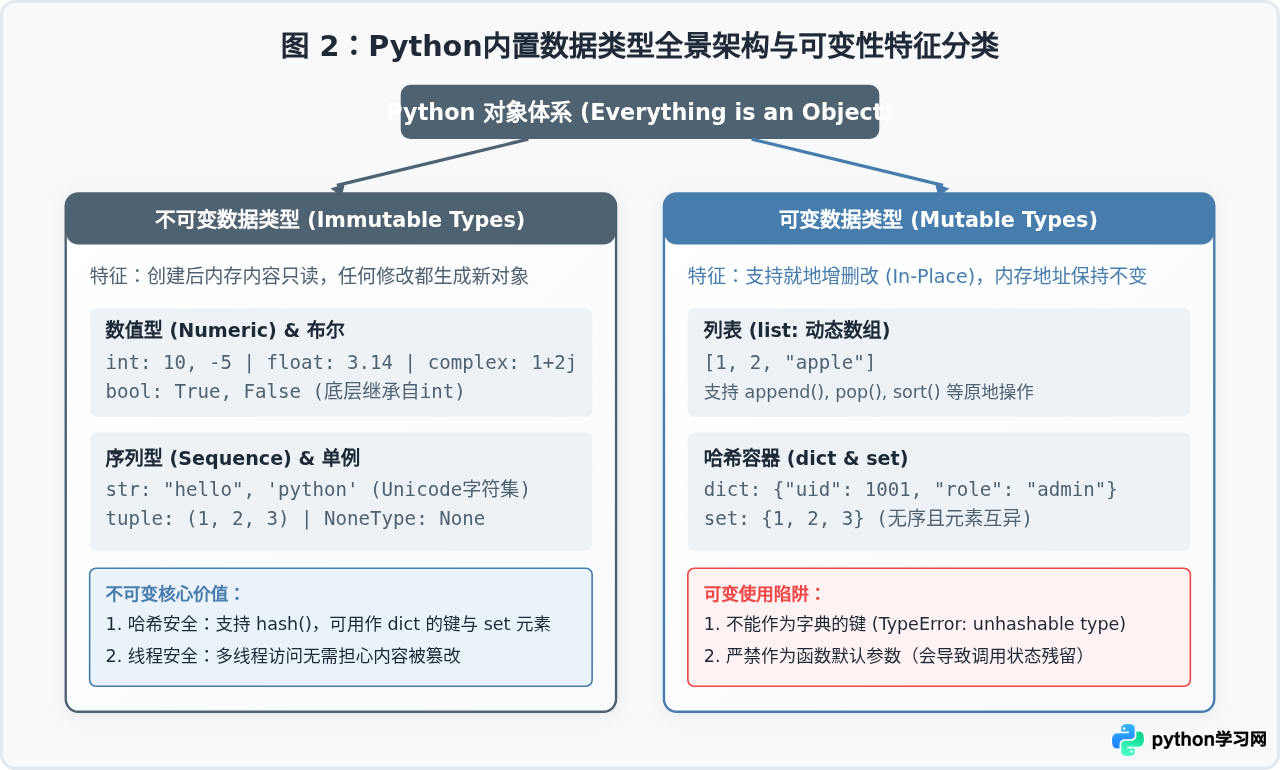
Python 是动态强类型语言:“动态”意味着变量声明时不需要显式指定类型,变量可以在运行期随意绑定到不同类型的对象;“强类型”意味着对象本身的类型是严格固定的,解释器不会在没有明确规则的情况下随意隐式混淆类型(例如字符串 "12" 与数值 3 直接相加 "12" + 3 会抛出 TypeError)。
1. 核心数据类型分类与特征
| 类型名称 | 类型标识 | 可变性 | 典型字面量示例 | 核心应用场景与注意事项 |
|---|---|---|---|---|
| 整型 (Integer) | int |
不可变 | 42, -10, 0b1010 |
精度无限制,支持任意大整数运算;避免溢出。 |
| 浮点型 (Float) | float |
不可变 | 3.14, -0.001, 2e-5 |
基于 IEEE 754 双精度浮点,存在微小舍入误差。 |
| 布尔型 (Boolean) | bool |
不可变 | True, False |
int 的子类,在算术计算中 True == 1, False == 0。 |
| 空值类型 (NoneType) | NoneType |
不可变 | None |
全局单例,常用于函数默认返回值或空占位符。 |
| 字符串 (String) | str |
不可变 | 'hello', "Python" |
Unicode 字符有序序列,支持切片,不可原地修改某一位。 |
| 列表 (List) | list |
可变 | [1, 'abc', 3.5] |
连续动态数组,支持增删改查及异构数据存储。 |
| 元组 (Tuple) | tuple |
不可变 | (1, 2, 'ok'), (42,) |
只读有序序列,常用于函数多值返回与字典键。 |
| 字典 (Dictionary) | dict |
可变 | {'id': 1, 'name': 'Bob'} |
基于哈希表的键值对映射,查找时间复杂度为 O(1)。键必须可哈希。 |
| 集合 (Set) | set |
可变 | {1, 2, 3} |
无序去重元素容器,常用于成员检测与交并补集合运算。 |
2. 类型转换与类型校验机制
在实际业务编码中,数据类型经常需要流转与校验:
- 隐式类型转换:在混合算术运算中,Python 会自动将窄类型提升为宽类型。例如
10 + 3.5会自动将整数10转为浮点数10.0,得到13.5。 - 显式强制转换:通过内置类型构造函数完成:
int("1024"):字符串转整数(非法字符将抛出ValueError);float("3.14"):转为浮点数;str(100):转为字符串"100";list((1, 2, 3)):元组强转为可变列表。
- 类型校验规范:推荐使用
isinstance(val, type)而非type(val) == type。因为isinstance()能够正确处理面向对象的继承关系(例如isinstance(True, int)为True),同时支持多类型元组判定isinstance(x, (int, float))。
三、运算符与表达式求值规则
运算符负责指示解释器对操作数执行何种计算。Python 的运算符涵盖算术运算、比较运算、逻辑运算与身份/成员运算,每一类都有明确的求值边界与注意事项。
1. 算术运算符及数学边界
除常规的加(+)、减(-)、乘(*)外,以下四个算术符号需特别区分:
- 真除法
/:在 Python 3 中,即便两数皆为整型且能整除,结果也始终为浮点数(例如4 / 2结果为2.0)。 - 整除法
//(向下取整):执行除法并向负无穷方向取整(floor)。正数整除符合直觉(7 // 2得3);负数整除需格外留意(-7 // 2的结果是-4,而非-3)。 - 取模
%:返回余数,数学上满足公式r = a - (a // b) * b。因此-7 % 2的结果为-7 - (-4 * 2) = 1。 - 幂运算
**:2 ** 3得到8;支持浮点数开方9 ** 0.5得3.0。其结合性为右结合(即2 ** 3 ** 2相当于2 ** (3 ** 2) = 512)。
2. 比较运算符与身份运算符(== 与 is 的核心差异)
比较运算符包括 ==, !=, >, <, >=, <=。返回布尔值 True 或 False。Python 支持罕见的“链式比较”,例如 1 < x < 10 等价于 (1 < x) and (x < 10),且 x 仅被求值一次。
== 与 is 的边界区别●
a == b(值相等性):调用对象内部的 __eq__() 方法,核对两者的数据内容是否相等。●
a is b(同一性):比对 id(a) == id(b),核对两者是否为同一个内存地址。对
None 的比对,官方规范要求必须使用 if x is None:,因为 None 是全局唯一单例。
3. 逻辑运算符与“短路求值”特性
Python 的逻辑运算符包括 and(与)、or(或)、not(非)。与其他语言不同,Python 中的 and 和 or 不一定返回布尔值,而是返回直接决定结果的操作数本身:
- 短路规则
A and B:如果A的布尔真值为假,计算直接终止,并返回A;如果A为真,则计算并返回B。 - 短路规则
A or B:如果A的布尔真值为真,计算直接终止,并返回A;如果A为假,则计算并返回B。
# 短路求值示例代码
res1 = "Hello" and 123
print(res1)
# 示例输出: 123 (因 "Hello" 为真,必须继续计算并返回右侧的 123)

res2 = [] and "Never Executed"
print(res2)
# 示例输出: [] (因 [] 为假,触发短路,直接返回 [])

res3 = 0 or "Default Val"
print(res3)
# 示例输出: Default Val (0 为假,返回右侧的默认值)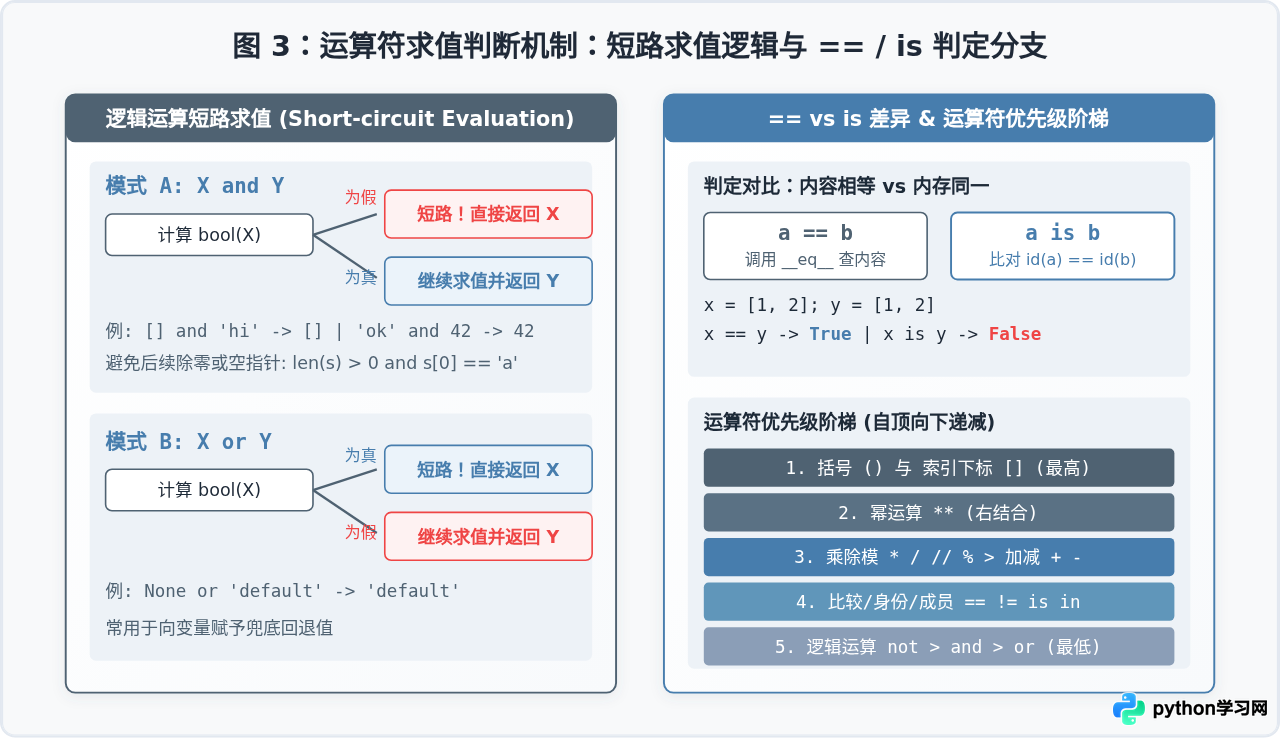
四、三者协同实践与避坑排查指南
在工程实践中,变量的标签性质、数据类型的可变性以及运算符的运算边界通常交织在一起。下面通过一个贴合生产实际的数据清洗校验案例,演示三者的协同运作。
1. 综合实战:用户输入数据清洗与合法性断言
# 模拟从外部接口获取的原始未清洗数据字典
raw_payload = {
    "username": "  alice_tech  ",
    "age": "24",
    "roles": None,
    "score": "98.5"
}

# 协同 1:通过字符串处理与显式转换提取类型
clean_user = raw_payload["username"].strip()
# 协同 2:利用短路机制赋予默认列表(避免 NoneType 异常)
user_roles = raw_payload["roles"] or ["guest"]
# 协同 3:安全数值转换
user_age = int(raw_payload["age"])
user_score = float(raw_payload["score"])

# 协同 4:综合链式比较与成员运算符判定合法性
is_valid_user = (
    len(clean_user) >= 3
    and (18 <= user_age <= 65)
    and ("guest" in user_roles or "admin" in user_roles)
)

print("清洗后用户名:", clean_user)
print("分配权限:", user_roles)
print("综合校验是否通过:", is_valid_user)
# 示例输出:
# 清洗后用户名: alice_tech
# 分配权限: ['guest']
# 综合校验是否通过: True
2. 高频开发陷阱与应对清单
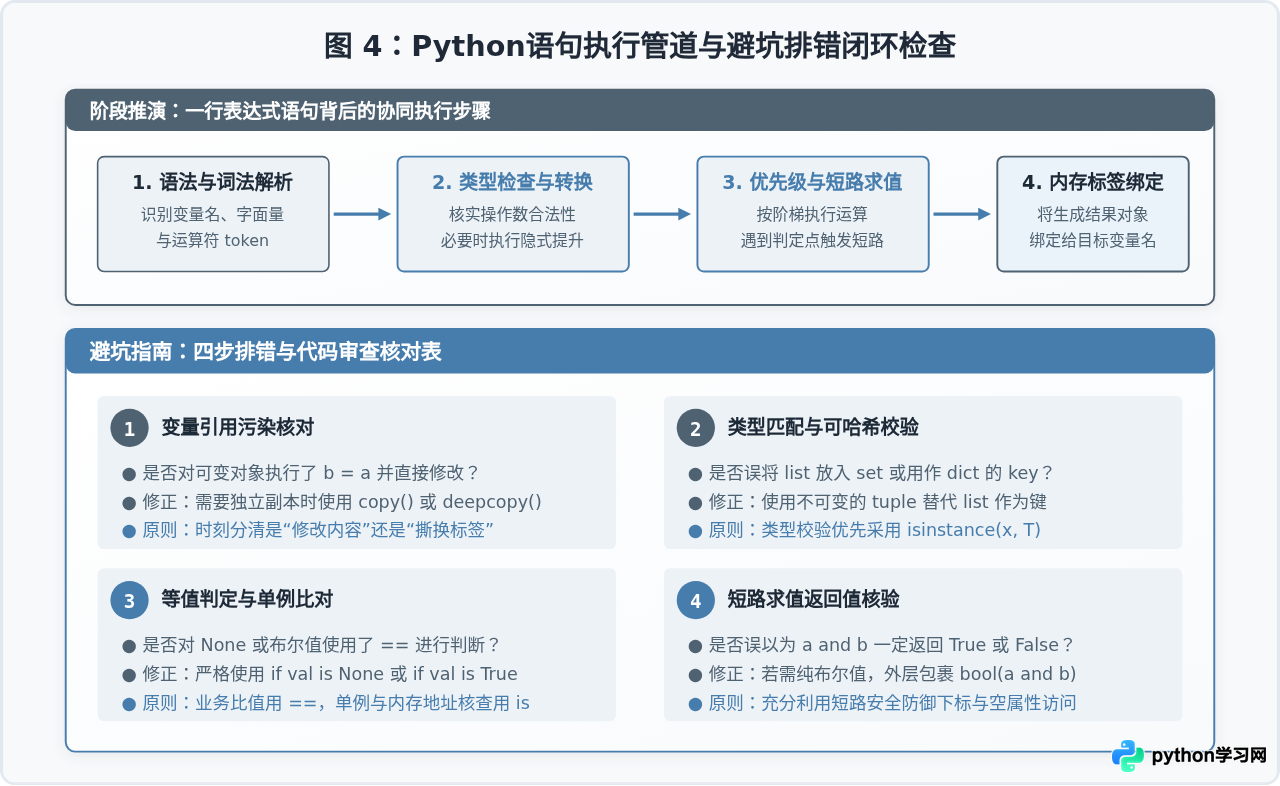
- 浮点数直接比较陷阱:由于底层二进制浮点舍入,
0.1 + 0.2 == 0.3返回False。在涉及高精度计算时,应使用标准库math.isclose(a, b, rel_tol=1e-9)或decimal.Decimal进行处理。 - 浅拷贝导致的状态污染:使用
b = a.copy()或b = a[:]仅复制顶层容器。如果列表内部嵌套了子列表或字典,修改b[0].append(...)仍然会污染a。对于多层嵌套结构,应使用import copy; b = copy.deepcopy(a)。 - 默认参数可变对象陷阱:在函数定义时,严禁写成
def append_item(val, container=[]):。因为函数的默认参数对象在模块加载时仅创建一次,多次调用会不断累加旧状态。标准写法为container=None并在函数内部初始化if container is None: container = []。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















