


Python正则表达式完整代码实例:复杂文本匹配与替换实战
本文深入讲解Python正则表达式处理高复杂度文本匹配与替换的核心技术,涵盖命名捕获组、零宽断言、VERBOSE可读性编译、基于Callable回调的高级动态替换实战及灾难性回溯避坑指南。
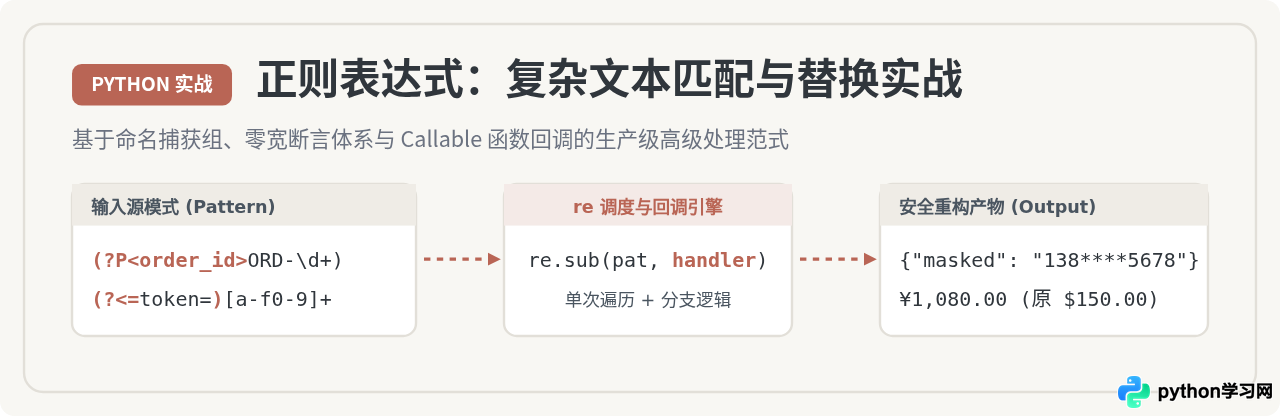
在处理非结构化系统日志、动态敏感数据脱敏、跨币种金额换算以及富文本清理等工程任务时,基础的字符串方法(如 str.split() 或简单的字符替换)往往难以应对上下文交错、多分支嵌套的复杂场景。解决复杂文本处理的核心路径在于:利用 re.compile 搭配 re.VERBOSE 标志位构建具备注释与层次的高可读性正则;通过命名捕获组(Named Groups)与零宽断言(Lookaround Assertions)实现不破坏游标的精确定位;最终借助 re.sub 的 Callable 函数回调机制,将复杂的业务逻辑注入单次文本扫描中,实现兼顾可维护性与线性性能的替换闭环。
一、复杂文本匹配的基石:命名捕获组与零宽断言
当正则表达式匹配的目标包含多个业务字段时,使用默认的数字索引(如 match.group(1)、group(2))极易因为后续微调模式而引发索引漂移灾难。Python 提供了语法完备的命名捕获组,通过显式语义消除索引耦合。
与此同时,零宽断言(Lookaround)允许我们在不“消费”(Consume)字符的前提下,对匹配目标的前后邻接环境设置严格的条件约束。例如,我们希望提取某个键名后面的数值,但不需要把键名本身纳入匹配结果,此时正向后顾断言(Positive Lookbehind)便能派上用场。
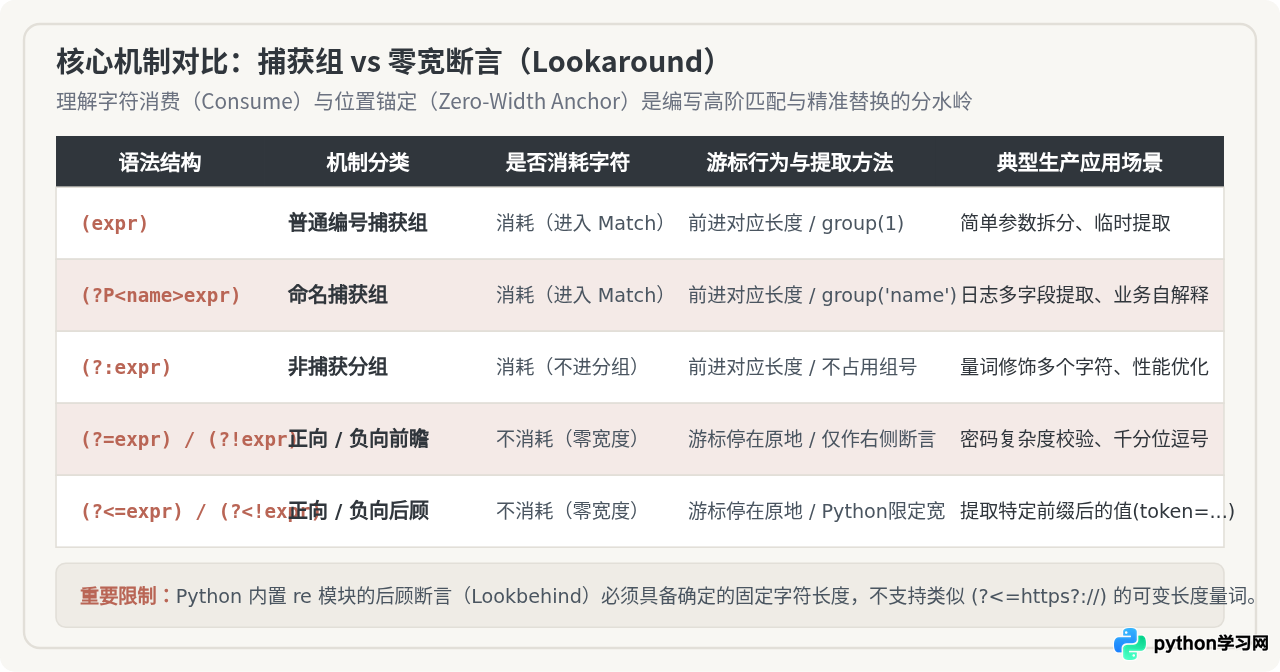
与其他编程语言(如 JavaScript ES2018+ 或 PCRE 库)不同,Python 内置的 re 模块对后顾断言 (?<=...) 和 (?<!...) 要求其内部表达式必须具有固定长度。类似 (?<=https?://) 或 (?<=\d+) 这种包含不确定长度量词的写法会在编译阶段直接抛出 re.error: look-behind requires fixed-width pattern 异常。若需支持可变长后顾,可改用第三方 regex 库或通过非捕获前置组进行结构化拆解。
二、标准化操作流程:复杂正则的执行生命周期
在生产级 Python 代码中,书写与执行复杂正则表达式不能随意调用顶层快捷函数。一套清晰、健壮的流水线包括从模式预编译、标志位配置、游标扫描到最终产物封装的五个标准化步骤。
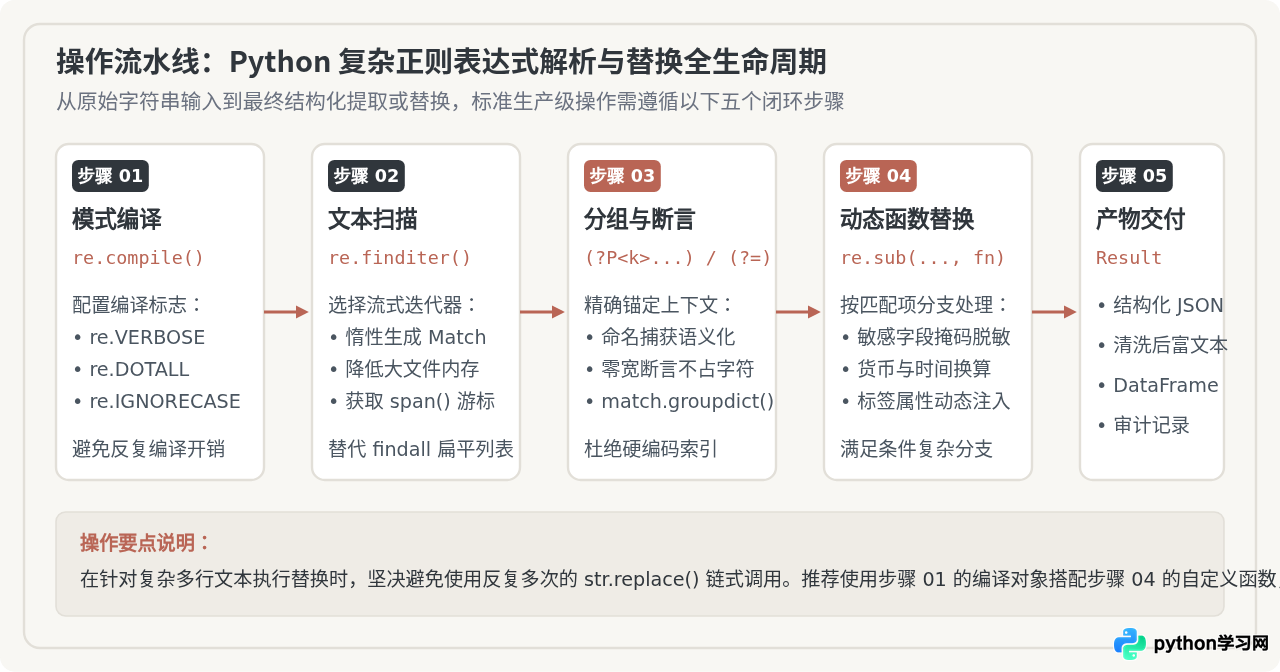
特别地,针对大量日志行或长文本文档,应优先选用 re.finditer() 而非 re.findall()。re.finditer() 返回惰性迭代器,不仅能大幅减轻瞬时内存占用,还为每个匹配项保留了完整的 Match 对象,使我们能够直接获取匹配位置区间 span() 与字典映射 groupdict()。
三、实战案例一:高复杂度多源系统日志的结构化提取
在分布式微服务运维中,日志往往交织着时间戳、日志级别、调用链路节点、网络标识、请求动词与查询参数、状态码以及 JSON 格式的业务负载。以下代码演示如何利用 re.VERBOSE 编写清晰的自解释模式,并一次性完成全部维度的结构化抽取。
1. 完整运行代码
import re
from typing import Dict, Any, List

# 模拟真实微服务混合审计日志
RAW_LOG_DATA = """
2026-11-01 10:14:22.812 [INFO] [auth-service] User: alice (ip=192.168.1.105) Action: "POST /api/v2/tokens?type=oauth" Status: 200 Duration: 42ms Payload: {"grant_type": "password"}
2026-11-01 10:14:25.109 [WARN] [payment-gateway] User: bob (ip=10.0.8.22) Action: "GET /api/v2/orders/ORD-98213?currency=USD" Status: 404 Duration: 128ms Payload: {"error": "not_found"}
2026-11-01 10:14:28.940 [ERROR] [order-worker] User: system (ip=127.0.0.1) Action: "DELETE /api/v1/jobs/batch-77" Status: 500 Duration: 1045ms Payload: {"reason": "timeout"}
"""

# 使用 re.VERBOSE 编写结构清晰、包含注释的多行正则
LOG_PATTERN = re.compile(
    r"""
    ^                                                    # 行首锚定
    (?P<timestamp>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2}\.\d{3})\s+  # 毫秒时间戳
    \[(?P<level>[A-Z]+)\]\s+                             # 日志级别: INFO/WARN/ERROR
    \[(?P<service>[\w\-]+)\]\s+                          # 服务组件名称
    User:\s(?P<user>\w+)\s+                              # 触发用户名
    \(ip=(?P<ip>(?:\d{1,3}\.){3}\d{1,3})\)\s+            # IPv4地址
    Action:\s"(?P<method>[A-Z]+)\s                       # 请求HTTP动词
    (?P<path>/[^?\s"]*)                                  # 请求路径URI
    (?:\?(?P<query>[^"]*))?"\s+                          # 可选URL查询串 (非捕获组内嵌命名组)
    Status:\s(?P<status>\d{3})\s+                       # HTTP返回码
    Duration:\s(?P<duration_ms>\d+)ms\s+                 # 响应耗时
    Payload:\s(?P<payload>\{.*?\}Python正则表达式完整代码实例:复杂文本匹配与替换实战)$                    # JSON负载片段 (惰性匹配至行尾)
    """,
    re.VERBOSE | re.MULTILINE
)

def parse_audit_logs(log_text: str) -> List[Dict[str, Any]]:
    parsed_records = []
    # 使用 finditer 流式迭代,获取完整的 Match 对象
    for match in LOG_PATTERN.finditer(log_text.strip()):
        data = match.groupdict()
        # 类型转换与语义增强
        data["status"] = int(data["status"])
        data["duration_ms"] = int(data["duration_ms"])
        parsed_records.append(data)
    return parsed_records

if __name__ == "__main__":
    records = parse_audit_logs(RAW_LOG_DATA)
    for idx, r in enumerate(records, 1):
        print(f"记录 #{idx}: {r}")
2. 执行输出结果(示例)
在上述实现中,(?:\?(?P<query>[^"]*))? 展示了非捕获分组与可选命名捕获组的结合:外部的 (?:...)? 允许该部分完全缺省(如第 3 行日志没有 ?query 参数时,data["query"] 自动解析为 None),避免因为缺少可选字段而导致整行模式匹配失败。
四、实战案例二:基于 Callable 回调的动态替换与条件脱敏
传统的 re.sub(pattern, repl, string) 中,如果替换目标依赖复杂的动态计算(例如不同字段执行不同脱敏算法、将美元汇率折算为人民币、或根据时间戳动态格式化),静态字符串模板(如 r'\g<name>')完全无法满足需求。
Python 允许向 re.sub 的第二个参数传入一个可调用对象(Callable)。正则引擎每次成功匹配,都会将当前的 Match 对象传入该回调函数,并以函数的返回值作为替换文本。
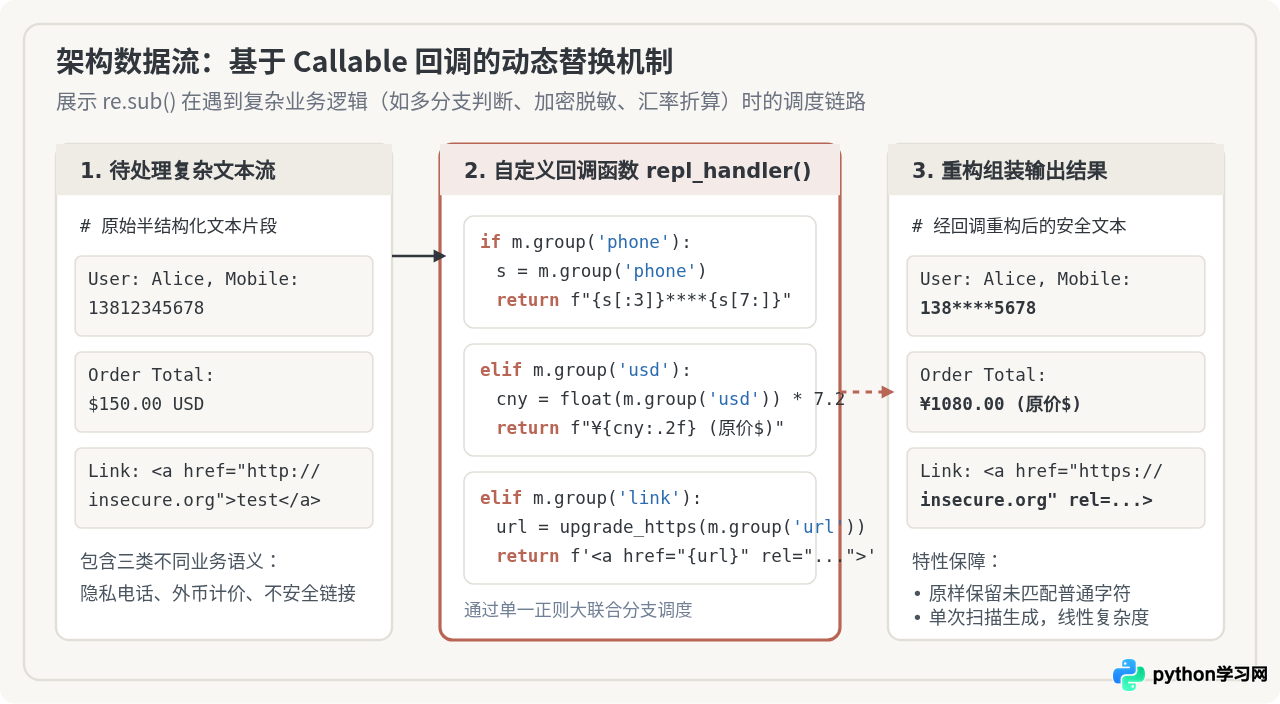
1. 完整运行代码
import re

# 包含敏感信息与跨币种金额的原始财务工单
ORDER_DOCUMENT = """
客户订单汇总(机密):
1. 客户:张伟,手机号:13812345678,身份证:110101199003072345,消费金额:$120.50
2. 客户:李娜,手机号:15987654321,身份证:31010419881215452X,消费金额:$3450.00
3. 客户:王强,手机号:18666889900,身份证:440301199505201123,消费金额:$85.00
"""

# 通过单一联合正则同时捕获手机号、身份证号与美元金额
# 使用零宽负向后顾 (?<!\d) 与负向前瞻 (?!\d) 确保提取的是独立号码,而非更长数字序列的一部分
SECURITY_REPLACE_PATTERN = re.compile(
    r"""
    (?P<mobile>(?<!\d)1[3-9]\d{9}(?!\d))
    |
    (?P<idcard>(?<!\d)\d{17}[\dXx](?!\d))
    |
    (?P<usd>\$(?P<amount>\d+(?:\.\d{2})?))
    """,
    re.VERBOSE
)

# 动态汇率转换常量
USD_TO_CNY_RATE = 7.20

def dynamic_entity_replacer(match: re.Match) -> str:
    """
    根据当前匹配项所属的命名捕获组,分发到对应的业务处理逻辑
    """
    # 场景 1: 手机号掩码脱敏 (保留前3后4,中间4位掩盖)
    if match.group("mobile"):
        raw_phone = match.group("mobile")
        return f"{raw_phone[:3]}****{raw_phone[7:]}"

    # 场景 2: 身份证号掩码脱敏 (保留前6后4,中间8位掩盖)
    elif match.group("idcard"):
        raw_id = match.group("idcard")
        return f"{raw_id[:6]}********{raw_id[14:]}"

    # 场景 3: 美元消费金额动态转换为人民币展示,并保留原美元参考
    elif match.group("usd"):
        raw_amount = float(match.group("amount"))
        cny_amount = raw_amount * USD_TO_CNY_RATE
        return f"¥{cny_amount:,.2f}(折合 ${raw_amount:.2f})"

    # 保底返回原始内容
    return match.group(0)

def sanitize_and_convert_orders(raw_text: str) -> str:
    # 单次遍历完成所有维度的脱敏与换算,未匹配的普通文本原样保留
    return SECURITY_REPLACE_PATTERN.sub(dynamic_entity_replacer, raw_text)

if __name__ == "__main__":
    sanitized_text = sanitize_and_convert_orders(ORDER_DOCUMENT)
    print(sanitized_text.strip())
2. 执行输出结果(示例)
这种通过联合分支(Branch A | Branch B | Branch C)结合单个调度函数的方案,相比在代码中写多个循环执行多次 re.sub(),其最大优势在于单趟扫描(Single-pass Scanning)。无论文档体积多大,文本只被状态机遍历一次,极大降低了时间复杂度与临时字符串分配成本。
五、实战案例三:HTML 富文本清洗与链接属性重构
在内容管理系统(CMS)或爬虫数据入库环节,我们常需要清洗带有安全风险的不规范 HTML 片段:剔除 <script> 与 <style> 等高危代码块、剥离 onclick 等内联事件监听器,同时对所有外部超链接进行重构——将不安全的 http:// 升级为 https://,并强制注入 rel="noopener noreferrer" 以抵御反向标签劫持。
1. 完整运行代码
import re

DIRTY_HTML_CONTENT = """
<div class="content" style="color: red; font-size: 16px;">
    <h1>文章标题</h1>
    <p>点击访问 <a href="http://example.com/login" target="_blank" onclick="steal()">用户中心</a> 查看详情。</p>
    <script type="text/javascript">alert("XSS Vulnerability");</script>
    <p>图片:<img src="http://img.example.com/pic.jpg" alt="封面" style="width:100%" /></p>
    <a href="https://secure.site.org/docs" class="btn">安全文档</a>
</div>
"""

def clean_and_harden_html(html_str: str) -> str:
    # 步骤 1: 剥离整个 script 和 style 块(包含内部所有代码)
    # 使用 [^>]*? 限制标签内部,避免跨标签贪婪过度消费
    no_scripts = re.sub(
        r"<(?:script|style)[^>]*>[\s\S]*?</(?:script|style)>",
        "",
        html_str,
        flags=re.IGNORECASE
    )

    # 步骤 2: 剥离所有的内联 JavaScript 事件处理器 (如 onclick, onload, onerror)
    no_events = re.sub(
        r"\s+on[a-z]+\s*=\s*(?:\"[^\"]*\"|'[^']*'|[^\s>]+)",
        "",
        no_scripts,
        flags=re.IGNORECASE
    )

    # 步骤 3: 提取 <a> 标签重构链接协议并注入安全属性
    # 使用命名捕获组精准截获 href 的引号类型、目标URL以及前后伴随属性
    link_pattern = re.compile(
        r"""
        <a\b                                            # a 标签词界
        (?P<before>[^>]*?)                              # href 之前的属性
        \bhref=(?P<quote>["'])(?P<url>[^"']+)(?P=quote) # href 属性与匹配相同引号
        (?P<after>[^>]*?)                               # href 之后的属性
        >
        """,
        re.VERBOSE | re.IGNORECASE
    )

    def link_transformer(match: re.Match) -> str:
        before = match.group("before")
        quote = match.group("quote")
        url = match.group("url")
        after = match.group("after")

        # 针对 http 协议实施协议升级
        if url.startswith("http://"):
            url = "https://" + url[7:]

        # 清除原可能存在的旧 rel 属性,防止属性重复堆叠
        combined_attrs = f"{before} {after}".strip()
        cleaned_attrs = re.sub(r"\brel=(?:\"[^\"]*\"|'[^']*')", "", combined_attrs, flags=re.IGNORECASE)
        # 规整化多余的连续空白符
        cleaned_attrs = re.sub(r"\s+", " ", cleaned_attrs).strip()

        attr_segment = f" {cleaned_attrs}" if cleaned_attrs else ""
        return f'<a href={quote}{url}{quote}{attr_segment} rel="noopener noreferrer">'

    hardened_html = link_pattern.sub(link_transformer, no_events)
    return hardened_html

if __name__ == "__main__":
    cleaned_result = clean_and_harden_html(DIRTY_HTML_CONTENT)
    print(cleaned_result.strip())
2. 执行输出结果(示例)
注意在重构属性时,(?P=quote) 语法发挥了关键作用:它要求闭合引号必须与前面捕获的 (?P<quote>["']) 严格相同,从而避免了单引号和双引号在混乱 HTML 中引发的属性截断漏洞。
六、性能优化与生产避坑指南
正则表达式在带来强大表达能力的同时,若使用不当,极易成为系统的性能瓶颈甚至引发安全事故。在生产部署前,必须系统核对以下核心法则。
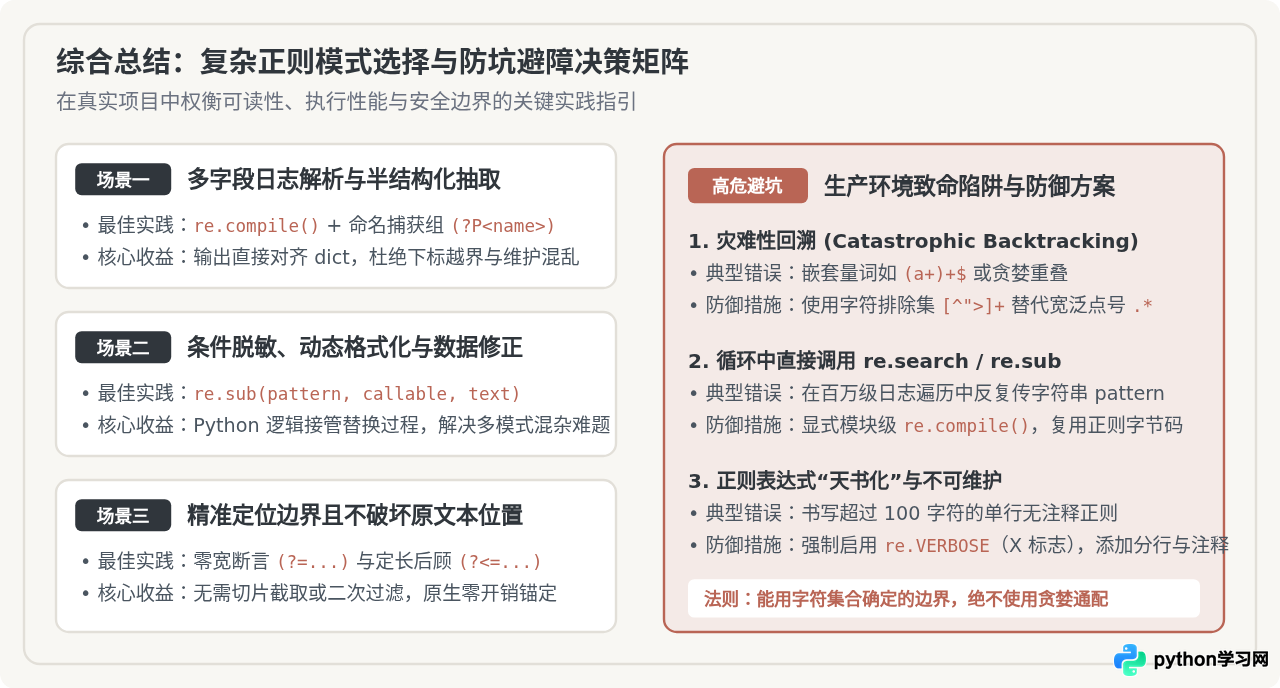
1. 严防灾难性回溯(Catastrophic Backtracking)
当正则表达式中包含嵌套量词(如 (a+)+$ 或 (.*\d)+)且目标输入以非匹配字符结尾时,非确定有限状态自动机(NFA)引擎将尝试穷举所有可能的分组切分方式,导致计算步数呈指数级爆炸($O(2^n)$),造成 CPU 100% 锁死(ReDoS 攻击)。
避坑策略:尽可能使用明确的排除型字符组代替宽泛的点号。例如,在匹配双引号包裹的字符串时,切勿编写 ".*?",而应明确指定为 "[^"]*"。因为排除型字符组与定界符互斥,状态机在遇到闭合引号时无法向后回退,能将回溯开销彻底降低为零。
2. 显式预编译与模块级缓存
在批量循环中直接调用 re.search(pattern_str, line) 会隐式消耗 Python 的内置正则缓存(LRU 缓存默认上限仅 512 个)。当系统使用的正则模式数量超过该阈值时,缓存击穿会导致每次循环都要重新经历编译与状态机生成过程。对于生产代码,务必在模块加载期使用 re.compile() 将模式编译为常量对象复用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















