


Python正则表达式难写?re模块核心匹配函数实战

很多开发者在编写 Python 文本处理代码时,常常对正则表达式抱有畏难情绪。事实上,大部分令人头疼的问题往往并非来自正则表达式本身的元字符语法,而是源于对 Python 标准库 re 模块内部函数调用机制的不熟悉。例如混淆了 re.match() 与 re.search() 的扫描起点导致返回 None,或者不清楚 re.findall() 在存在括号分组时的结构变化。本文将全面梳理 re 模块中最核心的匹配与处理函数,理清它们的设计机制、适用场景与避坑要点,帮助读者建立清晰可靠的代码选型逻辑。
一、re 模块核心函数的选型逻辑
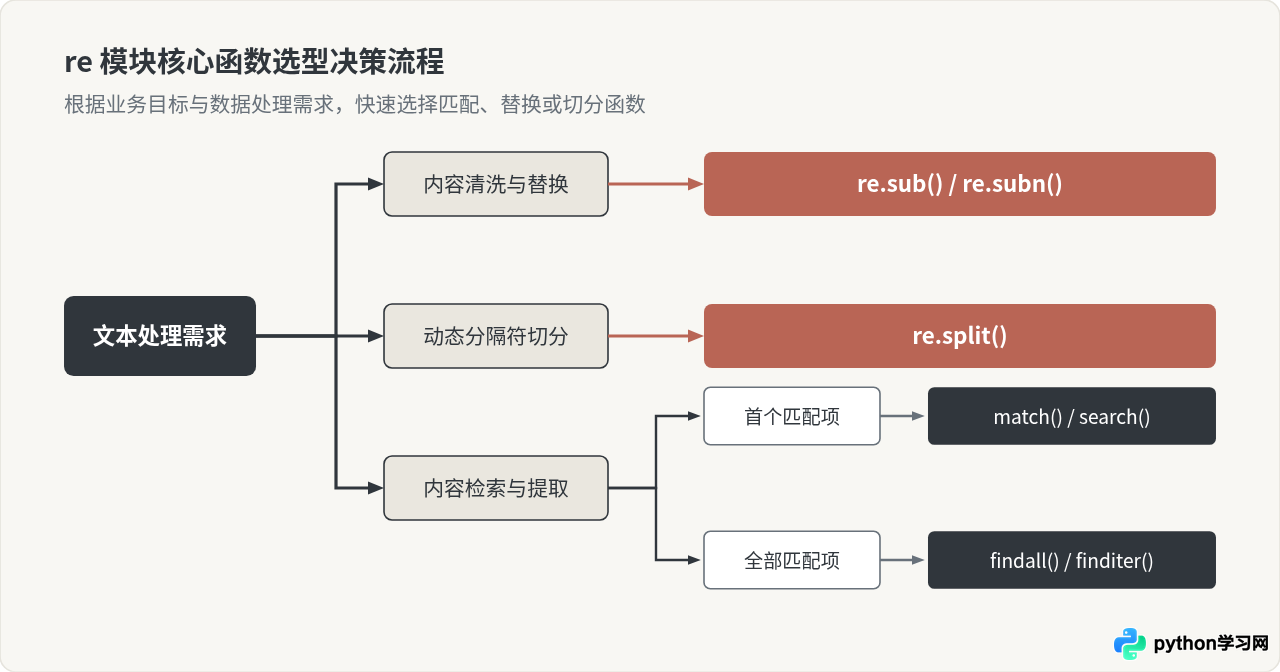
在动手写具体的正则模式(Pattern)之前,首先应当明确操作目的:究竟是校验格式、全文检索第一个结果、提取所有满足条件的片段,还是进行内容替换与切分?选错函数不仅会导致代码冗长易错,还可能带来不必要的性能开销。
下图清晰梳理了面对不同处理需求时,re 模块核心函数的判定流向:
二、match() 与 search():首部锚定与全串扫描
re.match() 与 re.search() 是最容易被误用的两个函数。很多初学者写了正确的正则表达式,却因为误用了 re.match() 而导致返回 None,随后调用 .group() 时抛出致命的 AttributeError: 'NoneType' object has no attribute 'group'。
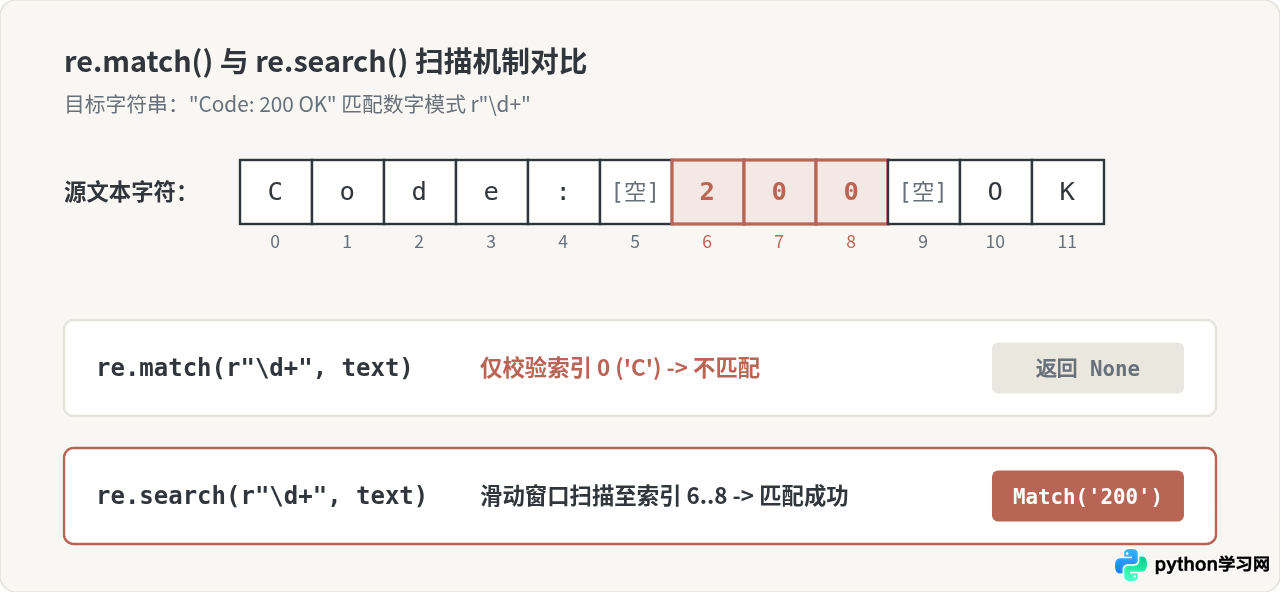
1. 底层扫描机制的根本差异
re.match(pattern, string):仅从字符串的索引 0 位置(开头)开始比对。只要第 0 个字符不符合模式要求,匹配立即宣告失败并返回None,绝不向后滑动窗口。re.search(pattern, string):按从左到右的顺序逐字扫描整个字符串,直到找到第一个完全符合规则的子串。只有当整个字符串遍历结束依然未发现目标时,才会返回None。
2. 实战代码与安全提取
import re

text = "Code: 200 OK"

# 错误示例:以为 match 会检索整个文本
res_match = re.match(r"\d+", text)
print(res_match)  # 示例输出:None

# 正确示例:在字符串任意位置检索目标数字
res_search = re.search(r"\d+", text)
if res_search:
    print(f"匹配内容: {res_search.group()}")        # 示例输出:匹配内容: 200
    print(f"出现位置区间: {res_search.span()}")     # 示例输出:出现位置区间: (6, 9)
else:
print("未找到匹配内容")避坑准则:如果你的目标是“在文本中查找某个关键字或模式”,请无条件优先使用 re.search();只有当你需要强校验文本格式(例如严格校验手机号、身份证号且开头不能有任何杂质时),才使用 re.match() 或配合 ^ 锚点。
三、批量提取:findall() 与 finditer() 的取舍
当需要从长文本(例如日志文件、HTML 源码、CSV 数据)中提取出所有符合条件的子串时,通常在 re.findall() 与 re.finditer() 之间进行选择。
1. findall() 的分组行为“陷阱”
re.findall() 会直接返回一个 Python 列表(list)。它非常直观,但有一个极易被忽略的行为:模式中是否存在捕获括号 () 会彻底改变返回值的结构。
- 无捕获括号:返回匹配到的完整字符串列表。例如
['192.168.1.1', '10.0.0.1']。 - 单个捕获括号:只返回括号内捕获的内容,而丢弃括号外的完整匹配。
- 多个捕获括号:列表元素自动变为元组(
tuple),每个元组对应各个括号的匹配项。
import re

log_line = "GET /index.html 200; POST /login.php 403;"

# 情况 A:没有括号,返回完整匹配
print(re.findall(r"\w+\s+/\S+\s+\d+", log_line))
# 示例输出:['GET /index.html 200', 'POST /login.php 403']

# 情况 B:包含两个捕获括号,返回值变成了包含元组的列表
print(re.findall(r"(\w+)\s+(/\S+)", log_line))
# 示例输出:[('GET', '/index.html'), ('POST', '/login.php')]

# 技巧:若需要使用括号表示逻辑优先级但不想改变 findall 返回值,请使用非捕获括号 (?:...)
print(re.findall(r"(?:GET|POST)\s+/\S+", log_line))
# 示例输出:['GET /index.html', 'POST /login.php']
2. 大数据量与精细控制的首选:finditer()
当文本量达到数万行或数十兆时,findall() 会一次性将所有匹配项全部实例化到内存列表中,造成显著的瞬时内存开销。此外,findall() 无法提供每个匹配项在原文中的具体字符位置(索引)。
re.finditer() 完美解决了这两个问题:它返回一个迭代器(Iterator),按需产生 re.Match 对象,既节省内存,又能保留完整元数据。
import re

text = "User: Alice (ID: 1001), User: Bob (ID: 1002)"
pattern = r"User:\s+(?P<name>\w+)\s+\(ID:\s+(?P<uid>\d+)\)"

for match in re.finditer(pattern, text):
    # 通过命名分组提取
    user_name = match.group("name")
    user_id = match.group("uid")
    start_pos, end_pos = match.span()
    print(f"用户: {user_name}, 编号: {user_id}, 在原文中位于: {start_pos}..{end_pos}")

# 示例输出:
# 用户: Alice, 编号: 1001, 在原文中位于: 0..22
# 用户: Bob, 编号: 1002, 在原文中位于: 24..45
四、文本清洗:sub() 与 split() 的高效实践
1. re.sub():不仅是简单替换
re.sub(pattern, repl, string, count=0) 用于将匹配到的文本替换为指定内容。其中 repl 参数不仅可以是静态字符串,还可以是反向引用标记或自定义回调函数。
import re

# 技巧 1:使用反向引用 \1, \2 调整格式
# 将 "2026-10-24" 改写为 "24/10/2026"
date_str = "2026-10-24"
converted = re.sub(r"(\d{4})-(\d{2})-(\d{2})", r"\3/\2/\1", date_str)
print(converted)  # 示例输出:24/10/2026

# 技巧 2:repl 传入函数,实现动态计算与脱敏
def mask_phone(match):
    # 保持前 3 后 4,中间 4 位用 * 替换
    raw = match.group(0)
    return raw[:3] + "****" + raw[7:]

content = "客服电话: 13812345678, 技术咨询: 13987654321"
cleaned = re.sub(r"1[3-9]\d{9}", mask_phone, content)
print(cleaned)
# 示例输出:客服电话: 138****5678, 技术咨询: 139****4321
2. re.split():突破 str.split() 的单一分隔符限制
Python 原生的 str.split() 只能按固定单字符或固定子串切割。但在处理自然文本或多格式导出数据时,分隔符往往混合了逗号、分号、空格或制表符。
import re

raw_data = "Apple, Banana; Orange   Grape\tMelon"
# 按一个或多个连续的逗号、分号或空白字符进行切分
fruits = re.split(r"[,;\s]+", raw_data.strip())
print(fruits)
# 示例输出:['Apple', 'Banana', 'Orange', 'Grape', 'Melon']
五、性能飞跃:re.compile() 与标准化执行流
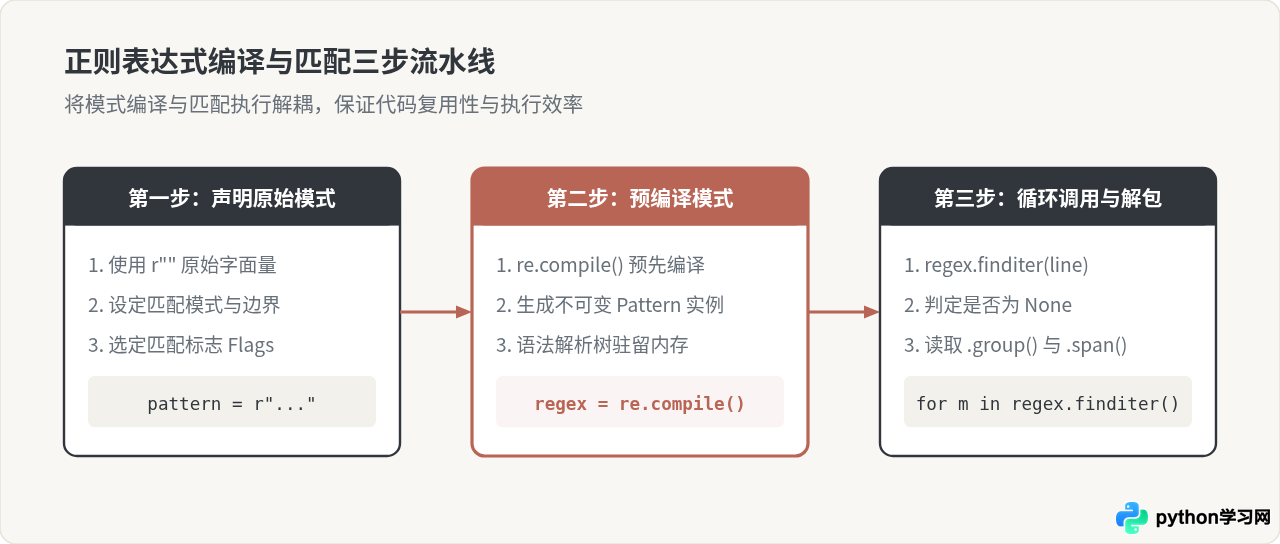
在循环、高频 API 请求或大文件扫描中频繁调用 re.search() 时,Python 内部虽然维护了一个小的正则表达式缓存,但依然存在哈希查询和重复解析开销。推荐的做法是通过 re.compile() 将正则表达式编译为不可变的模式对象(Pattern Object)。
下图展示了生产环境中标准的正则表达式三步构建与执行流程:
预编译完整示例
import re

# 预先编译正则表达式,并指定多行模式与忽略大小写
LOG_PATTERN = re.compile(
    r"^\[(?P<level>INFO|WARN|ERROR)\]\s+(?P<message>.+)$",
    flags=re.IGNORECASE | re.MULTILINE
)

raw_logs = """[INFO] Server started at port 8080
[warn] High memory consumption detected
[ERROR] Database connection timed out"""

# 高效遍历处理
for match in LOG_PATTERN.finditer(raw_logs):
    level = match.group("level").upper()
    msg = match.group("message")
    print(f"级别: {level:<5} | 详情: {msg}")

# 示例输出:
# 级别: INFO  | 详情: Server started at port 8080
# 级别: WARN  | 详情: High memory consumption detected
# 级别: ERROR | 详情: Database connection timed out
六、核心函数特性速查与总结
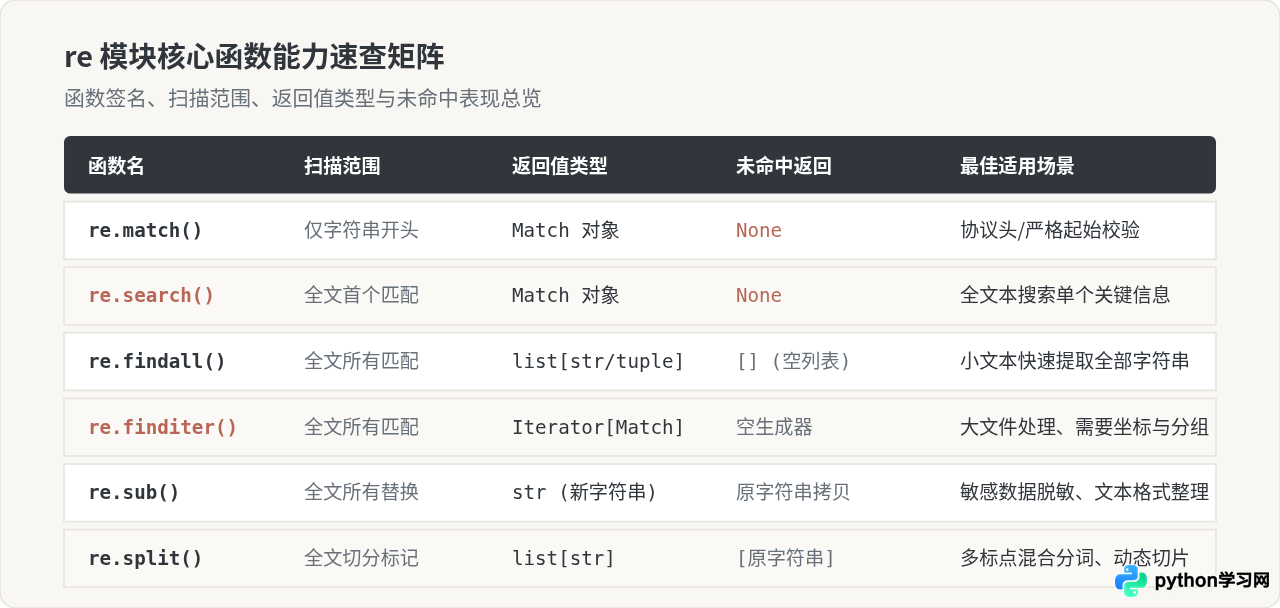
为了在日常开发中随时查阅,下表汇总了 re 模块 6 个最主要函数的行为矩阵:
掌握 Python 正则表达式的关键,在于将“写好正则表达式”与“选准匹配函数”两件事拆开看待。只要牢记 r"" 原始字符串前缀、养成检查 search() 返回值是否为 None 的防御性编程习惯,并在批量处理时优先选用具备按需迭代优势的 finditer() 与 compile(),正则表达式就会成为日常开发中简洁而强悍的数据处理利器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















