


NumPy读取CSV报错UnicodeDecodeError或ValueError怎么解决
详细剖析使用NumPy读取CSV时出现的UnicodeDecodeError与ValueError报错原因,提供np.loadtxt与np.genfromtxt的实用参数配置、代码示例与排查决策树。
NumPy 读取 CSV 出现报错,核心原因通常只有两类:文件字符编码不匹配引发 UnicodeDecodeError,或者文本包含表头字符串、非数值数据、空值以及错误分隔符引发 ValueError。只要根据错误类型在 np.loadtxt 或 np.genfromtxt 中补齐 encoding、delimiter、skiprows 等关键参数,即可精准排除故障。
一、两类报错的快速诊断与操作步骤
在 Python 中使用 numpy.loadtxt 或 numpy.genfromtxt 载入 CSV 文件时,读者最先看到的通常是控制台抛出的一大串 Traceback。排查问题的第一步,是直接看 Traceback 最后一行的异常名称。
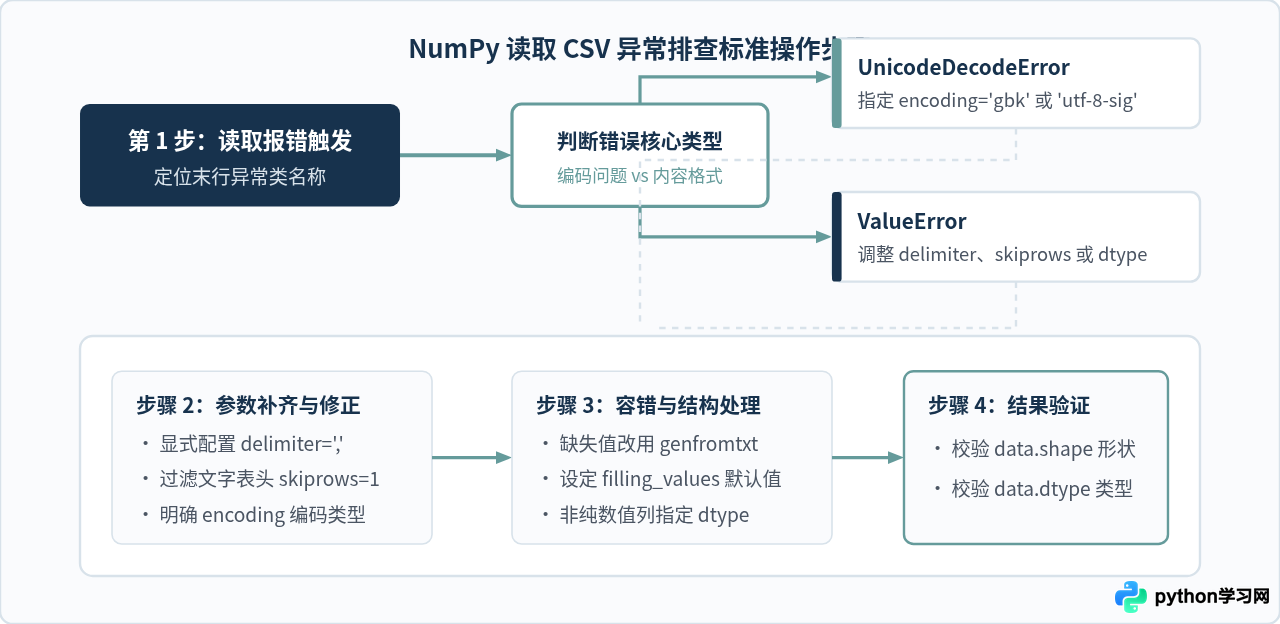
二、解决 UnicodeDecodeError:编码冲突与排查
UnicodeDecodeError 的典型表现如下:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xbd in position 0: invalid start byte或者在处理包含 BOM 头的 UTF-8 文件时可能伴随字符乱码甚至字段错位。
1. 为什么会发生编码错误?
在 Windows 环境下,通过 Excel 导出或保存的 CSV 文件,默认编码常常是 GBK(或 ANSI/CP936)。而 Python 3 环境及较新版本的 NumPy 函数在读取文本时,默认假定文件为 UTF-8 编码。当 NumPy 读到 GBK 特有的双字节汉字编码时,由于其首字节不符合 UTF-8 变长字节规范,解码器便会在第一处非法字节位置直接抛出 UnicodeDecodeError。
2. 解决方案与具体代码
NumPy 的 np.loadtxt 与 np.genfromtxt 都原生支持 encoding 参数。解决步骤如下:
- 如果文件由中文版 Windows Excel 保存,直接在调用中增加
encoding='gbk'。 - 如果文件是在某些文本编辑器中保存的“带有 BOM 的 UTF-8”,首字符会出现隐藏的
\ufeff,此时应指定encoding='utf-8-sig'。
import numpy as np

# 针对 Windows Excel 导出的中文编码 CSV
data = np.loadtxt('sensor_data.csv', delimiter=',', encoding='gbk')

# 如果使用了 genfromtxt 同样支持 encoding 参数
data_gen = np.genfromtxt('sensor_data.csv', delimiter=',', encoding='gbk')

# 针对包含 BOM 标记的 UTF-8 文件
data_bom = np.loadtxt('sensor_data.csv', delimiter=',', encoding='utf-8-sig')encoding='gbk'。
三、解决 ValueError:文本、表头与结构冲突
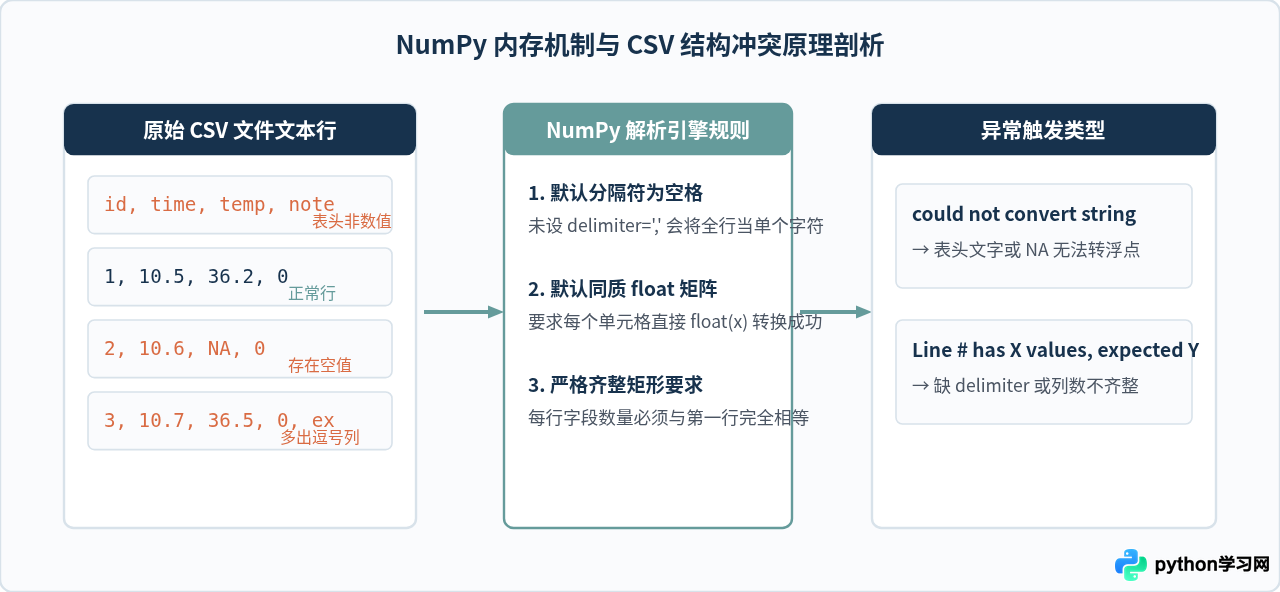
ValueError 在 NumPy 读取 CSV 时最为常见,它通常分为“字符串转换浮点数失败”与“字段数量不一致”两种具体形态。
1. 错误形态一:could not convert string to float
ValueError: could not convert string to float: 'age'
# 或者:
ValueError: could not convert string to float: 'NA'原因分析:np.loadtxt 的默认参数是 dtype=float。当 CSV 文件的第一行是英文或中文表头(例如 id, age, score)时,NumPy 尝试将字符串 'age' 直接转换为浮点数,必然抛出该异常。同理,当数据行中含有 NA、null、None 等缺失值占位符时,也会导致同样的报错。
排查与修复方法:
- 若由表头导致:使用
skiprows=1(对于np.loadtxt)或skip_header=1(对于np.genfromtxt)跳过第一行表头。 - 若因缺失值导致:改用
np.genfromtxt,并设置filling_values=0.0(或np.nan),将非数值或缺失项自动替换为合法的数字。 - 若数据原本就是字符串或混合类型:通过
dtype=str直接作为字符串数组读取,或者传入包含字段类型的元组列表定义结构化数组。
2. 错误形态二:字段数量不匹配(Line has X values, expected Y)
ValueError: Some errors were detected ! Line #3 (got 4 columns instead of 3)原因分析:NumPy 的二维数组在底层必须是一块连续且列数完全一致的内存块(矩形网格)。产生该报错有两大常见诱因:
- 未指定分隔符:
np.loadtxt默认以任意空白字符(空格或 Tab)作为分隔。如果 CSV 是标准的逗号分隔,NumPy 会将包含逗号的整行当作一个单一字段,导致第一行判定为 1 列,随后行若包含空格则字段数突增,直接报错。 - 数据本身存在缺失尾列或注释行:行尾存在空换行,或某几行缺少了逗号分隔符。
import numpy as np

# 规范写法:显式指定逗号分隔符,并跳过第 1 行表头
data = np.loadtxt(
    'metrics.csv',
    delimiter=',',   # 必须显式声明逗号,避免默认空格分割导致列数识别错误
    skiprows=1       # 跳过表头行
)

# 当数据包含缺失值或混合类型时,推荐使用 np.genfromtxt
data_robust = np.genfromtxt(
    'metrics_with_na.csv',
    delimiter=',',
    skip_header=1,
    filling_values=-1.0   # 遇到空缺时填入默认值 -1.0
)
四、核心参数与解决方案矩阵
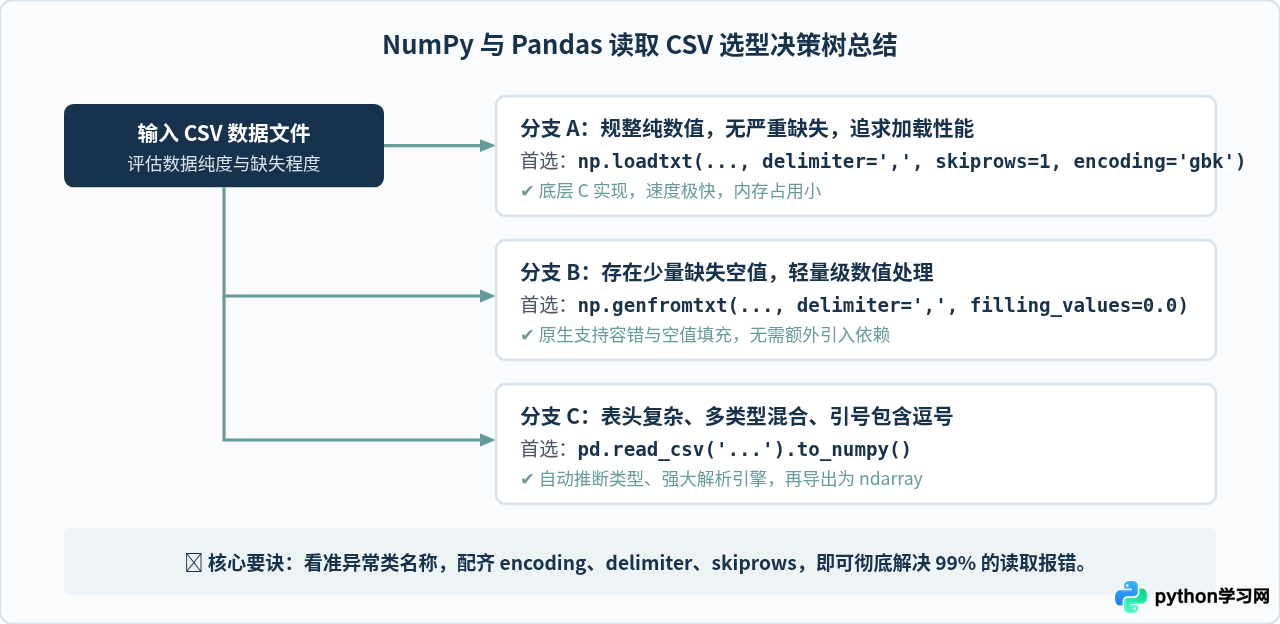
为了让排查更清晰,下表和图解对两套常用函数在面对各种异常时的参数配置进行了全面映射对比:
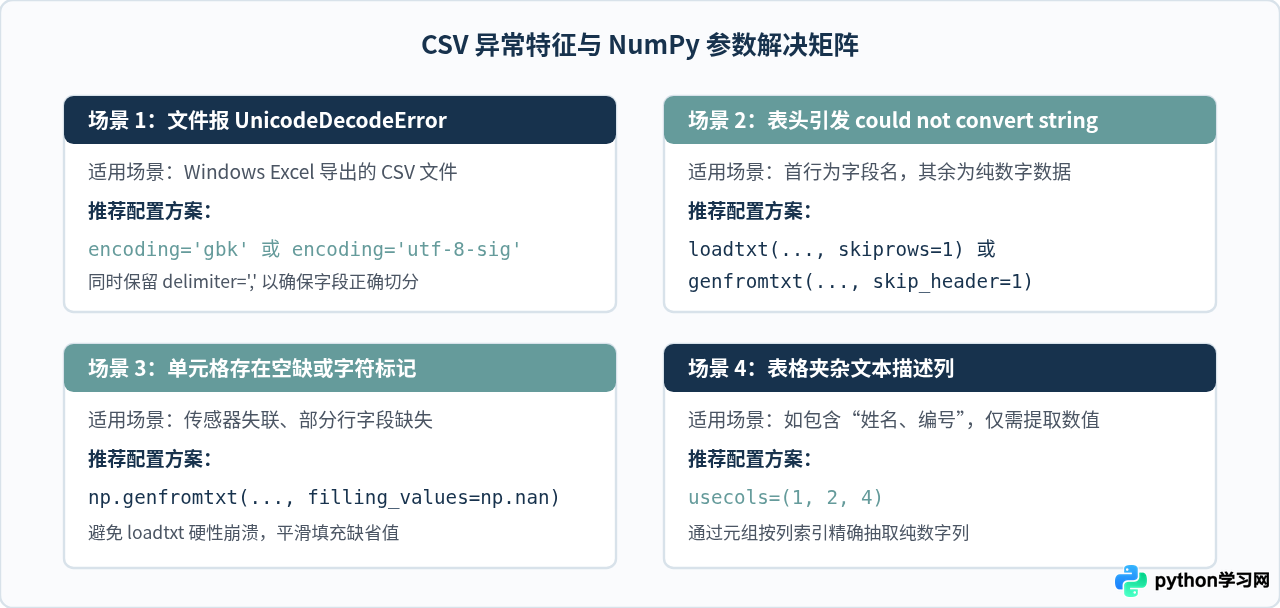
| 问题特征 | 引发原因 | 核心修正参数 | 推荐使用函数 |
|---|---|---|---|
UnicodeDecodeError |
系统默认 UTF-8 无法读取 GBK/ANSI 编码 | encoding='gbk' |
np.loadtxt / genfromtxt |
ValueError: could not convert...(表头) |
文本表头无法直接转为 float | skiprows=1 / skip_header=1 |
np.loadtxt |
ValueError: could not convert...(缺失值) |
单元格存在 NA、空字符串 |
filling_values=0.0 |
np.genfromtxt |
ValueError: ...expected Y |
未指定分隔符或每行字段数量不齐 | delimiter=',', usecols=(...) |
np.loadtxt / genfromtxt |
五、选型决策与稳健模板总结
在工程实践中,根据 CSV 的复杂程度与性能要求,合理选择加载工具能有效预防 90% 以上的读取异常。
最终防御性代码模板
下面是一套兼顾编码排查与格式容错的标准代码模板,可以在实际工程项目中直接使用:
import numpy as np

def load_csv_safely(file_path):
    """
    稳健读取 CSV 为 NumPy 数组的范例函数
    """
    # 尝试常用编码顺序:先 utf-8,失败则回退至 gbk
    for enc in ['utf-8', 'gbk', 'utf-8-sig']:
        try:
            # 优先使用 genfromtxt 兼顾表头与空值
            data = np.genfromtxt(
                file_path,
                delimiter=',',         # 明确声明逗号分隔符
                skip_header=1,         # 跳过第 1 行表头
                filling_values=0.0,    # 遇到缺失数据填充 0.0
                encoding=enc
            )
            print(f"成功使用 {enc} 编码加载文件,数组形状: {data.shape}")
            return data
        except UnicodeDecodeError:
            continue
        except ValueError as e:
            print(f"数值解析失败,请检查是否包含文本列或列数不齐: {e}")
            raise

    raise RuntimeError("所有常见编码均未能成功解析文件。")

# 示例调用
if __name__ == '__main__':
    # 传入你的 CSV 文件路径即可执行验证
    # array = load_csv_safely("sample.csv")
passprint(data.shape) 检查读取到的行数和列数是否符合预期,使用 print(data.dtype) 检查数据类型是否已被正确解析为数值类型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















