


Python正则匹配中文乱码或失败的原因及解决方法
深入解析在Python中使用正则表达式匹配中文时出现匹配失败或乱码的核心原因,从数据类型混淆、字符编码冲突、Unicode区间盲区到终端输出环境逐一排查,提供完整可落地的解决方案与标准代码示例。
在 Python 中使用正则表达式处理中文文本时,遇到匹配结果为空(匹配失败)或者提取出来的汉字变成类似 \xe4\xb8\xad、???? 以及不可读乱码,其核心原因通常并非正则表达式引擎本身存在缺陷,而是字符串对象类型混淆(Unicode str 与原生 bytes 混用)、输入数据源未显式指定编码导致字符集错乱、正则表达式范围模式书写有误(未覆盖全角标点或生僻字),以及控制台终端输出环境自身编码配置不匹配导致的“假乱码”。彻底解决该问题的通用原则非常明确:在输入阶段统一显式解码为 Python 3 原生 Unicode 字符串,使用经过校准的 Unicode 字符集区间进行匹配,并在输出端保障 UTF-8 编码环境。
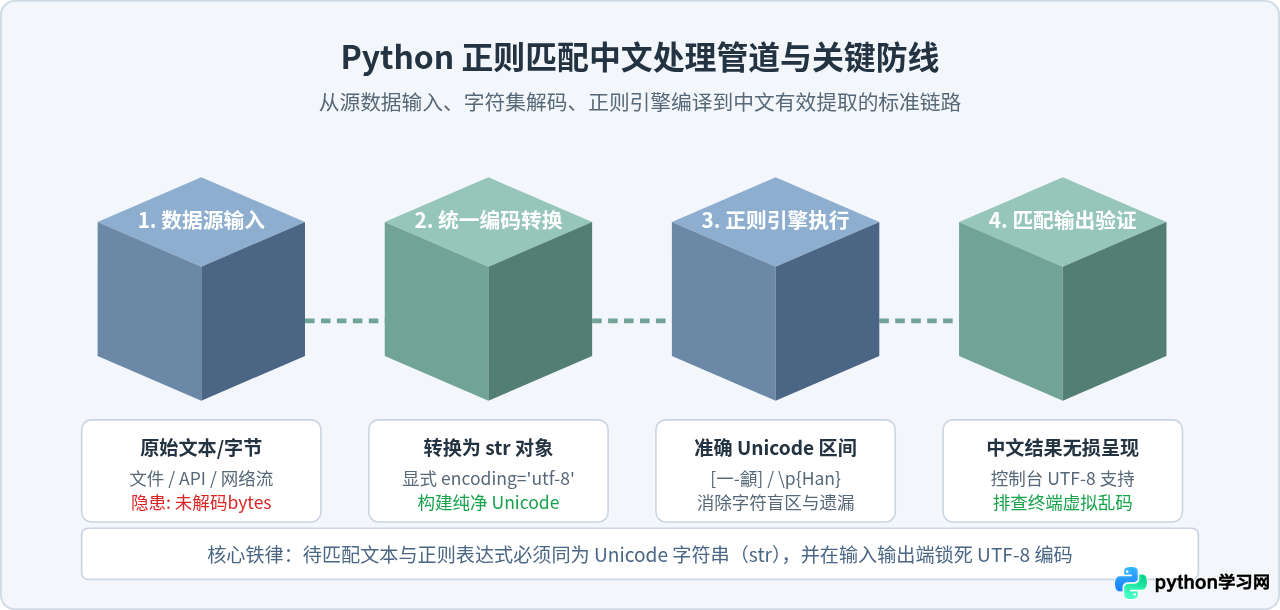
一、常见故障表现与快速排查四步法
在编写业务脚本或清洗文本时,中文正则匹配异常一般集中表现为以下三种具体现象:
- 匹配结果为空列表或 None:原本肉眼可见包含汉字的文本,调用
re.findall()后返回[],或者re.search()返回None。 - 匹配成功但内容为十六进制字节:结果为
[b'\xe4\xb8\xad\xe6\x96\x87'],既无法直接进行字符串比对,直接打印到控制台或写入文件还会显示为乱码。 - 汉字字符发生截断或部分缺失:一段完整的中文句子,提取后只有一部分汉字,标点符号周围的词语被强行拆散,或者生僻字、特定人名消失不见。
当遇到上述情况时,建议按照“数据类型 > 源头编码 > 正则范围 > 终端环境”的顺序依次执行排查,即可在几分钟内精准定位问题根源。
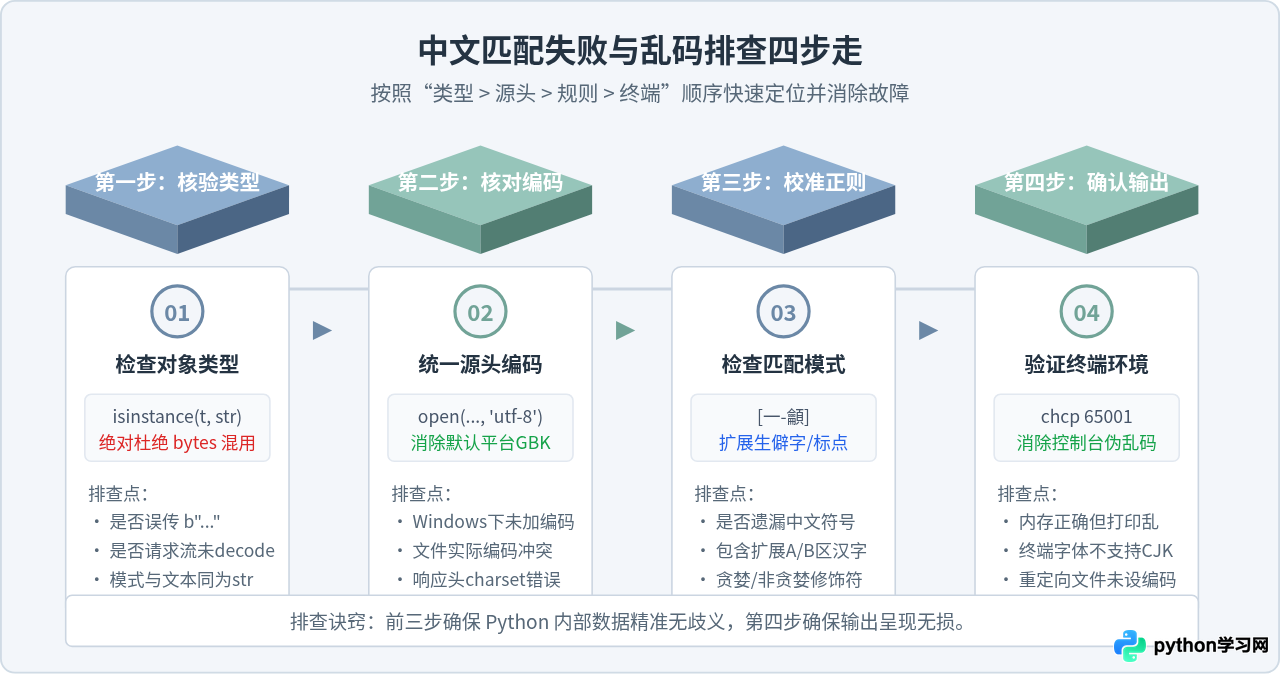
- 第一步:检查待匹配对象与模式的数据类型。在 Python 3 中,
str(Unicode 文本)和bytes(二进制字节)是完全不同的两种数据类型。请通过type(text)检查待匹配数据。如果数据是bytes,绝不能直接与字符串正则模式混用。 - 第二步:核对文件或网络流的输入编码。读取本地文件时,如果仅调用
open(filename, 'r')而未显式指定encoding='utf-8',Windows 系统默认会采用系统的本地 ANSI 编码(如 GBK / CP936)读取文件。若文件本身是 UTF-8 格式,读取到的内存数据在传入正则之前就已经完全乱码。 - 第三步:校准正则表达式的 Unicode 区间。常用的
[\u4e00-\u9fa5]仅涵盖 CJK 统一表意文字基本区。如果待匹配文本中含有扩展区汉字(如古籍字、生僻姓名)或全角中文标点符号(如“,”、“。”),基础模式便会漏选或在标点处强行截断。 - 第四步:确认运行终端或重定向输出的显示编码。有时 Python 内部匹配出的
str完全正确,但在 Windows CMD、PowerShell 或老旧日志收集器中直接打印时出现乱码。这属于终端显示环境问题,并非正则匹配逻辑错误。
二、核心根因剖析:为什么会出现乱码或匹配失败?
理解问题发生的底层机理,有助于我们在写代码时彻底规避同类错误。中文在计算机中是以多字节编码形式存储的,而 Python 3 正则引擎在处理 Unicode 字符与处理底层字节时,逻辑完全不同。
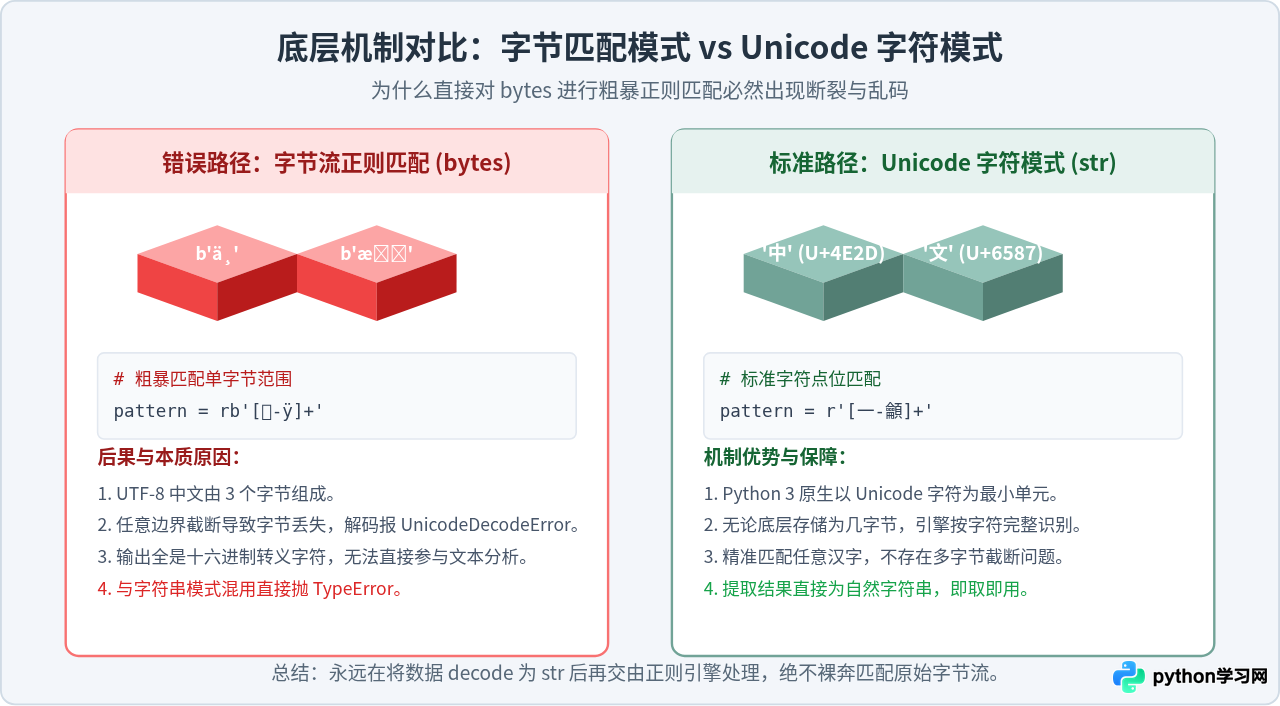
1. 混淆 str 与 bytes 导致的类型报错与字节断裂
在 Python 2 时代,str 实际上就是字节流;但从 Python 3 开始,所有文本 str 均在内存中严格以 Unicode 代码点(Code Point)存储,而二进制流则统一为 bytes。
当待匹配文本为 bytes 类型时,若使用字符串正则,Python 会直接抛出异常:
import re

raw_data = b"\xe4\xb8\xad\xe6\x96\x87\xe6\xb5\x8b\xe8\xaf\x95"
pattern = r"[\u4e00-\u9fa5]+"

# 运行下列语句将直接报错:
# TypeError: cannot use a string pattern on a bytes-like object
re.findall(pattern, raw_data)
部分开发者为了避免此报错,误将模式写为字节正则,例如 rb"[\x80-\xff]+"。在 UTF-8 编码下,一个标准汉字通常占用 3 个字节(每个字节的高位均为 1,数值范围在 0x80 到 0xFF 之间)。使用字节正则粗暴扫描时,极易因网络数据包分片或混有其他单字节符号而发生多字节截断,破坏了 UTF-8 的 3 字节完整结构,导致后续解码失败并产生不可逆的乱码。
bytes 数据上直接使用十六进制范围匹配中文。标准做法是先将其 decode('utf-8') 为 str,再使用常规正则进行语义匹配。
2. 源文件读取未指定编码引发的底层畸变
很多初学者在读取文本文件时习惯简写为 with open('data.txt') as f:。在不同操作系统下,未声明编码的 open() 会调用 locale.getpreferredencoding():
- 在 macOS 和现代 Linux 上,默认编码通常是
utf-8。 - 在中文 Windows 系统上,默认编码通常是
cp936(GBK)。
如果源文件是以 UTF-8 编码保存的,而在 Windows 下以 GBK 模式打开,文件内容在读入内存的一瞬间就已经变成了畸形字符串。此时即使正则表达式写得完全正确,正则引擎面对的也只是一堆被错误映射的乱码字符,自然无法匹配出预期汉字。
3. Unicode 汉字编码区间的认知盲区
许多教程推荐使用 [\u4e00-\u9fa5] 来匹配中文,这使得很多人误以为这就是“所有中文”的代名词。实际上,Unicode 规范中汉字分布在多个区间:
| Unicode 编码区间 | 区间名称 / 涵盖范围 | 典型内容与适用场景 |
|---|---|---|
\u4e00-\u9fa5 |
CJK 统一表意文字基本区(早期) | 包含 20,902 个常用及次常用汉字,覆盖日常 99% 的书面用字。 |
\u4e00-\u9fff |
CJK 统一表意文字基本区(完整) | 包含补充录入的汉字,推荐作为现代基础汉字匹配的首选范围。 |
\u3400-\u4dbf |
CJK 表意文字扩展 A 区 | 包含 6,582 个汉字,主要见于古籍、历史文献及特定户籍姓名用字。 |
\u3000-\u303f |
CJK 符号和标点 | 全角空格、顿号(、)、句号(。)、书名号(《》)等。 |
\uff01-\uff5e |
半角及全角形式(中文全角标点) | 全角逗号(,)、全角感叹号(!)、全角问号(?)等。 |
如果待处理的文本中包含生僻姓名(例如“䶮”、“𬱖”)或希望提取整句中文文本,单纯使用 [\u4e00-\u9fa5] 就会导致生僻字遗漏,或者在遇到中文逗号、句号时直接截断,误以为匹配失败。
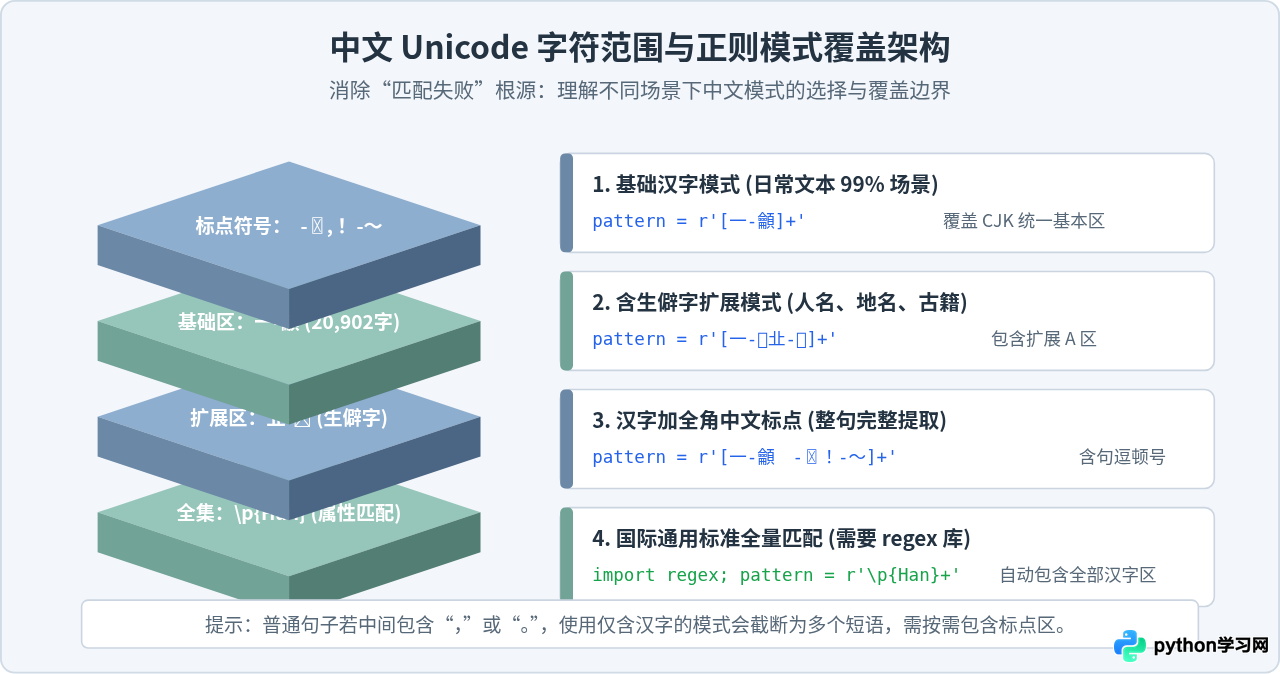
三、标准解决方法与完整代码实现
针对上述原因,以下提供不同场景下的标准解决对策与可运行代码示例。
方案 1:全流程纯 Unicode 字符串处理(标准基础方案)
这是处理中文文本时最健壮、最推荐的通用规范。无论数据源来自文件、数据库还是网络接口,务必确保在进入正则引擎前为 str 类型,并使用显式 encoding='utf-8'。
import re

# 模拟带中文字符的文本(确保为原生 str)
text = "用户:张伟,联系邮箱:zhangwei@example.com,留言内容:系统运行稳定!"

# 1. 仅提取连续的汉字词组(排除数字、字母与标点)
han_pattern = re.compile(r'[一-龥]+')
chinese_words = han_pattern.findall(text)
print("提取的纯汉字词组:", chinese_words)
# 示例输出:['用户', '张伟', '联系邮箱', '留言内容', '系统运行稳定']

# 2. 提取包含中文全角标点的完整中文句子
sentence_pattern = re.compile(r'[一-龥 -〿!-~]+')
chinese_sentences = sentence_pattern.findall(text)
print("提取的含标点中文句:", chinese_sentences)
# 示例输出:['用户:张伟,联系邮箱:', ',留言内容:系统运行稳定!']
方案 2:规范读取外部文件,杜绝编码失真
读取本地文件时,始终显式传入 encoding='utf-8'。如果面对的是老旧系统导出的 GBK / GB2312 文件,则明确传入 encoding='gbk',Python 会在读取时自动转为内部统一的 Unicode str。
import re

# 规范打开文件并提取中文
def extract_chinese_from_file(file_path):
    try:
        # 始终显式声明编码;若文件为 GBK,将 utf-8 替换为 gbk
        with open(file_path, mode='r', encoding='utf-8') as f:
            content = f.read()
    except UnicodeDecodeError:
        # 兜底容错处理:尝试使用 gbk 解码
        with open(file_path, mode='r', encoding='gbk', errors='replace') as f:
            content = f.read()

    # 编译匹配正则并查找
    pattern = re.compile(r'[一-鿿]+')
    return pattern.findall(content)

# 示例调用(代码说明):
# matches = extract_chinese_from_file("sample.txt")
方案 3:涵盖生僻字与高要求文本的高级匹配
如果业务场景涉及户籍姓名、古代文献、中医药典籍等存在生僻字的场景,建议扩大 Unicode 检索区间,或者引入支持 Unicode 属性的第三方 regex 模块。
import re

# 包含生僻字(CJK 扩展 A 区)的测试样本
special_text = "户籍信息:王䶮,居住地:上海市静安区。"

# 组合常用区(一-鿿)与扩展 A 区(㐀-䶿)
extended_pattern = re.compile(r'[一-鿿㐀-䶿]+')
results = extended_pattern.findall(special_text)
print("包含生僻字的匹配结果:", results)
# 示例输出:['户籍信息', '王䶮', '居住地', '上海市静安区']regex 模块的 \p{Han} 属性标准库
re 暂不支持 \p{Han} 语法。在处理国际化或极端复杂的汉字匹配时,可通过 pip install regex 安装第三方扩展库,直接使用 regex.findall(r'\p{Han}+', text),它会自动覆盖从基本区到扩展所有分区的全部合法汉字。
方案 4:排查终端与控制台的“假乱码”
如果在执行代码后,打印出来的中文变成了形如 ä¸ 或问号,但 len(chinese_words) 和逻辑运算完全正常,说明正则匹配本身成功,是控制台输出环境产生了“假乱码”。
- Windows CMD / PowerShell 临时配置:在执行 Python 脚本前,先在终端输入
chcp 65001并回车,将当前控制台代码页切换为 UTF-8。 - 设置环境变量:在操作系统中设置环境变量
PYTHONIOENCODING=utf-8,强制 Python 在向标准输出(sys.stdout)写入数据时使用 UTF-8 编码。 - 保存到文件验证:遇到终端乱码怀疑时,不要只用
print()观察,直接将匹配结果通过with open('output.txt', 'w', encoding='utf-8') as f: f.write(result)写入磁盘,用支持 UTF-8 的编辑器打开确认。
四、避坑指南与总结备忘
为确保中文正则表达式在生产环境中的长期稳定运行,建议将以下要点作为代码审查的固定清单:
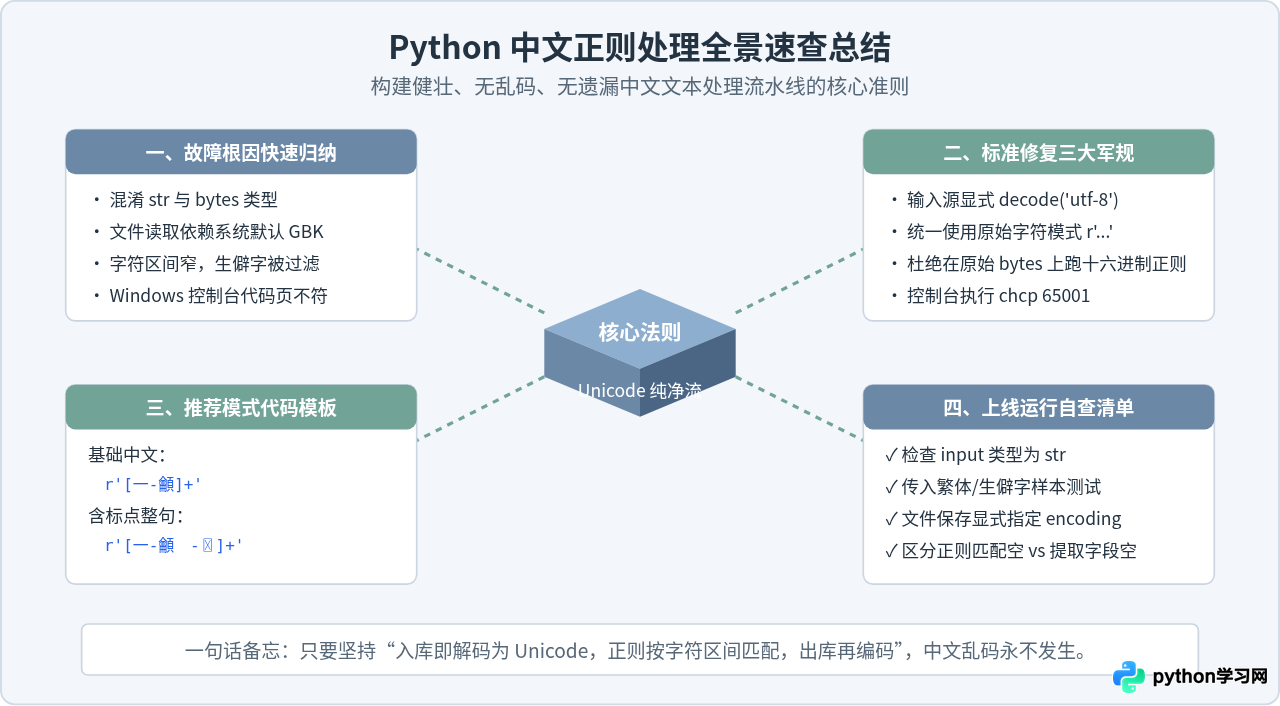
- 永远不要在原始 bytes 上运行粗暴的字节正则:无论数据来自 Socket、网络请求库还是二进制文件,第一步永远是调用
.decode('utf-8')(或检测真实编码后解码)将其还原为 Unicode 字符串。 - 字符串正则前统一加上 raw 标记
r'...':虽然 Unicode 转义如\u4e00在普通字符串中也能生效,但养成使用原始字符串r'...'的习惯可以避免转义反斜杠被 Python 解释器提前消耗。 - 明确区分“纯汉字”与“中文文本”的需求边界:纯汉字提取只需
[\u4e00-\u9fa5]+;如果是清洗中文正文,务必把全角标点符号(\u3000-\u303f、\uff01-\uff5e)纳入字符集,避免句子被拆得支离破碎。 - 跨平台开发必须显式锁定文件编码:团队中若同时存在 macOS、Linux 与 Windows 开发者,任何涉及文本读写的
open()调用,必须显式传入encoding='utf-8',彻底根绝不同操作系统平台默认编码差异带来的诡异 Bug。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















