


Python函数返回值接收指南:变量赋值与链式调用技巧
深入解析Python函数返回值接收机制,全面涵盖单变量接收、元组多值解包、扩展星号语法、链式调用原理与原地修改陷阱排查技巧。
一、Python 函数返回值的底层机制
在深入具体语法前,首先必须明确 Python 对函数返回值的处理规则。无论在函数内部声明了多么复杂的计算,函数退出时的返回值始终遵循以下两项刚性约定:
- 隐式返回值:若函数体内没有显式书写
return语句,或仅书写了不带任何表达式的return,Python 解释器会自动向调用方返回None。 - 多值打包机制:当用逗号分隔多个表达式返回时(如
return a, b, c),Python 不会真正返回多个独立的实体,而是自动将它们打包为一个不可变的元组(tuple)。
def get_user_status(user_id: int):
    if user_id <= 0:
        return  # 隐式返回 None
    # 逗号分隔的多个返回值,实际返回类型为 (bool, str, int) 的元组
    return True, "Active", 95

result = get_user_status(101)
print(type(result))  # 示例输出:<class 'tuple'>
print(result)        # 示例输出:(True, 'Active', 95)
认识到“多返回值实质是元组”这一特性,是掌握后续各种灵活接收技巧的关键前提。
二、变量赋值与多元解包技巧
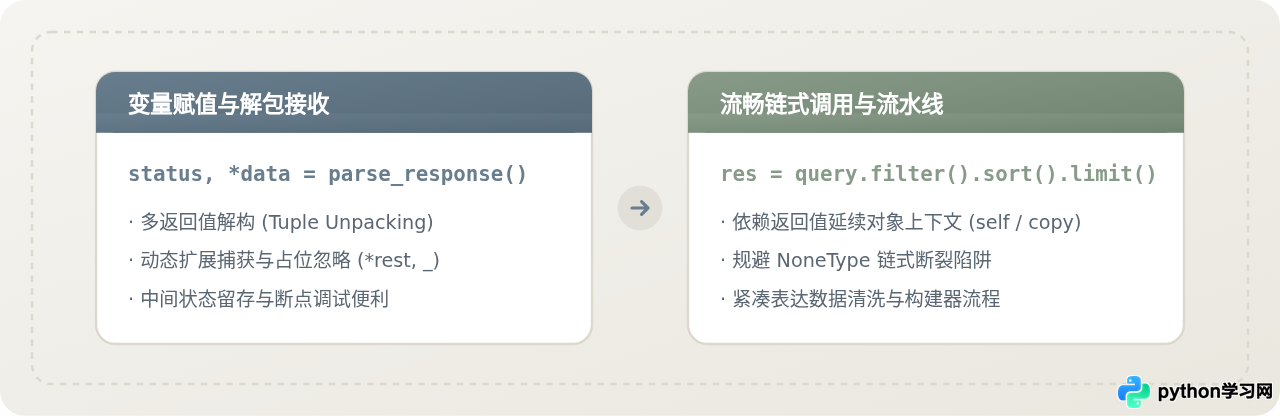
当函数返回结果后,合理地将其分配给变量,能够让后续逻辑更具可读性与可维护性。针对不同的数据形态,Python 提供了层次分明的接收方案。
1. 精准位置解包(Tuple Unpacking)
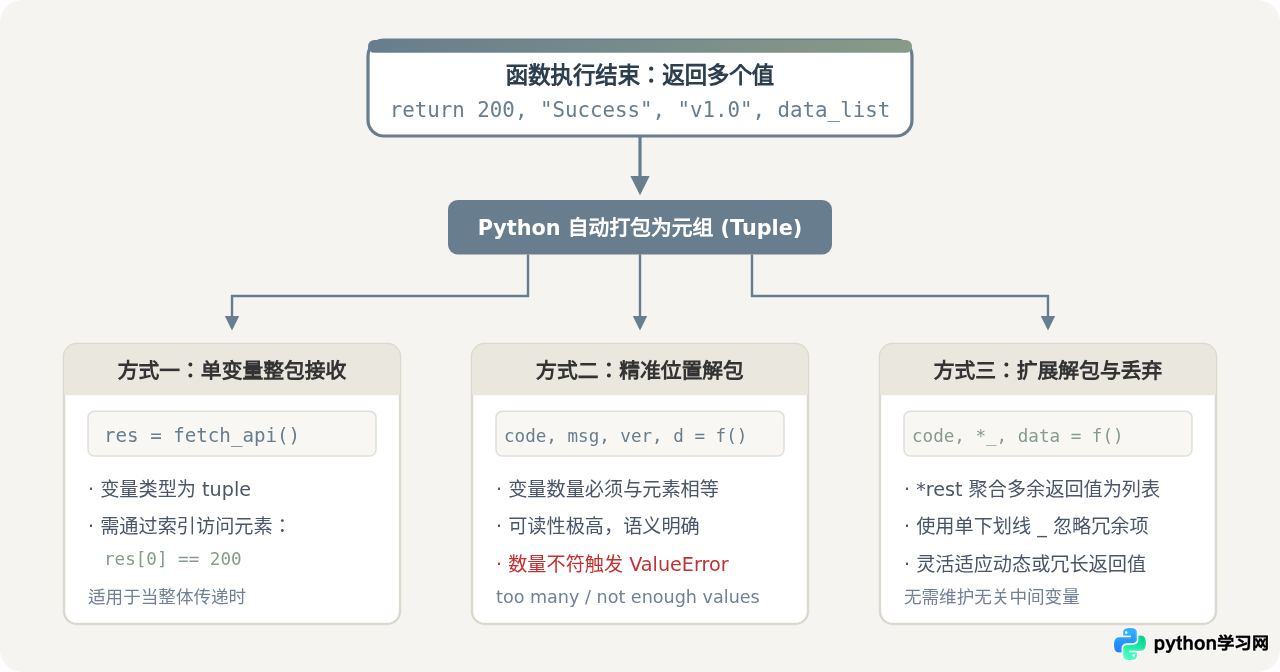
当明确知晓函数返回的元组长度与各字段含义时,最地道且推荐的做法是将返回值直接解包至相同数量的局部变量中。这种方式消除了索引下标带来的魔术数字,让变量名直接承担文档解释功能。
def query_order(order_id: str):
    # 模拟订单查询,返回:状态码、提示信息、金额
    return 200, "支付成功", 199.50

# 推荐:位置一一对应的精准解包
status_code, message, amount = query_order("ORD-20261101")
print(f"状态: {status_code}, 信息: {message}, 实付: {amount}")
# 示例输出:状态: 200, 信息: 支付成功, 实付: 199.5ValueError: not enough values to unpack;如果左侧变量偏少,则会触发 ValueError: too many values to unpack。
2. 扩展解包与星号语法(Starred Expression)
如果函数返回的项目数量不固定,或者我们只关心头部、尾部的个别值,可以使用带星号的前缀变量(*rest)来接收剩余的多余项。Python 会自动将剩余的所有值组织为一个列表(list)。
def parse_log_entry():
    # 返回:时间戳、日志级别、若干标签、详细信息
    return "2026-11-01 19:20", "ERROR", "auth", "db", "timeout", "连接池耗尽"

# 提取头部时间戳和级别,尾部消息,中间所有标签聚合到 tags
timestamp, level, *tags, message = parse_log_entry()

print(timestamp)  # 示例输出:2026-11-01 19:20
print(level)      # 示例输出:ERROR
print(tags)       # 示例输出:['auth', 'db', 'timeout']
print(message)    # 示例输出:连接池耗尽
3. 下划线占位符与忽略冗余值
在实际工程中,遵循规范的团队通常使用单下划线 _ 或带星号的双下划线 *_ 来接收不需要的返回值。这不仅能告知代码审查者此值被有意忽略,还能避免代码检查工具(如 flake8、pylint)报出“未使用的局部变量”警告。
# 仅需要第一项状态码与最后一项耗时,丢弃中间的具体详情
status, *_, duration = perform_health_check()
4. 海象运算符(:=)即时赋值与校验
在 Python 3.8 及以上版本中,赋值表达式(海象运算符 :=)允许在判断条件内部同时完成函数返回值的接收与真值判定,避免了编写冗长的“先赋值、再换行判断”结构。
def fetch_cached_token(user_id: int):
    # 模拟未命中缓存时返回 None
    return "token_xyz_987" if user_id == 100 else None

# 使用海象运算符接收返回值并直接判定是否有效
if token := fetch_cached_token(100):
    print(f"使用有效凭据: {token}")
else:
    print("未获取到有效凭据,准备重新鉴权")
三、链式调用的底层原理与流式设计
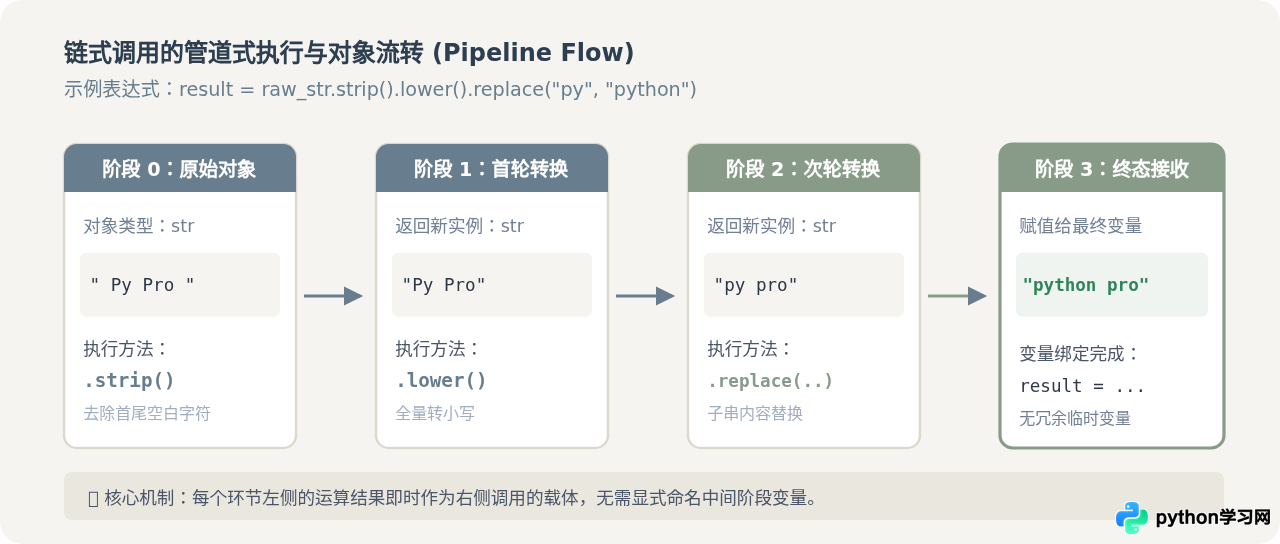
与显式变量赋值相比,链式调用(Method Chaining)通过省略中间变量,将一系列连续的函数或方法串接在一条语句中。理解链式调用的关键在于:前一个调用所产出的返回值,就是后一个调用所依赖的宿主对象。
1. 标准库内置类型的天然链式调用
Python 中的不可变类型(如 str)非常适合链式调用。因为字符串是不可变的,所以字符串的所有变换方法(如 strip()、lower()、replace())都不会修改原有字符串,而是计算并返回一个全新的字符串对象,下一个方法即可立即挂接执行。
raw_input_data = "   Python_Data_Processing_2026   "

# 连续执行去空、小写、下划线替换,最终一次性接收
cleaned_data = (
    raw_input_data
    .strip()
    .lower()
    .replace("_", "-")
)

print(cleaned_data)  # 示例输出:python-data-processing-2026
2. 自定义类的流畅接口设计(Fluent Interface)
若要在自定义类中实现链式调用(常见于 SQL 查询构建器、HTTP 请求配置器或数据加工流水线),核心设计技巧是在每个配置方法处理完内部状态后,显式加上 return self。
class QueryBuilder:
    def __init__(self, table: str):
        self.table = table
        self.conditions = []
        self._limit_num = None

    def where(self, field: str, value: str):
        self.conditions.append(f"{field} = '{value}'")
        return self  # 关键点:返回实例自身以支持链式连续调用

    def limit(self, count: int):
        self._limit_num = count
        return self  # 返回 self

    def build(self) -> str:
        sql = f"SELECT * FROM {self.table}"
        if self.conditions:
            sql += " WHERE " + " AND ".join(self.conditions)
        if self._limit_num is not None:
            sql += f" LIMIT {self._limit_num}"
        return sql

# 链式装配查询条件并在末尾构建最终语句
sql_statement = (
    QueryBuilder("users")
    .where("status", "active")
    .where("role", "admin")
    .limit(10)
    .build()
)

print(sql_statement)
# 示例输出:SELECT * FROM users WHERE status = 'active' AND role = 'admin' LIMIT 10
四、关键差异与排错陷阱:原地修改与 NoneType 断裂
在运用链式调用时,初学者最常遭遇的错误是意外的 AttributeError: 'NoneType' object has no attribute '...'。这源于对 Python 语言设计哲学的一个重要误解:就地修改(In-Place Mutation)与生成新对象(New Copy)的区别。
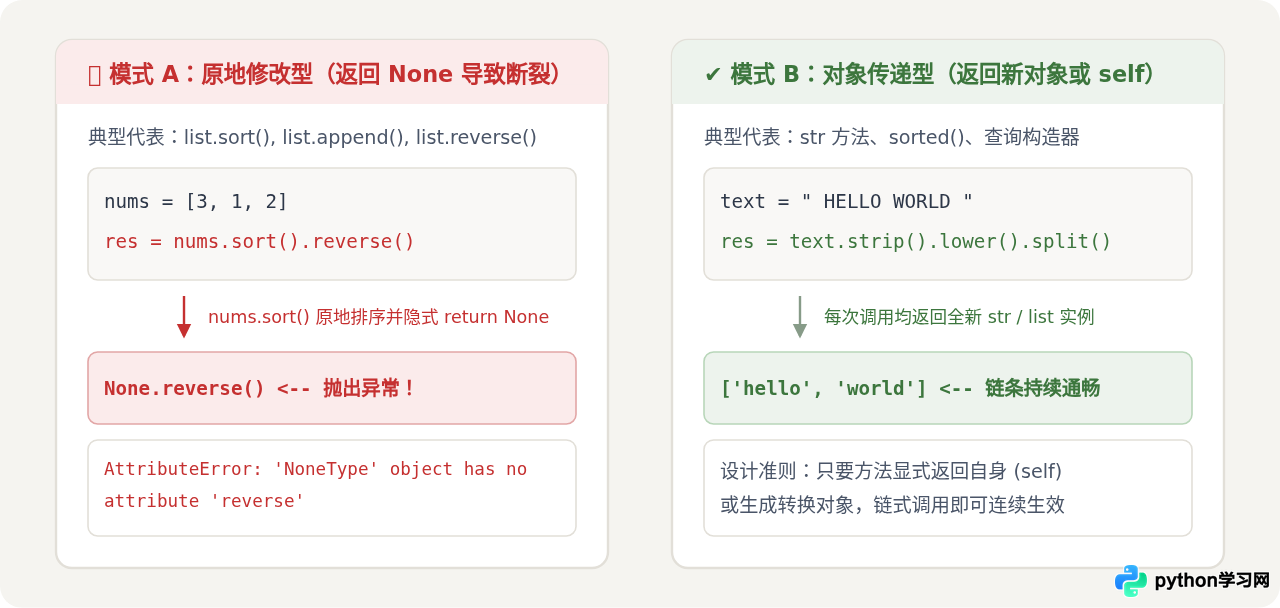
1. 原地修改方法的“零返回值”原则
在 Python 标准库中,可变容器(如 list、set、dict)的原地修改方法通常特意设计为返回 None。Python 核心设计者这么做是为了明确告诫开发者:“此操作直接改变了原对象的内容,并没有产生新副本”。
list.sort():直接重排原列表,返回 None。list.reverse():直接反转原列表,返回 None。list.append():直接追加元素,返回 None。
# 错误写法:试图在原地排序后继续链式操作或接收变量
nums = [5, 2, 8, 1]
sorted_nums = nums.sort()  # nums.sort() 返回了 None!
print(sorted_nums)         # 示例输出:None
sorted_nums.reverse()      # 崩溃:AttributeError: 'NoneType' object has no attribute 'reverse'
2. 两种处理方式的关键属性对照
为了准确区分何时能够链式调用、何时必须分步赋值,请参考下表的具体差异:
| 对比维度 | 原地修改模式(In-Place) | 链式转换模式(Chaining) |
|---|---|---|
| 返回值特征 | 无显式返回,固定为 None |
返回转换后的新实例,或显式返回 self |
| 原数据状态 | 原对象内存内容被直接修改 | 原对象通常保持不变(如不可变类型),产生全新结果 |
| 链式支持度 | 严禁链式调用,第一步就会破坏调用链 | 天然支持链式,右侧调用无缝接入左侧返回 |
| 典型代表 | list.sort(), list.extend(), dict.update() |
sorted(list), str.strip(), df.dropna() |
| 正确使用姿势 | 单起一行执行修改,无需赋值给新变量 | 直接连续调用,并在链条末尾由变量接收 |
如果确实希望对列表进行排序并继续流式处理,应当使用内置函数 sorted(),它会创建并返回一个全新的排好序的列表:
raw_numbers = [5, 2, 8, 1, 9]

# 正确做法:使用 sorted() 返回新列表,顺畅支持后续切片或链式转换
top_three_desc = sorted(raw_numbers, reverse=True)[:3]
print(top_three_desc)  # 示例输出:[9, 8, 5]
五、工程决策:何时拆分变量?何时使用链式?
在实际团队开发中,代码应当兼顾“表达的简洁”与“排查的便利”。过分追求单行链式调用被称为“链式调用走火入魔”,容易在出现异常时难以定位到底是哪个子调用出错了。
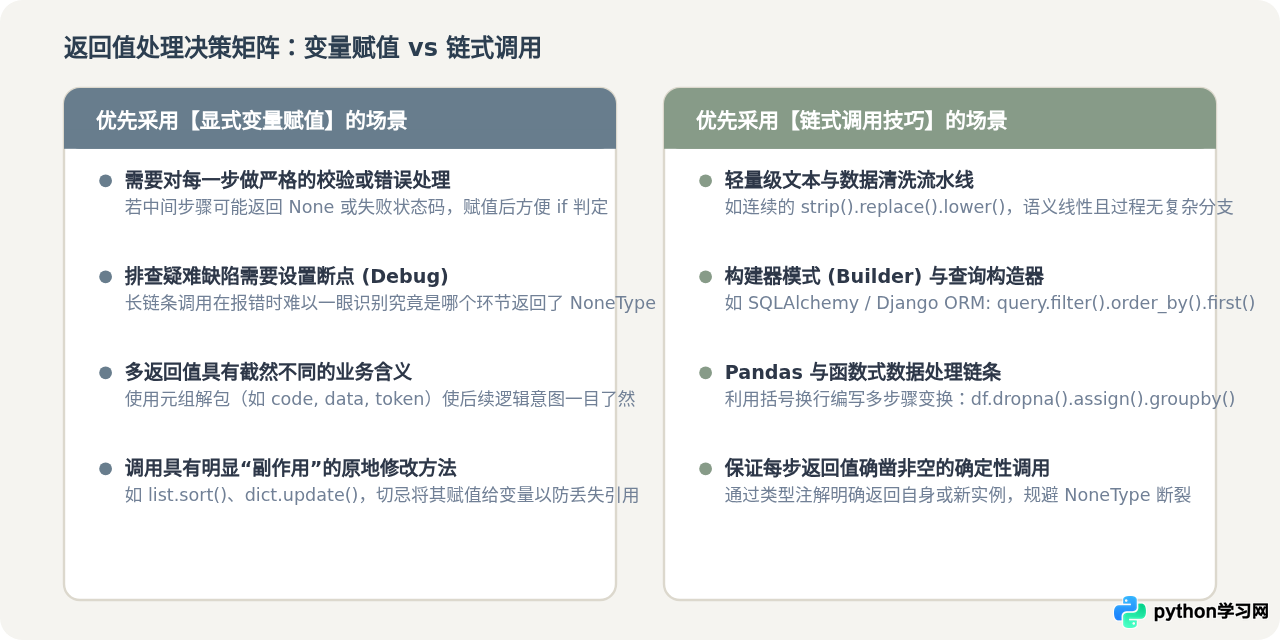
1. 优先拆分变量的场景
- 步骤包含不可靠的外部 I/O 或网络调用:例如先读取配置、再发起 HTTP 请求、最后解析 JSON。每个中间步骤都可能返回异常数据或
None,拆解为独立变量便于插入针对性的校验与异常捕获。 - 需要设置 IDE 断点单步排错:长链条调用在很多调试器中只会停留在同一行,难以单独观察第 3 或第 4 个函数的瞬时返回值。
- 返回值被多处逻辑复用:如果某一步的中间结果后续还需要传递给另外的子系统,显然应当将其固化命名为明确的变量。
2. 优先采用链式调用的场景
- 纯函数式的数据清洗与转换:如字符串预处理、列表过滤排序映射,每一步均无副作用且逻辑直接直观。
- 框架级 Fluent 接口:如 ORM 查询构造、PyTorch 模型序列搭建、Pandas 向量化流式计算。
- 换行格式化排版:当链式调用超过 3 个节点时,推荐使用小括号包裹并将各方法单起一行缩进对齐,以保持极佳的纵向扫视体验。
# 推荐的工程化多行链式书写风格
final_dataset = (
    raw_dataframe
    .dropna(subset=["target_column"])
    .query("score > 80")
    .reset_index(drop=True)
)本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















