


Python文件与目录操作命令汇总:os.path与pathlib常用方法
全面汇总Python文件与目录操作核心命令,系统对比传统os.path与现代面向对象pathlib的常用方法、属性解析、遍历读写及常见踩坑避障指南。
os.path,以及 Python 3.4 引入的现代面向对象模块 pathlib。本文针对文件检索、路径安全拼接、属性解析、多级目录创建与文件清理等日常高频场景,逐一对比两者的标准命令与等价写法,帮助读者建立清晰、可直接复用的文件操作知识体系。
一、核心理念差异:字符串处理 vs 面向对象建模
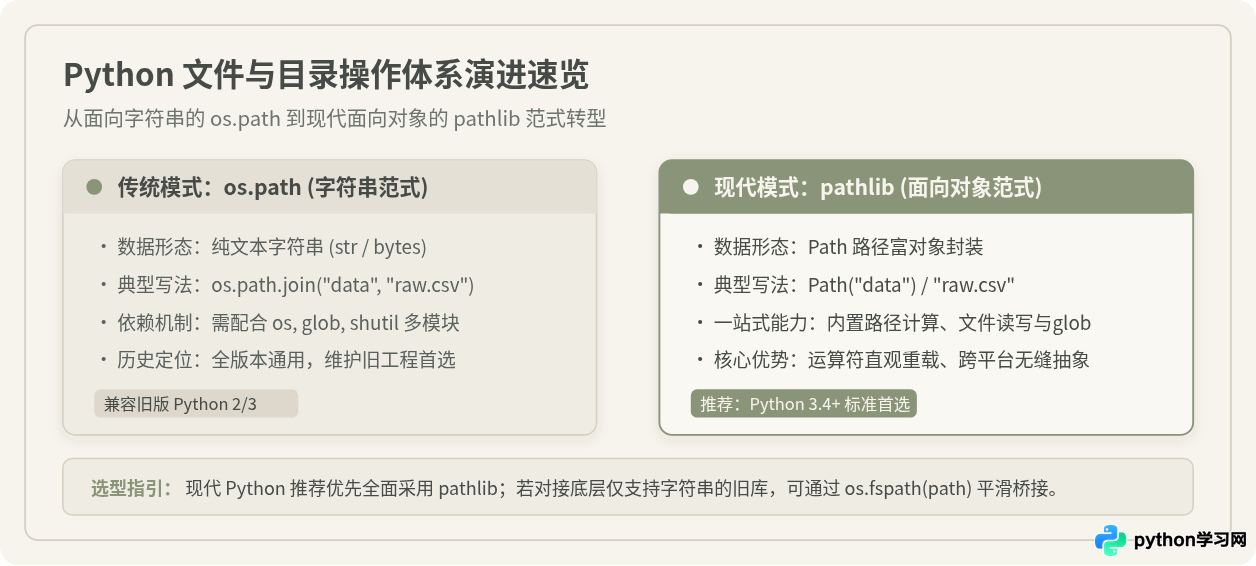
在编写文件与目录操作逻辑前,理解两种方案背后的设计哲学至关重要。传统 os.path 将系统路径看作一段“纯文本字符串”(str 或 bytes),开发者对路径的每一项检查、切分或拼装,都是在调用独立的系统函数,传入字符串并接收字符串输出。
而 pathlib 则引入了“富对象”概念,通过 Path 类将路径实体化。路径不再仅仅是扁平的字符序列,而是一个拥有各种状态属性与内建操作方法的活对象。在 pathlib 中,除法运算符 / 被优雅地重载为路径拼接器,极大提高了代码的表现力与可读性。
这种说法有一定依据但不够全面。之所以看似合理,是因为 pathlib 底层最终依然调用系统的底层 I/O 函数,且构造 Path 对象伴随轻微的类实例化与跨平台封装开销,在极端微基准测试(如单进程连续构建数千万次路径)中纯时间确实略高于原生字符串拼接。然而,在日常真实的 I/O 密集型业务中,磁盘读写与网络响应时间远超几纳秒的对象开销;相反,pathlib 统一了跨平台分隔符逻辑,杜绝了 Windows 反斜杠和 Linux 正斜杠的转义混淆,并在单个对象中集成了读写与遍历能力,代码的维护成本与安全性远优于散落的函数式字符串处理。
二、路径拼接与规范化:两套体系命令对比
构建文件路径是所有文件操作的基础。如果在拼接路径时直接使用 Python 的字符串相加(例如 "data" + "/" + "report.csv"),当代码迁移到 Windows 环境时可能会因为分隔符差异导致不可预测的逻辑缺陷。两套体系均提供了安全的路径拼接与规范化方法。
1. 路径拼接命令
# 传统 os.path 方式
import os

base_dir = "workspace"
sub_folder = "project"
filename = "data.csv"
target_os = os.path.join(base_dir, sub_folder, filename)

# 现代 pathlib 方式
from pathlib import Path

target_path = Path("workspace") / "project" / "data.csv"target_path: PosixPath('workspace/project/data.csv') 或 WindowsPath('workspace/project/data.csv')
2. 绝对路径与真实路径解析(解析软链接与相对符号)
当处理包含相对路径符号(如 ./ 或 ../)或符号链接(Symlink)时,开发者通常需要获取目标在文件系统中的精确物理位置:
# 传统方式
abs_path = os.path.abspath("../config.json")
real_path = os.path.realpath("../config.json")  # 展开符号链接与规范化

# pathlib 方式
p = Path("../config.json")
resolved_path = p.resolve()  # 直接消除相对路径并解析真实软链接
3. 家目录与环境变量展开
路径中的波浪号 ~ 代表当前用户主目录,系统默认不会自动将其转译为绝对路径,必须通过显式命令展开:
# 传统方式
user_config = os.path.expanduser("~/.myapp/config.yaml")

# pathlib 方式
user_config_path = Path("~/.myapp/config.yaml").expanduser()
# 或者直接获取当前用户主目录
home_dir = Path.home()
三、路径组成提取与属性解析
在日志分析、数据处理与批量重命名等任务中,经常需要将路径拆分为父级目录、主文件名及文件扩展名。在这一环节中,两者的代码简洁度差异尤为明显。
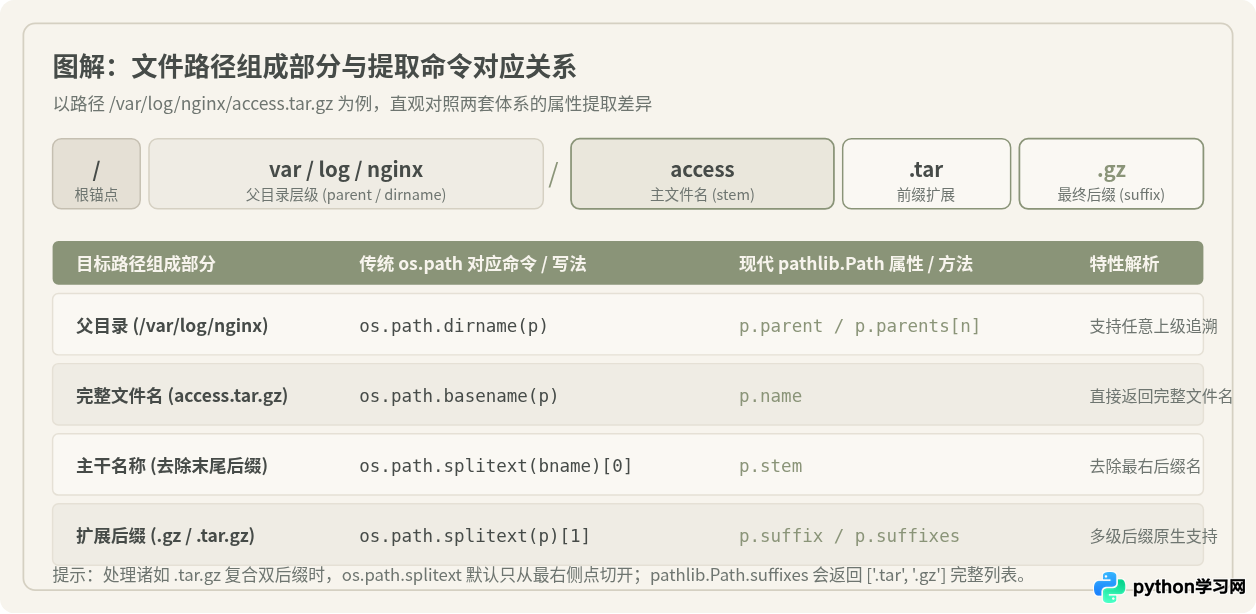
命令对比与复合后缀处理
sample_file = "/var/log/nginx/access.tar.gz"

# 1. 传统 os.path 提取方式
parent_dir = os.path.dirname(sample_file)          # "/var/log/nginx"
full_name = os.path.basename(sample_file)          # "access.tar.gz"
stem_name, suffix = os.path.splitext(full_name)    # ("access.tar", ".gz")

# 2. 现代 pathlib 提取方式
p = Path(sample_file)
parent_path = p.parent                             # PosixPath('/var/log/nginx')
name = p.name                                      # "access.tar.gz"
stem = p.stem                                      # "access.tar"
suffix = p.suffix                                  # ".gz"
all_suffixes = p.suffixes # ['.tar', '.gz'] (原生支持多后缀)无论是 os.path.splitext 还是 Path.stem / Path.suffix,默认规则都遵循标准规范,只以“最右侧的点”为界限划分。若需要精确剥离像 .tar.gz 这样的双重后缀,使用 pathlib.Path.suffixes 可以获取完整的切分后缀列表,从而通过 "".join(p.suffixes) 进行精准判断,避免手动切分字符串出现下标越界。
四、存在性检查与文件状态校验
在进行读写前,必须确认目标文件是否存在,以及它究竟是常规文件、文件夹还是系统链接,这是防御性编程的关键屏障。
| 功能需求 | os.path 命令 | pathlib.Path 方法 | 返回值与说明 |
|---|---|---|---|
| 检查路径是否存在 | os.path.exists(path) |
path.exists() |
布尔值 (True / False) |
| 判断是否为普通文件 | os.path.isfile(path) |
path.is_file() |
存在且为常规文件返回 True |
| 判断是否为目录 | os.path.isdir(path) |
path.is_dir() |
存在且为目录返回 True |
| 判断是否为符号链接 | os.path.islink(path) |
path.is_symlink() |
若是软链接返回 True |
| 获取文件字节大小 | os.path.getsize(path) |
path.stat().st_size |
整数 (字节数) |
| 获取最后修改时间戳 | os.path.getmtime(path) |
path.stat().st_mtime |
浮点数 (UNIX 时间戳) |
当一个符号链接指向的目标文件已被删除时,调用 os.path.exists(symlink) 或 path.exists() 均会返回 False!许多开发者会因此误以为该路径不存在而直接执行创建,导致系统抛出“文件已存在(FileExistsError)”的异常。正确的做法是在判断前调用 is_symlink() 确认是否为断链链接。
五、目录与文件创建、遍历与清理
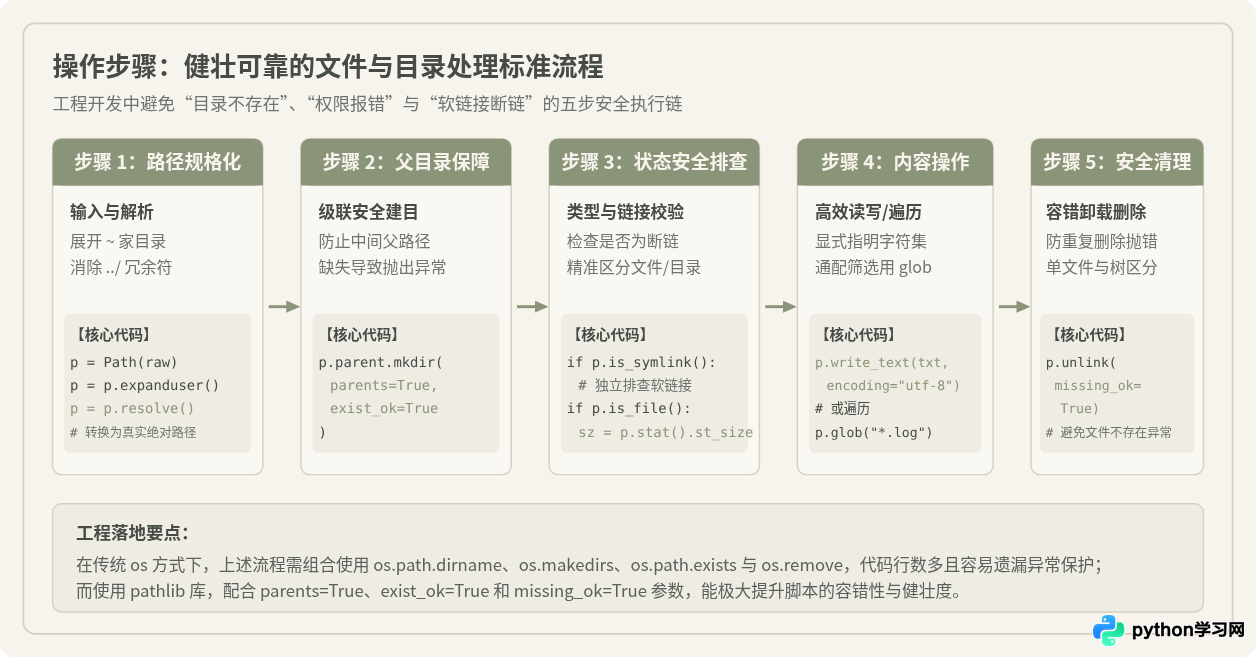
文件生命周期包含“创建目录 -> 遍历检索 -> 读写数据 -> 善后删除”。掌握这套流水线命令能大幅降低脚本运行时的异常报错率。
1. 级联安全创建多级目录
target_dir = "output/reports/2026/q1"

# 传统方式:需使用 os 模块的 makedirs
import os
os.makedirs(target_dir, exist_ok=True)

# pathlib 方式:直接由 Path 对象创建
from pathlib import Path
dir_path = Path(target_dir)
dir_path.mkdir(parents=True, exist_ok=True)关键参数说明:parents=True 相当于 Shell 中的 mkdir -p,会沿途补齐缺失的上级目录;exist_ok=True 保证在目录已存在时静默跳过,避免多线程并发执行时因竞态条件崩溃。
2. 目录遍历与模式匹配
遍历目录文件时,传统方式与现代方式在内存管理上有显著差别:
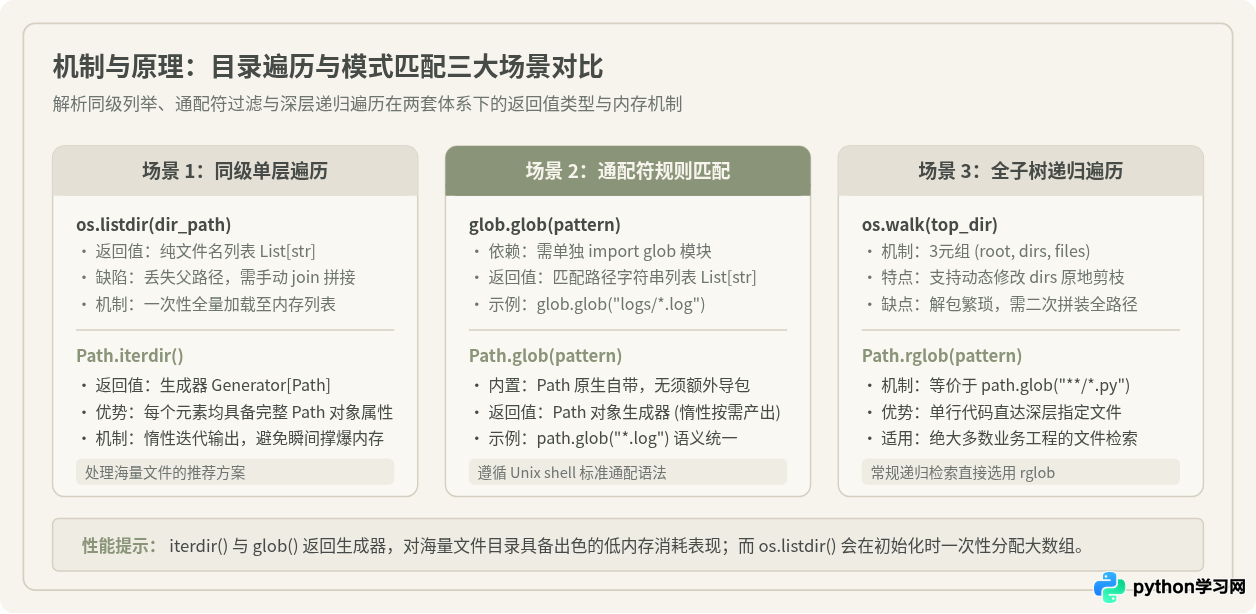
# 场景 A:仅遍历同级目录下的直属文件
# 传统方式
files = [os.path.join("logs", f) for f in os.listdir("logs")]

# pathlib 方式 (返回惰性生成器,节省大目录内存)
files_gen = [f for f in Path("logs").iterdir() if f.is_file()]

# 场景 B:使用通配符匹配特定扩展名
# 传统方式 (需借助第三方或独立 glob 模块)
import glob
csv_files = glob.glob("data/*.csv")

# pathlib 方式 (内置 glob 支持)
csv_paths = list(Path("data").glob("*.csv"))

# 场景 C:递归搜索全子树中的所有 Python 脚本
# 传统方式使用 os.walk
py_list = []
for root, _, files in os.walk("src"):
    for f in files:
        if f.endswith(".py"):
            py_list.append(os.path.join(root, f))

# pathlib 方式使用 rglob (单行完成全目录深度检索)
py_paths = list(Path("src").rglob("*.py"))
3. 一站式快速文本读写
对于几十兆以内的小型文本或配置文件,pathlib 提供了极度精炼的内置读写 API,省去了反复编写 with open(...) 模板代码的繁杂:
conf_file = Path("settings.json")

# 快速写入文本数据 (显式指明 UTF-8 编码)
conf_file.write_text('{"status": "active", "version": 2}', encoding="utf-8")

# 快速读取全部文本内容
content = conf_file.read_text(encoding="utf-8")4. 文件与目录的安全清理删除
# 传统方式
if os.path.exists("temp.log"):
    os.remove("temp.log")

# pathlib 方式 (Python 3.8+ 支持 missing_ok 参数)
target = Path("temp.log")
target.unlink(missing_ok=True)  # 若文件不存在也不抛出 FileNotFoundError

# 删除空目录
dir_target = Path("temp_empty_dir")
if dir_target.is_dir():
    dir_target.rmdir()          # 注意:rmdir 只能删除空目录
六、工程实战完整示例:自动化日志清理归档
为了加深理解,下面通过一个完整的生产实用示例展示如何综合运用上述命令:在指定的日志根目录下,自动检测并创建归档目录,扫描所有超过 30 天未修改或体积大于 50MB 的 .log 历史文件并进行安全迁移。
import time
from pathlib import Path

def archive_old_logs(base_dir: str, max_age_days: int = 30) -> int:
    log_root = Path(base_dir).resolve()
    archive_dir = log_root / "archived"

    # 步骤 1:确保归档目标父目录安全就绪
    archive_dir.mkdir(parents=True, exist_ok=True)

    current_time = time.time()
    seconds_limit = max_age_days * 86400
    migrated_count = 0

    # 步骤 2:使用 rglob 深度递归检索全部日志
    for log_path in log_root.rglob("*.log"):
        # 排除已位于归档目录中的文件,避免循环处理
        if archive_dir in log_path.parents:
            continue

        file_stat = log_path.stat()
        file_age = current_time - file_stat.st_mtime
        file_size_mb = file_stat.st_size / (1024 * 1024)

        # 步骤 3:多维度属性比对 (时间超限或单文件超 50MB)
        if file_age > seconds_limit or file_size_mb > 50:
            target_dest = archive_dir / log_path.name
            # 安全重命名/移动
            log_path.replace(target_dest)
            migrated_count += 1

    return migrated_count

# 执行调用示例
# total = archive_old_logs("./app_logs", max_age_days=15)七、速查汇总与工程选型建议
在了解了常用方法的技术细节后,下方的总结决策图与速查表格可作为日常开发的便查备忘手册。
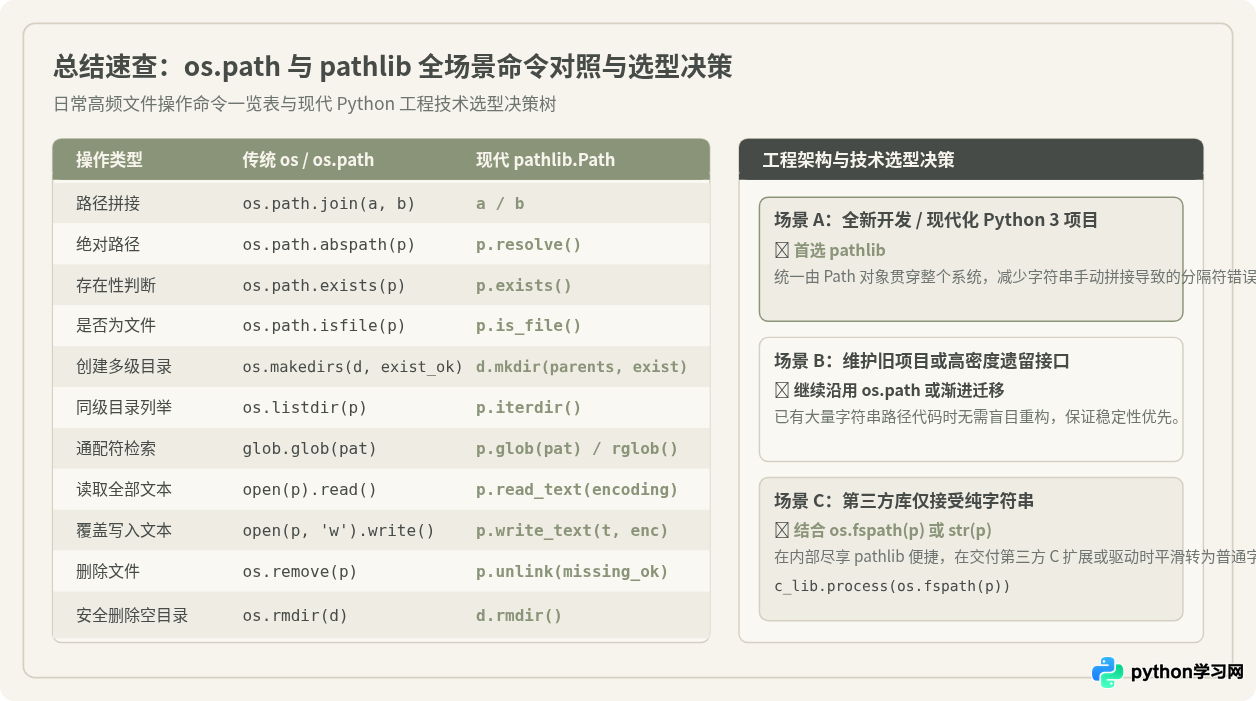
工程选型与平滑迁移建议
- 新建工程优先 pathlib:只要运行环境在 Python 3.6 以上,推荐在全部业务逻辑中首选
from pathlib import Path,将路径对象作为工程的标准类型。 - 遗留系统审慎重构:对于已经稳定上线数年且大量依赖
os.path字符串处理的旧项目,不必为了形式上的现代性盲目大改;但若进行模块重构,可在新建模块中局部引入。 - 平滑兼容纯字符串第三方库:某些古老的底层第三方 C 扩展(如部分旧版图像驱动或科学计算接口)入参仅接受纯
str。此时无需退回os.path,只需在传参处调用内置的os.fspath(path_obj)或str(path_obj)即可完成解包,两全其美。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















