


Python爬虫可以抓取哪些数据:文本、图片及API接口详解
深入解析Python网络爬虫可以抓取的三大核心数据形态:HTML网页文本、图片及多媒体二进制流、后端API接口数据。详细讲解DOM解析、防盗链突破、接口逆向与选型决策。
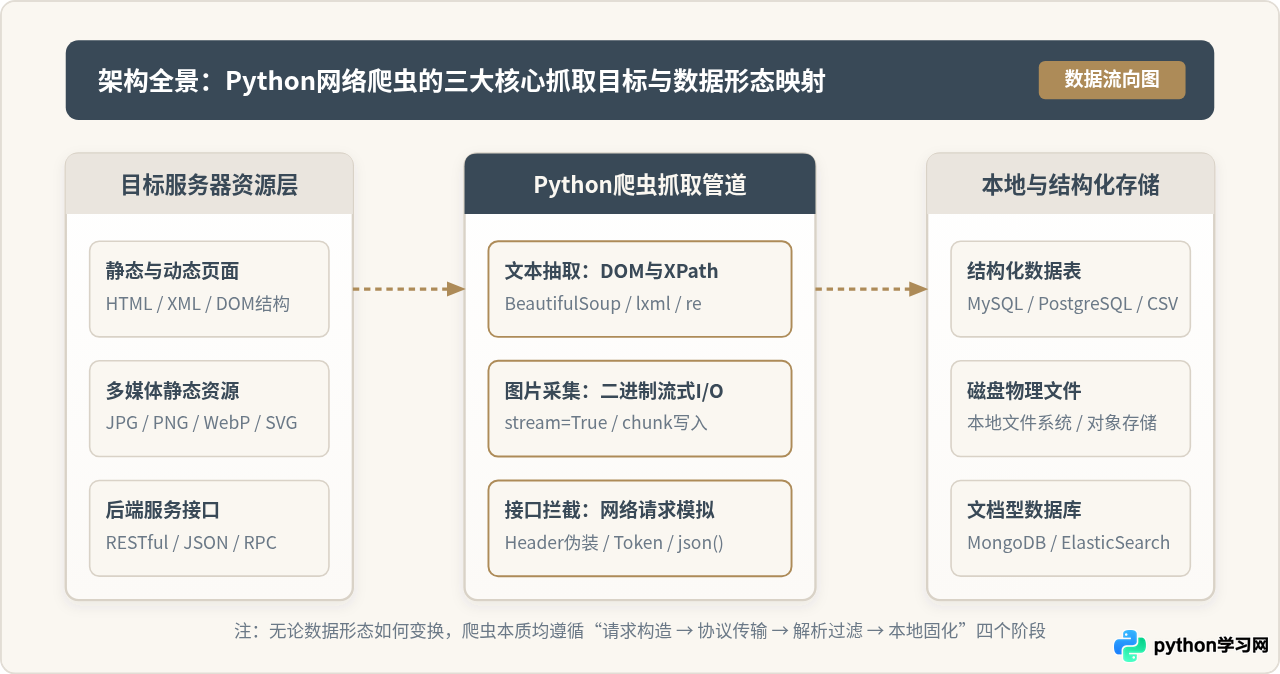
一、文本数据抓取:结构化提取与字符处理
文本数据是网络爬虫最常见、最基础的抓取对象。无论是新闻门户的文章资讯、电商平台的商品标题与规格说明、专业百科的词条正文,还是社交论坛的评论与发帖记录,最初都是以字符形式嵌在服务端的HTML响应文本中返回给浏览器的。
1.1 文本提取的核心机制
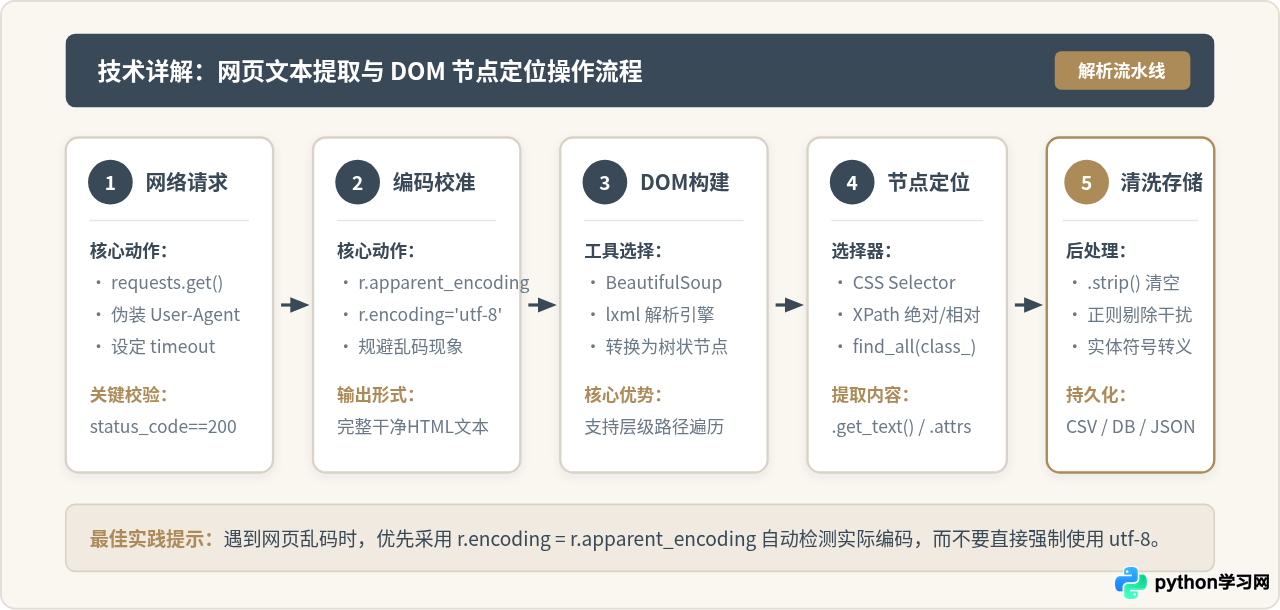
抓取文本数据的完整流程通常包括三个环节:首先通过网络请求库(如requests)获取服务器返回的HTML源码;随后利用DOM解析引擎(如BeautifulSoup或lxml)将扁平的HTML字符串转换为树状的对象模型;最后根据预设的路径或属性规则,精确定位并提取出纯文本内容。
在节点定位技术中,目前主流采用两种方案:
- CSS选择器:语法与前端样式选择器完全一致,擅长通过类名(class)、ID和父子标签层级进行匹配(例如
div.article-content > p),语法直观,学习成本低。 - XPath路径表达式:基于XML节点树的查询语言,不仅支持层级遍历与属性定位,还原生支持文本内容模糊匹配、轴关系查询(如选取父节点、兄弟节点),在复杂或结构不规则的旧式网页中具备更强的灵活性。
1.2 文本抓取完整代码实现
下面是一个标准的文本抓取示例,演示了如何获取页面源码、校准字符编码,并通过 CSS 选择器提取文章标题与正文段落:
import requests
from bs4 import BeautifulSoup

def fetch_article_text(url: str) -> dict:
    # 构造标准请求头,避免默认的 python-requests 请求头被服务器直接拦截
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 '
                      '(KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'
    }

    try:
        # 发起 HTTP GET 请求,设置超时时间防止线程永久阻塞
        response = requests.get(url, headers=headers, timeout=10)
        response.raise_for_status()  # 若状态码非 200 则主动抛出 HTTPError 异常

        # 编码校准:优先依据响应体内容推测实际编码,解决中文常见乱码问题
        response.encoding = response.apparent_encoding

        # 构建 BeautifulSoup DOM 树,选用解析速度较快的 lxml 引擎
        soup = BeautifulSoup(response.text, 'lxml')

        # 1. 提取文章标题(以 h1 标签为例)
        title_tag = soup.find('h1')
        title = title_tag.get_text(strip=True) if title_tag else "无标题"

        # 2. 提取正文内容(以 class 包含 content 的容器为例)
        content_box = soup.find('div', class_='content')
        paragraphs = []
        if content_box:
            # 提取所有子段落文本,去除首尾空白字符
            for p in content_box.find_all('p'):
                text = p.get_text(strip=True)
                if text:
                    paragraphs.append(text)

        return {
            "url": url,
            "title": title,
            "paragraphs": paragraphs
        }

    except requests.exceptions.RequestException as e:
        print(f"网络请求失败 [{url}]: {e}")
        return {}
1.3 文本抓取的常见陷阱与解决要点
- 字符编码混乱:中文网页历史遗留了 GBK、GB2312 与 UTF-8 混用的情况。若未显式指定编码,
requests可能默认使用ISO-8859-1,导致中文显示为乱码。在解析前设置response.encoding = response.apparent_encoding是最通用的纠偏手段。 - HTML实体字符干扰:抓取到的文本中常含有
、<、"等实体字符。应在持久化前使用 Python 内置的html.unescape()函数进行还原清洗。 - 动态渲染陷阱:如果网页源码中目标节点的容器为空(例如只有一个
<div id="app"></div>),说明该页面采用了前端 JavaScript(如 React、Vue)异步渲染,此时直接抓取 HTML 将一无所获,应转为抓取 API 接口或使用无头浏览器。
二、图片与多媒体数据抓取:二进制下载与反盗链应对
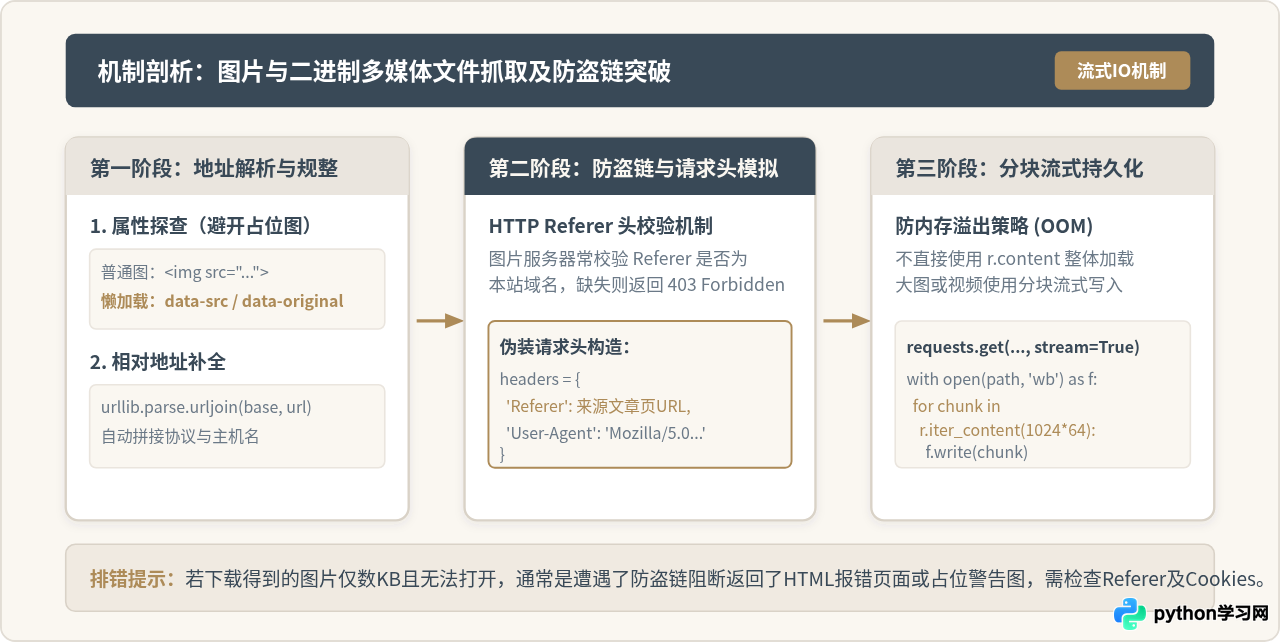
与纯字符构成的文本不同,图片(JPG、PNG、WebP、SVG)、音频(MP3)和视频(MP4)属于二进制多媒体资产。在网页传输中,服务器并不会直接在 HTML 标签中嵌入图片的原始二进制流,而是提供该资源的 URL 链接(如 <img src="...">)。因此,多媒体抓取本质上是“分步走”的操作:第一步先提取资源链接,第二步针对链接发起二进制流式下载。
2.1 图片地址解析与懒加载(Lazy Loading)
为节约带宽与提升首屏加载速度,绝大多数现代网站对图片采用了“懒加载”技术。在用户未将页面滚动到可视区域时,<img> 标签的 src 属性往往被设置为一个 1×1 像素的透明占位图或默认加载动画,真实的图片超链接被隐藏在自定义属性中,常见的命名有 data-src、data-original、data-actualsrc 或 srcset。
编写爬虫时,提取规则必须优先判断这些自定义属性是否存在,若存在则优先使用自定义属性值;若提取出的是相对路径(如 /images/photo.jpg),则必须使用 urllib.parse.urljoin() 将其转换为包含协议和域名的完整绝对 URL。
2.2 防盗链机制(HTTP Referer)及其突破
许多图片服务器(如 CDN 存储桶、图床)部署了严格的“防盗链”验证策略。当爬虫直接向图片 URL 发送 GET 请求时,服务端会检查 HTTP 请求头中的 Referer 字段。如果 Referer 为空,或者其域名不属于该网站的白名单,服务器会立刻返回 403 Forbidden 状态码,或者返回一张提示“禁止外链”的警告占位图。
突破这一限制的正确做法是:在请求图片二进制数据时,显式将该图片所在的宿主文章页面 URL 填入 Referer 请求头中,使请求在服务端校验时完全符合浏览器正常展示的行为特征。
2.3 图片流式下载完整代码实现
import os
from urllib.parse import urljoin
import requests

def download_image(img_url: str, page_url: str, save_dir: str = "downloads") -> str:
    """
    流式下载单张图片并保存到指定文件夹
    :param img_url: 图片原始 URL(支持相对路径与绝对路径)
    :param page_url: 来源宿主页面 URL(用于构造 Referer 头以绕过防盗链)
    :param save_dir: 本地存储目录
    """
    # 补全相对路径
    full_url = urljoin(page_url, img_url)

    # 构造请求头,携带关键的 Referer 字段
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0.0.0 Safari/537.36',
        'Referer': page_url
    }

    os.makedirs(save_dir, exist_ok=True)
    # 取 URL 路径中的文件名,过滤查询参数
    filename = full_url.split('?')[0].split('/')[-1]
    if not filename or '.' not in filename:
        filename = "media_asset.jpg"

    local_path = os.path.join(save_dir, filename)

    try:
        # 设置 stream=True 开启流式响应,避免大文件一次性载入内存导致 OOM
        with requests.get(full_url, headers=headers, stream=True, timeout=15) as r:
            r.raise_for_status()

            # 分块写入本地二进制文件
            with open(local_path, 'wb') as f:
                for chunk in r.iter_content(chunk_size=1024 * 64):
                    if chunk:
                        f.write(chunk)

        return local_path
    except requests.exceptions.RequestException as err:
        print(f"图片下载失败 [{full_url}]: {err}")
        return ""
三、API接口抓取:逆向分析与高效率数据获取
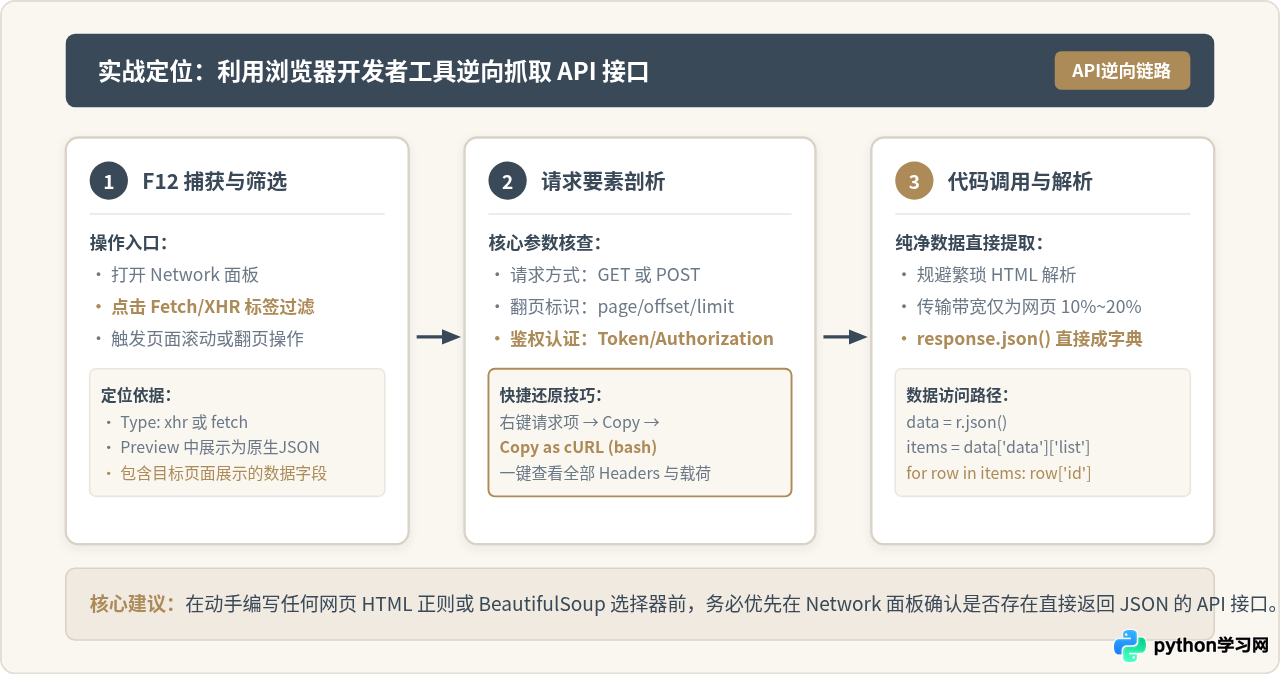
现代 Web 应用普遍采用前后端分离架构,前端页面只负责骨架展示,真实的数据通常由后端的 RESTful 接口异步提供,以 JSON(JavaScript Object Notation)格式在网络中流转。对于爬虫开发者而言,抓取 API 接口不仅能获得极其纯净的结构化数据,而且采集效率远高于解析整页 HTML。
3.1 API 抓取的核心优势
- 极高的信噪比与解析效率:HTML 文档中充斥着样式标签、嵌套结构和冗余脚本,而 API 接口仅返回纯粹的业务字段。解析 JSON 只需调用
response.json(),直接转换为 Python 字典或列表,省去了编写复杂 XPath 或 CSS 选择器的繁琐工作。 - 网络带宽与处理耗时大幅削减:单个 HTML 页面的体积常在数十 KB 到上百 KB,加上静态资源可能达数 MB;而对应的 JSON 接口载荷往往只有几 KB 到十几 KB,数据传输与解析耗时通常只有传统网页爬取的 10%~20%。
- 更稳定的数据格式:前端 UI 经常因为样式升级、改版而变更标签层级,导致原本写好的 CSS 选择器失效;而后端 API 接口通常具有版本控制和较为严格的字段契约,结构变更频率显著低于 DOM。
3.2 逆向发现与定位 API 接口的步骤
- 开启网络监控:在 Chrome 或 Edge 浏览器中按
F12打开开发者工具,切换到 Network(网络) 面板。 - 筛选传输类型:在过滤器中选中 Fetch/XHR,屏蔽图片、CSS、JS 等静态资源的干扰。
- 触发数据加载:在页面上执行下拉刷新、点击“加载更多”或切换分页,观察 Network 列表中新出现的网络请求。
- 审查响应载荷:点击新出现的请求,在 Preview(预览) 标签页中检查返回的内容。若内容展现为包含目标列表的 JSON 树状结构,即锁定了核心 API。
- 提取请求要素:在 Headers 中核查请求方式(GET/POST)、目标 URL、Query String Parameters(或 Request Payload),并检查是否附带了
Authorization或Token等鉴权凭据。
3.3 API 接口数据抓取代码实现
import requests

def fetch_api_dataset(api_url: str, page: int = 1, page_size: int = 20) -> list:
    """
    请求结构化 API 接口并直接解析纯净 JSON 数据
    """
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0.0.0 Safari/537.36',
        'Accept': 'application/json, text/plain, */*',
        # 若接口需要权限校验,在此配置由抓包获取的 Token 凭证
        # 'Authorization': 'Bearer YOUR_ACCESS_TOKEN'
    }

    # 构造接口查询参数
    params = {
        'page': page,
        'limit': page_size,
        'sort': 'latest'
    }

    try:
        response = requests.get(api_url, headers=headers, params=params, timeout=10)
        response.raise_for_status()

        # 将 JSON 响应体反序列化为 Python 原生字典
        payload = response.json()

        # 根据业务约定提取嵌套的数据列表
        records = []
        if payload.get('code') == 200 or payload.get('status') == 'success':
            items = payload.get('data', {}).get('list', [])
            for item in items:
                records.append({
                    'id': item.get('id'),
                    'title': item.get('title'),
                    'published_at': item.get('created_time'),
                    'view_count': item.get('views', 0)
                })

        return records

    except requests.exceptions.RequestException as e:
        print(f"API 请求异常 [{api_url}]: {e}")
        return []
    except ValueError as e:
        print(f"JSON 序列化失败,响应非标准 JSON 格式: {e}")
        return []
四、三种抓取方式的技术对比与选型决策
在实际构建爬虫工程时,并不是所有任务都采用相同的手法。针对不同的数据形态与系统特征,需要综合考量开发效率、运行开销与反爬阻力。
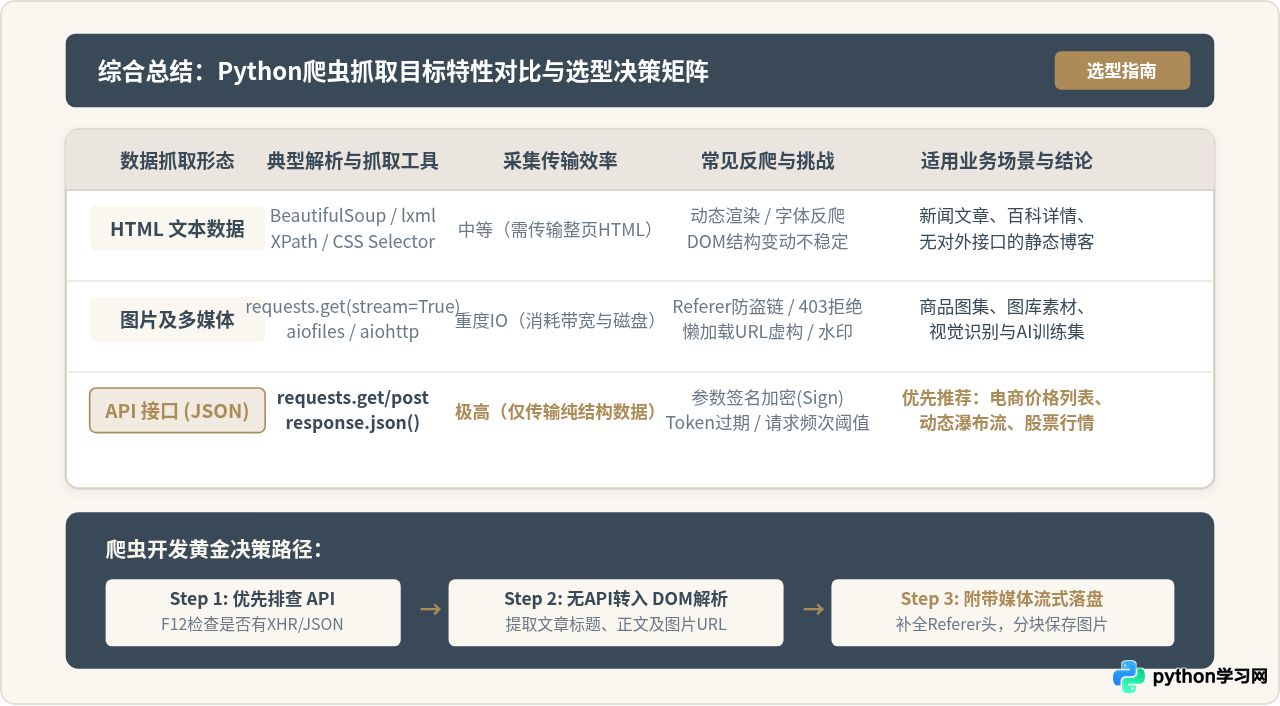
| 数据形态 | 典型解析工具 | 网络与IO开销 | 主要维护成本与挑战 | 工程选型建议 |
|---|---|---|---|---|
| HTML 文本数据 | BeautifulSoup, lxml, XPath | 中等(传输整页标记语言) | 前端改版破坏节点层级;字符编码错乱;动态JS渲染 | 传统新闻站点、静态博客、百科词条等无开放接口的页面 |
| 图片与多媒体 | requests (stream=True), aiofiles | 重度(高带宽与磁盘写入) | Referer 防盗链 403 阻断;懒加载属性虚构;高并发容易超载 | 商品素材库、图像识别数据集、壁纸下载等明确需要物理归档的场景 |
| API 接口 (JSON) | requests, httpx, 内置 json 模块 | 极低(纯粹紧凑的业务字段) | 请求参数包含加解密签名(Sign);Token 过期时间短;频次阈值严格 | 最高优先级推荐:电商价格、动态流水、评论列表等前后端分离系统 |
五、爬虫实践中的边界与规范
无论抓取何种数据形态,网络爬虫的本质都是一种程序化访问手段,开发者在编写和运行爬虫时必须时刻坚守技术与法律的边界:
- 请求频率节制:爬虫的高频请求极易对目标站点服务器造成非预期的并发冲击,甚至引发类似拒绝服务攻击(DoS)的后果。在编写循环抓取逻辑时,应加入适度的随机延时(例如
time.sleep(random.uniform(1.0, 3.0))),限制并发线程数量。 - 遵守协议与声明:在开展抓取前,主动查看目标域名下的
robots.txt协议文件,严格规避网站明确声明禁止抓取的路径和受限爬虫代理规则。 - 数据隐私与权限底线:爬虫抓取的合法范围仅限于未经身份越权即可公开访问的公开数据。严禁抓取涉及公民个人隐私、非公开商业秘密,或绕过付费与越权权限强行采集未授权的内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















