


Python脚本在定时任务备份与日志分析中的实际应用

深入讲解如何使用Python标准库编写高可靠的定时备份脚本与流式日志分析程序,涵盖环境配置、进程锁、数据校验、流式解析与异常告警的全流程工程实践。
自动化备份与日志分析是保障系统稳定运行的两大基石任务。很多小型项目或日常运维初期往往依赖人工检查,但随着业务持续运行,数据遗漏备份与日志爆满失控的问题会频繁出现。本文将介绍如何利用 Python 标准库编写高效、健壮的文件备份与流式日志分析脚本,并结合操作系统的定时任务调度器(如 Linux Crontab),构建一套免安装重型外部 Agent、开箱即用的轻量级自动化运维闭环。
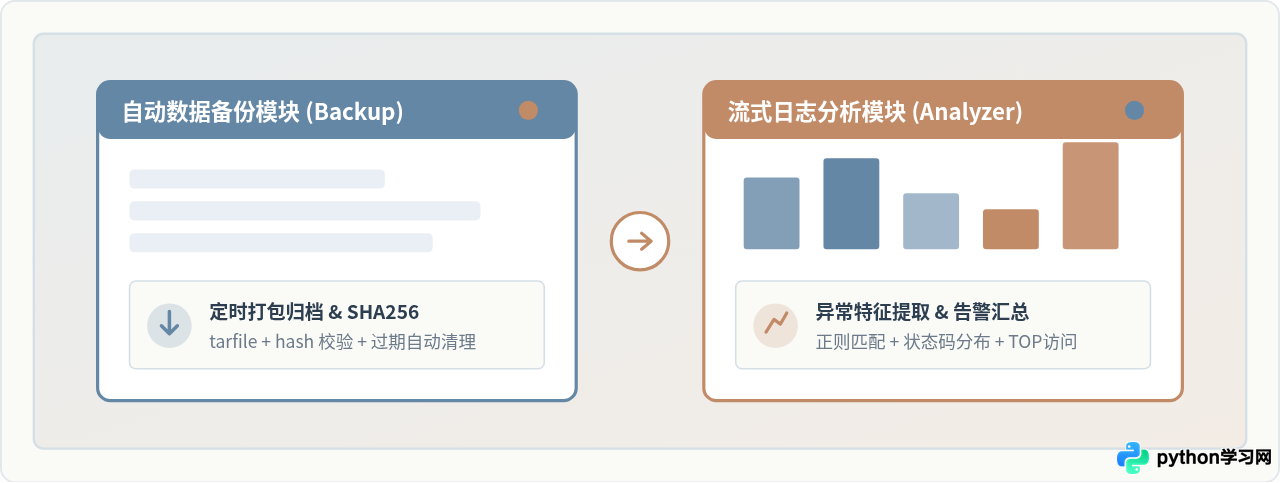
一、自动化文件备份脚本的设计与实现
编写备份脚本的核心目标并不只是把目标文件夹压缩打包,而是必须确保备份全周期的确定性:包括备份前检查目标目录与磁盘余量、压缩时避免半途故障产生脏文件、自动计算校验和以备灾难恢复核验,以及依照保留天数自动清理历史旧归档,防止服务器磁盘被逐渐撑爆。
在设计上,推荐采用“临时文件写入 + 校验完成原子重命名”的机制。如果打包过程中断(例如进程被杀或空间告警),临时文件不会被误认为是有效备份。同时,利用 tarfile 模块的 w:gz 模式提供高压缩比归档,并用 hashlib 同步产出 SHA-256 校验和清单。
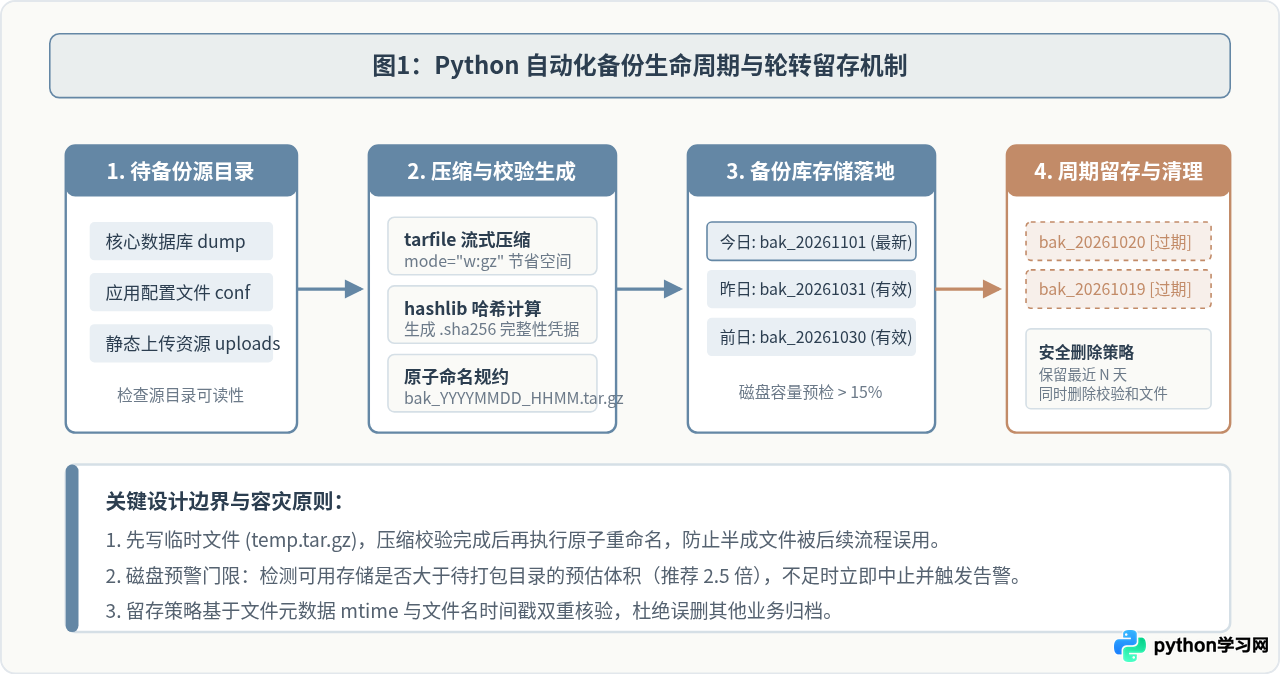
1. 完整备份与多版本轮转代码
以下为一个可直接执行的生产级备份脚本,无需安装任何第三方第三方包,纯依赖 Python 3 标准库即可运行:
# -*- coding: utf-8 -*-
import os
import sys
import shutil
import tarfile
import hashlib
import datetime

def calculate_sha256(filepath):
    """计算备份归档的 SHA-256 哈希值,用于后续完整性核对"""
    sha256 = hashlib.sha256()
    with open(filepath, 'rb') as f:
        for chunk in iter(lambda: f.read(65536), b''):
            sha256.update(chunk)
    return sha256.hexdigest()

def execute_backup(src_dir, dest_dir, retention_days=7):
    # 1. 基础路径合法性验证
    if not os.path.isdir(src_dir):
        print(f"[错误] 源目录不存在: {src_dir}", file=sys.stderr)
        return False
    os.makedirs(dest_dir, exist_ok=True)

    # 2. 磁盘可用空间预检(至少保留待备份源文件大小的 1.5 倍)
    total_size = sum(
        os.path.getsize(os.path.join(r, f))
        for r, _, files in os.walk(src_dir) for f in files
    )
    free_disk = shutil.disk_usage(dest_dir).free
    if free_disk < (total_size * 1.5):
        print(f"[错误] 磁盘空间不足! 需求: {total_size * 1.5 // 1024 // 1024}MB, 可用: {free_disk // 1024 // 1024}MB", file=sys.stderr)
        return False

    # 3. 生成基于时间戳的标准归档文件名
    now_str = datetime.datetime.now().strftime("%Y%m%d_%H%M%S")
    final_archive = os.path.join(dest_dir, f"backup_{now_str}.tar.gz")
    temp_archive = os.path.join(dest_dir, f".temp_backup_{now_str}.tar.gz")

    print(f"[信息] 开始打包压缩源目录: {src_dir} ...")
    try:
        with tarfile.open(temp_archive, "w:gz") as tar:
            tar.add(src_dir, arcname=os.path.basename(src_dir))

        # 压缩完成后重命名为正式归档文件
        os.replace(temp_archive, final_archive)
        print(f"[完成] 归档生成成功: {final_archive}")
    except Exception as e:
        if os.path.exists(temp_archive):
            os.remove(temp_archive)
        print(f"[异常] 打包过程失败: {e}", file=sys.stderr)
        return False

    # 4. 校验和计算并写入对应的 .sha256 描述文件
    digest = calculate_sha256(final_archive)
    sha_file = final_archive + ".sha256"
    with open(sha_file, "w") as f:
        f.write(f"{digest}  {os.path.basename(final_archive)}\n")
    print(f"[信息] SHA256 校验和已记录: {digest}")

    # 5. 按照留存天数执行历史归档清理
    cutoff_time = datetime.datetime.now() - datetime.timedelta(days=retention_days)
    for entry in os.listdir(dest_dir):
        if entry.startswith("backup_") and (entry.endswith(".tar.gz") or entry.endswith(".sha256")):
            file_path = os.path.join(dest_dir, entry)
            mtime = datetime.datetime.fromtimestamp(os.path.getmtime(file_path))
            if mtime < cutoff_time:
                os.remove(file_path)
                print(f"[清理] 移除超出保留期的旧归档: {entry}")

    return True

if __name__ == "__main__":
    # 示例:备份 /data/app_data 到 /data/backups,保留最近 7 天
    SRC = "/data/app_data"
    DEST = "/data/backups"
    success = execute_backup(SRC, DEST, retention_days=7)
sys.exit(0 if success else 1)1. 避免相对路径:定时任务触发时的当前工作目录通常是用户的家目录或根目录,凡涉及路径均应使用绝对路径。
2. 临时文件前缀隐藏:采用 .temp_ 作为前缀,配合 os.replace 可以避免监控程序扫描到尚未写完的损坏文件。
二、系统定时任务的配置与执行防护
即便 Python 脚本逻辑严谨,如果定时调度配置不当,也会导致各种静默失败,例如找不到环境变量、依赖模块加载失败或两次执行周期重叠导致数据损坏。在 Linux 系统下,推荐使用 crontab 搭配 flock 进程文件锁进行防护。
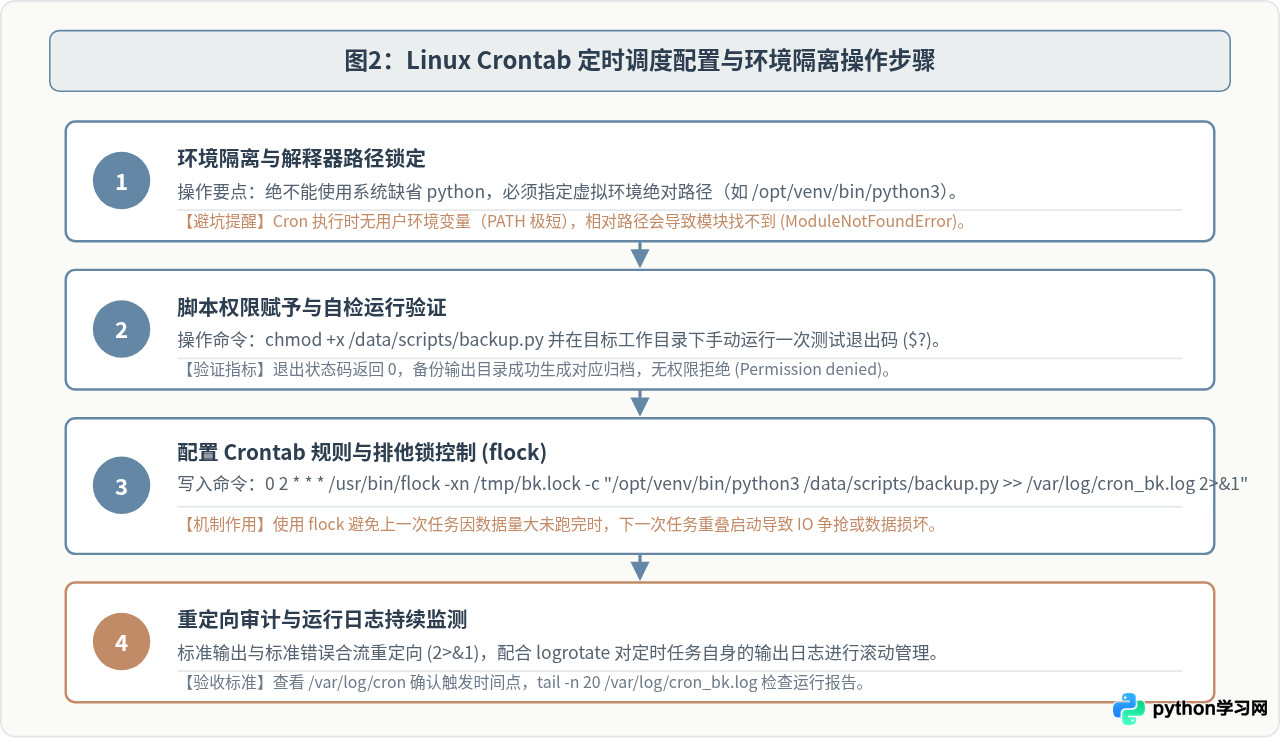
1. Crontab 配置的标准写法
编辑定时任务列表请使用命令 crontab -e。在编写规则时,务必注意指定 Python 解释器的完整绝对路径:
# 每天凌晨 02:30 执行数据备份,并在日志中记录标准输出与错误输出
30 2 * * * /usr/bin/flock -xn /tmp/app_backup.lock -c "/usr/local/bin/python3 /data/scripts/backup.py >> /var/log/backup_cron.log 2>&1"

# 每天凌晨 03:00 执行前一天的日志分析
0 3 * * * /usr/bin/flock -xn /tmp/app_log_analyze.lock -c "/usr/local/bin/python3 /data/scripts/log_analyzer.py >> /var/log/log_analyze_cron.log 2>&1"
上述命令中的几个关键参数解释如下:
/usr/bin/flock -xn /tmp/app_backup.lock -c "...":为任务加互斥排他锁(-x)且不等待(-n)。如果上一次备份尚未结束,下一次调度将直接退出,避免同时对同一数据源打包。2>&1:将标准错误(stderr)重定向到标准输出(stdout),确保即使出现异常堆栈也能在指定的日志文件中完整看到。
三、流式日志分析与异常特征提取
服务器在持续运行时会产生海量访问日志或业务日志,其体积常以 GB 为单位。很多初学者习惯使用 f.readlines() 将整个文件读入内存,这极易引发服务器的内存溢出(OOM),甚至连累正常运行的业务进程被操作系统杀死。
正确的做法是基于 Python 的生成器(Generator)进行按行流式读取,结合预编译的高性能正则表达式,在恒定内存开销(通常小于 20MB)下完成对数千万行日志的过滤、状态码计数及异常请求提取。
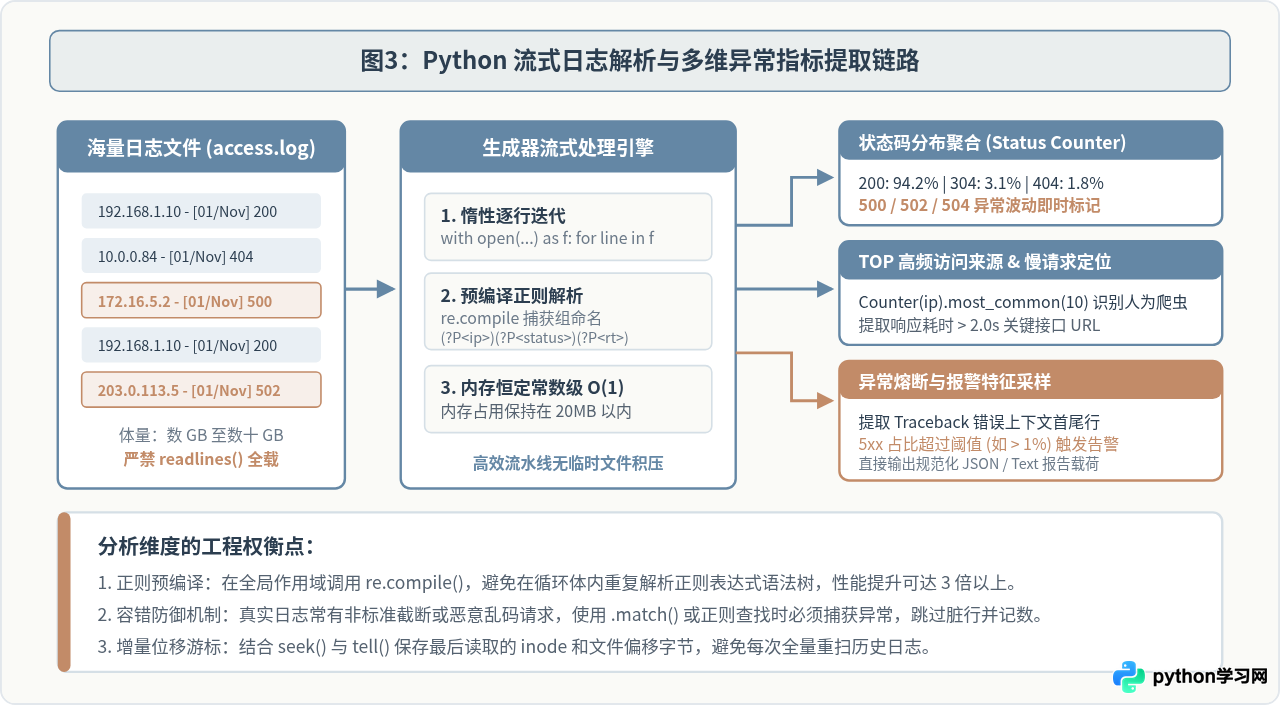
1. 完整的高效日志分析脚本示例
以下脚本以 Nginx 标准日志(Combined 格式)为例,展示如何逐行统计 HTTP 状态码分布、计算 4xx/5xx 错误比率、统计访问频次最高的 IP(TOP 10)并筛选耗时较长的慢请求:
# -*- coding: utf-8 -*-
import re
import sys
from collections import Counter

# 预编译正则表达式以获得最高匹配性能
# 匹配典型 Nginx 日志格式: $remote_addr - $remote_user [$time_local] "$request" $status $body_bytes_sent
LOG_PATTERN = re.compile(
    r'^(?P<ip>[\d\.]+) - \S+ \[.*?\] "(?P<method>[A-Z]+) (?P<path>\S+) HTTP/\d\.\d" (?P<status>\d{3}) (?P<bytes>\d+)'
)

def stream_log_reader(filepath):
    """生成器:按行流式读取,内存占用始终恒定"""
    with open(filepath, 'r', encoding='utf-8', errors='replace') as f:
        for line in f:
            yield line

def analyze_access_log(filepath):
    status_counter = Counter()
    ip_counter = Counter()
    path_error_counter = Counter()
    total_lines = 0
    parse_errors = 0

    print(f"[分析] 开始扫描日志文件: {filepath}")
    for raw_line in stream_log_reader(filepath):
        total_lines += 1
        m = LOG_PATTERN.match(raw_line)
        if not m:
            parse_errors += 1
            continue

        data = m.groupdict()
        status = int(data['status'])
        ip = data['ip']
        path = data['path']

        status_counter[status] += 1
        ip_counter[ip] += 1

        # 捕获服务端异常 (5xx)
        if 500 <= status <= 599:
            path_error_counter[path] += 1

    # 计算聚合指标
    valid_lines = total_lines - parse_errors
    server_errors_5xx = sum(count for code, count in status_counter.items() if 500 <= code <= 599)
    error_rate = (server_errors_5xx / valid_lines * 100) if valid_lines > 0 else 0.0

    # 输出结构化巡检简报
    print("=" * 50)
    print("            Nginx 每日访问与健康分析报告")
    print("=" * 50)
    print(f"总扫描行数: {total_lines} 行 | 格式跳过行数: {parse_errors} 行")
    print(f"5xx 服务端异常数: {server_errors_5xx} (占比: {error_rate:.2f}%)")
    print("\n[状态码分布概览]")
    for code, count in sorted(status_counter.items()):
        ratio = (count / valid_lines * 100) if valid_lines > 0 else 0
        print(f"  状态码 {code}: {count:>8} 次 ({ratio:>5.2f}%)")

    print("\n[TOP 5 访问量最高的客户端 IP]")
    for ip, count in ip_counter.most_common(5):
        print(f"  {ip:<18} -> {count:>6} 次请求")

    if path_error_counter:
        print("\n[TOP 5 产生 5xx 故障的高频 URL]")
        for p, count in path_error_counter.most_common(5):
            print(f"  {p:<35} -> {count:>4} 次错误")
    print("=" * 50)

    # 若服务端错误率超过 1.0%,返回非零退出码以触发上层告警
    if error_rate > 1.0:
        print(f"[预警] 5xx 错误率过高 ({error_rate:.2f}% > 1.0%)!", file=sys.stderr)
        return False
    return True

if __name__ == "__main__":
    log_file = "/var/log/nginx/access.log"
    success = analyze_access_log(log_file)
    sys.exit(0 if success else 1)
四、备份与日志巡检的闭环协同架构
在实际生产中,孤立的定时任务往往容易变成“黑盒运行”——备份失败了无人知晓,直到需要恢复数据时才发现半年前就停止了备份。因此,优秀的自动化设计必须建立状态汇总与故障外送的闭环。
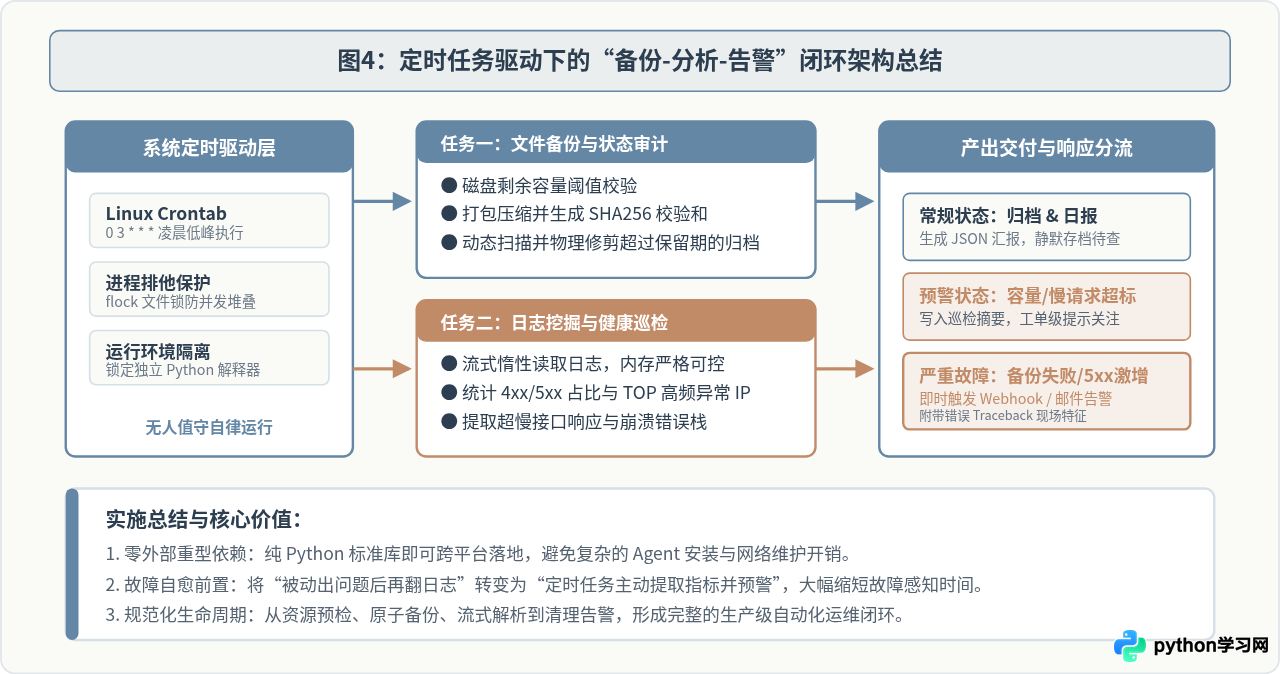
1. 轻量化告警触发策略
为了将告警降噪,我们可以将定时任务的结果分为三个梯级:
| 状态等级 | 触发场景 | 处置逻辑 |
|---|---|---|
| 正常(NORMAL) | 备份成功且校验哈希一致;日志 5xx 错误率低于阈值。 | 将统计概要写入本地日志文件,无需打扰运维人员。 |
| 注意(WARNING) | 磁盘剩余空间低于 20%;出现单个未知爬虫高频扫探。 | 追加记录到每日简报中,在日间例会或定时邮件中呈现。 |
| 致命(CRITICAL) | 磁盘写满致备份中断;校验码不匹配;5xx 比例急剧攀升。 | 通过 Python urllib.request 直接向运维人员的企业群 Webhook 发送高优先级报警。 |
2. 免三方库的 Webhook 发送封装
当捕获到致命异常时,直接利用标准库发送轻量 JSON Webhook,即可完成即时提醒:
# -*- coding: utf-8 -*-
import json
import urllib.request

def send_alert_webhook(webhook_url, message_text):
    """使用 Python 原生 urllib 发送 Webhook 报警卡片"""
    payload = {
        "msg_type": "text",
        "content": {
            "text": f"【系统运维预警】\n{message_text}"
        }
    }
    data_bytes = json.dumps(payload).encode('utf-8')
    req = urllib.request.Request(
        webhook_url,
        data=data_bytes,
        headers={'Content-Type': 'application/json'}
    )
    try:
        with urllib.request.urlopen(req, timeout=10) as response:
            return response.status == 200
    except Exception as e:
        print(f"告警推送失败: {e}", file=sys.stderr)
        return False
五、常见问题排查与日常运维规范
在长期部署 Python 定时任务的过程中,以下三个问题最为常见,建议在上线之初即落实规范:
- 问题 1:Crontab 日志提示 Permission denied
排查原因:系统 cron 服务运行的属主与目标目录权限不匹配。例如,非 root 用户的 cron 尝试向/var/log或/data/backups写入。
规避方法:确保目标备份目录的所属组与运行用户一致,或在特权 cron (sudo crontab -e) 中明确限定文件所属权限。 - 问题 2:日志时间戳与系统时间偏差导致过滤遗漏
排查原因:Web 服务器(如 Nginx、Apache)默认记录的时间戳格式可能采用 UTC 时区或特殊的本地格式(如01/Nov/2026:18:00:00 +0800)。如果使用简单的字符串匹配切片,会导致按日期筛选时偏差 8 小时。
规避方法:尽量使用标准正规解析,或者只分析经logrotate按天轮转切分后的已完成归档(如access.log-20261101)。 - 问题 3:备份压缩时间过长拖慢线上业务 IO
排查原因:直接在业务高并发时段全速读写磁盘压缩。
规避方法:在 cron 中通过nice -n 19和ionice -c 3调低 Python 进程的 CPU 和磁盘调度优先级,让系统在闲暇空档执行压缩,优先保证前端响应。
结合 Python 原生强大的标准库与操作系统的轻量级守护机制,开发者无需引入复杂的运维监控套件,就能搭建起一套高可用、抗重试、低资源开销的数据备份与日志分析防护网。关键在于把握好资源预检、原子替换、流式解析与状态告警四个核心环节,让每一次备份都可信、每一项异常都受控。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















