


Python代码规范:何时使用行尾注释、独立注释或Docstring
深入解析Python代码中行尾注释、独立块级注释与Docstring的核心区别、解释器运行时机制、PEP规范用法与适用场景,通过真实重构示例助你写出干净专业的Python代码。
一、核心认知:Docstring、独立注释与行尾注释的本质区别
在Python语法中,虽然文档字符串(Docstring)与普通的井号(#)注释都可以用来记录人类可读的文字,但它们在Python解释器底层生命周期、AST抽象语法树生成以及生态工具链支持上存在着本质差异。
普通的井号注释(包括独立注释与行尾注释)属于纯粹的源码级注记。当Python的词法解析器(Tokenizer)扫描源代码时,所有以 # 开头的内容都会被当场丢弃。它们既不会进入AST节点,也不会被编译到 .pyc 字节码文件中,在生产环境运行时不占用任何内存。
与此相对,Docstring是语法层面的第一类公民。根据 PEP 257 规范,紧随模块、类、函数或方法定义语句之后的第一条未赋值字符串字面量会被Python编译器识别为该对象的文档字符串,并自动绑定到该对象的 __doc__ 属性上。这意味着Docstring在程序运行时是完全可读的,能够被内置的 help() 函数查看,并被集成开发环境(IDE)与 Sphinx、MkDocs 等自动化文档生成器解析提取。
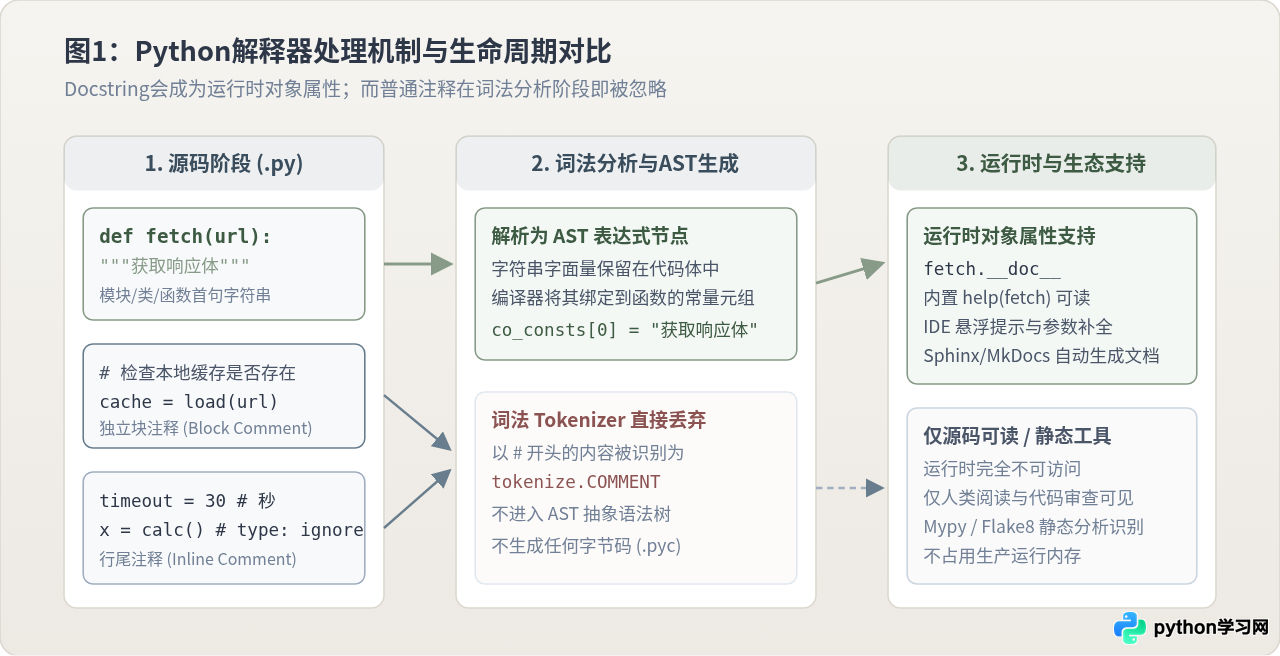
图1:Python解释器对Docstring与普通注释的处理路径及运行时可见性差异
| 比较维度 | 文档字符串 (Docstring) | 独立注释 (Block Comment) | 行尾注释 (Inline Comment) |
|---|---|---|---|
| 语法形式 | """...""" 三引号字符串 |
代码上方单独成行的 # ... |
代码同行的 code # ... |
| 运行时可见 | 是(存放在 obj.__doc__) |
否(编译前已被丢弃) | 否(编译前已被丢弃) |
| 主要服务对象 | 模块/函数使用者、API调用方、IDE | 阅读/修改该文件具体算法的开发者 | 快速扫视该行细节的维护者、Linter |
| 关注的核心问题 | “是什么、怎么调用、有什么结果” | “为什么这样做、逻辑思路是什么” | “这个常量代表什么、静态检查请忽略” |
| PEP 标准依据 | PEP 257 文档字符串规范 | PEP 8 块注释章节 | PEP 8 行内注释章节 |
二、选型决策指南:如何在编码时快速选择?
许多初学者容易走向两个极端:要么通篇不写注释,导致后续维护人员必须通读每一行源码才能推测业务逻辑;要么对每一行普通代码都做机械翻译,产生大量噪音。选型的根本依据在于受辖对象的层级与读者获取信息的目的。
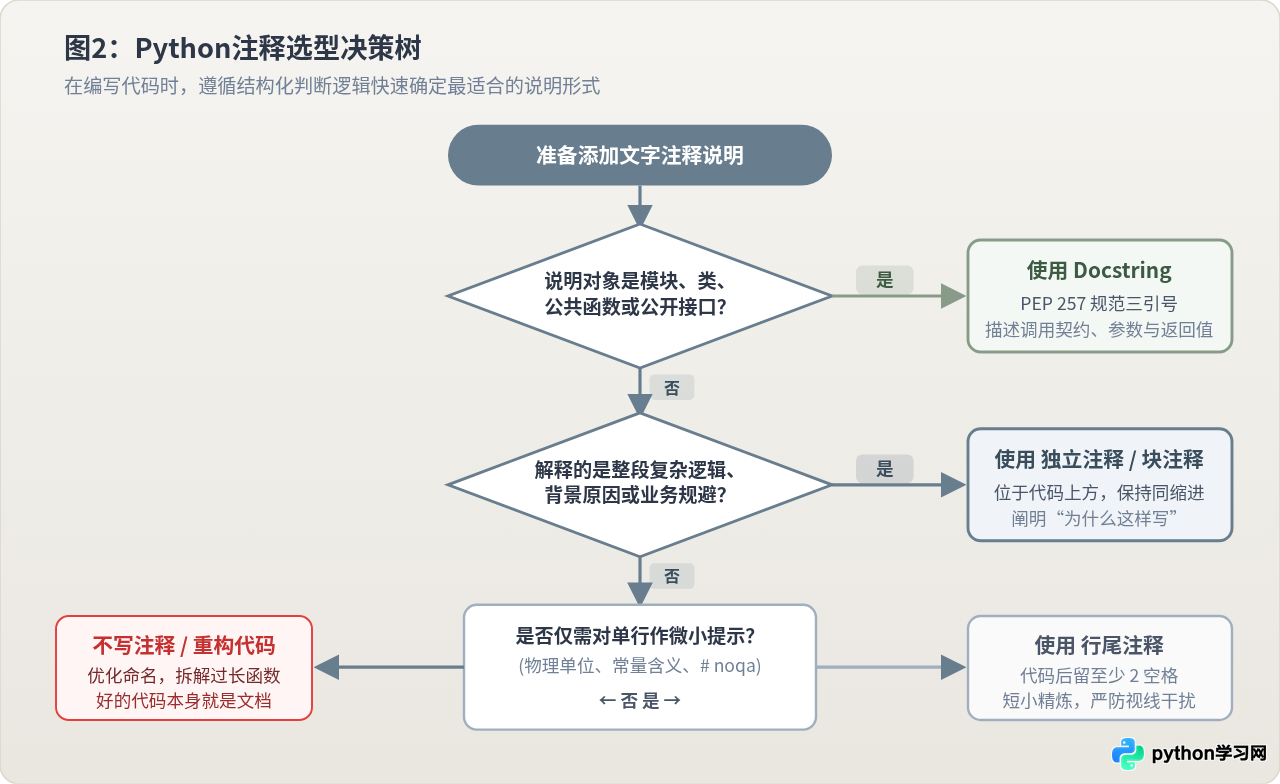
图2:编写代码时的结构化注释选型决策树
在面对一段准备添加的文字说明时,可以按照以下三个判断节点快速决策:
- 第一层筛选(对象层级):如果说明的对象是模块、类、公开方法或公共函数,必须使用 Docstring。因为调用者关心的是接口契约,不应强制他人深入内部看你的实现源码。
- 第二层筛选(信息性质):如果是在函数或分支内部,且需要阐述整段逻辑的算法背景、业务限制、设计权衡或规避第三方Bug的缘由,使用 独立注释(块注释)。
- 第三层筛选(颗粒度):如果仅仅是针对单行代码中的特殊参数做物理意义提示(如单位是毫秒还是字节),或者给静态类型检查工具提供指令(如
# type: ignore),使用极其简练的 行尾注释。 - 终极检验:如果上述三者都不满足,而你只是想写“将列表中元素加1”,请立即删除该注释。此时代码本身已经自解释,添加注释只会增加维护成本与代码不同步的风险。
三、Docstring:何时使用与规范要求
Docstring 是 Python 代码向外部世界展示的窗口。只要一个对象(模块、类、函数)会被本文件外部、当前类外部甚至同一项目中的其他模块调用,就应当为其编写规范的 Docstring。
1. 必须编写 Docstring 的场景
- 所有公共模块(Module):位于文件最顶部,概括本模块所提供的职责、核心类与配置入口。
- 所有导出的类(Class):描述类的抽象职责、公共属性以及生命周期注意事项。
- 所有公共函数与方法(Function / Method):详细声明参数类型、业务含义、返回值格式以及可能引发的特化异常。
2. 规范的书写格式(以 Google 风格为例)
根据 PEP 257 规范,单行 Docstring 应当以三引号包裹,且闭合引号与起始引号处于同一行,首字母大写,末尾加句号。多行 Docstring 则在第一行写出简明的动词祈使句概要,空出一行后,再展开详细说明:
def calculate_tier_discount(price: float, user_level: int) -> float:
    """计算指定用户等级下的折后结算总价。

    根据系统会员策略,高级别用户享有梯度折扣比例,
    当价格低于基础运费成本阈值时,自动保底为基础成本价。

    Args:
        price: 订单原始总金额,单位为元,必须大于等于0。
        user_level: 会员等级,取值范围为 1 至 5。

    Returns:
        折扣后的最终应付金额,保留两位浮点数。

    Raises:
        ValueError: 当 price 为负数或 user_level 超出有效范围时抛出。
    """
    if price < 0 or not (1 <= user_level <= 5):
        raise ValueError("输入参数超出业务范围")
    # 具体业务计算逻辑...
    return round(price * (1 - user_level * 0.05), 2)
__doc__ 属性上,还会使编译器生成无意义的常数字面量表达式,极大地干扰代码的视觉流。
四、独立注释(块注释):解释逻辑意图与“为什么”
独立注释(Block Comment)通常应用于代码段落之前。它占据整行,以 # 加上一个半角空格开头,并与紧随其后的代码保持完全相同的缩进级别。
1. 独立注释的核心应用场景
独立注释的最高法则是:不要重复解释代码“做了什么”,而要解释“为什么这样做”。代码本身展示了执行步骤,但无法表达背后的历史原因、权衡取舍与外部依赖限制。
- 阐述非常规算法选择:例如为什么弃用常规的字典查找而改用二分搜索,背后的内存或吞吐量考量是什么。
- 记录业务陷阱与兼容补丁:针对下游第三方接口特定版本偶发异常(如特定HTTP 409状态码)所做的重试逻辑。
- 长函数内的逻辑段落分界:如果由于历史原因函数暂未拆分,使用独立注释作为“章节标题”,提示接下来这一段代码的意图。
2. 好的注释 vs 坏的注释对比
# ----------------- 错误做法:机械复述语法 -----------------
# 判断 user_status 是否等于 'ACTIVE'
if user_status == 'ACTIVE':
    # 循环遍历 items 列表中的每个 item
    for item in items:
        # 将 item 追加到 result
        result.append(item)

# ----------------- 正确做法:解释背景与意图 -----------------
# 针对活跃用户保留全量试用特权;
# 历史遗留原因:旧版网关在批量结算时要求即使未支付也必须保留占位符,
# 否则在后续流水线对账中会触发跨节点校验超时。
if user_status == 'ACTIVE':
    result.extend(items)
五、行尾注释:极简补充与特殊标记
行尾注释(Inline Comment)是指与可执行代码位于同一行的注释。由于它直接紧跟在代码右侧,如果使用不当,会严重破坏代码的右侧边界,导致屏幕横向滚动并分散读者的注意力。
1. PEP 8 对行尾注释的严格排版约束
- 间距规定:行尾注释的前面必须保留至少两个空格与代码主体隔开。
- 符号规范:井号
#后面必须跟上一个半角空格,随后书写简短说明。 - 长度控制:加上行尾注释后的整行总长度应严格控制在代码规范宽度以内(通常为79或88字符),绝对不能为了加注释导致整行折行。
2. 适宜使用行尾注释的典型场景
# 场景 1:标注特殊常量的物理单位或业务基准
CACHE_EXPIRATION = 86400  # 秒 (24小时)
BUFFER_CAPACITY = 1048576  # 字节 (1MB)

# 场景 2:给静态类型检查器或代码审查工具提供特定抑制指令
parsed_data = json.loads(payload)  # type: ignore[arg-type]

# 场景 3:正则表达式分组的业务意图标记
PATTERN = r"^([a-z0-9_\.-]+)@([\da-z\.-]+)\.([a-z\.](2, 6))$"  # 依次匹配: 用户名, 域名, 后缀
六、实战演练:业务函数注释重构全过程
为了直观展现如何将上述规范应用于实际工程代码,我们以一个典型的“支付网关订单同步函数”为例,展示从混乱杂糅到整洁规范的四步重构过程。
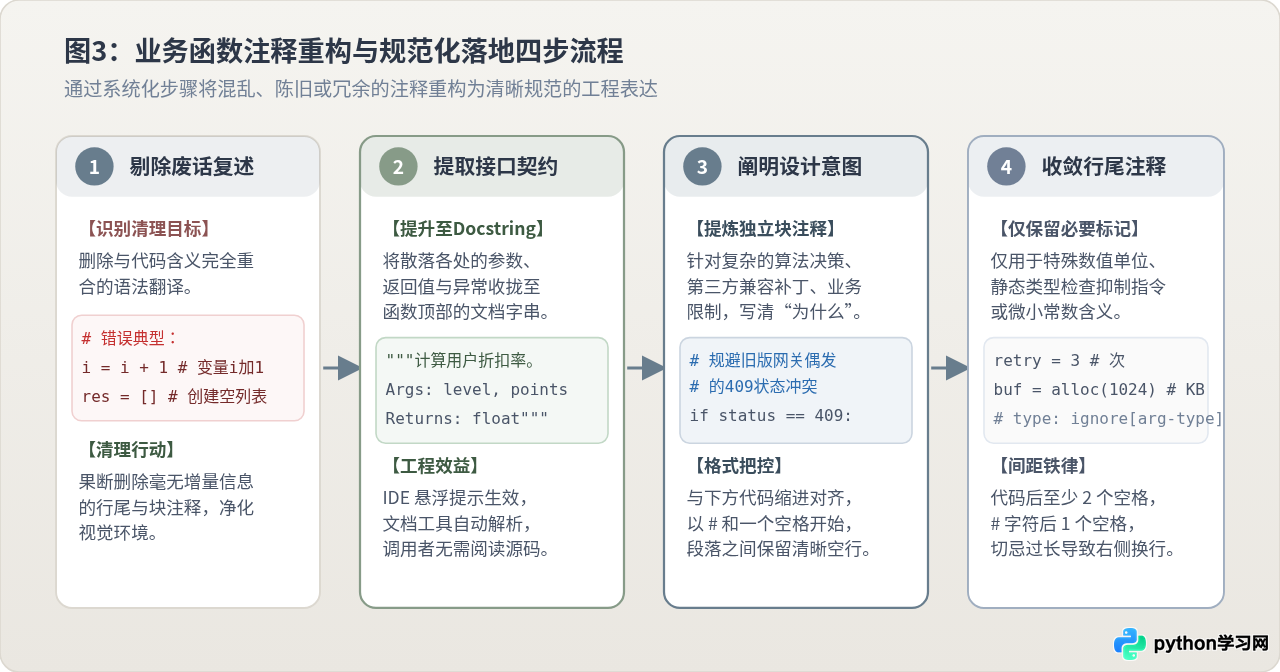
图3:业务函数注释规范化重构的四步推进流程
1. 重构前的问题代码
以下代码真实反映了项目中常见的注释乱象:顶层缺乏统一契约,内部到处充斥着自以为详细却毫无价值的语法复述,关键常数未标明单位,且在局部变量下方违规使用多行Docstring。
# 这是一个支付同步函数
def sync_payment(order_id, retry=3): # 重试次数
    """同步支付状态"""
    # 初始化 status 变量为 None
    status = None
    """
    这个变量用于临时存储从第三方网关拉取的原始报文,
    必须在解析完成后立即释放内存。
    """
    raw_response = fetch_remote(order_id) # 获取数据
    if raw_response.code == 200: # 如果状态码是200
        # 解析数据
        status = raw_response.json()['status']
    else:
        # 重试
        sleep(500) # 等待
        status = 'RETRY'
    return status # 返回状态
2. 按照四步法实施重构
- 第一步(清理废话):删除
# 初始化 status 变量、# 如果状态码是200、# 返回状态等纯属语法翻译的噪声。 - 第二步(提升契约):将原本只写了六个字的Docstring扩充为符合规范的多行Docstring,交代完整的参数含义、返回值类型与网络异常。
- 第三步(建立意图注释):将内部误用的三引号局部变量注释移除;在
else异常等待处,用独立注释讲清楚休眠重试的业务动机。 - 第四步(收敛行尾):将
sleep(500)行尾的模糊注释规范为带物理单位的准确提示,并确保间距符合规范。
3. 重构后的优雅代码
def sync_payment(order_id: str, retry_count: int = 3) -> str:
    """从第三方支付网关拉取最新交易凭证并同步本地订单状态。

    本方法通过主动轮询网关接口确认最终账单,主要解决用户跳转后
    异步回调(Webhook)偶发丢包导致本地状态长时间挂起的问题。

    Args:
        order_id: 系统唯一订单编号,格式如 'ORD_20261101_XXXX'。
        retry_count: 最大失败轮询次数,默认重试3次。

    Returns:
        最终订单交易状态,可能为 'SUCCESS'、'FAILED' 或 'RETRY'。

    Raises:
        GatewayTimeoutError: 当网关连接连续超时且耗尽重试次数时抛出。
    """
    raw_response = fetch_remote(order_id)
    if raw_response.code == 200:
        return raw_response.json().get('status', 'FAILED')

    # 网关存在防刷限流机制,429 或 500 响应后需指数退避,
    # 避免短时间内并发击穿支付渠道边界。
    sleep(0.5)  # 秒,防抖冷却间隔

    return 'RETRY'
七、规范速查与反模式矩阵
为了便于日常编码和代码评审(Code Review),下表整理了三类说明方式的核心指标、必须遵守的格式细节与坚决避免的反模式。
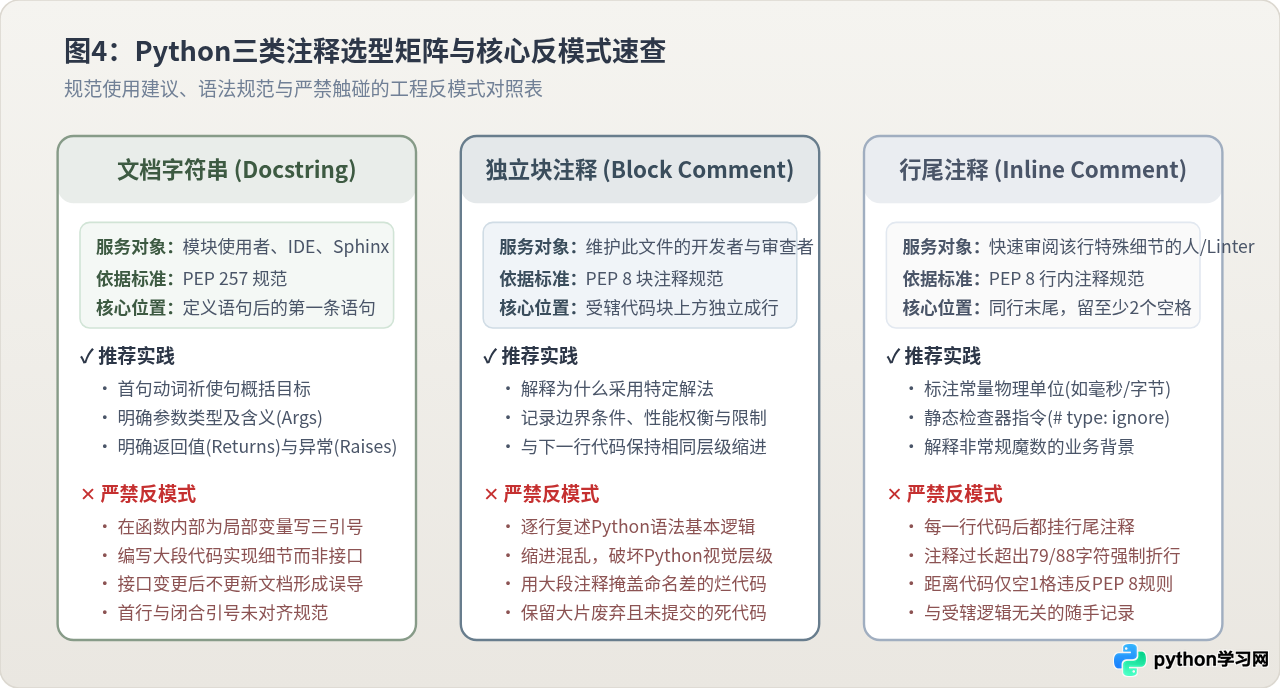
图4:三类注释选型矩阵与核心反模式对照总结
对外公开看 Docstring,函数入参返回值;
逻辑复杂靠 独行,解释缘由为什么;
极简提示置 行尾,两格空格标单位;
代码能把意思表,删去废话最高明。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















