


Python三重引号字符串中的换行保留与去除技巧
深入解析Python三重引号多行字符串的换行机制,详细讲解首尾换行消除、缩进对齐保留,以及将多行源码平滑转换为单行文本的实用技巧与技术选型。
''')或三重双引号(""")常用于书写跨越多行的字面量字符串。它的默认机制会完整保留源代码中的每一个回车换行符和行首缩进空格。但在实际开发中,例如编写 SQL 语句、多行提示词(Prompt)或 HTML 模板时,开发者往往需要精细调整换行行为:既有保留内部排版但剔除首尾空行与公共缩进的需求,也有源码多行排版但运行期合并为单行的需要。本文将系统拆解这些处理场景的具体方法与最佳实践。
一、三重引号字符串的换行机制与默认行为
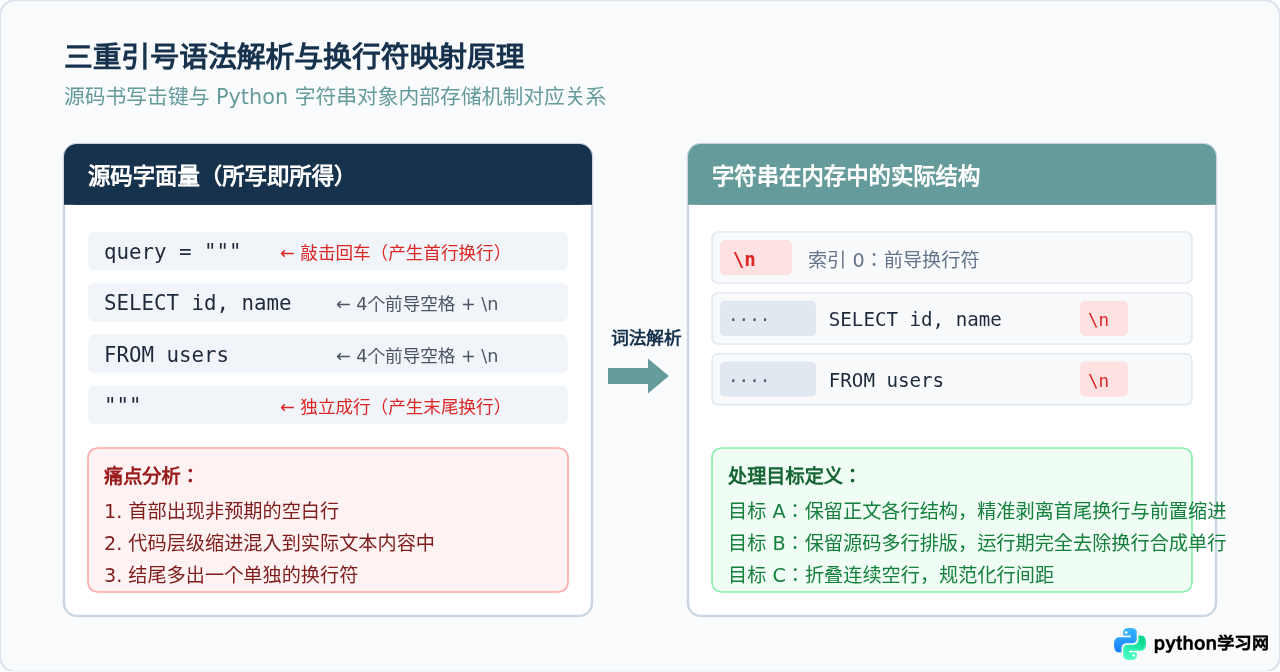
Python 解释器在解析多行字符串字面量时遵循所见即所得的规则。当你在键盘上敲击回车换行时,词法分析器会将该换行动作直接转换为换行符 \n(在 Windows 源码保存为 CRLF 时转换为 \r\n,但 Python 会统一规范化为 \n),并忠实地计入字符串对象的长度。
最常见的混淆来自于开头与末尾的隐形换行。为了代码美观,开发者往往在三引号右侧直接换行,并在最后一行内容结束后换行放置闭合三引号。这种写法会在字符串的最前方和最后方各自引入一个多余的换行符。
# 示例:容易产生意外首尾换行的写法
text = """
SELECT id, name, role
FROM users
WHERE status = 'active'
"""

# 查看实际内存表示
print(repr(text))
# 输出中可以看到首尾均有独立的 '\n',且每行带有函数体缩进'\nSELECT id, name, role\nFROM users\nWHERE status = \'active\'\n'
除此之外,若三引号字符串写在函数、类或缩进代码块内部,为了遵循 PEP 8 缩进规范,多行文本的前缀通常会带有 4 个或更多的空格。这些空格同样会被完整计入字符串内容,导致生成文本包含非预期的多余前缀空格。
二、保留多行结构:首尾换行与缩进的规范消除
当我们需要输出具有多行层次的文本(如 SQL 查询、Markdown 内容、配置文件模板)时,必须保留正文中间的逻辑换行,同时去除首尾的多余空行以及用于代码对齐的无效前导缩进。
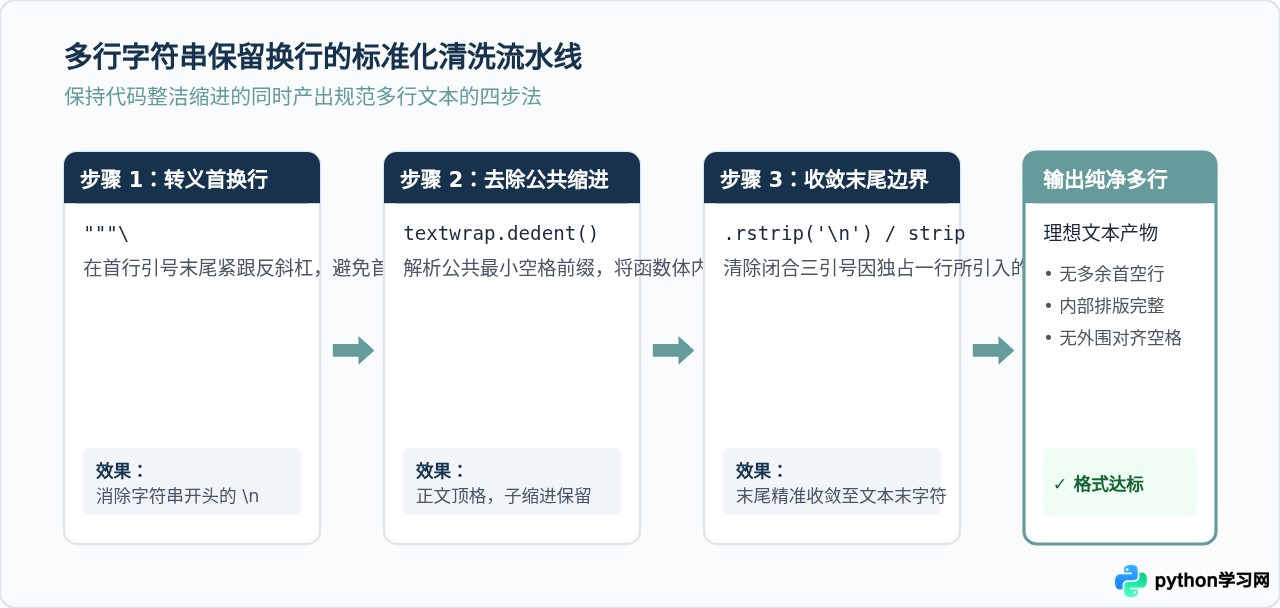
技巧 1:行首转义反斜杠 \ 消除首部换行
在起始三引号后立即输入一个反斜杠 \,可以让解释器在词法分析阶段忽略紧随其后的回车换行符。这样既能保证正文从新的一行开始书写,又不会在文本开头产生空白行。
# 在第一行使用反斜杠转义换行
text = """\
第一行文字(前面没有任何多余换行符)
第二行文字
第三行文字"""

print(repr(text))
# 此时首部直接以“第一行文字”开始'第一行文字(前面没有任何多余换行符)\n第二行文字\n第三行文字'
技巧 2:标准库 textwrap.dedent() 剔除公共缩进
如果多行字符串写在函数内部,行首通常会缩进 4 个或 8 个空格。手动让三引号内的文字顶格书写会破坏整体代码的缩进美感。Python 标准库自带的 textwrap.dedent() 可以智能查找所有非空行的公共前缀空格,并将其统一去除,同时完整保留行与行之间的换行结构。
import textwrap

def generate_sql():
    # 结合首行反斜杠与标准库 dedent
    query = textwrap.dedent("""\
        SELECT
            user_id,
            username,
            email
        FROM accounts
        WHERE is_active = 1
    """).strip()
    return query

sql = generate_sql()
print(sql)SELECT
user_id,
username,
email
FROM accounts
WHERE is_active = 1
技巧 3:使用 strip() 与 strip('\n') 进行边界收敛
str.strip() 默认会移除字符串开头和结尾的所有空白字符(包括空格、制表符 \t 和换行符 \n)。如果需要更严格地仅去除换行符,而不触动首尾可能特意保留的空格,可以显式传入参数 strip('\n')、lstrip('\n') 或 rstrip('\n')。
三、消除换行:将多行源码平滑转换为单行文本
在另一些场景下,我们需要书写一段很长的单行字符串(例如超长正则表达式、单行日志格式、大模型单行系统提示词或长 URL 查询参数)。为了遵守代码行宽限制(如 PEP 8 建议的 79 或 88 字符限制),源码必须分行书写,但实际运行产物必须是连续的单行。
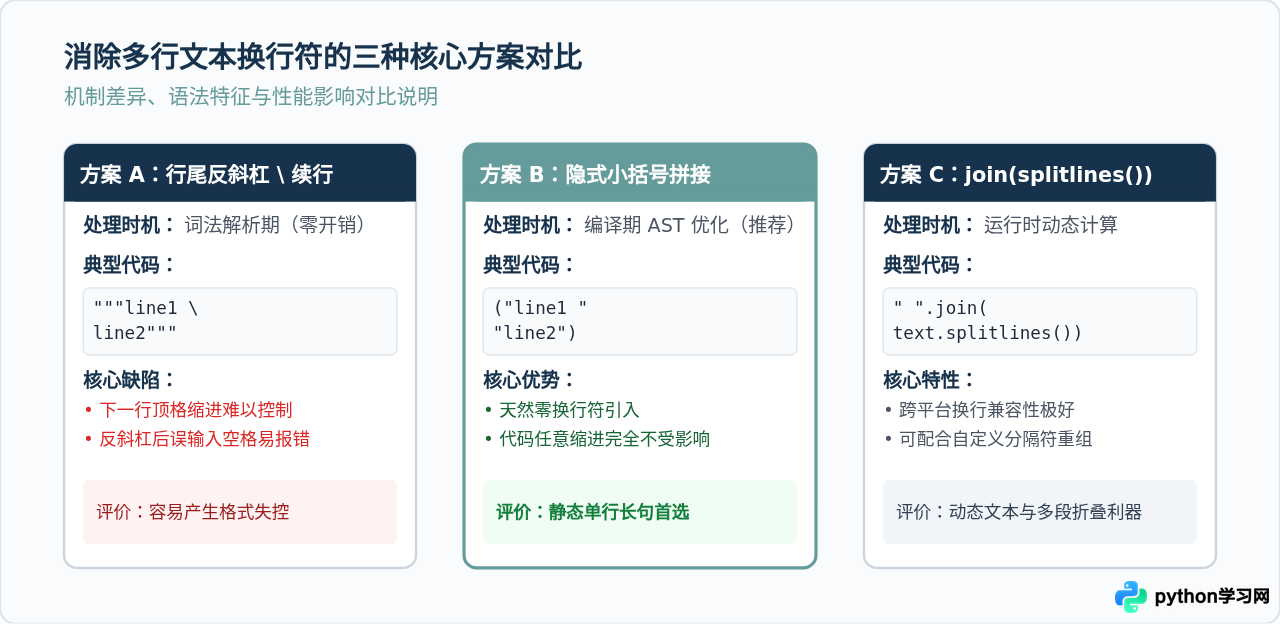
方法 1:行尾反斜杠 \ 物理续行
在多行字符串的每一行行末添加反斜杠 \,可以通知 Python 忽略物理换行。但需要特别注意:反斜杠会消除换行符,但不会消除下一行的行首缩进空格。
# 源码使用反斜杠消除行尾换行
log_message = """\
这是第一段内容,\
继续接在第一段之后,没有任何换行,\
最终合并为一段连续文字。\
"""

print(log_message)方法 2:隐式括号字面量拼接(替代三引号的最佳方案)
当目标是产出单行字符串时,使用小括号包裹多个普通字符串字面量通常比使用三引号更加清晰。Python 解释器会在编译阶段自动将括号内相邻的字符串字面量合并为单个字符串,完全不产生换行符,也不会受代码缩进空格的干扰。
# 推荐:使用隐式括号拼接替代三引号生产长单行
api_url = (
    "https://api.example.com/v2/analytics"
    "?report_type=daily"
    "&start_date=2026-01-01"
    "&end_date=2026-01-31"
    "&format=json"
)

print(api_url)
# 产物完全在一行,源码既易读又不受换行符影响https://api.example.com/v2/analytics?report_type=daily&start_date=2026-01-01&end_date=2026-01-31&format=json
方法 3:运行期动态去除换行:replace() 与 splitlines()
如果多行字符串是动态读取或三引号内混合了复杂的段落排版,可以在运行时通过字符串内置方法处理换行:
text.replace('\n', ' '):将所有换行符直接替换为空格,适合单词间需要空格隔开的自然语言文本。text.replace('\n', ''):将换行符完全剔除,适合连贯代码或无间隙字符串。" ".join(text.splitlines()):最稳健的自然语言折叠方案。splitlines()会同时处理\n、\r\n和\r,且配合split()还能自动压缩连续多余的空白字符。
四、常见应用场景与综合处理代码
场景 A:SQL 查询语句编写
编写 SQL 时,既希望在源码中换行缩进以便审查,又希望在日志输出或执行引擎中去除冗余的多余缩进与换行,以便格式紧凑且避免意外的多余空行。
import textwrap

def get_active_orders(user_id: int) -> str:
    # 结合反斜杠首行转义与 dedent,保留 SQL 子句结构
    sql = textwrap.dedent(f"""\
        SELECT
            o.order_id,
            o.amount,
            o.create_time
        FROM orders o
        JOIN users u ON o.user_id = u.id
        WHERE o.user_id = {user_id}
          AND o.status = 'COMPLETED'
        ORDER BY o.create_time DESC
    """).strip()
    return sql
场景 B:大语言模型(LLM)Prompt 结构化组装
编写 Prompt 时,通常包含角色设定、多条指令与输出规范。如果直接写普通单行字符串,编辑起来极其困难;如果使用未清洗的三引号,缩进空格与首尾空行会消耗宝贵的 Token 额度。
import textwrap

def build_system_prompt(role: str, constraints: list[str]) -> str:
    formatted_constraints = "\n".join(f"- {c}" for c in constraints)

    prompt = textwrap.dedent(f"""\
        你是一名专业的{role}。请严格遵循以下规则处理用户请求:
        {formatted_constraints}

        请直接给出最终结论,无需冗余寒暄。
    """).strip()

    return prompt
场景 C:保留空行段落,但折叠单行断行
在 Markdown 或长文本排版中,经常需要“双换行代表段落,单换行仅是源码折行”的效果。我们可以通过简单的字符串分段处理达成这一目标:
def normalize_paragraphs(text: str) -> str:
    """保留段落之间的空行,但将单段落内的断行折叠为单行"""
    paragraphs = text.split("\n\n")
    cleaned_paragraphs = [
        " ".join(line.strip() for line in p.splitlines() if line.strip())
        for p in paragraphs
    ]
    return "\n\n".join(cleaned_paragraphs)

raw_doc = """\
这是第一个段落的第一句,
这是同一个段落的第二句。

这是第二个段落的第一句,
这是第二个段落的第二句。
"""

clean_doc = normalize_paragraphs(raw_doc)
print(clean_doc)这是第一个段落的第一句, 这是同一个段落的第二句。
这是第二个段落的第一句, 这是第二个段落的第二句。
五、技巧总结与方法选择决策
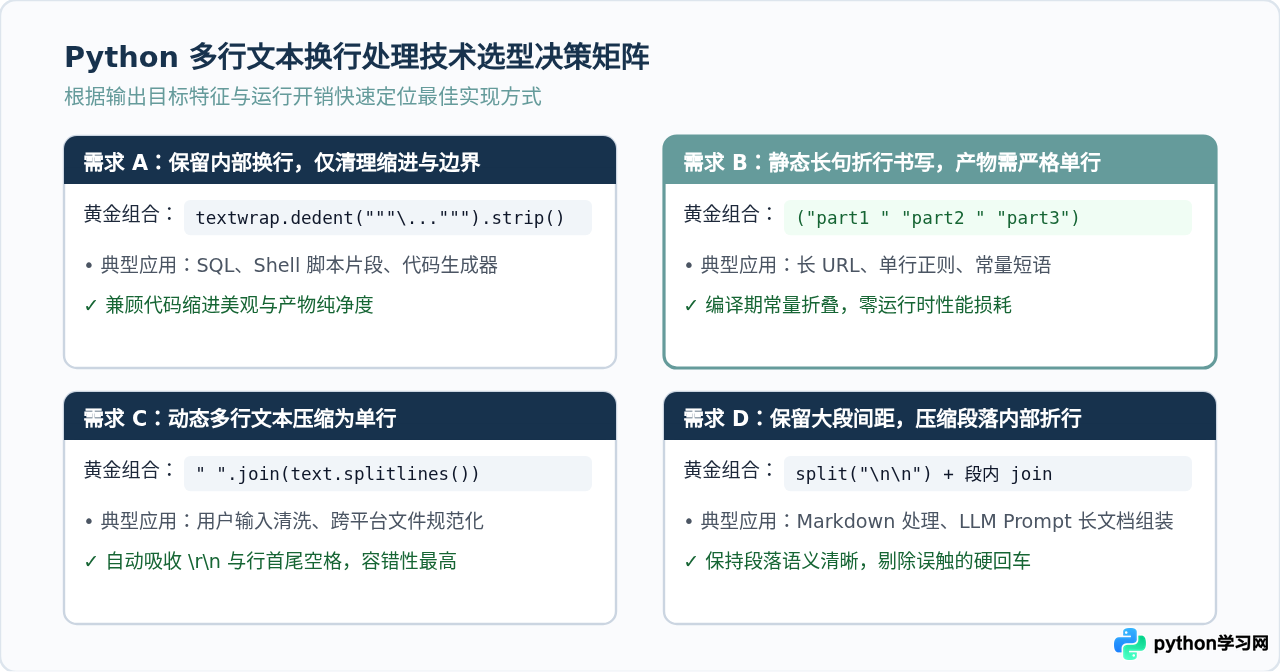
处理 Python 三重引号字符串中的换行与空白,核心在于区分排版需求与产物形态。下表汇总了不同目标下的推荐手段及适用边界:
| 目标需求 | 推荐方法 | 执行阶段 | 核心优点与适用场景 |
|---|---|---|---|
| 保留多行结构,仅去首尾换行 | 首行加 \ + str.rstrip('\n') |
词法解析 + 运行期 | 最简单的多行排版,适用于无需去缩进的小脚本 |
| 保留多行结构,去除代码缩进 | textwrap.dedent("""\...""").strip() |
运行期(标准库) | 最规范做法,适用于 SQL、HTML 模板、多行命令 |
| 源码折行,最终产物为单行 | 小括号隐式字面量拼接 ("a" "b") |
编译期(零运行开销) | 单行首选,长 URL、连续参数、单行日志格式 |
| 动态消除换行并压缩空格 | " ".join(text.splitlines()) |
运行期 | 跨平台适应性最强,自动处理 \r\n 与多余空格 |
| 段落结构保留,句内折行消除 | 先按 \n\n 分段,段内 splitlines 合并 |
运行期自定义函数 | Markdown、富文本解析与自然语言文章排版 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















