


Python字符串常用方法详解:split、replace与strip的使用技巧
深入解析Python字符串核心方法split、replace与strip的使用技巧。全面梳理参数规则、底层工作原理、边界陷阱与数据清洗流水线实践。
在 Python 的日常编程、文件解析以及数据清洗任务中,文本处理占据了极高比重。字符串作为 Python 中的不可变序列类型,其内建方法众多,而 split()、replace() 和 strip() 无疑是最基础、最高频的三项核心能力。理解这三个方法的参数语义、底层运行机制以及边界细节,不仅能够大幅提升代码书写效率,还能有效规避因空白字符、计数限制及字符集误判引发的隐蔽缺陷。本文将分别对这三项方法进行深度剖析,并结合组合流水线演示工程实战应用。
一、split():字符串切分与结构化展开
split() 方法用于依照指定分隔符将字符串拆分为子串列表。其函数原型为 str.split(sep=None, maxsplit=-1)。参数看似简单,但在 sep 的默认设置与显式传参之间,存在截然不同的分割逻辑。
1. 默认空白切分与显式分隔符的差异
当 sep=None(即缺省状态)时,Python 将连续的任意空白字符(包括空格、制表符 \t、换行符 \n、回车符 \r 等)视作一个单一的分隔符。不仅如此,字符串开头和末尾的所有空白都会在切分前被自动剥离,因此结果列表中不会包含空字符串 ""。
反之,若显式传入具体字符,如 sep=" "(单空格),Python 就会严格执行定点匹配,不会合并相邻分隔符。两个相邻的分隔符之间将被切出长度为 0 的空字符串,且首尾的分隔符也会在结果中生成空字符串项。
# 示例代码:sep=None 与 sep=' ' 的行为对比
text = "  Python   3.12 \t \n release   "

# 1. 默认参数:自动折叠连续空白并去除首尾空项
res_default = text.split()
print("默认行为:", res_default)
# 示例输出: 默认行为: ['Python', '3.12', 'release']

# 2. 显式指定单空格:严格按字符切分,保留空字符串
res_space = text.split(" ")
print("显式单空格:", res_space)
# 示例输出: 显式单空格: ['', '', 'Python', '', '', '3.12', '\t', '\n', 'release', '', '', '']
2. 利用 maxsplit 参数控制切分次数
maxsplit 规定了切分操作执行的最大次数。默认值为 -1,表示全量切分。当设定为正整数 N 时,切分器在完成 N 次切割后立即终止扫描,剩余的整个未切分文本将作为列表中最后一个元素完整保留。这一特性在解析“键值对”或特定格式的协议报文时极为高效。
# 示例代码:利用 maxsplit 解析键值文本
log_entry = "2026-10-28 05:45:23 [INFO] User login failed: connection timed out"

# 仅切分前 3 次,保留后续完整的消息体
fields = log_entry.split(" ", 3)
print("切分结果:", fields)
# 示例输出: 切分结果: ['2026-10-28', '05:45:23', '[INFO]', 'User login failed: connection timed out']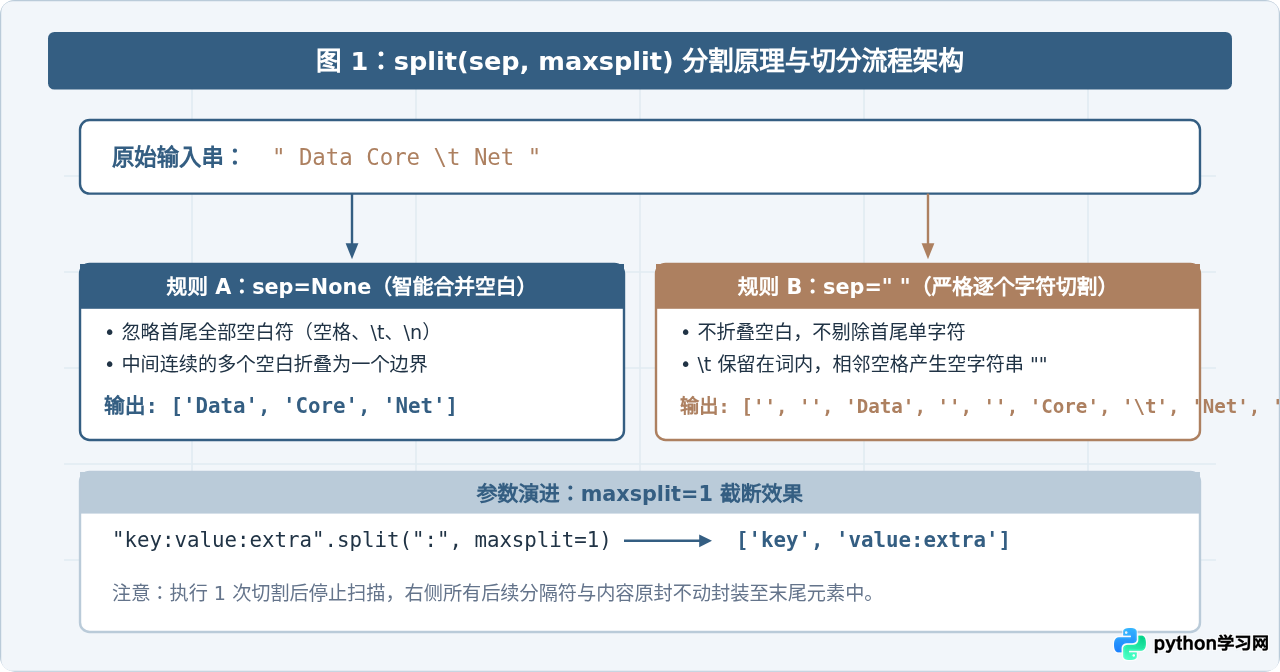
二、replace():模式查找与字符串替换
replace() 方法返回一个新字符串,其中所有的原旧子串被指定的新子串所替换。函数原型为 str.replace(old, new, count=-1)。
1. 字符串的不可变性与替换机制
在 Python 中,字符串是不可变(Immutable)对象。调用 s.replace("a", "b") 绝不会在原有内存地址上修改 s,而是重新申请内存空间构造并返回一个新的字符串对象。如果未将返回值赋给变量或接收,替换结果将被丢弃。
# 示例代码:字符串不可变性
raw_text = "prod-server-01"
raw_text.replace("prod", "test")
print("原变量值:", raw_text)
# 示例输出: 原变量值: prod-server-01 (未发生任何改变)

new_text = raw_text.replace("prod", "test")
print("新变量值:", new_text)
# 示例输出: 新变量值: test-server-01
2. 精准控制替换频率:count 参数
count 参数用于限制执行替换的最大次数。默认值为 -1,意味着全量替换文本中出现的每一个匹配项。若设定具体数值,Python 将从左至右扫描,一旦完成指定次数的替换便停止遍历,保持剩余文本不变。
# 示例代码:限次替换
path_str = "root/module/submodule/controller/action"

# 仅替换前 2 个斜杠为连字符
partial_rep = path_str.replace("/", "-", 2)
print("限次替换:", partial_rep)
# 示例输出: 限次替换: root-module-submodule/controller/action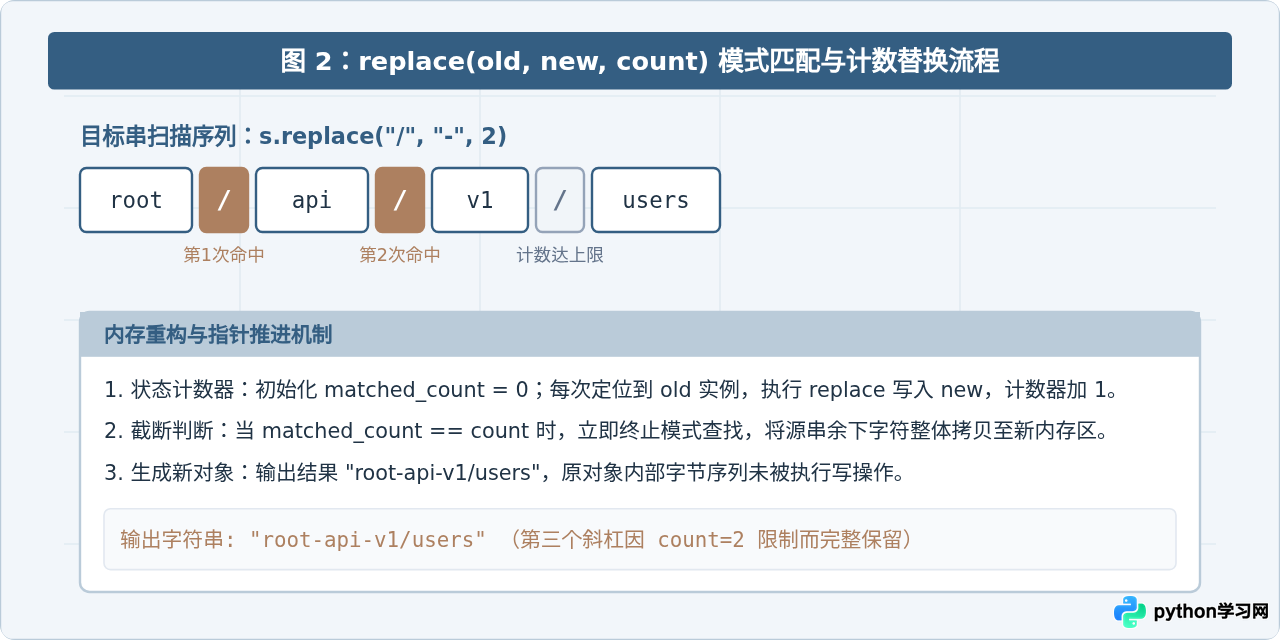
三、strip():两端剥离与字符集匹配细节
strip() 系列方法用于去除字符串边界处的指定内容,包括双向修剪的 strip()、仅左侧修剪的 lstrip() 以及仅右侧修剪的 rstrip()。函数原型为 str.strip([chars])。
1. 核心误区:chars 是“字符集合”而非“前后缀子串”
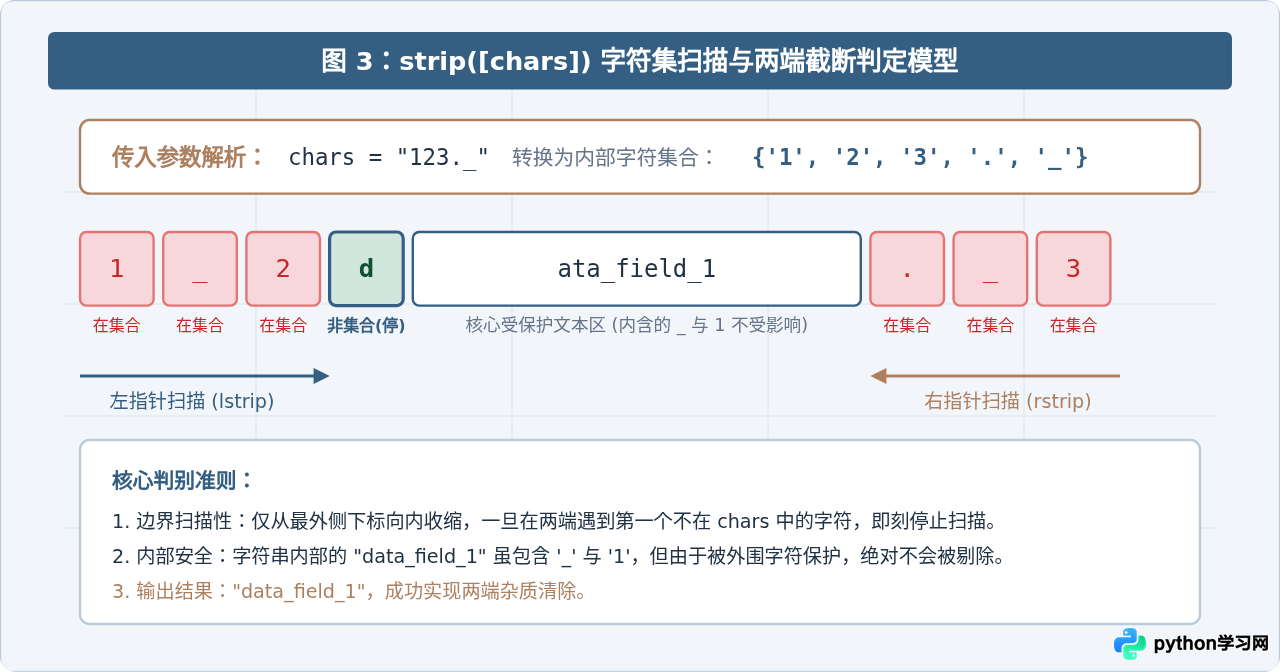
这是 Python 初学者乃至有经验开发者最常踩入的误区之一:chars 参数传入的不是一个按顺序匹配的完整单词或子串,而是一个无序的字符集合(Character Set)。
当执行 s.strip(chars) 时,Python 会从字符串两端开始逐个检查字符。只要当前字符包含在 chars 中,该字符就会被剔除;一旦遇到第一个不在 chars 集合内的字符,扫描立即停止,即便后续还含有 chars 中的字符也不会再做处理。
# 示例代码:strip 的字符集剥离行为
domain = "www.python.org"

# 错误直觉:希望去除前缀 "www."
res_err = domain.strip("www.")
print("strip('www.'):", res_err)
# 示例输出: strip('www.'): python.org (表面看起来正确)

# 边界测试:尝试去除网址末尾 ".com"
url = "https://example.com"
res_url = url.strip(".com")
print("strip('.com'):", res_url)
# 示例输出: strip('.com'): https://example
# 解析:字符集为 {'.', 'c', 'o', 'm'},由于 'e' 不在集合内,右侧扫描在 'e' 停止,看起来去除了 ".com"

# 典型陷阱:若目标串末尾含有集合内字符
filename = "main.py.mp3"
# 试图剔除末尾后缀 ".mp3"
clean_name = filename.rstrip(".mp3")
print("rstrip('.mp3'):", clean_name)
# 示例输出: rstrip('.mp3'): main
# 陷阱剖析:集合包含 '.', 'm', 'p', '3'。在剥离完 ".mp3" 后,遇到了原词中的 '.py',
# 由于 'y' 不在集合内,但在前一步中 '3'、'p'、'.' 均在集合中,导致连同 '.py' 的一部分或关联字符也被剥除!str.removeprefix(prefix) 和 str.removesuffix(suffix),它们仅匹配完整的整词子串,不会发生字符集贪婪误删。
四、综合实践:构建健壮的文本清洗流水线
在工程实践中,单一字符串方法很少单独使用。面对脏数据、非结构化配置文件或爬取到的网页文本,最经典的模式是将 strip()、replace() 和 split() 串联为管道(Pipeline)。
1. 清洗流水线的合理执行时序
在设计链式处理流程时,执行顺序至关重要:
- 第一步(边缘去噪):先使用
strip()剥离首尾换行符、无用空格及定界杂质,防止首尾空白干扰后续切分。 - 第二步(规范化归一):使用
replace()将不规则的分隔符(如中文逗号、全角空格、多余制表符)替换为统一的标准符号。 - 第三步(结构化切分):调用
split()将归一化后的文本切分为结构化列表,完成从扁平字符串到内存对象的转换。
# 示例代码:数据清洗管道实践
raw_records = [
  "  #1001, Alice Brown , Engineering ; TeamLead \n",
  "1002, Bob Smith,Marketing; Specialist\r\n",
  "  #1003, Charlie; HR ; Manager \n"
]

cleaned_data = []
for record in raw_records:
    # 步骤 1: 剥离首尾空白符及井号前缀
    step1 = record.strip(" \r\n#")
    # 步骤 2: 归一化分隔符,将分号 ';' 统一为逗号 ','
    step2 = step1.replace(";", ",")
    # 步骤 3: 按照逗号拆分字段,并对每个子字段去除周围空格
    fields = [item.strip() for item in step2.split(",")]
    cleaned_data.append(fields)

for row in cleaned_data:
    print(row)

# 示例输出:
# ['1001', 'Alice Brown', 'Engineering', 'TeamLead']
# ['1002', 'Bob Smith', 'Marketing', 'Specialist']
# ['1003', 'Charlie', 'HR', 'Manager']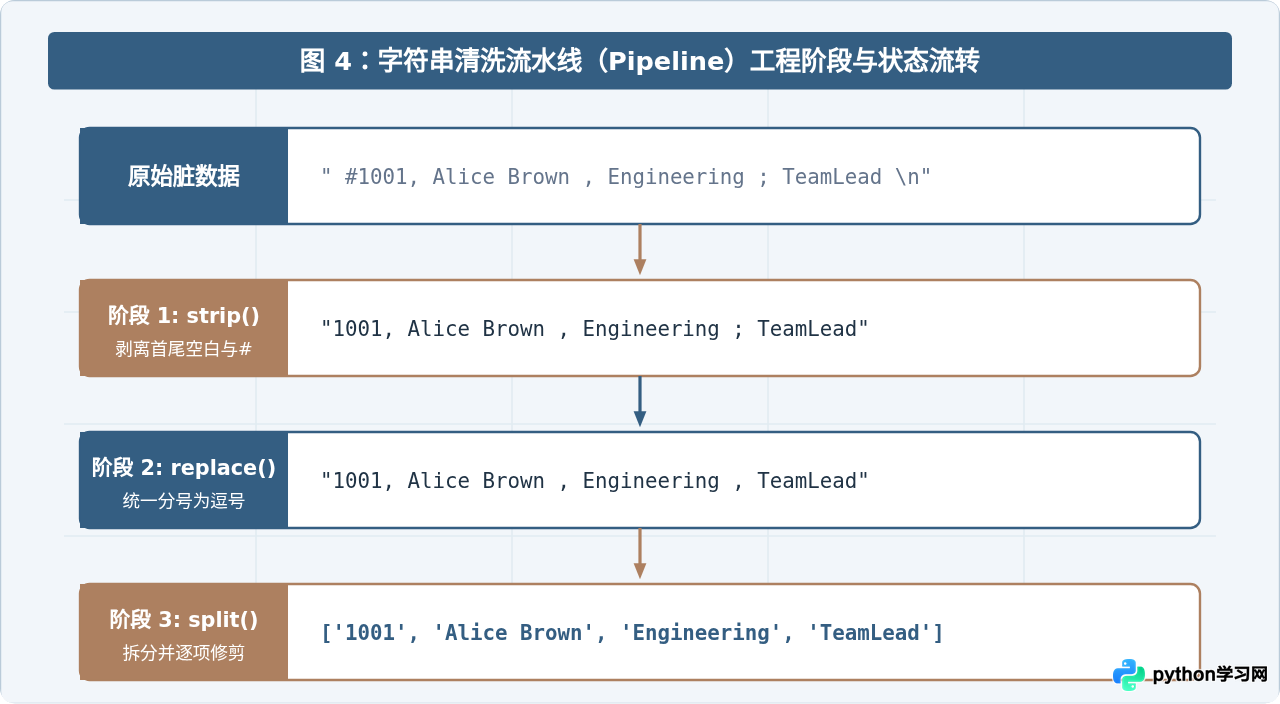
五、三大核心方法对比与总结
为便于在实际开发中准确选型并规避隐患,下表系统归纳了 split、replace 与 strip 的核心参数、关键语义及典型陷阱:
| 方法名称 | 典型语法原型 | 核心作用 | 核心参数说明 | 常见陷阱与注意事项 |
|---|---|---|---|---|
| split() | str.split(sep=None, maxsplit=-1) |
将字符串拆分为子串列表 | sep 为分隔符;maxsplit 限制切分次数 |
sep=None 合并空白;显式 sep=" " 会因连续空格生成空字符串 ""。 |
| replace() | str.replace(old, new, count=-1) |
替换指定文本模式并返回新串 | old 查找目标;new 替换文本;count 限制次数 |
字符串不可变,调用后原对象不变;大小写严格敏感。 |
| strip() | str.strip([chars]) |
去除两端指定的字符集合 | chars 为无序字符集,默认去除所有空白符 |
chars 不是前缀子串,而是无序字符集合;若需精准剔除前缀/后缀请用 removeprefix/removesuffix。 |
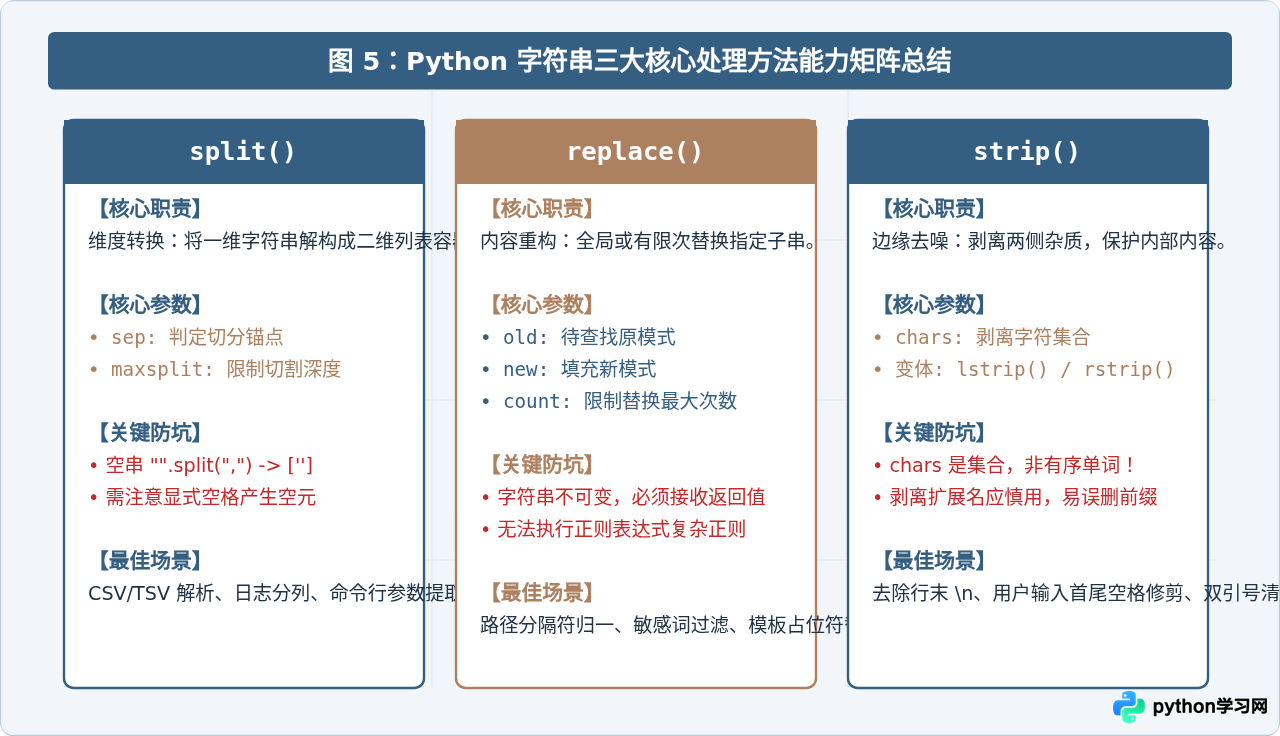
综上所述,split 解决的是“结构拆解与容器转换”,replace 解决的是“模式修正与内容归一”,而 strip 解决的是“边缘降噪与两端清理”。掌握其运行本质并在工程中规范组合使用,能够使 Python 文本处理代码更加简洁、健壮与高效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















