


Python批量处理时:循环内with与循环外with的选择策略
在Python批量处理场景中,深入探讨循环内with与循环外with的生命周期开销、I/O性能、网络连接池复用、异常隔离容错与锁持有差异,并给出清晰的选型决策树与分块优化方案。
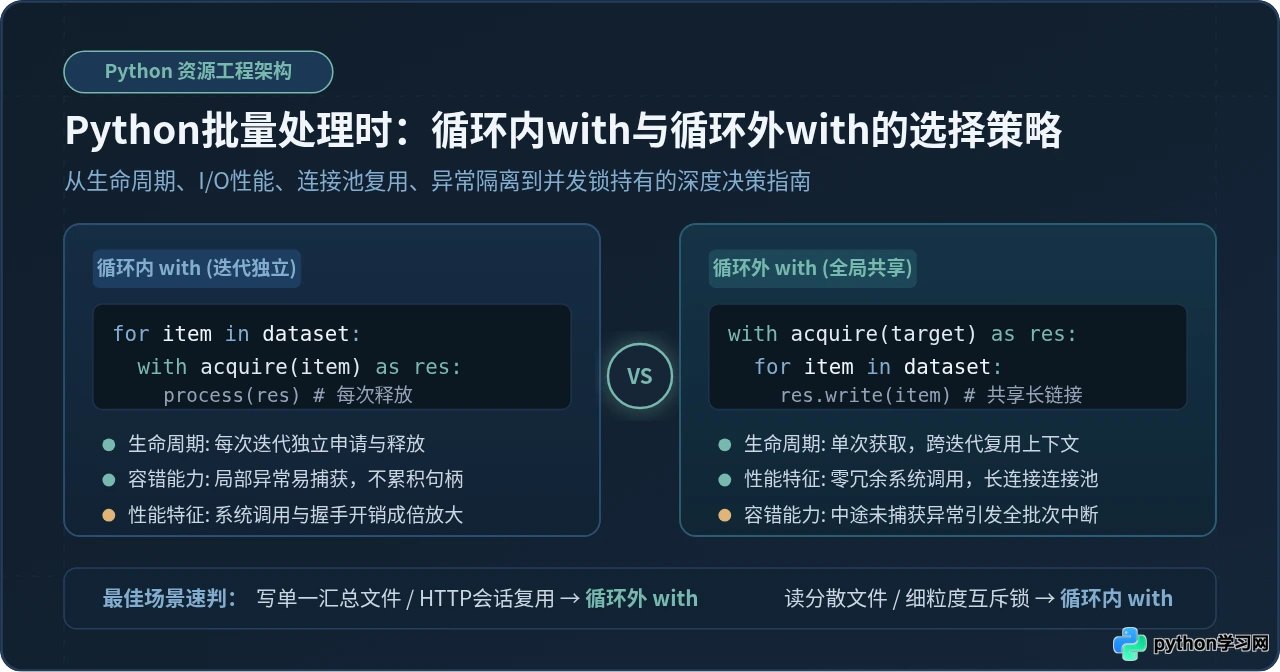
假设你正在编写一个数据清洗脚本,需要将 10,000 条结构化指标计算后追加写入一个汇总日志文件;或者你需要向 500 个微服务接口发起健康检查请求。很多开发者在编写代码时,会随手在 for 循环内部直接套上一层 with open(...) 或 with requests.Session(...)。从语法层面来看,两种写法都能在测试集上顺利跑通并产出相同的结果,但在生产环境的大规模批量处理场景下,它们在内核系统调用、底层网络连接池、异常隔离粒度以及锁持有时间上,存在着质的飞跃与严峻的性能分水岭。
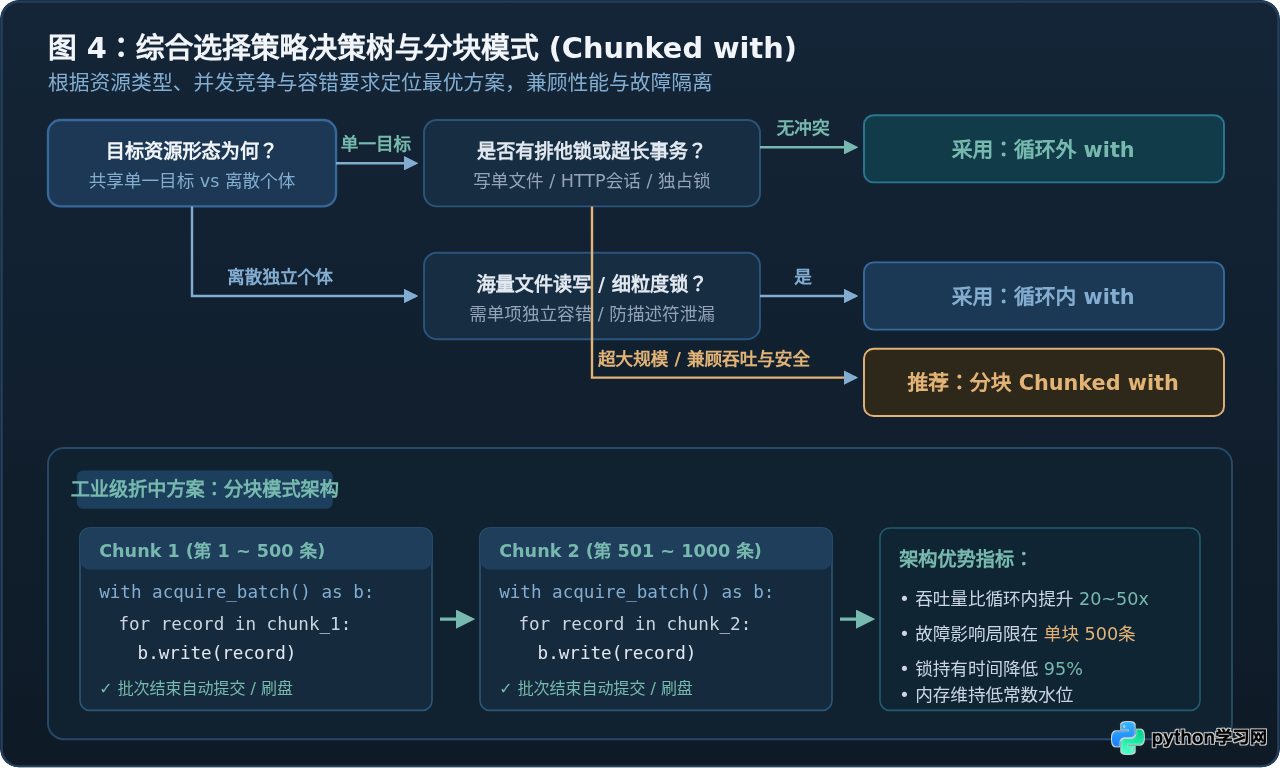
核心的选择依据可以归纳为明确的原则:当批量迭代面向的是同一个共享的全局目标资源时,务必将 with 放置在循环外部,从而复用句柄与连接池,消除数万次无谓的内核系统调用开销;当批量迭代面向的是成千上万个离散独立的个体资源,或者需要精确隔离单条数据的失败时,应当将 with 放置在循环内部,实现用毕即还并防止系统文件描述符溢出;而在数据规模巨大且需要兼顾极速吞吐与故障安全回滚时,应采用分块批处理(Chunked with)作为工业级平衡方案。
一、上下文管理器的底层机制与生命周期开销
要透彻理解两者的性能差异,必须回归 Python 上下文管理器协议(Context Manager Protocol)的运行本质。当代码进入 with 代码块时,解释器会隐式执行目标对象的 __enter__() 方法;而当代码离开 with 作用域(无论正常离开还是因异常跳出)时,解释器均会无条件调用其 __exit__() 方法。
在批量处理场景下,两种结构对应的底层行为频次有着本质差别:
- 循环外 with:全生命周期中仅执行 1 次
__enter__(),内部连续运行 N 次循环迭代,处理完毕后再执行 1 次__exit__()。 - 循环内 with:随着循环向前推进,执行 N 次
__enter__()与 N 次__exit__(),资源被反复申请与注销。
以向同一个本地文件写入 10,000 行清洗结果为例,我们通过具体的代码结构观察差异:
# 模式 A:循环内 with(频繁打开与关闭)
for item in dataset:
    with open("output.log", "a", encoding="utf-8") as f:
        f.write(format_line(item) + "
")

# 模式 B:循环外 with(单次打开,共享句柄)
with open("output.log", "w", encoding="utf-8") as f:
    for item in dataset:
        f.write(format_line(item) + "
")
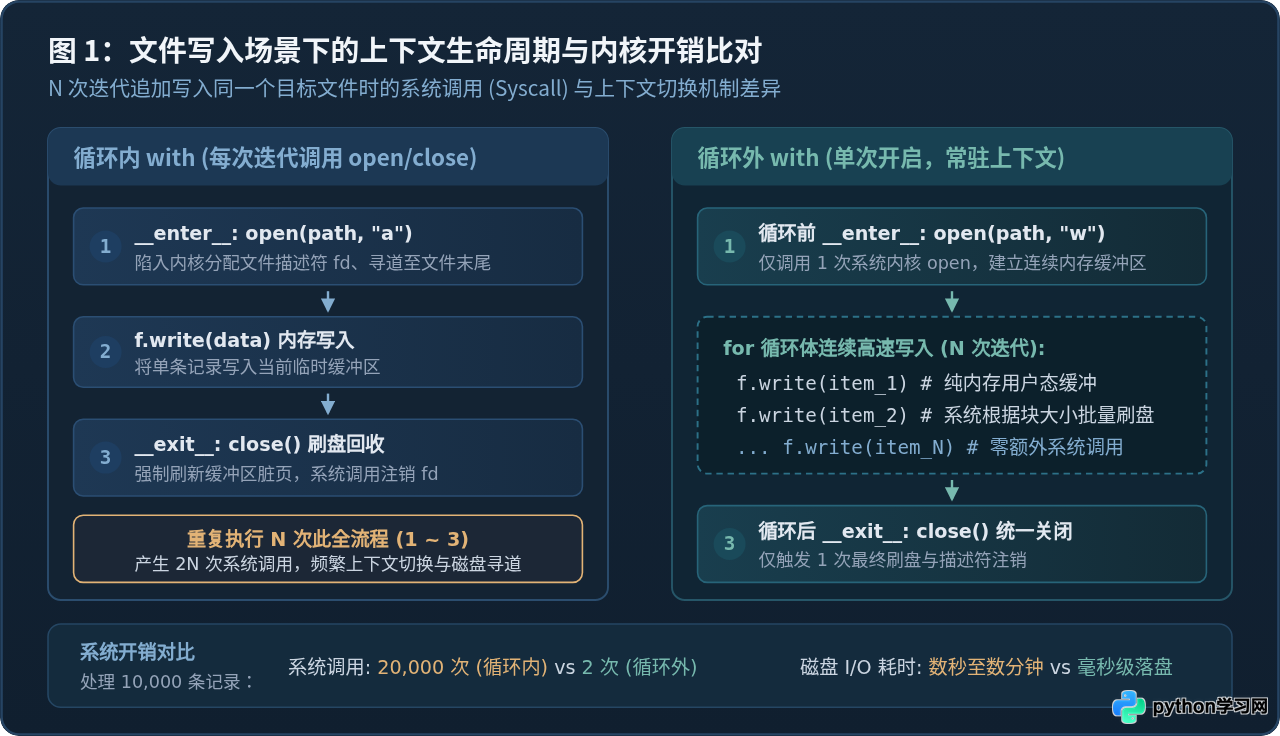
在模式 A 中,每次循环迭代都会导致操作系统执行一次内核态陷入(System Call):内核先分配一个文件描述符(File Descriptor, FD),通过文件系统元数据寻道至磁盘文件末尾,准备缓冲区;写入一行后退出 with,__exit__() 立即调用 close(),触发脏页冲洗并销毁该描述符。迭代 10,000 次意味着产生 20,000 次无意义的 I/O 系统调用与上下文切换,机械硬盘或云盘的寻道开销将直接导致原本毫秒级完成的操作膨胀至数十秒甚至数分钟。
而在模式 B 中,操作系统仅执行 1 次 sys_open,之后 10,000 行数据全部直接写入 Python 进程在用户态维护的流式内存缓冲区。操作系统根据默认的块大小(如 4KB 或 8KB)自动批量将脏页落盘,整个批处理过程只产生极少量的真实物理 I/O,效率相差数倍至上百倍。
二、网络请求与长连接复用:连接池层面的断崖式差距
如果说本地文件 I/O 的频繁打开主要消耗磁盘控制器与系统调用,那么在网络批量爬取或 API 交互场景下,循环内与循环外使用网络会话(如 requests.Session 或 aiohttp.ClientSession)所带来的开销则是网络拓扑层面的灾难。
在 HTTP/1.1 与 HTTP/2 协议中,Session 对象的核心价值在于维护持久连接池(Connection Pool)与 HTTP Keep-Alive 机制。当我们在网络抓取中配置 with 时:
# 模式 A:循环内创建与销毁 Session(错误用法)
for url in target_urls:
    with requests.Session() as session:
        response = session.get(url, timeout=5)
        handle_data(response.json())

# 模式 B:循环外维持长连接 Session(推荐用法)
with requests.Session() as session:
    for url in target_urls:
        response = session.get(url, timeout=5)
        handle_data(response.json())
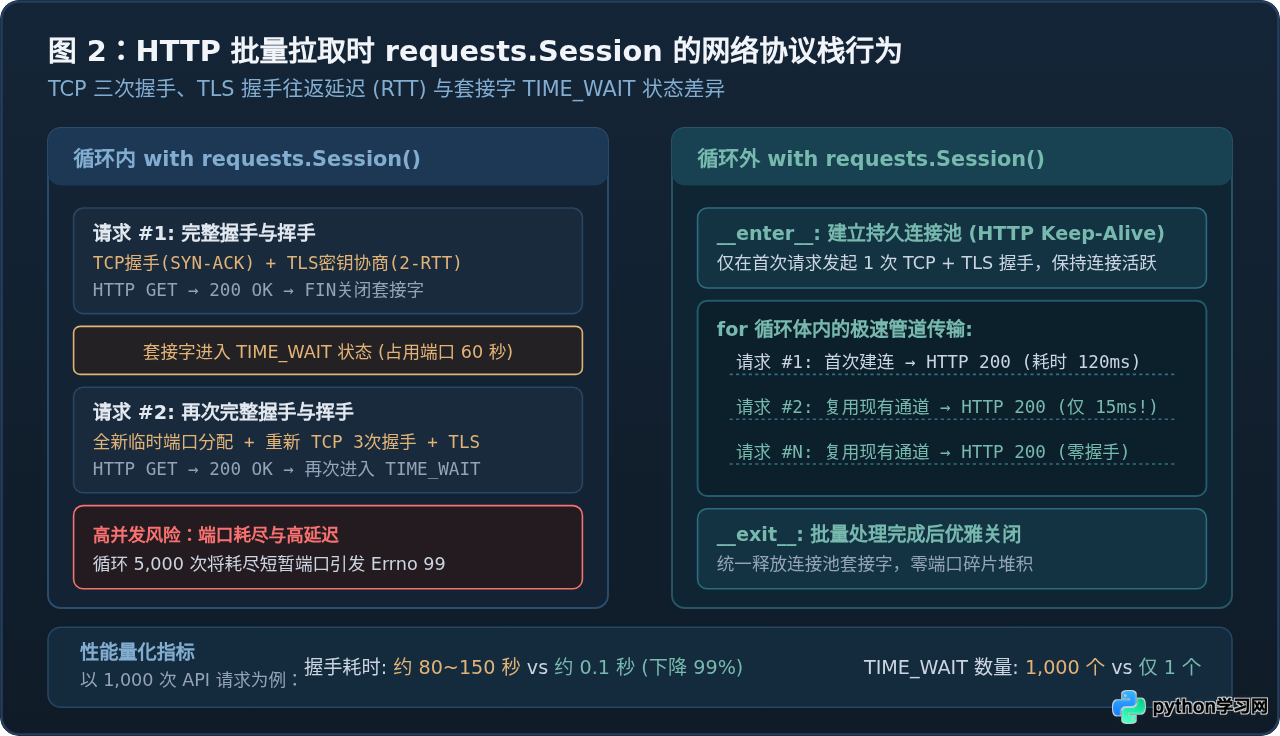
在模式 A 中,每一次循环迭代都要经历以下完整链路:本地操作系统分配短暂端口(Ephemeral Port)→ 发起 TCP 三次握手(SYN、SYN-ACK、ACK)→ 若是 HTTPS 则还要额外进行 1~2 个 RTT 的 TLS/SSL 证书校验与对称密钥协商 → 发送 HTTP GET 请求并接收响应 → 退出 with 执行 TCP 四次挥手(FIN)。此时,本地端口并不会立即释放,而是进入长达 60 秒的 TIME_WAIT 状态。一旦目标 URL 达到数千量级,本地短暂端口将瞬间被耗尽,直接抛出 OSError: [Errno 99] Cannot assign requested address 崩溃。
在模式 B 中,循环外的 with 让底层的 urllib3 连接池在整个任务期间始终驻留内存。除了首次连接需要握手之外,后续所有向同主机发起的请求全部复用现成的 TCP 管道,往返网络延迟从百毫秒级骤降至几毫秒,且全局仅占用一个固定本地套接字,系统资源负载极其健康。
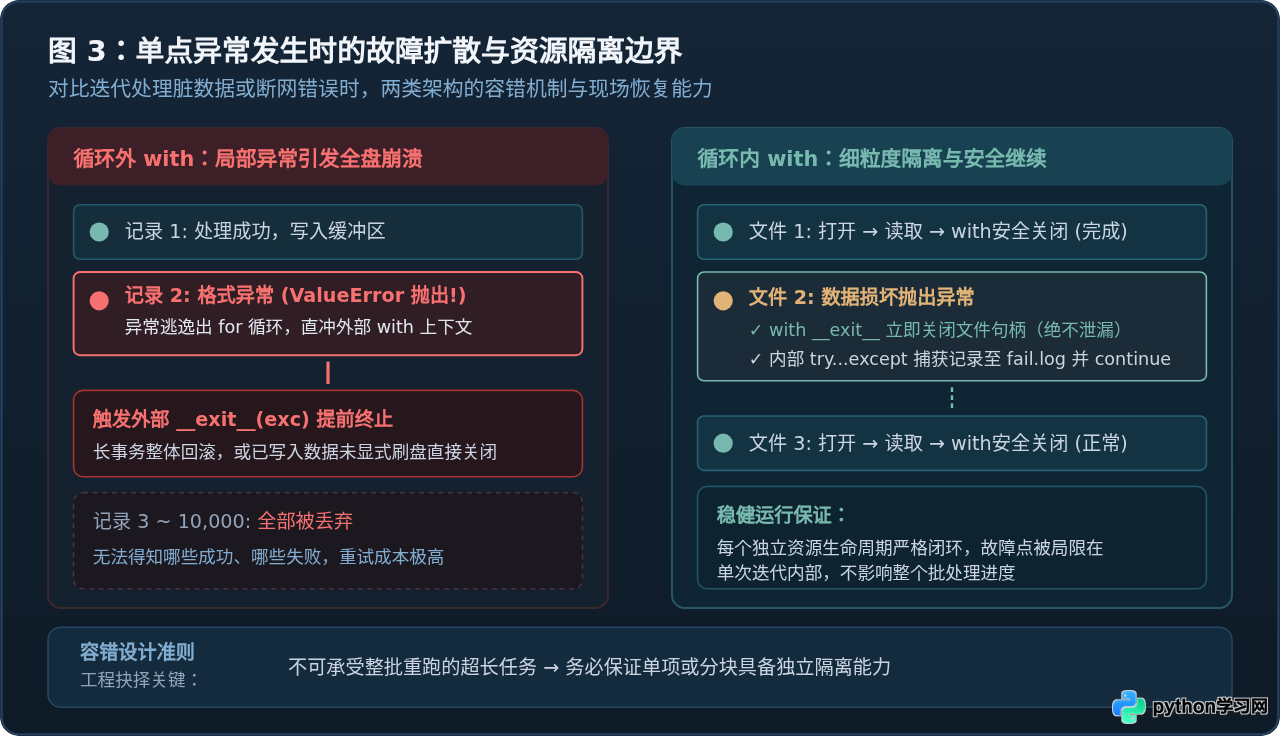
三、异常边界与故障隔离:局部失败与整批崩溃的权衡
既然循环外 with 能够显著提升吞吐性能,为什么我们不能在所有批量处理场景下都无脑采用循环外 with 呢?核心的制约因素就在于异常容错边界与资源隔离粒度。
在真实生产环境中,批量数据往往夹杂着格式畸变、编码异常或脏数据。考虑以下场景:我们需要处理 100,000 个分散在不同目录下的日志文件,读取各文件前 10 行并解析关键指标。
如果将 with 放在循环外部,通常意味着所有子资源由外部单一上下文统筹。但如果是处理分散的独立个体,我们无法在循环外用一个 open 搞定所有不同路径的文件。更严重的是异常扩散问题:在循环外 with 模式下,如果在第 500 个数据处理时抛出了未捕获的 KeyError 或 JSONDecodeError,异常会直接沿着调用栈向上冒泡并逃出 for 循环,进而直接触发外部 __exit__() 关闭整个资源上下文,导致剩余 99,500 个任务彻底终止。
相反,循环内 with 天然提供了一个细粒度的安全沙盒:
# 循环内 with 配套局部 try...except:精确容错
for file_path in file_list:
    try:
        with open(file_path, "r", encoding="utf-8") as f:
            content = f.read()
            process_record(content)
    except (UnicodeDecodeError, FileNotFoundError) as err:
        # 单项异常被就地消化,且由于处于循环内 with,无论是否抛出异常,
        # 该文件的描述符都会在跳出 with 瞬间被 100% 自动关闭,绝无句柄泄漏。
        log_failure(file_path, err)
        continue
除了异常隔离之外,还有一个重要的操作系统限制:系统打开文件数上限(ulimit -n)。如果循环内打开的大量独立句柄没有用 with 强制即时关闭,仅依赖 Python 的垃圾回收(GC)延迟销毁,在高吞吐的并发或异步迭代中,文件描述符极易快速堆积直至耗尽,导致系统拒绝提供任何新的 I/O 服务。
四、并发控制与锁竞争:避免临界区范围被无意放大
在多线程或多进程批量任务中,线程锁(threading.Lock)与分布式互斥锁(如 Redis 分布式锁)同样广泛采用 with 上下文管理器来避免死锁。在涉及并发锁的场景下,with 的位置决定了系统的整体并发吞吐量:
- 循环外 with 持锁:在进入循环前获取锁,直到所有 10,000 条记录全部处理完毕才释放。这将使临界区被强行扩大数万倍。在持锁的数十秒内,其他所有工作线程均处于饥饿挂起状态,程序退化为单线程串行执行,完全丧失并发优势。
- 循环内 with 持锁:只在每次迭代中真正需要同步写共享字典或更新全局计数的纳秒或微秒级区间内获取锁,完成关键步骤立即释放。锁争用时间被压缩至极限,其他并发线程得以高效交替运行。
with transaction.atomic(): 置于包含十万次迭代的循环外部,这不仅会持有数据库行锁甚至表锁过长时间导致并发阻塞,还会导致 Undo Log 膨胀;一旦末尾失败,整批修改全部回滚,此前所有耗时运算付诸东流。
五、工业级折中方案:分块批处理(Chunked with)
面对“循环外 with 吞吐极高但容错较弱、锁持有太久”与“循环内 with 容错安全但系统开销巨大”的经典矛盾,工业界最成熟的解决范式是分块批处理模式(Chunked Context Management)。
分块模式的核心思想是:将全量数据集划分为固定大小的批次(例如每 500 条或 1,000 条为一个 Chunk),在批次外部开启 with,而在批次内部高速迭代写入。完成该批次后立即退出 with 提交事务或刷盘,随后进入下一个批次。
from itertools import islice

def chunked_iterable(iterable, size):
    """通用分块生成器"""
    it = iter(iterable)
    while True:
        chunk = list(islice(it, size))
        if not chunk:
            break
        yield chunk

# 分块批量模式实战:兼顾吞吐量与故障恢复
BATCH_SIZE = 500

for chunk_idx, batch in enumerate(chunked_iterable(records, BATCH_SIZE)):
    try:
        # 在每个分块外部开启 with,内部批量写入
        with db.transaction():
            for record in batch:
                db.execute_insert(record)
        record_checkpoint(chunk_idx * BATCH_SIZE)  # 记录断点检查点
    except Exception as batch_err:
        log_checkpoint_error(chunk_idx, batch_err)
        # 仅该批次的 500 条回滚,前面已完成的数万条不受任何影响
        handle_failed_batch(batch)
分块模式在工程实践中带来了多维收益:第一,将系统调用或数据库交互由 100,000 次锐减至 200 次,吞吐量比纯循环内提升 20~50 倍;第二,将锁持有时间限制在毫秒级批次内,避免长时间独占资源;第三,一旦中途遭遇断网或机器宕机,已提交的批次安全持久化,任务支持从最近检查点无缝重试,故障隔离边界清晰明确。
六、选型速查表与高频避坑指南
根据处理对象的具体技术属性,下表梳理了常见批量任务的推荐策略与判断依据:
| 业务处理场景 | 推荐策略 | 核心选型依据 | 性能/稳定性风险 |
|---|---|---|---|
| 追加写入同一个聚合文件/日志 | 循环外 with | 单目标句柄复用,减少 99.9% 内核系统调用 | 循环内写入会产生巨量磁盘寻道与系统调用 |
| 遍历读取数千个独立小文件 | 循环内 with | 单文件读完即释放,维持低描述符与内存占用 | 未及时关闭会导致 Too many open files |
| 批量抓取相同/相邻域名的 HTTP API | 循环外 with | 持久化复用 TCP 握手与 TLS 凭证,连接池管理 | 循环内新建 Session 会触发端口枯竭 TIME_WAIT |
| 高并发写入互斥共享变量(线程锁) | 循环内 with | 最小化临界区,避免其他并发工作线程长时间饥饿 | 循环外持锁会导致多线程并发退化为纯串行 |
| 海量数据入库(数据库长事务) | 分块 Chunked | 平衡单次提交吞吐与长事务行锁/回滚成本 | 全量大事务易死锁,单条逐个提交则网络延迟爆炸 |
实战开发中的三个高频易错细节
-
循环内打开文件的打开模式误用:在循环内打开同一个目标文件时,如果错误使用了覆盖模式
open(target, "w")而非追加模式"a",每一次循环都会清空文件内容,最终只保留最后一条写入项。虽然循环外使用"w"是安全的,但若因重构将with移入循环内部,必须警惕该缺陷。 -
生成器延时求值与上下文提前销毁:在循环外使用
with打开文件并返回一个包含yield的生成器时,必须确保外部在消费生成器时该with上下文仍处于活跃状态。如果生成器逃逸出with作用域,外部尝试迭代消费时将抛出ValueError: I/O operation on closed file。 -
循环外长时间运行的文件未手动冲洗:当使用循环外
with open(...)持续处理耗时较长的流式任务时,数据全部堆积在 Python 用户态缓冲区内。如果程序突遭不可恢复的异常(如kill -9),未达缓冲区阈值的数据将彻底丢失。针对长周期任务,应在每完成关键阶段后主动调用f.flush()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















