


基于Scrapy框架构建Python结构化数据采集项目的完整步骤
本文详细讲解基于Scrapy框架从零搭建Python结构化数据采集项目的完整流程,涵盖脚手架搭建、数据模型契约、页面解析与递归翻页、管道清洗过滤、调度配置以及格式化导出的全套工程化实践。
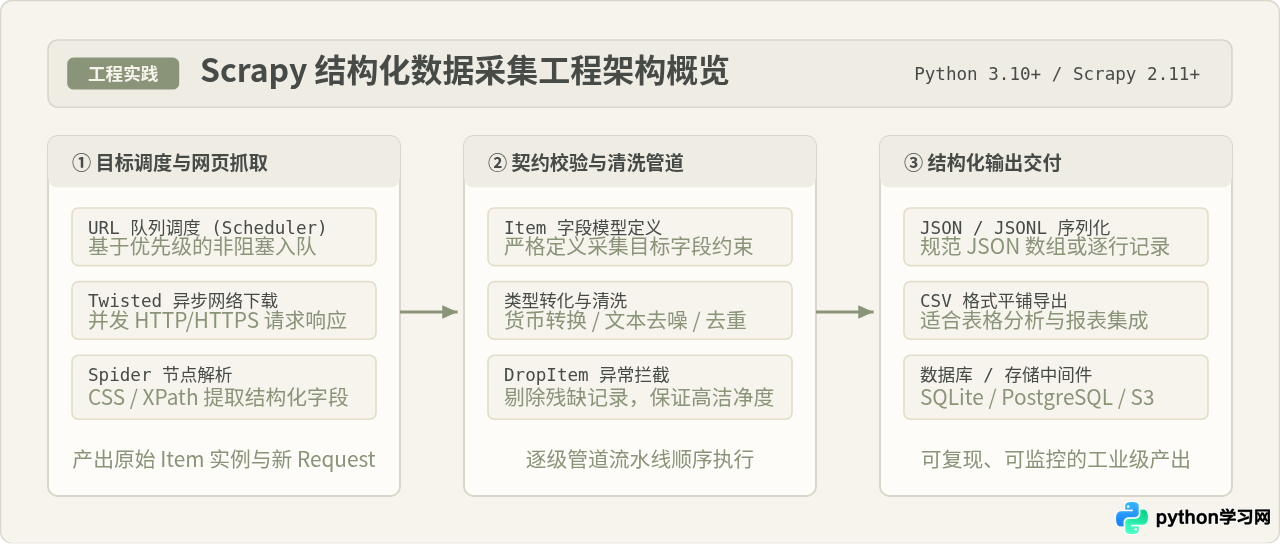
一、准备工作与初始化项目骨架
在正式编写采集代码之前,我们需要创建隔离的 Python 运行环境并安装 Scrapy。Scrapy 是一个应用型框架,直接全局安装容易引发依赖包版本冲突。
1. 环境配置与安装
打开终端,进入你的工作空间目录,执行以下命令创建虚拟环境并安装 Scrapy:
# 创建并激活隔离环境
python3 -m venv venv
source venv/bin/activate  # Windows 环境执行: venv\Scriptsctivate

# 安装 Scrapy 核心库
pip install scrapy
2. 使用 CLI 脚手架生成工程目录
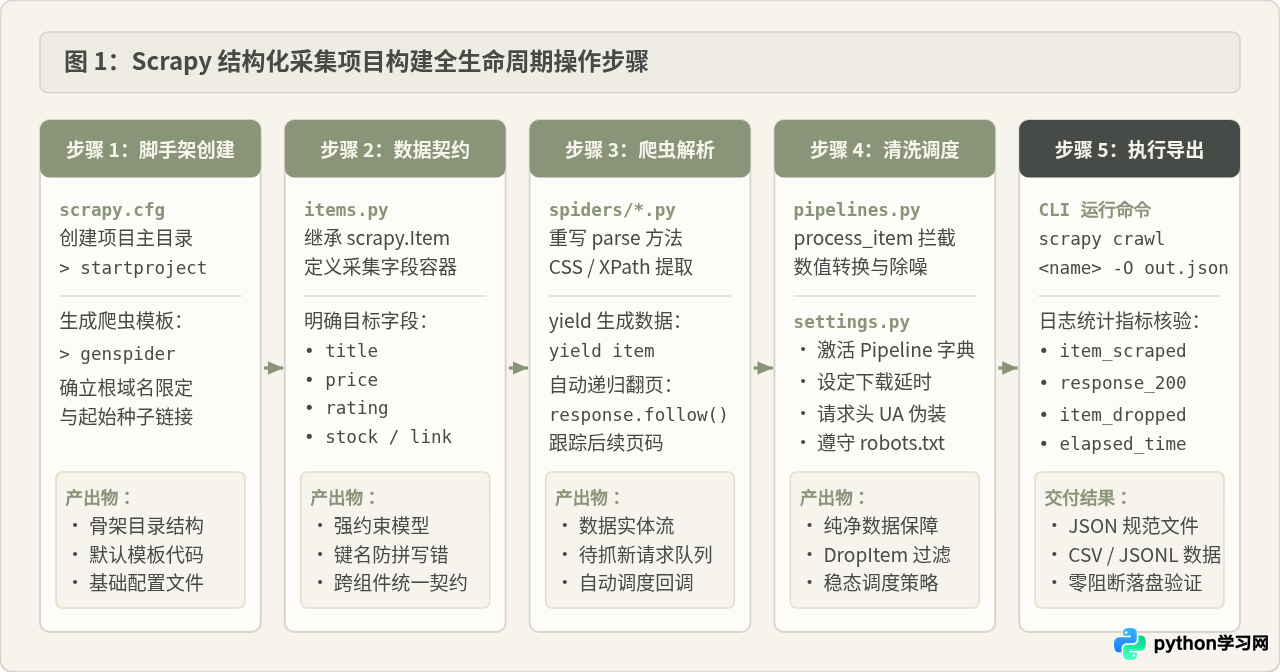
Scrapy 提供了专用的命令行工具用于生成工程脚手架。以采集图书信息项目 book_collector 为例,在终端执行:
scrapy startproject book_collector执行完成后,控制台将输出脚手架创建成功的提示:
此时生成的目录结构如下。理解每个模块的单一职责是编写整洁采集工程的前提:
book_collector/
├── scrapy.cfg            # 项目部署根配置文件,指明 settings 路径
└── book_collector/       # Python 包根目录
    ├── __init__.py
    ├── items.py          # 数据契约文件:定义提取目标的实体类与字段
    ├── middlewares.py    # 中间件文件:处理请求与响应的底层钩子(如代理、UA轮换)
    ├── pipelines.py      # 数据管道:负责字段清洗、格式校验与持久化落盘
    ├── settings.py       # 全局配置:并发数、下载延迟、请求头与激活组件
    └── spiders/          # 爬虫脚本集合目录
        └── __init__.py
3. 生成初始爬虫模板
进入项目根目录,使用 genspider 命令生成针对目标站点的基础爬虫代码。这里以经典的公开练习网站 books.toscrape.com 为例:
cd book_collector
scrapy genspider books toscrape.com
该命令会在 spiders/ 目录下自动创建 books.py,并预设 allowed_domains 和 start_urls。
二、核心机制:Scrapy 内部异步数据流转拓扑
许多初学者常将 Scrapy 与 Requests 混为一谈,误以为它只是“多加了几个解析方法的并发库”。事实上,Scrapy 是基于 Twisted 异步网络反应堆(Reactor) 的事件驱动系统。理解其内部数据流向,对于编写高效且无阻塞的爬虫至关重要。
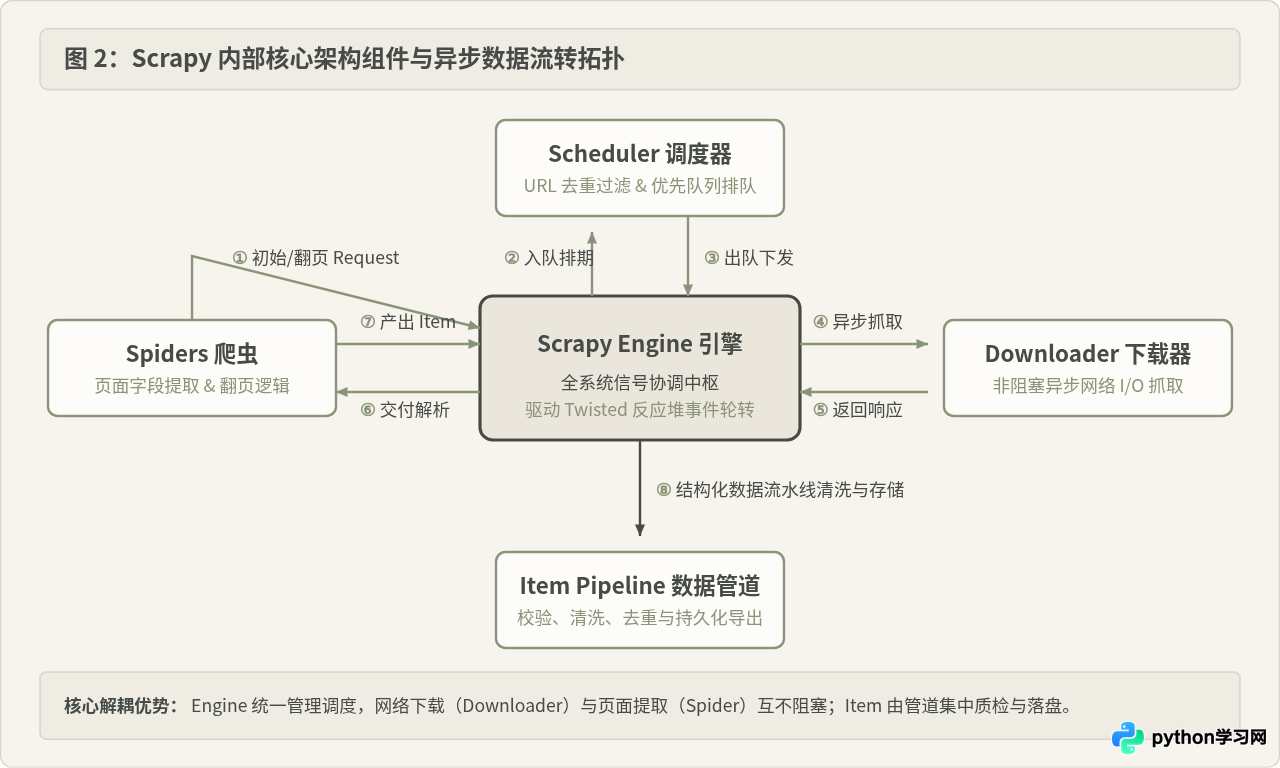
整个采集生命周期由 Scrapy Engine(引擎) 协调轮转,具体流转分为八个明确节点:
- 发起请求:Spider 产出初始种子请求(
Request),提交给引擎。 - 调度入队:引擎将请求送入 Scheduler(调度器),调度器负责请求指纹去重并按优先级入队。
- 请求分发:调度器向引擎吐出下一个就绪的待抓请求。
- 下载网页:引擎将请求通过下载中间件传递给 Downloader(下载器),下载器通过 Twisted 异步非阻塞 I/O 向远程站点发送 HTTP 请求。
- 返回响应:远程服务器返回 HTTP 响应内容,下载器将其封装为
Response对象,回传给引擎。 - 交付解析:引擎将
Response经由爬虫中间件分发至对应的 Spider 回调函数(默认为parse)。 - 产出实体:Spider 在回调中解析页面,提炼出结构化数据对象(
Item)以及需要继续跟踪的翻页请求(新Request)。 - 清洗落盘:引擎将结构化数据
Item送入 Item Pipeline 链条,依序执行数值清洗、校验去重和格式化保存;翻页请求则重新返回步骤 ② 循环调度。
三、结构化采集实战核心四部曲
完成了环境搭建并理解流转机制后,我们进入核心代码编写环节。标准工程落地包含四大步骤:定义数据契约、编写提取与跟踪逻辑、构建清洗校验管道、以及调度配置。
第 1 步:在 items.py 中定义结构化数据契约
在非工程化的简易脚本中,开发者往往直接在代码里塞原生字典(dict)。这极易因手误写错字段键名(如 price 误写为 prcie)而导致脏数据流入数据库。
通过继承 scrapy.Item 并声明 scrapy.Field(),我们可以建立强约束的“数据模型契约”。修改 book_collector/items.py:
# book_collector/items.py
import scrapy

class BookItem(scrapy.Item):
    title = scrapy.Field()       # 书籍标题 (str)
    price = scrapy.Field()       # 价格 (清洗后为 float)
    rating = scrapy.Field()      # 评分 (清洗后为 1-5 整数)
    stock = scrapy.Field()       # 库存状态 (清洗后为 bool)
    detail_url = scrapy.Field()  # 详情页绝对链接 (str)
使用 BookItem 后,只要 Spider 中尝试赋值未声明的字段,Scrapy 就会立即抛出 KeyError,在开发阶段即可阻断非法字段。
第 2 步:在 Spider 中编写页面提取与翻页跟踪逻辑
打开 book_collector/spiders/books.py。我们需要重写 parse 方法,遍历图书列表卡片,提取字段并填充到 BookItem 中。同时,通过查找“下一页”的按钮链接,实现自动递归抓取。
# book_collector/spiders/books.py
import scrapy
from book_collector.items import BookItem

class BooksSpider(scrapy.Spider):
    name = "books"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/page-1.html"]

    def parse(self, response):
        # 1. 遍历当前页面的所有图书卡片
        books = response.css("article.product_pod")
        for b in books:
            item = BookItem()

            # 使用 CSS 选择器提取原始文本,.get() 方法在匹配不到时返回 None,避免抛出异常
            item['title'] = b.css("h3 a::attr(title)").get()
            item['price'] = b.css("p.price_color::text").get()

            # 提取评分 class,例如 'star-rating Three'
            rating_classes = b.css("p.star-rating::attr(class)").get()
            item['rating'] = rating_classes.replace("star-rating", "").strip() if rating_classes else None

            # 提取库存文本
            item['stock'] = b.css("p.instock.availability::text").getall()

            # 拼接详情页完整链接
            relative_url = b.css("h3 a::attr(href)").get()
            item['detail_url'] = response.urljoin(relative_url)

            yield item

        # 2. 查找下一页分页节点
        next_page = response.css("li.next a::attr(href)").get()
        if next_page is not None:
            # response.follow 会自动结合当前 response.url 补全相对路径
            yield response.follow(next_page, callback=self.parse)
在生产代码中,应优先使用 .get() 或 .getall(),避免使用已废弃且易报 IndexError 的 extract()[0]。对于翻页,直接使用 response.follow(next_page, callback=self.parse),它原生支持相对路径拼装并自带去重判定。
第 3 步:在 pipelines.py 中编写数据清洗与校验逻辑
Spider 只负责“把网页上的原始文字拿下来”,而“数据的纯洁度与合规性”应全部收敛在 Pipeline 中。例如,从网页拿到的价格是包含英镑符号的字符串 "£51.77",文字评分为 "Three",这些必须转换为机器可读的数值。
打开 book_collector/pipelines.py,编写包含类型清洗与丢弃异常条目的管道类:
# book_collector/pipelines.py
import re
from scrapy.exceptions import DropItem

class BookCleanPipeline:
    RATING_MAP = {
        'One': 1,
        'Two': 2,
        'Three': 3,
        'Four': 4,
        'Five': 5
    }

    def process_item(self, item, spider):
        # 1. 标题必须存在,否则认定为废弃记录
        if not item.get('title'):
            raise DropItem(f"缺失必要字段 title: {item}")

        # 2. 价格字段清洗:提取浮点数
        price_raw = item.get('price')
        if price_raw:
            price_match = re.search(r'\d+\.\d+', price_raw)
            if price_match:
                item['price'] = float(price_match.group())
            else:
                item['price'] = 0.0
        else:
            item['price'] = 0.0

        # 3. 评分字段清洗:映射为 1-5 整数
        rating_raw = item.get('rating')
        item['rating'] = self.RATING_MAP.get(rating_raw, 0)

        # 4. 库存状态清洗:转为布尔值
        stock_list = item.get('stock', [])
        stock_text = "".join(stock_list).strip().lower()
        item['stock'] = 'in stock' in stock_text

        # 必须返回处理后的 item,供后续管道或导出组件接收
        return item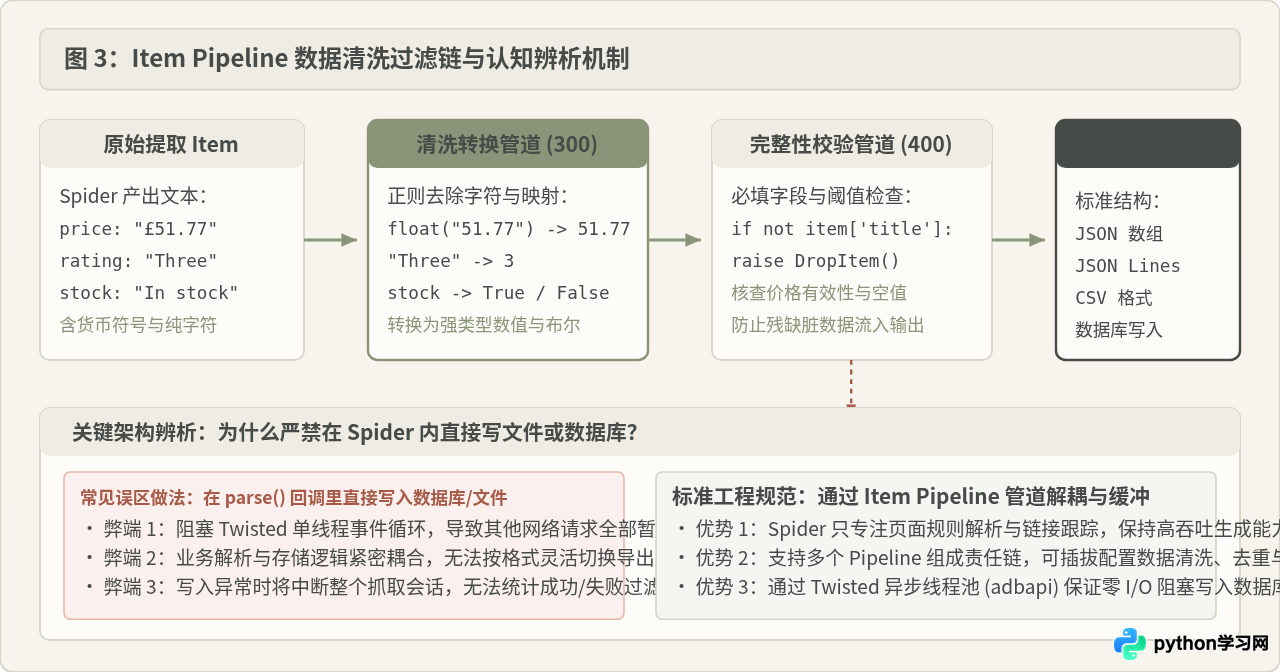
第 4 步:在 settings.py 中配置管道激活与调度参数
编写好的 Pipeline 默认处于未激活状态,必须在 book_collector/settings.py 中显式声明其类名与执行优先级(数值越小优先级越高,范围通常在 1~1000 之间)。同时,我们需要配置合规友好的采集速率。
在 settings.py 中调整以下核心配置项:
# book_collector/settings.py

# 遵守目标站点的 robots.txt 协议
ROBOTSTXT_OBEY = True

# 设定下载延迟(秒),避免对目标站点造成突发高并发攻击
DOWNLOAD_DELAY = 1.0

# 单个域名的最大并发连接数(默认 8)
CONCURRENT_REQUESTS_PER_DOMAIN = 8

# 配置标准合规的 User-Agent
USER_AGENT = "BookCollectorBot/1.0 (+http://example.com/bot; contact@example.com)"

# 激活 Item Pipeline 管道
ITEM_PIPELINES = {
   "book_collector.pipelines.BookCleanPipeline": 300,
}

# 控制台日志级别(推荐 INFO,减少繁杂的 DEBUG 输出)
LOG_LEVEL = "INFO"
四、执行采集任务与结构化导出验证
完成上述四步配置后,整个采集流水线已处于生产可用状态。Scrapy 内置了强大的 Feed Exports 系统,支持直接输出 JSON、JSON Lines、CSV 或 XML 格式,无需手动编写文件保存代码。
1. 执行采集并导出数据
在终端中运行以下命令。特别注意:导出参数推荐使用大写的 -O,它会在每次运行时覆盖已有文件;而小写的 -o 会在已有文件末尾追加,追加 JSON 文件会导致生成非法的多根节点损坏文件。
scrapy crawl books -O books_data.json2. 控制台日志统计核查(Stats Dump)
任务执行完毕后,Scrapy 会在终端最后打印一份完整的执行统计摘要。这是一项至关重要的结果验证手段:
重点检查以下四项指标:
item_scraped_count:成功经由 Pipeline 验证并落盘的有效记录总数(此处示例为 1000 条)。item_dropped_count:被DropItem拦截的残缺记录数,若数值异常偏高,说明前端页面规则有变或校验条件过于苛刻。downloader/response_status_count/200:HTTP 成功响应频次。如果出现大量的 403 或 429,说明已触及目标站点的风控限制,需调大DOWNLOAD_DELAY。elapsed_time_seconds:运行总耗时,用于评估采集吞吐速率。
3. 交付数据成果样例
打开生成的 books_data.json,数据结构呈现为清洗完成的标准实体数组:
[
  {
    "title": "A Light in the Attic",
    "price": 51.77,
    "rating": 3,
    "stock": true,
    "detail_url": "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html"
  },
  {
    "title": "Tipping the Velvet",
    "price": 53.74,
    "rating": 1,
    "stock": true,
    "detail_url": "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html"
  }
]
五、关键认知辨析与常见陷阱规避
在实际构建 Scrapy 项目时,有一些广为流传的说法看似合理,但在特定工程条件下会引发隐患。我们针对其中最典型的三个认知进行辨析:
辨析一:“在 parse() 回调函数里直接写数据库更快捷省事”
看似合理之处:对刚从简单脚本转过来的开发者而言,既然解析出了字段,顺手 cursor.execute("INSERT...") 逻辑上最直观,少写一个 pipelines.py。
成立条件与修正:这种做法只在单机抓取极少量测试页面(如小于 10 页)时看似没有问题。然而,Scrapy 的底层是一个单线程的 Twisted 事件循环。一旦在 parse() 中执行了阻塞式 I/O 操作(例如同步连接 MySQL 或写入本地磁盘文件),整个事件循环就会在此处完全停滞,所有后续的网络请求均被阻塞,高并发优势归零。
正确方案:必须把存储工作移交至 Item Pipeline。若需要写入关系型数据库,应结合 twisted.enterprise.adbapi 异步连接池,或者在管道中批量缓存后异步刷盘,使 Spider 始终专注于高速解析。
辨析二:“并发配置(CONCURRENT_REQUESTS)设得越高,采集速度就越快”
看似合理之处:提高并发线程/连接数通常被视为提高数据吞吐的直接手段。
成立条件与修正:该结论仅在目标服务器带宽无限、算力充裕且完全没有防刷保护时局部成立。在真实生产环境中,盲目将并发设置为 64 或 128 会导致两种严重后果:第一,本地带宽或 DNS 查询线程打满导致大量超时(DNSLookupError);第二,迅速触发目标站点的频率风控,返回 429 Too Many Requests 或直接将 IP 封禁。
正确方案:结构化采集应追求“稳态吞吐”而非“峰值瞬态”。通常建议将 CONCURRENT_REQUESTS_PER_DOMAIN 设为 4~8,配合 DOWNLOAD_DELAY = 1.0 并开启 AUTOTHROTTLE_ENABLED = True(智能自适应限速扩展),根据目标站点的响应延迟动态微调并发。
辨析三:“Scrapy 无法采集带有 JavaScript 渲染的现代前端页面”
看似合理之处:Scrapy 默认内置的 Downloader 仅下载纯文本 HTML,无法执行页面中的 JS 脚本,直接解析 SPA(单页应用)时常常只能拿到一个空的 <div id="root"></div>。
成立条件与修正:Scrapy 确实不自带浏览器的渲染引擎,但断言其“无法采集动态页面”是不准确的。在实践中,70% 以上的动态页面底层都有规范的异步 API(JSON 接口),通过浏览器开发者工具审查 XHR/Fetch 网络请求,直接将 Scrapy 的 start_urls 指向 JSON 接口,采集效率比用无头浏览器高出十倍以上;而对于确实无法绕过加密或必须依赖 DOM 渲染的页面,可以通过 scrapy-playwright 中间件将无头浏览器无缝挂载为 Downloader 的渲染后端。
六、结构化采集工程化就绪与自检总结
在将采集任务正式部署到长期运行环境或调度平台之前,对照以下自检矩阵进行核对,能够规避绝大多数由网络波动、数据脏乱或风控阻断引发的停机事故。
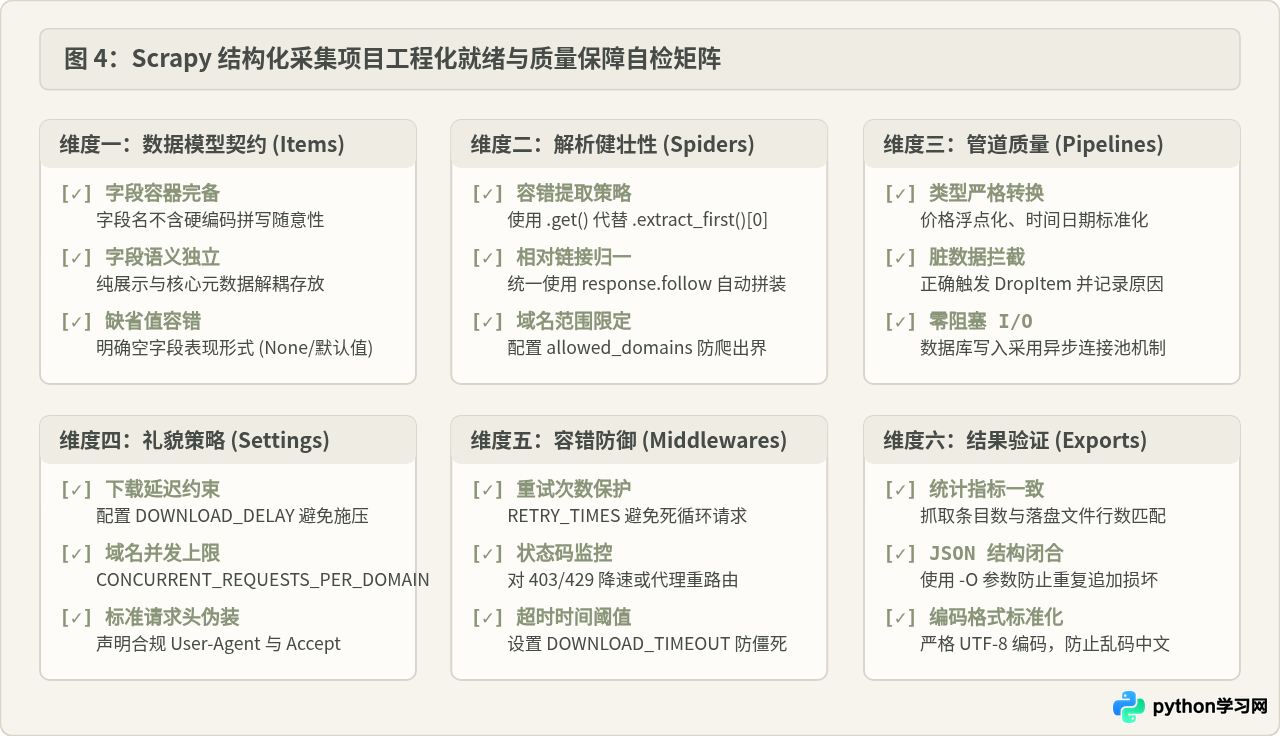
| 工程检查维度 | 规范实践要点 | 未达标时的典型故障 |
|---|---|---|
| 数据模型 (Items) | 统一继承 scrapy.Item,禁止随意添加未经声明的动态键 |
手误拼写错字段名,导致导出的列分散不齐或缺失 |
| 解析容错 (Spider) | 所有单节点提取采用 .get(),翻页统一用 response.follow |
页面遇到个别缺失标签抛出 IndexError,造成单个页面提取中断 |
| 清洗管道 (Pipeline) | 在管道中完成类型转换与空值清洗,不合格条目抛出 DropItem |
脏数据污染下游分析库;字符串与浮点数混杂引发解析报错 |
| 礼貌并发 (Settings) | 配置合理的 DOWNLOAD_DELAY 与 USER_AGENT,开启 AutoThrottle |
瞬间高并发造成对方站点瘫痪或本机 IP 遭遇封禁 |
| 导出验证 (Exports) | 使用 -O 覆盖导出并核对 item_scraped_count 统计 |
使用 -o 反复追加造成非法的损坏 JSON 格式 |
遵循上述工程步骤与结构规范,即可确保 Scrapy 项目从一个临时性的抓取脚本蜕变为具备工业级健壮性、数据质量保障与维护扩展性的 Python 结构化数据采集系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















