


Python Requests库怎么获取重定向后的最终URL
深入讲解在 Python 中使用 Requests 库获取 HTTP 重定向后最终 URL 的实用方法,包含 response.url 核心用法、response.history 跳转链路解析、allow_redirects 控制机制及异常防护。
response.url 属性,即可获得经历所有跳转之后落地的最终绝对地址;若需查看请求过程中经过的所有中间跳板和状态码,则可以读取 response.history 列表。
一、核心解答:使用 response.url 直接获取最终地址
HTTP 重定向(如常见的 301 永久重定向、302 临时重定向、307 及 308)是 Web 服务中经常出现的跳转机制。例如,当客户端访问未加密的 http://github.com 时,服务端会指示客户端跳转至规范的 https://github.com/。
Requests 库在处理 GET、OPTIONS 等请求时,默认开启了自动跟随重定向行为(即内部参数 allow_redirects=True)。这意味着开发者无需手动解析响应头中的 Location 字段并再次发送请求,Requests 会在底层自动跟踪重定向链路,并将最终到达页面的 URL 赋给 response.url。
import requests

# 发起一个包含协议或路径跳转的请求
target_url = "http://github.com"
response = requests.get(target_url)

# 读取最终落地 URL
final_url = response.url
print(f"初始请求: {target_url}")
print(f"最终落地: {final_url}")
在控制台中执行上述代码,输出结果如下(示例):
初始请求: http://github.com
最终落地: https://github.com/
此时 response.status_code 返回的是最终目标页面的状态码(通常是 200),而 response.text 包含的也是最终页面的 HTML 内容。
二、查看重定向历史链条:遍历 response.history
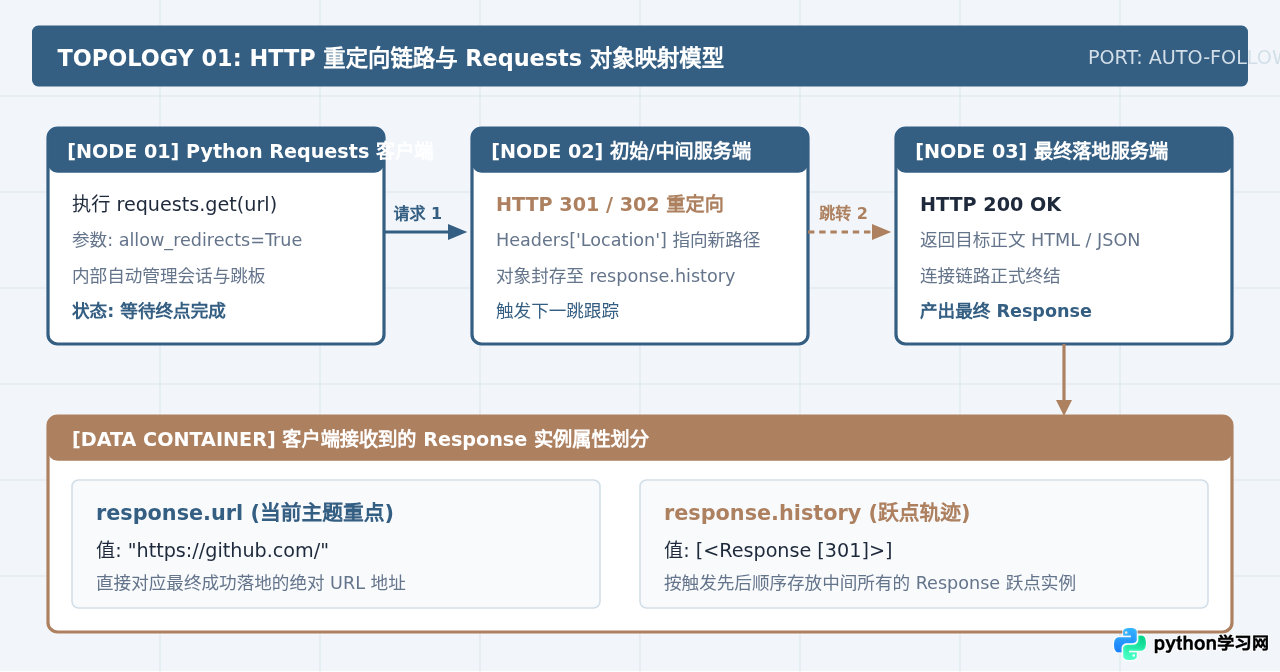
在网络爬虫、链接审计或接口调试场景中,仅仅知道“最终 URL”可能还不够,往往还需要知道整个跳转链路:一共重定向了几次?中间分别经过了哪些域名或协议?
Requests 提供了 response.history 属性来完整记录这个过程。response.history 是一个 Python 列表(list),按照请求发生的先后顺序,依次存储每一个中间重定向步骤所产生的 Response 对象。
- 如果请求没有发生任何重定向,
response.history为空列表[]。 - 如果发生了重定向,列表中的每一个元素都是一个标准
Response对象,可以通过.url查看当时的请求路径,通过.status_code查看跳转状态码,或通过.headers['Location']获取该步指定的重定向目标。
import requests

# httpbin.org 提供了多跳重定向测试接口,此处模拟跳转 3 次
test_url = "https://httpbin.org/redirect/3"
response = requests.get(test_url)

print(f"最终目标 URL: {response.url}")
print(f"总共经历跳数: {len(response.history)}")

for index, step_resp in enumerate(response.history, start=1):
    next_hop = step_resp.headers.get("Location")
    print(f"第 {index} 跳 | 状态码: {step_resp.status_code} | 当前: {step_resp.url} -> 下一跳: {next_hop}")
代码运行后的控制台输出示例如下:
最终目标 URL: https://httpbin.org/get
总共经历跳数: 3
第 1 跳 | 状态码: 302 | 当前: https://httpbin.org/redirect/3 -> 下一跳: /relative-redirect/2
第 2 跳 | 状态码: 302 | 当前: https://httpbin.org/relative-redirect/2 -> 下一跳: /relative-redirect/1
第 3 跳 | 状态码: 302 | 当前: https://httpbin.org/relative-redirect/1 -> 下一跳: /get
通过以上遍历,重定向链路的完整流向清晰可见。
三、控制重定向行为:禁止自动跳转以提高效率
在某些特定的开发场景下,我们并不希望 Requests 自动跟踪重定向。例如:
- 短链接解析服务:只需要知道短网址跳转到哪个长网址,而不想真正下载几兆甚至上百兆的目标页面 HTML 或多媒体文件。
- SEO 审计与跳转验证:需要明确验证某个页面返回的是
301 永久重定向还是302 临时重定向,而不是直接拿到终点的200 OK。
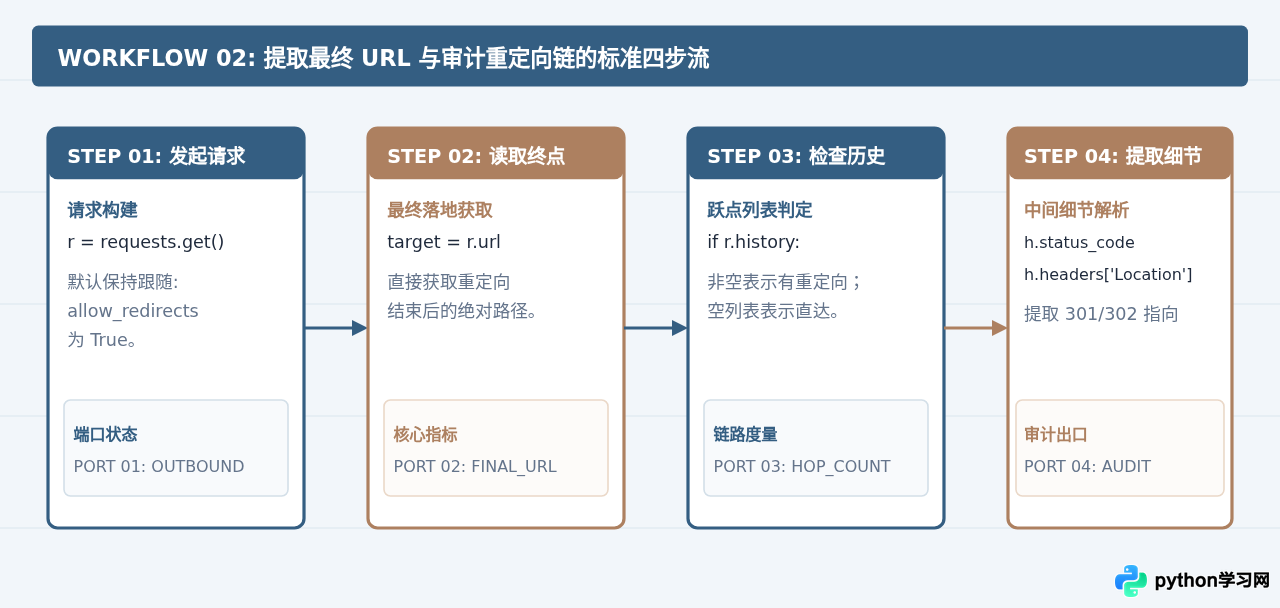
此时,可以在请求中显式设置 allow_redirects=False。设置后,Requests 在收到服务端返回的 30x 响应后会立即停止并直接返回该响应对象。
import requests
from urllib.parse import urljoin

initial_url = "http://github.com"

# 设置 allow_redirects=False 禁止自动跟随
response = requests.get(initial_url, allow_redirects=False)

print(f"当前状态码: {response.status_code}")  # 输出: 301
print(f"当前 response.url: {response.url}")  # 输出仍然是初始 URL

# 从 Location 响应头中提取下一跳地址
location = response.headers.get("Location")
print(f"响应头 Location: {location}")

# 注意:Location 有可能是相对路径,需使用 urljoin 拼接成完整 URL
final_target = urljoin(response.url, location)
print(f"计算出的下一跳绝对地址: {final_target}")allow_redirects=False 时,response.url 返回的是当前这一步请求发起时的 URL,而不是目标 URL;目标 URL 存放于响应头 response.headers['Location'] 中。
四、不同 HTTP 请求方法的重定向差异
并不是所有请求方法的重定向默认配置都一致,在实际开发中有两处关键差异需要特别注意:
1. HEAD 请求默认不跟踪重定向
在 Requests 库中,requests.get() 的 allow_redirects 默认为 True,但用于只读取响应头的 requests.head(),其 allow_redirects 默认是 False。
如果你尝试用 HEAD 请求探测最终 URL 以节省流量,必须显式指定 allow_redirects=True,否则拿到的是第一跳的 301/302 响应:
import requests

# 错误用法: requests.head 默认不跟随重定向,拿不到最终落地 URL
resp_err = requests.head("http://github.com")
print(resp_err.status_code)  # 输出: 301
print(resp_err.url)          # 输出仍是: http://github.com

# 正确用法: 显式开启 allow_redirects=True
resp_ok = requests.head("http://github.com", allow_redirects=True)
print(resp_ok.status_code)   # 输出: 200
print(resp_ok.url)           # 输出: https://github.com/
2. POST 请求与状态码转换
当对一个 URL 发送 POST 请求并触发重定向时,HTTP 协议规范定义了不同的转换逻辑:
- 301 Moved Permanently / 302 Found:按照历史惯例和浏览器事实标准,Requests 会将下一跳请求的方法由
POST降级自动转换为GET方法,且不再携带原始 POST 请求体。 - 307 Temporary Redirect / 308 Permanent Redirect:根据 HTTP/1.1 标准规范,客户端必须严格保留原始的请求方法和数据载荷向下一跳地址发送请求。
五、异常处理与边界防御
在自动化处理重定向时,网络环境与服务端配置可能出现异常,以下两项防护是保证代码健壮性的必做项。
1. 捕获循环重定向:TooManyRedirects
如果目标网站配置失误,可能形成循环跳转(例如 A 跳转到 B,B 又跳转到 A)。Requests 内部默认设置了最大跳转次数上限(通常为 30 次)。一旦超过该阈值,Requests 会立即抛出 requests.exceptions.TooManyRedirects 异常。
import requests
from requests.exceptions import TooManyRedirects, RequestException

url = "https://httpbin.org/redirect/50"  # 超过默认最大限制

try:
    response = requests.get(url, timeout=10)
    print(f"最终URL: {response.url}")
except TooManyRedirects:
    print("发生异常: 重定向次数超过上限,可能存在死循环!")
except RequestException as e:
    print(f"网络请求错误: {e}")
2. 会话保持(Session)中的重定向
如果重定向涉及用户登录验证、OAuth 授权或 Cookie 传递,使用独立的 requests.get() 会丢失前置设置的 Cookie。推荐使用 requests.Session(),它能在重定向跳转的全程中自动保持 Cookie 和连接池状态:
with requests.Session() as session:
    session.headers.update({"User-Agent": "Mozilla/5.0 AuditBot"})
    resp = session.get("http://example.com/login-redirect")
    print(f"落地URL: {resp.url}")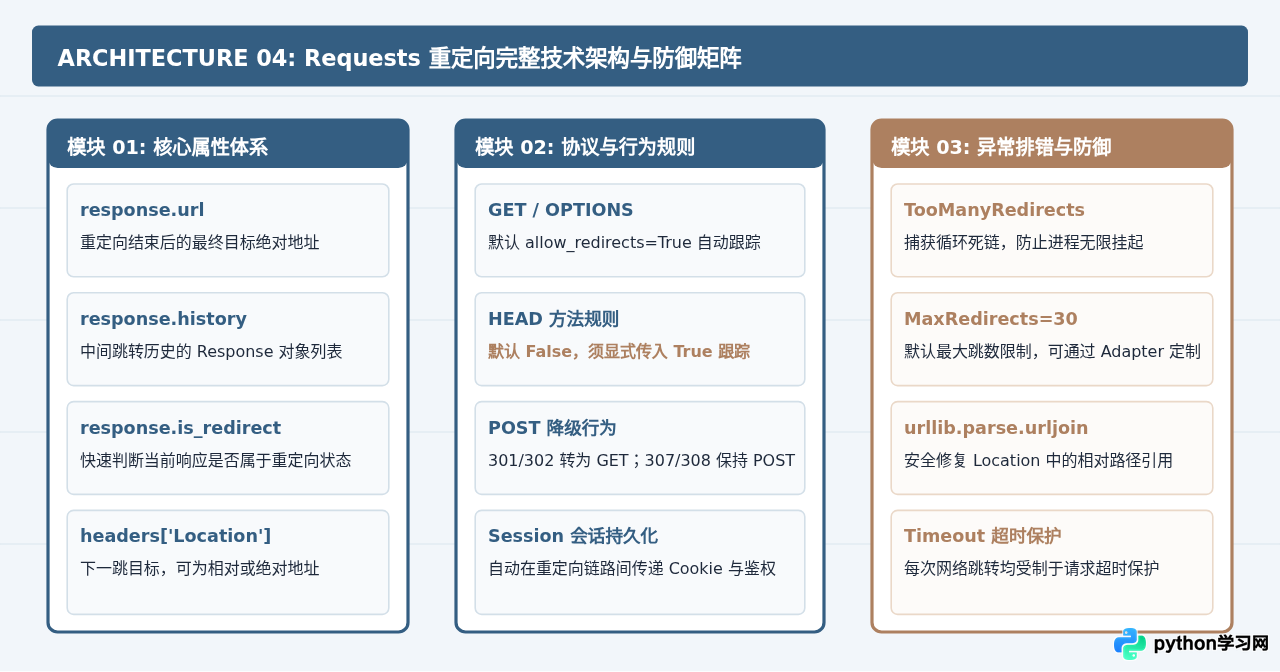
六、实践总结与速查清单
在处理“获取重定向后最终 URL”这一需求时,可以对照下表快速选择最适宜的代码方案:
| 目标需求 | 核心实现方案 | 关键返回值 / 属性 |
|---|---|---|
| 直接获取最终目标 URL | response = requests.get(url) |
直接读取 response.url |
| 获取完整的中间跳转路径 | for hop in response.history: ... |
hop.status_code 与 hop.url |
| 判断是否发生过重定向 | bool(response.history) |
若长度大于 0 则代表发生过跳转 |
| 仅获取下一跳,不下载正文 | requests.get(url, allow_redirects=False) |
response.headers.get('Location') |
| 使用 HEAD 方法探测终点 | requests.head(url, allow_redirects=True) |
必须显式声明 allow_redirects=True |
| 防范循环跳转与死锁 | 使用 try...except TooManyRedirects |
捕获超限重定向异常并记录日志 |
掌握 response.url 和 response.history 的配合使用,不仅能够轻松获取任何链接的最终落地地址,还能对复杂的网络跃点链路建立起清晰的掌控与排错能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















