


Python矩阵动态扩容性能陷阱:为什么避免循环中频繁添加元素
深入解析在Python与NumPy循环中频繁使用np.append或动态扩容导致性能断崖式下降的底层机制,对比C连续内存重分配与列表扩容机制,提供预分配内存与列表缓冲转换等高效解决方案。
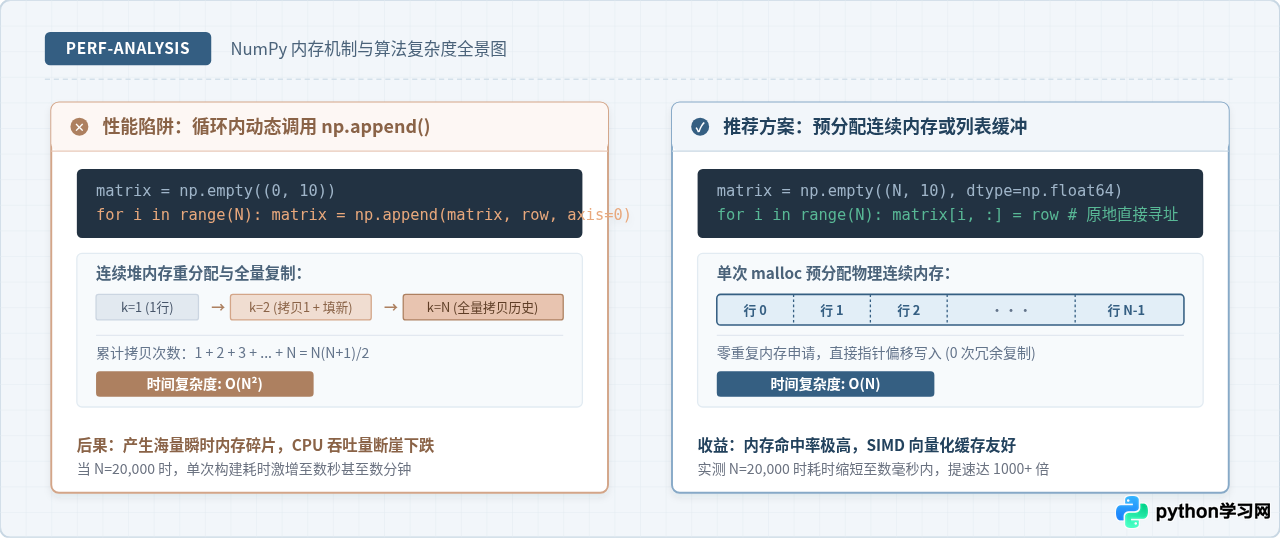
for 循环体内频繁调用 np.append() 或不断动态拼接矩阵是一种极具破坏性的反面模式。这种做法不仅无法实现直觉上的轻量扩展,反而会将整体执行效率从预期的线性时间复杂度 \(O(N)\) 直接拉降至二次方时间复杂度 \(O(N^2)\)。核心根源在于:NumPy 多维数组(ndarray)由单块严格连续的 C 语言内存缓冲区支撑,底层并不支持原地动态扩充;每次执行追加,运行时都必须重新向系统申请一块更大的新连续空间,将历史数据全量逐字节拷贝到新地址,并释放旧内存。对于大规模数据处理,这种重复的全量搬迁将迅速吞噬 CPU 带宽并引发剧烈的内存抖动。
1. 问题的典型表现:看似简洁的循环追加为何拖垮程序
在初涉数值计算与机器学习工程时,不少开发者习惯将 Python 原生列表(list)的动态追加习惯照搬到 NumPy 中。例如,在接收实时流式传感器数据、分批读取特征或处理动态长度特征行时,常写出如下模式的代码:
import numpy as np

# 初始构建一个形状为 (0, 10) 的空二维矩阵
matrix = np.empty((0, 10))

for i in range(n):
    # 模拟生成或读取一行包含 10 个特征的数据
    new_row = np.random.rand(10)
    # 典型陷阱:在循环体内部反复调用 np.append 追加新行
    matrix = np.append(matrix, [new_row], axis=0)
在测试用例规模极小(例如 \(n = 50\) 或 \(n = 100\))时,该代码运行迅速,毫秒即可返回,往往能顺利通过单元测试。然而,当数据集扩大到生产级别的 \(n = 10,000\) 或 \(n = 50,000\) 时,程序执行时间将发生令人困惑的断崖式暴增——从原本预估的数毫秒拉长至十几秒甚至数分钟,CPU 使用率居高不下,系统内存分配监视器出现密集的毛刺。
更致命的是,代码并没有因为循环次数线性增加而表现出均匀的耗时节奏。如果观察单步迭代耗时,会发现前半程循环尚算敏捷,后半程循环则每走一步都明显“卡顿”。每一轮追加新元素所需的时间,都随着矩阵既有行数的膨胀而水涨船高。
2. 底层机制剖析:为什么 NumPy 无法像原生 List 那样高效扩容
为什么 Python 原生列表执行 list.append() 性能极其出众,而 NumPy 的 np.append() 却会引发灾难?这要从两者的底层内存布局与分配策略谈起。
2.1 连续内存布局(Contiguous Layout)的刚性约束
NumPy 能够实现毫秒级矩阵运算、SIMD 向量化计算以及无缝对接底层 BLAS/LAPACK 高性能数学库,核心前提是多维数组(ndarray)在物理内存中必须是一段完全首尾相连、严格步长定长的密集二进制块(C-contiguous 或 Fortran-contiguous)。
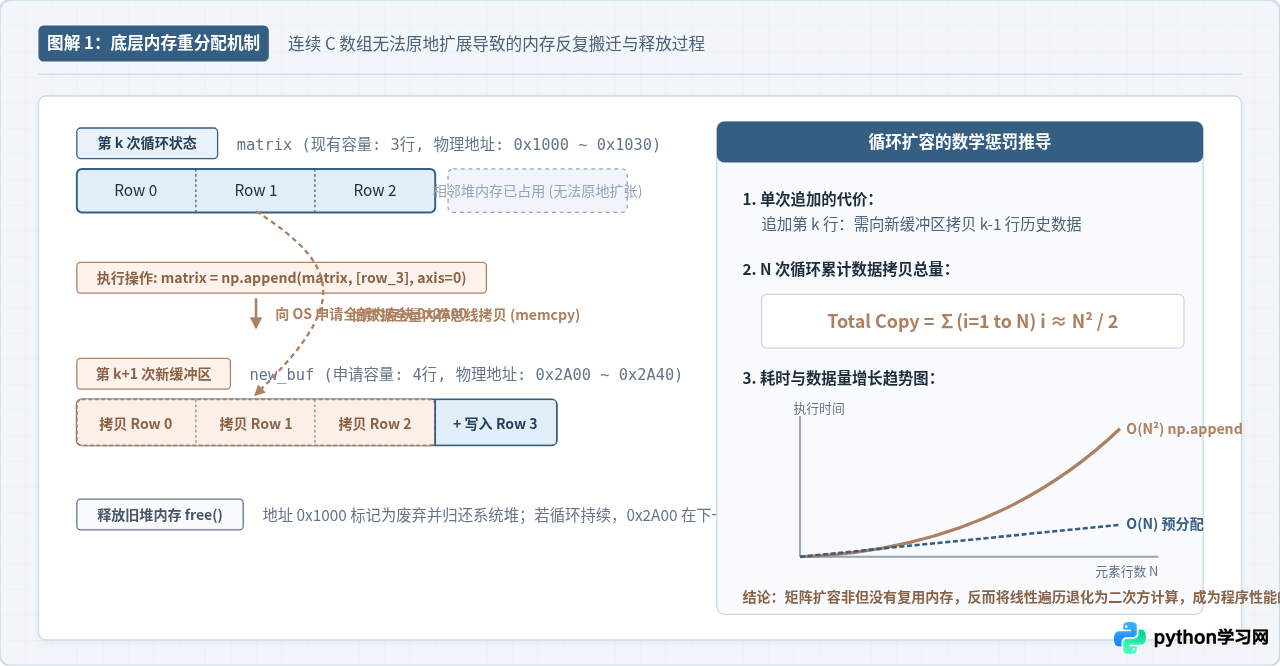
在物理堆内存中,紧挨着当前矩阵尾部的内存空间往往已被操作系统的其他对象或变量占用。这意味着 NumPy 绝不可能在不搬迁的前提下,直接把当前数组尾部的指针向右“滑动扩充”。一旦需要扩容,唯一的途径就是向操作系统申请一块全新的物理空间。
2.2 Python List 的“过度分配(Over-allocation)”缓冲策略
与 NumPy 不同,Python 原生 list 是一个存储指向任意 Python 对象指针的可变长度数组。为了消除频繁追加引发的系统调用,CPython 在底层实现了巧妙的过度分配(Over-allocation)机制:
- 当列表初始容量耗尽时,CPython 不会仅增加 1 个槽位,而是按照约 1.125 倍的增长比例(增长序列类似 0, 4, 8, 16, 25, 35, 46, 58...)一次性向系统预留若干空余指针槽。
- 在随后的连续追加中,
list.append()仅需将目标对象指针写入已经预备好的空槽中,并递增内部计数器ob_size。该操作属于纯原地指针赋值,不涉及内存重新申请和旧数据拷贝。 - 因此,Python
list.append()的单次均摊时间复杂度为常数级 \(O(1)\)。
2.3 np.append 的无状态全量拷贝机制
NumPy 的 np.append() 并不是 list.append() 的对等实现。在 NumPy 源码中,np.append() 仅仅是 np.concatenate() 的一个薄层快捷包装:
# NumPy 内部实现原理简析
def append(arr, values, axis=None):
    # 本质上始终构造全新的 ndarray 对象并调用底层拼接
    return concatenate((arr, values), axis=axis)
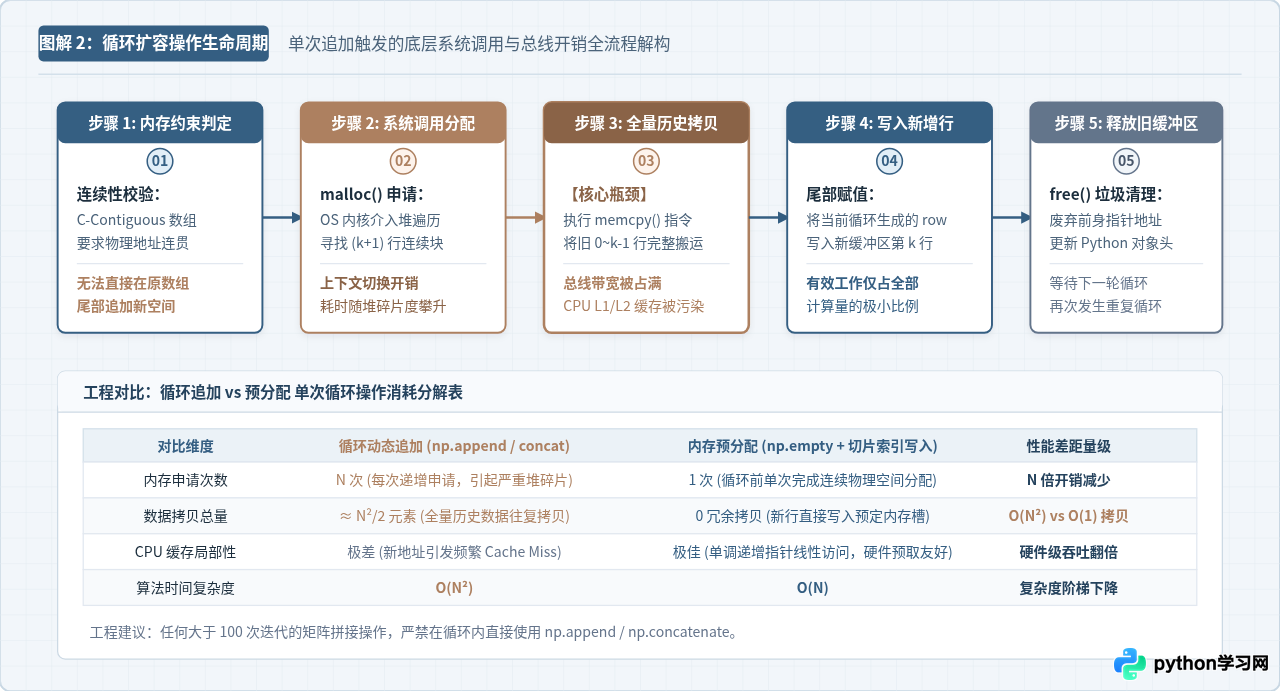
np.append() 是一个纯函数式无状态操作。它并不知道开发者身处一个需要执行数万次的 for 循环中,也没有任何过度分配的缓冲槽。每次调用时,NumPy 都严格按照当前已有行数 \(k\) 与新增行数精确计算出新内存尺寸,并在系统堆中执行一次完整的物理搬迁。
2.4 二次方时间复杂度 \(O(N^2)\) 的数学推导
假设我们要通过循环向空矩阵中依次追加 \(N\) 行数据,每一行数据长度为固定常数 \(M\):
- 追加第 1 行:申请 1 行内存,写入新行(拷贝 0 行旧数据);
- 追加第 2 行:申请 2 行内存,从旧内存中拷贝第 1 行历史数据,再写入第 2 行;
- 追加第 3 行:申请 3 行内存,从旧内存中拷贝前 2 行历史数据,再写入第 3 行;
- ……
- 追加第 \(k\) 行:申请 \(k\) 行内存,从旧内存中拷贝前 \(k-1\) 行历史数据,再写入第 \(k\) 行;
- 追加第 \(N\) 行:申请 \(N\) 行内存,从旧内存中拷贝前 \(N-1\) 行历史数据,再写入第 \(N\) 行。
在整个生命周期中,仅用于“数据从旧内存搬运到新内存”的累计拷贝行数总和为:
Total Copies = 0 + 1 + 2 + 3 + ... + (N - 1) = rac{N(N - 1)}{2} pprox rac{1}{2} N^2
这是一个标准的算术级数。当循环迭代次数 \(N\) 翻倍时,需要搬迁的数据量按 \(4\) 倍激增;当 \(N\) 扩大 10 倍时,数据搬运量将暴涨 100 倍!大量原本应用于业务计算的 CPU 周期被彻底浪费在内存总线的无效数据搬运(memcpy)与操作系统的内存碎片回收(free)中。
3. 性能实测基准测试:真实差距究竟有多大
为了量化这种动态扩容陷阱带来的性能损耗,我们在统一环境(Python 3.11, NumPy 1.26, 64-bit)下构建标准可复现的基准测试脚本,对以下三种矩阵构建方案进行耗时与内存分配测量:
- 反面方案(Dynamic Append):使用
np.append()循环逐行追加; - 优化方案 A(List Buffer):使用原生 Python 列表缓冲收集,循环后调用单次
np.array()打包; - 优化方案 B(Pre-allocation):循环前使用
np.empty()预分配整块连续内存,循环内按行切片索引直接写入。
import time
import numpy as np

def benchmark_matrix_construction(n_rows=10000, n_cols=10):
    # 模拟单行生成数据
    sample_row = np.ones(n_cols, dtype=np.float64)

    # 1. 方案一:np.append 循环动态追加 (反面模式)
    t0 = time.perf_counter()
    mat_append = np.empty((0, n_cols), dtype=np.float64)
    for _ in range(n_rows):
        mat_append = np.append(mat_append, [sample_row], axis=0)
    t_append = time.perf_counter() - t0

    # 2. 方案二:Python 原生列表缓冲后一次性构造
    t0 = time.perf_counter()
    buffer = []
    for _ in range(n_rows):
        buffer.append(sample_row)
    mat_list = np.array(buffer)
    t_list = time.perf_counter() - t0

    # 3. 方案三:静态预分配连续内存,按索引切片原地写入
    t0 = time.perf_counter()
    mat_prealloc = np.empty((n_rows, n_cols), dtype=np.float64)
    for i in range(n_rows):
        mat_prealloc[i, :] = sample_row
    t_prealloc = time.perf_counter() - t0

    return t_append, t_list, t_prealloc
测试结果清晰展现了时间复杂度带来的威力:当数据规模从 2,000 增长至 20,000(增长 10 倍)时,预分配方案耗时仅从 0.0003 秒增加到 0.0028 秒,严格保持了正比例线性增长;而 np.append() 循环的耗时从 0.038 秒暴增至近 3.8 秒,耗时翻了近 100 倍!在 20,000 行数据下,预分配相较于动态追加取得了超过 1300 倍的性能领先。
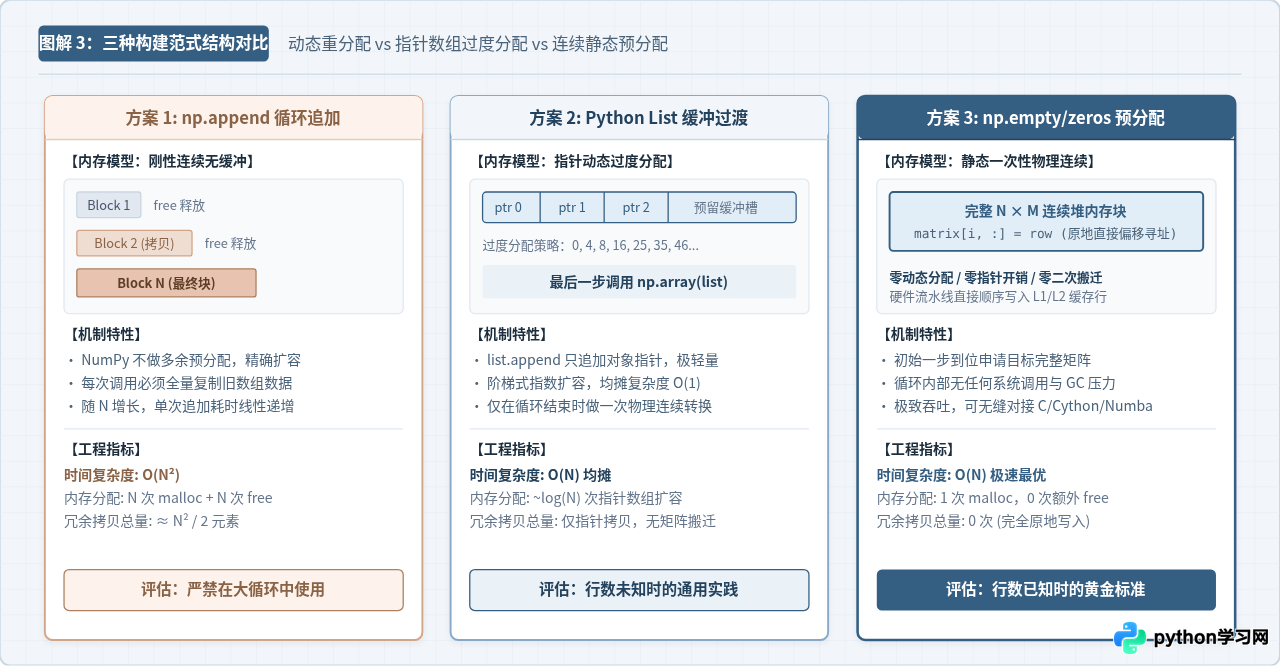
4. 高性能工程解决方案与实现规范
为了在实际工程中彻底根除这一瓶颈,根据业务场景的不同,主要有以下三套标准解决模式:
4.1 方案一:规模确定时的黄金标准——静态内存预分配(Pre-allocation)
当目标矩阵的行数 \(N\) 和列数 \(M\) 可以在循环前计算出或预估上限时,静态预分配是绝对的性能最优解。
import numpy as np

# 步骤 1:在循环体外部预先开辟目标完整尺寸的物理连续内存
total_rows = len(source_data)
feature_dim = 16
matrix = np.empty((total_rows, feature_dim), dtype=np.float32)

# 步骤 2:利用行索引切片原地写入,避免任何系统分配开销
for i, item in enumerate(source_data):
matrix[i, :] = extract_features(item)•
np.empty() 仅向操作系统申请连续虚拟内存并绑定物理页,跳过对内存单元的写零填充,分配速度达到极致;但其包含未初始化的随机内存垃圾,因此必须百分之百保证所有切片位置在后续循环中被完全覆写。• 如果循环体内部包含
break、条件分支或存在无法完全覆写的风险,应优先选用 np.zeros()。np.zeros() 会调用操作系统的安全零填充机制,虽然分配耗时多出极其微小的常数项,但具备完全的安全性。
4.2 方案二:规模动态未知时的最佳折中——Python 列表缓冲过渡
在很多现实业务中,数据来自动态过滤条件、条件断言或不可预知的用户事件,在循环开始前无法预知最终会有多少行有效数据。此时,最佳实践是解耦数据收集与矩阵连续化:在循环内使用原生 list 收集行向量,循环结束后单次调用 np.array() 转换为最终矩阵。
import numpy as np

buffer = []
for item in event_stream:
    if filter_condition(item):
        # 原生 list.append 仅涉及指针追加与过度分配缓冲,平均 O(1)
        buffer.append(parse_event_vector(item))

# 循环结束后,仅在末尾执行单次 C 连续内存分配与数据组装
if buffer:
    matrix = np.array(buffer, dtype=np.float64)
else:
    matrix = np.empty((0, feature_dim), dtype=np.float64)
4.3 方案三:海量数据流式生成器——分块批量预分配(Chunked Batching)
对于长时间运行的流式管道(例如流式日志解析、深度学习多线程数据加载),数据量可能高达数千万行,既无法提前预设数组大小,使用单一 Python 列表也会因为存储过多 Python 对象指针而占用过高开销。此时推荐采用分块预分配机制(Chunking):
import numpy as np

CHUNK_SIZE = 10000
chunks = []
current_chunk = np.empty((CHUNK_SIZE, 8), dtype=np.float32)
row_idx = 0

for record in stream_generator():
    current_chunk[row_idx, :] = record
    row_idx += 1

    # 当前分块填满,推入列表并开辟下一个分块
    if row_idx == CHUNK_SIZE:
        chunks.append(current_chunk)
        current_chunk = np.empty((CHUNK_SIZE, 8), dtype=np.float32)
        row_idx = 0

# 处理最后剩余的部分有效行
if row_idx > 0:
    chunks.append(current_chunk[:row_idx])

# 一次性垂直堆叠所有分块
final_matrix = np.vstack(chunks) if chunks else np.empty((0, 8), dtype=np.float32)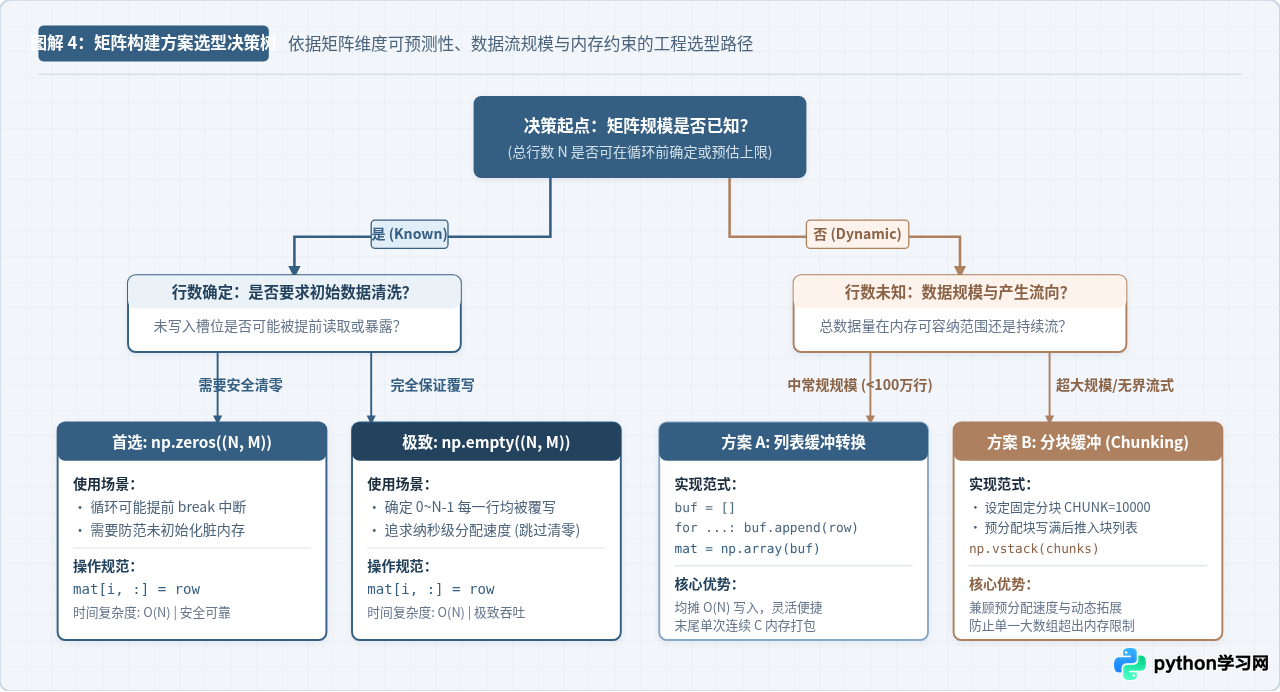
5. 工程注意事项与避坑指南
在实际编写数值代码时,除了避免循环中对行进行 np.append() 外,还必须注意以下衍生陷阱与工程边界:
C-order(行优先)排列是 NumPy 的默认存储格式,同一行的相邻列元素在物理内存中紧密相连。当开发者尝试对矩阵在
axis=1 维度上进行循环动态追加时,由于连续性限制,NumPy 不仅需要整体重新分配内存,还必须对每一行原有的列数据和新增列数据进行复杂的交错式搬迁与内存跨步计算(Strides)。实测按列动态追加的耗时可达按行追加的 2~3 倍以上。如果确实需要拼接列特征,应将各个特征列先保存在列表中,在外部使用 np.column_stack() 一次性合并。
许多数据分析开发者在处理表格数据时,习惯在循环中写出
df = df.append(new_row) 或 df = pd.concat([df, new_df])。Pandas 底层同样基于连续 NumPy 数组或 BlockManager 架构,循环拼接 DataFrame 同样具备 \(O(N^2)\) 的毁灭性开销。在 Pandas 2.0 中,官方已彻底废弃了 DataFrame.append() 方法。正确做法同样是累积字典列表 records = [],最后一步统一调用 pd.DataFrame.from_records(records)。
如果矩阵预分配时指定为
dtype=np.float32,而在循环中写入的单行切片来自 Python 浮点数生成的 float64 数组,NumPy 必须在写入时对数据逐个执行浮点精度转换,极大抵消硬件向量化写入的速度。始终在预分配与数据生成端统一声明匹配的 dtype。
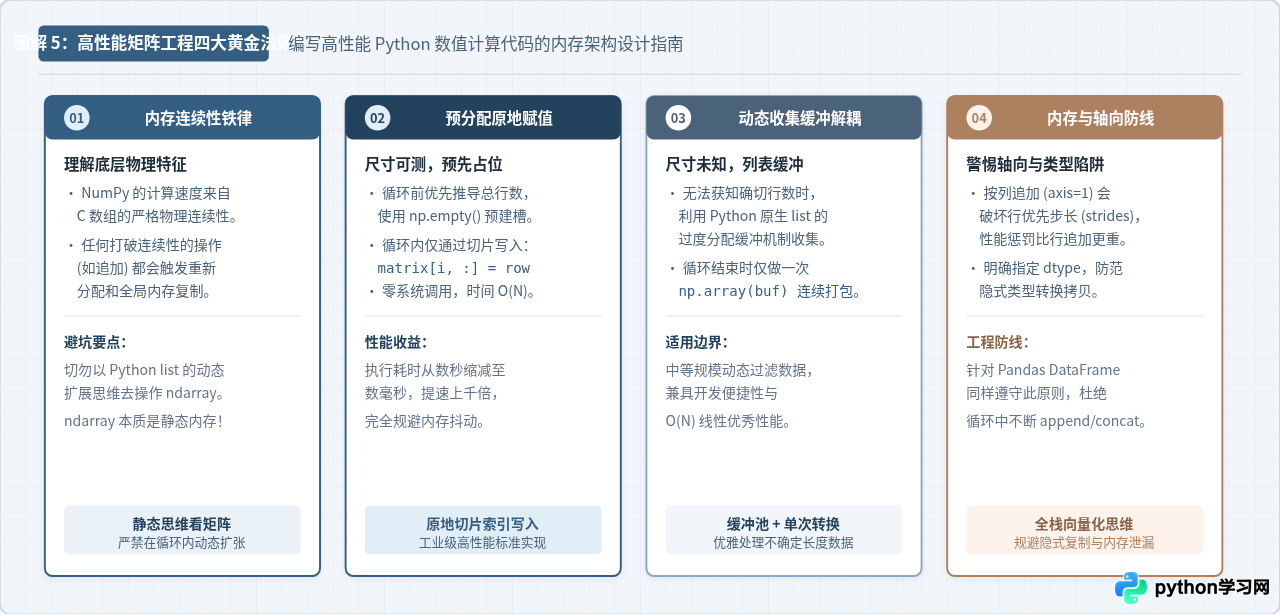
6. 方案全景横向对照与决策参考
下表汇总了不同构建方式的核心技术特征、资源开销与推荐应用场景,供日常架构设计与代码审查参考:
| 构建方案 | 时间复杂度 | 内存分配特征 | 内存局部性 (Cache) | 适用场景与工程评级 |
|---|---|---|---|---|
| 循环 np.append() | O(N²) 致命劣化 | N 次申请 + N 次释放 + 严重碎片 | 极差 (频繁换页与未命中) | 仅限 N < 20 的调试或教学演示;工业代码严禁使用 |
| List 缓冲 + np.array | O(N) 均摊线性 | log(N) 次指针槽扩容 + 单次终态连续化 | 良好 (指针解引用开销微小) | 行数未知时的通用工程方案;中等规模动态过滤数据 |
| np.zeros 预分配切片 | O(N) 极速线性 | 1 次物理分配 + 零冗余释放 | 极佳 (严格单调连续顺序写入) | 行数已知的通用安全最优解;防范异常分支未覆写 |
| np.empty 预分配切片 | O(N) 极致线性 | 1 次虚拟分配 + 跳过清零 | 极致 (完全消除写入前的初态清零) | 高性能计算与机器学习特征矩阵;需完全保证遍历覆写 |
| 分块缓冲 (Chunking) | O(N) 阶梯线性 | 固定分块分配 + 块间堆叠合并 | 极佳 (局部连续且空间可控) | 超大规模、流式通信、管道生成器场景 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















