


命令行运行Python脚本时怎么传递参数
详细讲解在命令行运行Python脚本时如何传递与解析参数。深入对比sys.argv与argparse模块的具体用法、代码示例、Shell参数分词规则及常见避坑指南。
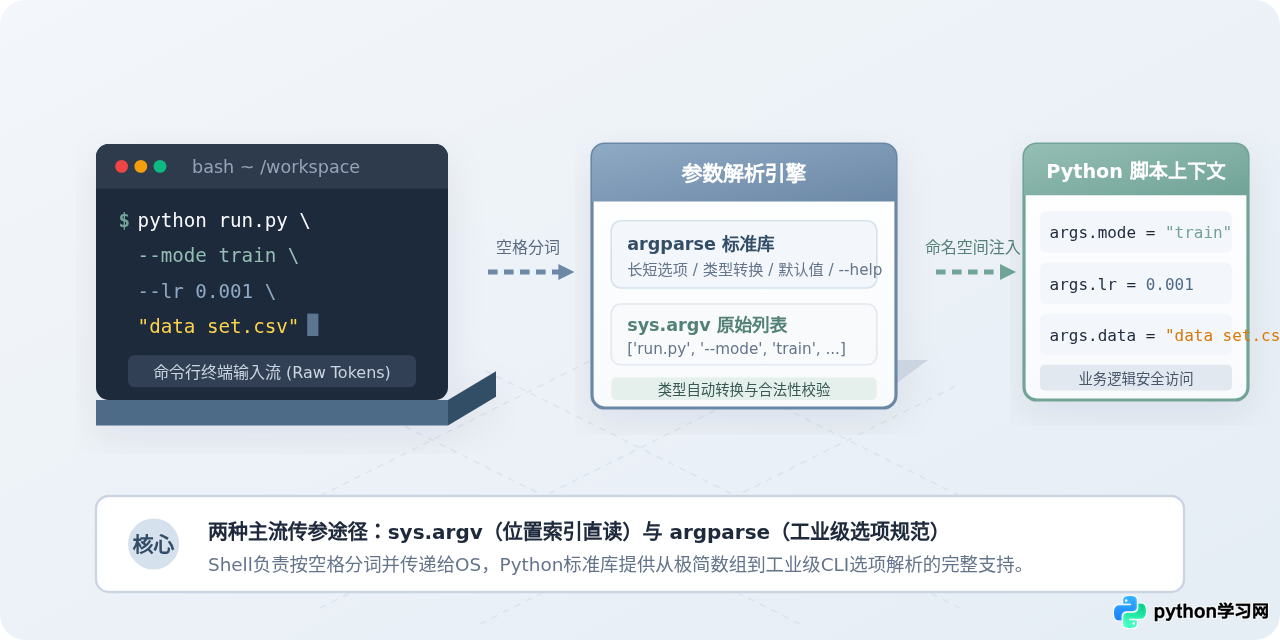
在命令行运行 Python 脚本时,向程序传递参数主要依靠两种途径:最直接的是使用内置的 sys.argv 列表,按位置下标读取原始字符串参数,适合单文件或临时小工具;而在需要规范交互、选项名称(如 --output、-v)、类型转换和帮助文档的生产场景中,推荐使用标准库内置的 argparse 模块。本文将从底层分词规则出发,完整拆解这两种方式的操作步骤、代码编写与常见踩坑细节。
一、命令行参数的传递原理与 sys.argv 直读法
当我们在终端中键入命令(如 python main.py data.csv 100)并回车时,操作系统或 Shell(如 Bash、Zsh、PowerShell)会先以空格为分隔符将这行输入拆分成多个独立的片段(Token)。随后,Python 解释器启动并将这些片段打包放入标准库 sys 模块的 sys.argv 列表中。
在 sys.argv 结构中:
sys.argv[0]固定表示当前执行的脚本名称或文件路径。sys.argv[1]开始才是用户在脚本名后传入的第一个实际参数。- 所有捕获到的参数在 Python 中一律以字符串(str)形式存在,即便输入的是数字。
1. sys.argv 的基础编写示例
创建文件 quick_calc.py,编写如下代码:
import sys

# 打印接收到的完整参数列表
print(f"完整参数列表 sys.argv: {sys.argv}")
print(f"脚本名称: {sys.argv[0]}")

# 检查用户是否传递了足够的参数,防止下标越界
if len(sys.argv) < 3:
    print("用法提示: python quick_calc.py <数字A> <数字B>")
    sys.exit(1)

# 注意:sys.argv 中的元素是字符串,必须显式转换为数字
num1 = float(sys.argv[1])
num2 = float(sys.argv[2])

print(f"计算结果: {num1} + {num2} = {num1 + num2}")
2. 命令行执行与输出
在终端中执行并传递两个数字参数:
# 示例命令
$ python quick_calc.py 12 8.5

# 示例输出
完整参数列表 sys.argv: ['quick_calc.py', '12', '8.5']
脚本名称: quick_calc.py
计算结果: 12.0 + 8.5 = 20.5
如果参数本身包含空格,例如文件名 sales 2026.csv,直接写空格会被 Shell 误当成两个参数。此时必须用英文双引号包裹:
$ python quick_calc.py "sales 2026.csv" "backup dir"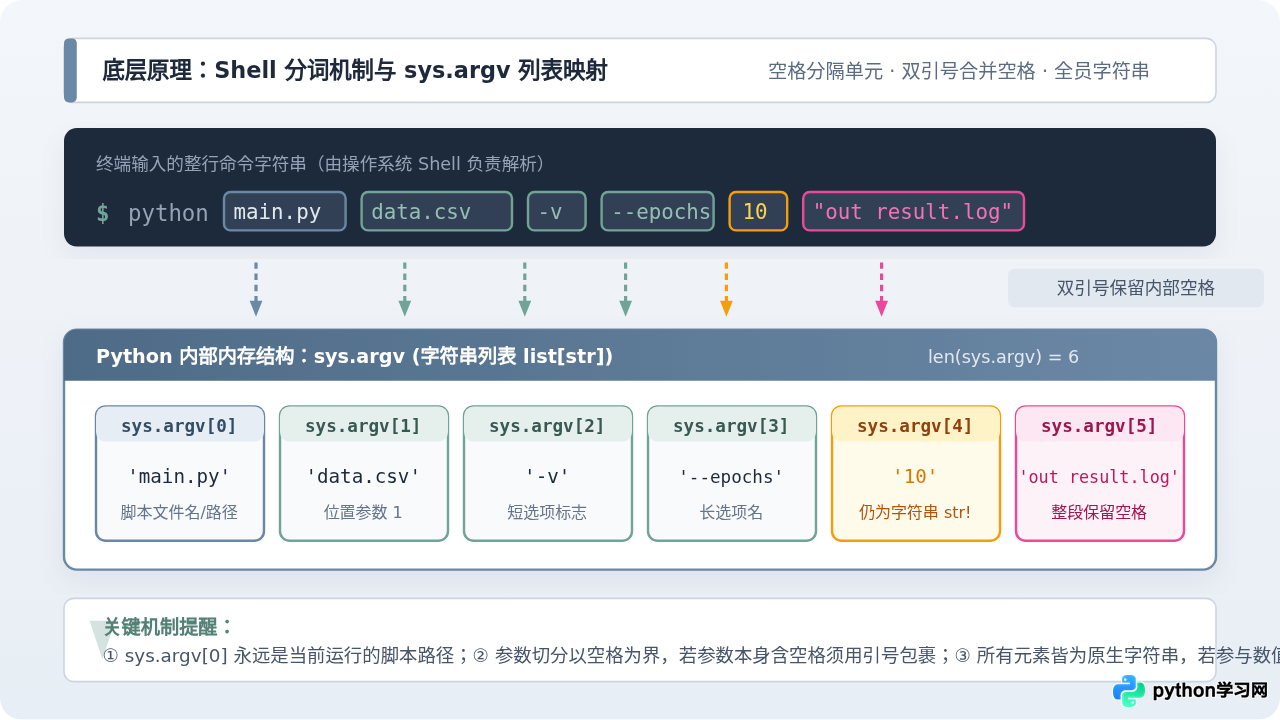
sys.argv 仅按顺序保存字符串,它不支持可选标志(如 -h)、无法自动校验数据类型、也不会自动生成使用帮助。当参数超过两个或需要选填参数时,编写分支判断会非常繁琐,此时应当采用下一节的 argparse。
二、标准化传参方案:使用 argparse 模块
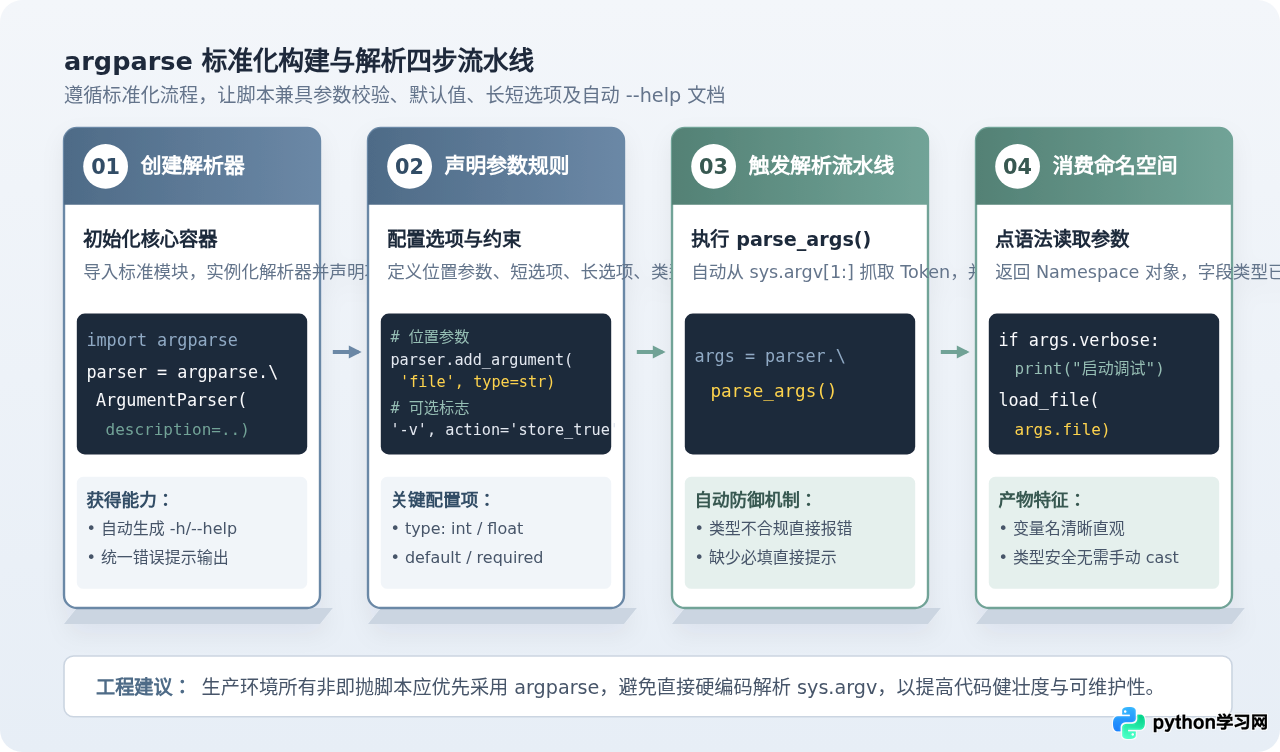
Python 标准库内置的 argparse 模块是处理命令行参数的官方推荐工具。它支持位置参数、长短可选参数(如 -o 和 --output)、指定默认值、限定取值范围,并在用户输入错误或附带 -h/--help 时自动打印规范的使用文档。
1. 编写 argparse 的标准四步流程
- 导入并创建解析器:通过
argparse.ArgumentParser()创建对象,并填写脚本功能描述。 - 添加参数定义:使用
add_argument()配置每个参数的名称、类型、默认值与帮助说明。 - 触发解析:调用
parser.parse_args(),模块会自动从命令行读取并完成类型校验。 - 使用参数:通过
args.参数名访问已处理好的属性,直接在业务逻辑中使用。
2. 完整实战代码
新建 process_data.py 文件,涵盖位置参数、值选项、布尔开关及类型转换:
import argparse

def main():
    # 步骤 1:创建解析器
    parser = argparse.ArgumentParser(
        prog="process_data",
        description="用于演示命令行参数接收与类型解析的数据处理工具"
    )

    # 步骤 2:添加参数规则
    # 规则 A:位置参数(必填项,无横线前缀)
    parser.add_argument(
        "filename",
        type=str,
        help="待处理的目标数据文件路径"
    )

    # 规则 B:可选值参数(长短选项,带默认值与类型转换)
    parser.add_argument(
        "-l", "--limit",
        type=int,
        default=10,
        help="限制处理的最大行数(默认: 10)"
    )

    # 规则 C:限定选择范围参数
    parser.add_argument(
        "-m", "--mode",
        choices=["fast", "safe", "deep"],
        default="fast",
        help="处理模式,仅支持 fast/safe/deep(默认: fast)"
    )

    # 规则 D:布尔开关(标志存在即为 True,不存在为 False)
    parser.add_argument(
        "-v", "--verbose",
        action="store_true",
        help="是否开启详细日志输出"
    )

    # 步骤 3:执行参数解析
    args = parser.parse_args()

    # 步骤 4:直接使用属性
    print("=== 参数解析成功 ===")
    print(f"目标文件: {args.filename} (类型: {type(args.filename).__name__})")
    print(f"处理行数: {args.limit} (类型: {type(args.limit).__name__})")
    print(f"执行模式: {args.mode}")
    print(f"详细日志: {args.verbose}")

if __name__ == "__main__":
    main()
3. 常见执行方式与输出效果
场景 A:使用默认值运行
# 示例命令:仅传入必填的位置参数
$ python process_data.py dataset.csv

# 示例输出
=== 参数解析成功 ===
目标文件: dataset.csv (类型: str)
处理行数: 10 (类型: int)
执行模式: fast
详细日志: False
场景 B:传入完整选项与布尔标志
# 示例命令
$ python process_data.py dataset.csv --limit 50 --mode safe -v

# 示例输出
=== 参数解析成功 ===
目标文件: dataset.csv (类型: str)
处理行数: 50 (类型: int)
执行模式: safe
详细日志: True
场景 C:查看自动生成的帮助文档
$ python process_data.py --help

# 示例输出
usage: process_data [-h] [-l LIMIT] [-m {fast,safe,deep}] [-v] filename

用于演示命令行参数接收与类型解析的数据处理工具

positional arguments:
  filename              待处理的目标数据文件路径

options:
  -h, --help            show this help message and exit
  -l LIMIT, --limit LIMIT
                        限制处理的最大行数(默认: 10)
  -m {fast,safe,deep}, --mode {fast,safe,deep}
                        处理模式,仅支持 fast/safe/deep(默认: fast)
  -v, --verbose         是否开启详细日志输出
场景 D:参数类型或取值不合法时的自动拦截
若将 --limit 传成了非数字(如 abc),或 --mode 传了未允许的取值,argparse 会在进入业务逻辑前自动阻断并给出明确提示,无需开发者手写异常捕获:
$ python process_data.py dataset.csv --limit abc

# 示例输出
usage: process_data [-h] [-l LIMIT] [-m {fast,safe,deep}] [-v] filename
process_data: error: argument -l/--limit: invalid int value: 'abc'
三、技术选型:sys.argv、argparse 与第三方库对比
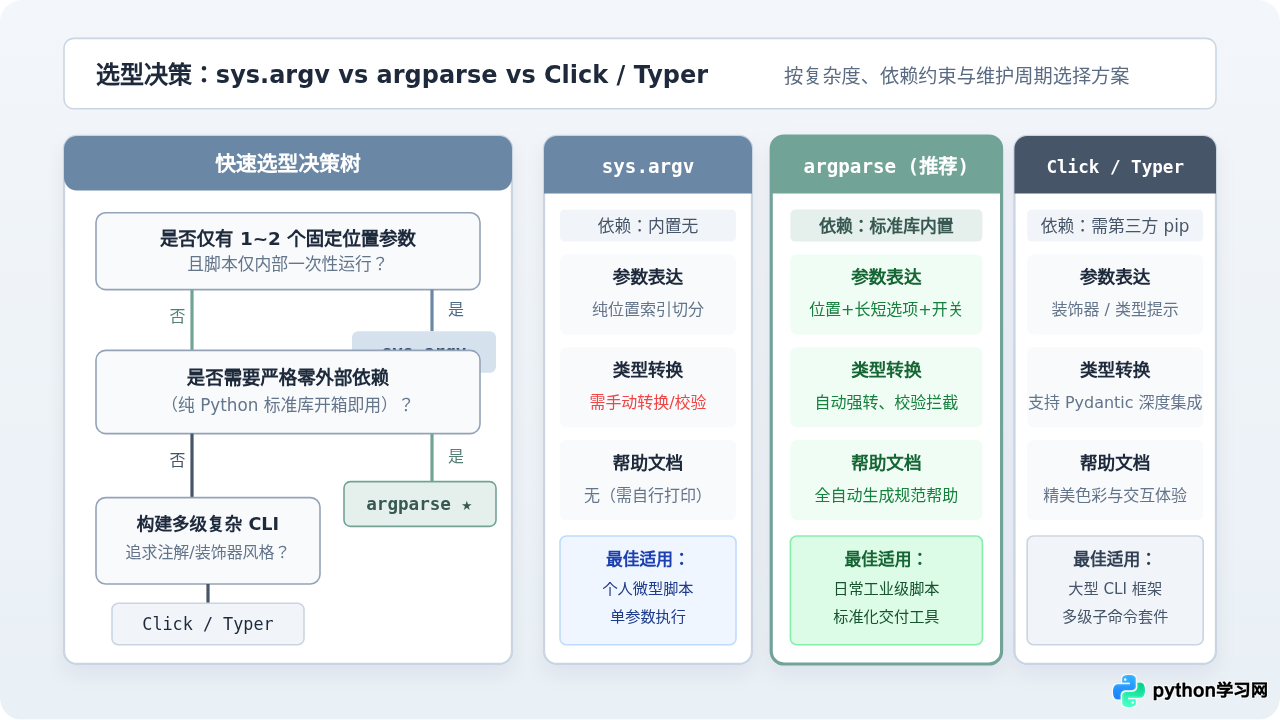
在实际开发中,根据脚本的体量、调用频率和使用者群体不同,参数传递方案的选择也有所区别:
- sys.argv:零依赖、执行极快。适合只有 1 到 2 个参数、仅供开发者个人在受控环境中快速触发的辅助脚本。
- argparse:Python 标准库预装,无外部依赖,功能覆盖工业级选项解析、类型断言与帮助文档。适合绝大多数团队协作、自动化调度流水线及对外分发的工具脚本。
- Click / Typer:需额外通过
pip install安装。采用函数装饰器或类型注解驱动,适合构建包含多级嵌套子命令(如类似git commit、docker compose up)的大型命令行工程。
四、命令行传参的关键细节与常见排错
1. 陷阱一:参数类型默认为字符串,数值计算变字符拼接
无论是 sys.argv 还是没有声明 type 的 argparse,获取到的参数值都是 str。如果直接对它们执行加法运算:
# 错误示例
a = sys.argv[1]  # 传入 "10"
b = sys.argv[2]  # 传入 "20"
print(a + b) # 输出结果为 "1020" 而不是 30解决方法:在使用 sys.argv 时手动调用 int(a) + int(b);在使用 argparse 时显式配置 type=int 或 type=float。
2. 陷阱二:布尔选项不能声明为 type=bool
很多初学者在 argparse 中写出 parser.add_argument("--flag", type=bool),并期望命令行传入 --flag False 能变成布尔值 False。但在 Python 中,内置的 bool("False") 结果仍然是 True(因为非空字符串的布尔值均为 True)。
action="store_true";如果必须从命令行显式指定 true 或 false,应使用自定义转换函数或在 Python 3.9+ 中使用 action=argparse.BooleanOptionalAction。
3. 陷阱三:传入负数被误判为未知选项
当脚本需要接收一个负数作为位置参数时(如 -5),解析器常会把开头的负号误当作命令行选项(flag),从而抛出 unrecognized arguments: -5 错误。
解决方法:在命令行中借助双横线分隔符 --,告诉 Shell 和解析器其后的所有输入均作为纯参数处理:
# 正确命令示范
$ python calculate.py -- -5 10
4. 陷阱四:传递带空格或特殊符号的路径
在 Windows 或 macOS 文件路径中若包含空格(如 My Documents/data.csv),命令行会以空格为界拆为两个参数,导致 sys.argv 长度增加或解析器报错。
解决方法:始终在路径两侧添加成对的双引号 "My Documents/data.csv"。
五、常用传参模式速查与总结
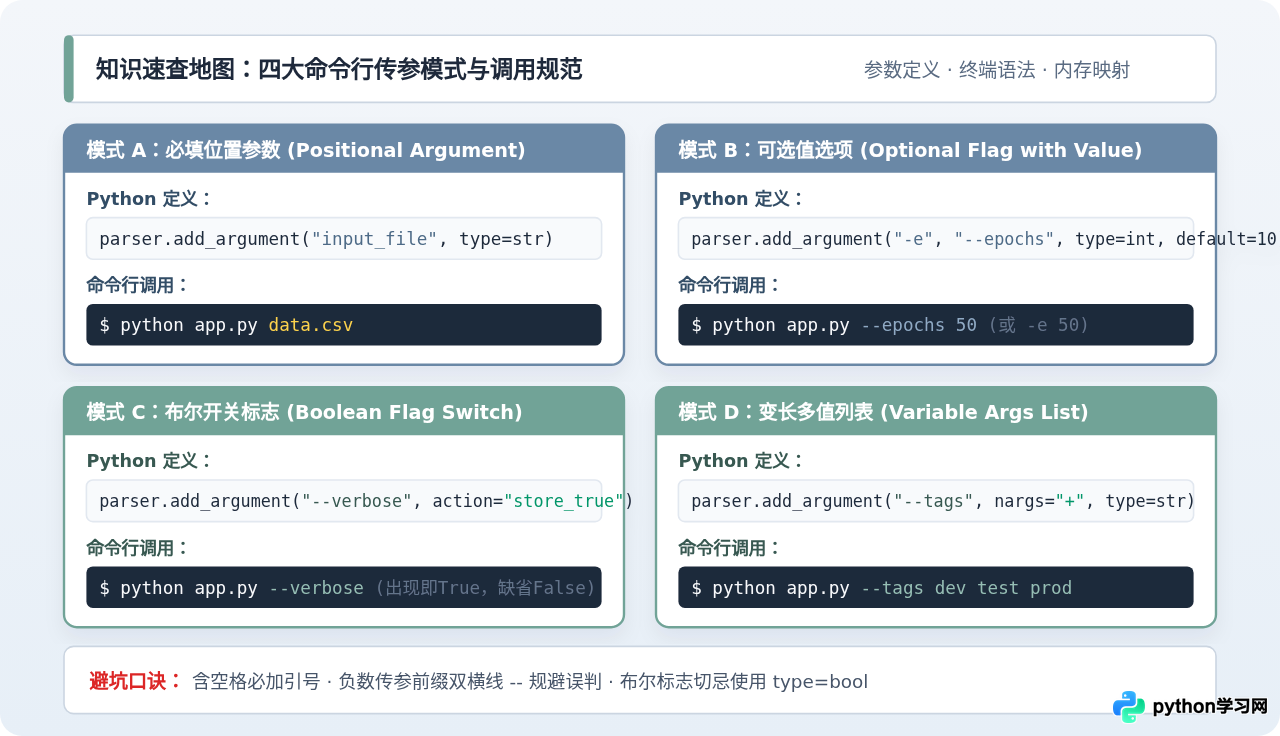
为了方便日常开发查阅,下表整理了 argparse 中最常用的四种传参模式定义与命令行调用形态:
| 参数模式 | Python 代码声明 | 终端调用示例 | 解析后取得的值 |
|---|---|---|---|
| 必填位置参数 | parser.add_argument("src") |
python app.py in.txt |
args.src = "in.txt" |
| 数值选项 (带默认值) | parser.add_argument("-n", type=int, default=1) |
python app.py -n 5 |
args.n = 5 (缺省为 1) |
| 布尔开关 (存在即真) | parser.add_argument("-v", action="store_true") |
python app.py -v |
args.v = True (缺省为 False) |
| 接收多值列表 | parser.add_argument("--files", nargs="+") |
python app.py --files a.txt b.txt |
args.files = ['a.txt', 'b.txt'] |
总结:向 Python 脚本传递命令行参数是脚本化和工具化开发的基本功。对于临时验证或单行调用,利用 sys.argv 可以以最少代码完成读取;对于需要长期维护、对外提供选项或供定时任务调度的标准脚本,采用 argparse 则能提供类型安全、默认兜底与规范帮助文档,确保程序稳定可靠。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















