


Python深浅拷贝的区别:内存引用与数据修改影响解析
深入解析Python中赋值、浅拷贝与深拷贝的核心差异,通过内存引用图解、id地址追踪及真实代码示例,系统阐述嵌套数据修改的影响与避坑指南。
custom_config = default_config.copy(),并修改了其中的数据库端口 custom_config["database"]["port"] = 5432。令人困惑的是,原本作为基准的 default_config["database"]["port"] 也变成了 5432。这种由于复制方式选择不当导致原数据被隐式篡改的现象,根源在于 Python 独特的“变量-引用”对象模型。本文将从内存引用结构入手,系统解析赋值、浅拷贝与深拷贝的底层差异,并阐明修改不同层级数据时产生的深远影响。
一、内存引用的本质:变量只是对象的标签
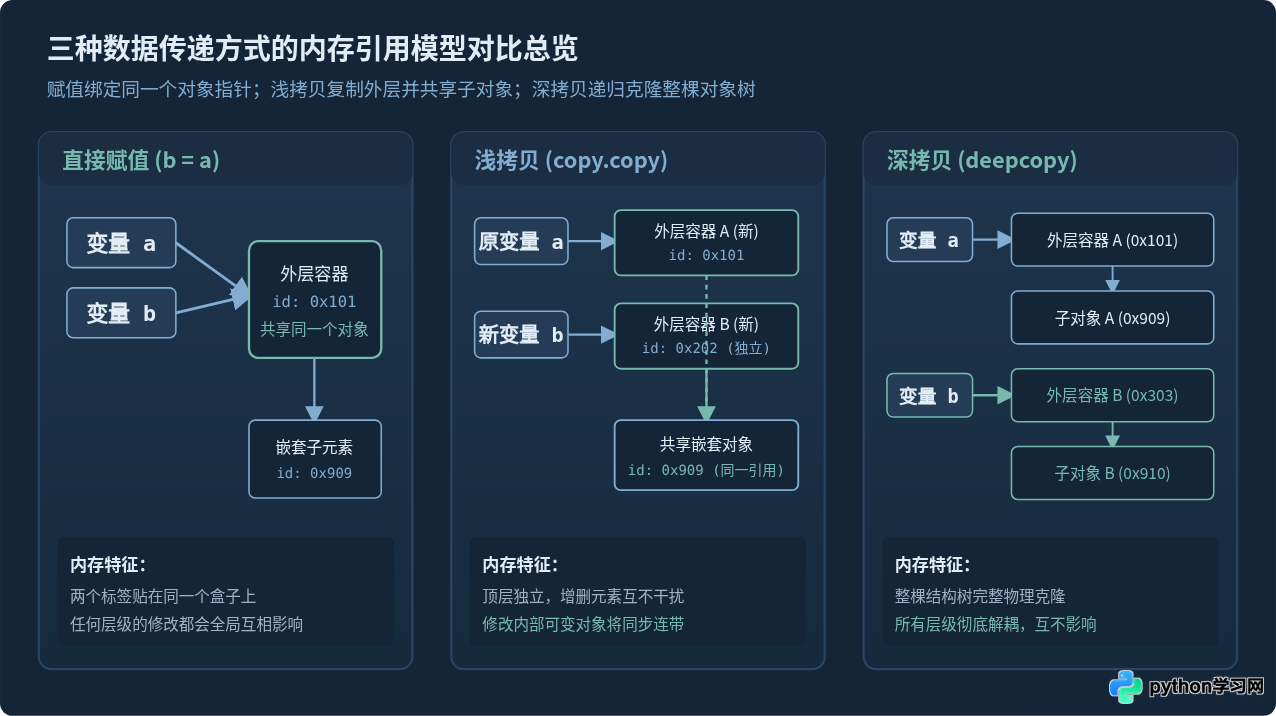
要搞清深浅拷贝的差异,首先必须摒弃传统 C/C++ 中“变量即内存存储空间”的旧观念。在 Python 中,万物皆对象。我们在代码中书写的变量名,本质上只是指向实际内存中某个对象的引用标签(Pointer / Reference)。
当执行 a = [1, 2, [3, 4]] 时,Python 解释器在内存堆空间开辟了一块地址来存放外层列表容器,这个外层列表内部又保存了指向数字 1、数字 2 以及内层嵌套列表 [3, 4] 的内存引用指针。变量名 a 仅仅持有了这个外层列表对象的首地址。
通过内置函数 id(),我们可以获取对象在内存中的唯一虚拟地址;通过操作符 is,可以判断两个变量是否指向完全相同的同一块内存空间(即 a is b 等价于 id(a) == id(b))。
# 示例 1:直接赋值的行为检验
original = [10, 20, [30, 40]]
assigned = original

print("original id:", hex(id(original)))
print("assigned id:", hex(id(assigned)))
print("是否同一对象:", original is assigned)

# 修改 assigned 的元素
assigned[0] = 99
assigned[2].append(50)

print("original 变动后:", original)
print("assigned 变动后:", assigned)
# 示例输出:
original id: 0x7fa2c00a1240
assigned id: 0x7fa2c00a1240
是否同一对象: True
original 变动后: [99, 20, [30, 40, 50]]
assigned 变动后: [99, 20, [30, 40, 50]]从输出中可以看到,直接赋值 assigned = original 根本没有创建新对象,只是给内存地址 0x7fa2c00a1240 贴上了一个名为 assigned 的别名标签。对任何层级的修改都会直接反映到双方。
二、浅拷贝的机制与内存共享陷阱
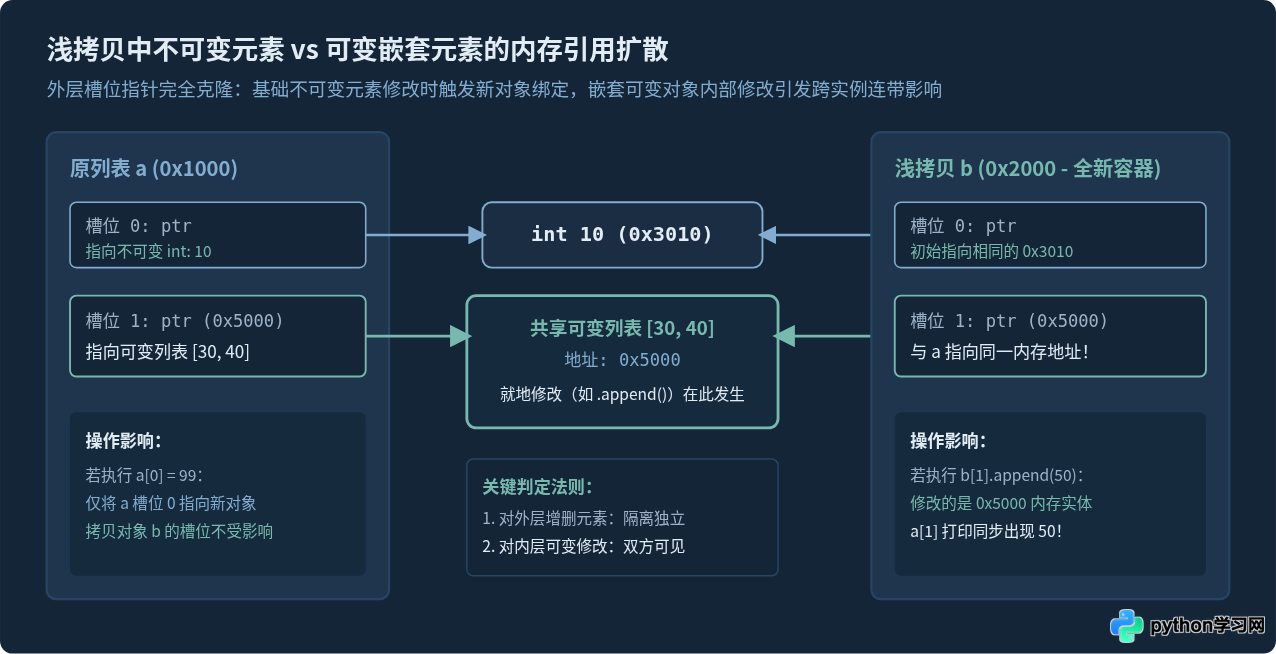
所谓浅拷贝(Shallow Copy),是指创建一个全新的外层容器对象,但对于容器内部包含的各个元素,只复制它们的引用指针,并不复制元素本身所代表的下层对象。
在 Python 中,触发浅拷贝的常见语法包括:
- 使用切片操作符:
b = a[:] - 容器类型的工厂函数:
b = list(a)或b = dict(d) - 容器自身提供的方法:
b = a.copy() - 标准库模块函数:
import copy; b = copy.copy(a)
代码实操:验证浅拷贝的隔离边界
我们可以编写一段明确的代码,同时检验“顶层修改”与“内层修改”对浅拷贝产生的不同效果:
import copy

# 初始数据:包含基本不可变数据与内层可变列表
source = [100, [200, 300]]
shallow = copy.copy(source)

print("外层容器比较:", source is shallow)           # False,说明容器已新建
print("内层对象比较:", source[1] is shallow[1])     # True,说明内层引用共享

# 1. 尝试修改外层元素(赋值新数字)
shallow[0] = 999
print("--- 修改 shallow[0] 后 ---")
print("source :", source)   # [100, [200, 300]] -> 原数据不受影响
print("shallow:", shallow)  # [999, [200, 300]]

# 2. 尝试向外层容器添加新元素
shallow.append(400)
print("--- 执行 shallow.append(400) 后 ---")
print("source :", source)   # [100, [200, 300]] -> 原数据不受影响
print("shallow:", shallow)  # [999, [200, 300], 400]

# 3. 尝试就地修改内层可变列表
shallow[1].append(350)
print("--- 执行 shallow[1].append(350) 后 ---")
print("source :", source)   # [100, [200, 300, 350]] -> 灾难:原数据被连带篡改!
print("shallow:", shallow) # [999, [200, 300, 350], 400]int、float、str 等不可变对象)时,浅拷贝才是完全安全的。一旦数据结构中存在任何嵌套的可变类型(如嵌套 list、dict 或自定义类实例),浅拷贝就无法提供修改隔离保障。
三、深拷贝的工作原理:递归复制与 Memo 备忘录机制
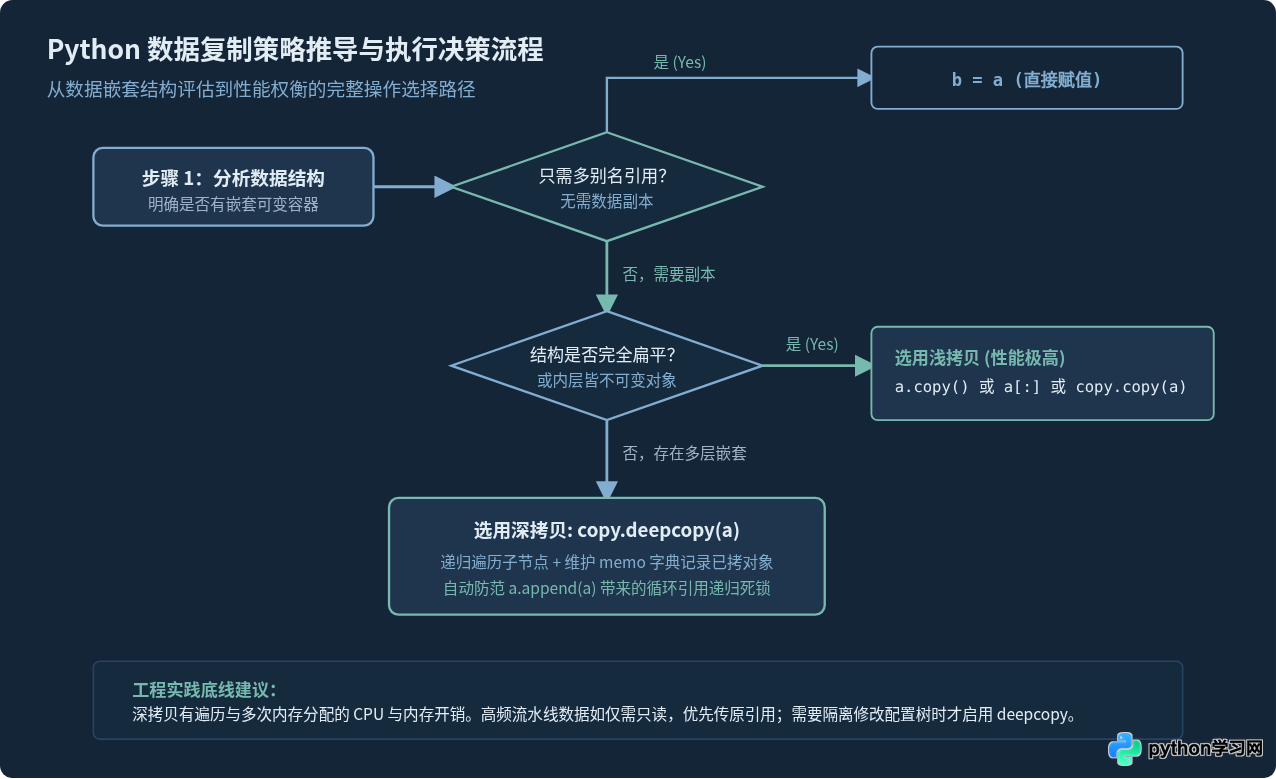
当需要完全脱离原对象、实现多层级数据的彻底隔离时,必须使用深拷贝(Deep Copy)。在 Python 中通过标准库的 copy.deepcopy() 实现。
copy.deepcopy() 的核心处理逻辑可归纳为以下几步:
- 类型判定:检查当前对象是否为不可变基础类型(如数值、纯不可变元组)。如果是,直接返回当前对象的引用,以节省内存空间。
- 新建实体:若当前对象是复合容器(如列表、字典、自定义类),则通过反射创建相同类型的全新空白实例。
- 递归遍历:递归遍历原对象包含的所有子元素或属性,依次对每个子元素调用
deepcopy,并将复制后的新子对象填充到新容器中。 - Memo 字典防环:这是深拷贝中最关键的工程实现细节。为了避免循环引用(Circular Reference)导致无限递归溢出,
deepcopy内部维护了一个名为memo的字典,键为对象的原内存地址id(obj),值为已经克隆出的新对象引用。每次克隆前先查询memo,若已存在则直接返回映射结果。
循环引用的深拷贝实测
如果对象自身引用了自己,浅拷贝或者朴素的递归函数会导致递归栈溢出,而 deepcopy 能够优雅应对:
import copy

# 构建一个循环引用的列表结构
circular_list = [1, 2]
circular_list.append(circular_list)

print("原列表长度:", len(circular_list))
print("最后一个元素指向自身:", circular_list[2] is circular_list)

# 进行深拷贝
cloned_list = copy.deepcopy(circular_list)

print("克隆后是否为新容器:", cloned_list is circular_list)
print("克隆内部循环引用指向:", cloned_list[2] is cloned_list)
print("克隆内部是否还指向原列表:", cloned_list[2] is circular_list)
# 示例输出:
原列表长度: 3
最后一个元素指向自身: True
克隆后是否为新容器: False
克隆内部循环引用指向: True
克隆内部是否还指向原列表: False输出证明,copy.deepcopy() 不仅完整隔离了新旧对象树,而且准确恢复了对象内部原有的环状拓扑结构,没有陷入死循环。
四、常见开发陷阱与数据修改影响解析
陷阱 1:列表乘法创建二维数组的浅引用灾难
在日常开发或算法刷题中,很多初学者习惯用乘法初始化二维矩阵:
# 错误写法:
matrix = [[0] * 3] * 3
matrix[0][0] = 7
print(matrix)
# 示例输出: [[7, 0, 0], [7, 0, 0], [7, 0, 0]]原因解析:乘法 [sub_list] * 3 并没有把 sub_list 复制 3 份独立的对象,而是将同一个 sub_list 的内存引用在外部列表中重复存储了 3 次(相当于浅拷贝了 3 个指针)。修改第 0 行,实际上也就是修改第 1 行和第 2 行。
正确写法:使用列表推导式,每次迭代都独立新建一个内部列表实例:
# 正确写法:
matrix = [[0] * 3 for _ in range(3)]
matrix[0][0] = 7
print(matrix)
# 示例输出: [[7, 0, 0], [0, 0, 0], [0, 0, 0]]
陷阱 2:不可变元组中包含可变对象
元组(tuple)本身是不可变类型,但这仅仅指元组内部存储的槽位指针地址不能变更。如果元组中存放了一个列表指针,列表内部的数据依然可以被修改:
tpl = (1, [10, 20])
shallow_tpl = copy.copy(tpl)

# 对不可变元组做浅拷贝,Python 甚至不会生成新元组,而是直接返回原元组
print("tpl is shallow_tpl:", tpl is shallow_tpl)  # True

# 修改元组内部列表
tpl[1].append(30)
print("修改后 tpl:", tpl)                  # (1, [10, 20, 30])
print("修改后 shallow_tpl:", shallow_tpl)  # (1, [10, 20, 30])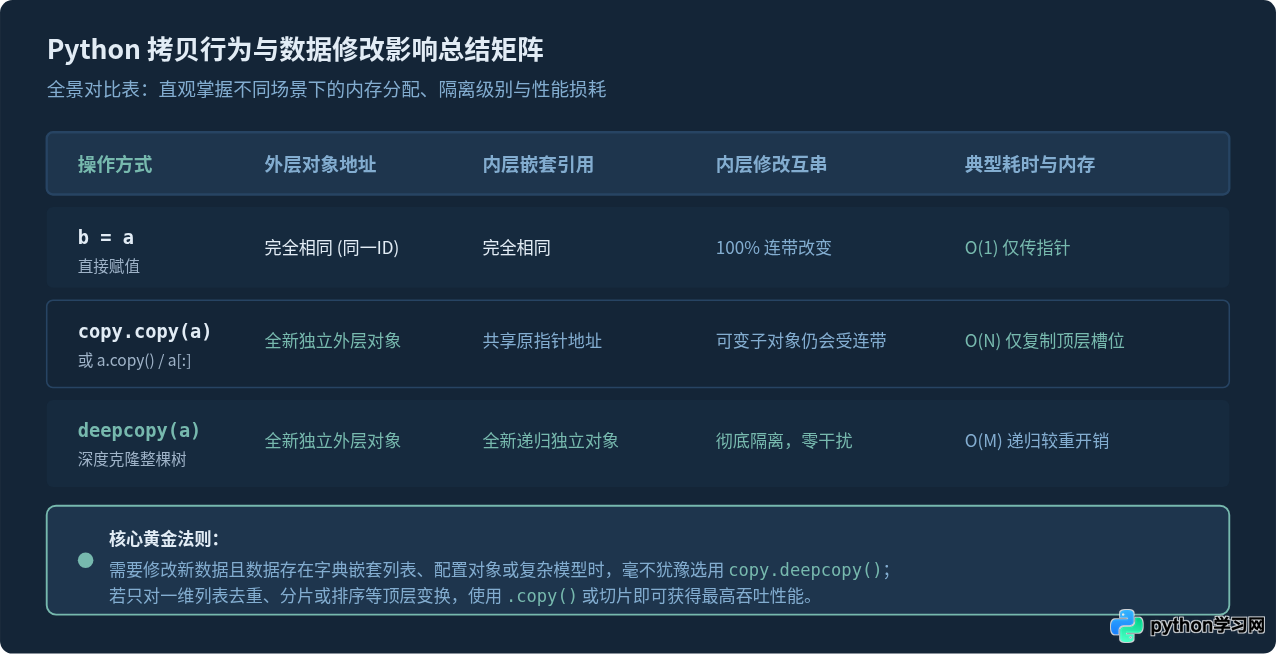
五、总结
理解 Python 深浅拷贝的本质,关键在于牢记“对象引用”在内存中的传递逻辑:
- 直接赋值(
=):不产生新对象,只是对原内存块多贴了一张别名标签。 - 浅拷贝(
copy.copy/ 切片 / 工厂构造):造了一个新盒子(独立的外层容器),但盒子里装的东西依然是原物品的钥匙(内部引用保持一致)。修改盒内第一层元素互不影响,修改深层嵌套内容依然会相互牵连。 - 深拷贝(
copy.deepcopy):递归制作了一个完全相同的新盒子,并且把盒子里的所有物品及其子部件全都 1:1 独立复制了一遍,同时借助备忘录字典从容处理循环引用,达成真正的物理内存彻底隔离。
在工程开发中,根据具体的嵌套层级与修改意图选择合适的数据传递方式,既能杜绝隐蔽的全局数据污染,又能避免不必要的深层复制性能损耗。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















