


Python文件操作与异常处理:安全读写数据的最佳实践
深入解析Python文件操作与异常处理的最佳实践,详解上下文管理器底层机制、显式UTF-8编码规范、精准OSError异常分支捕获,以及利用临时文件与os.replace实现原子写入防损方案。
一、资源管理的基石:上下文管理器与显式编码
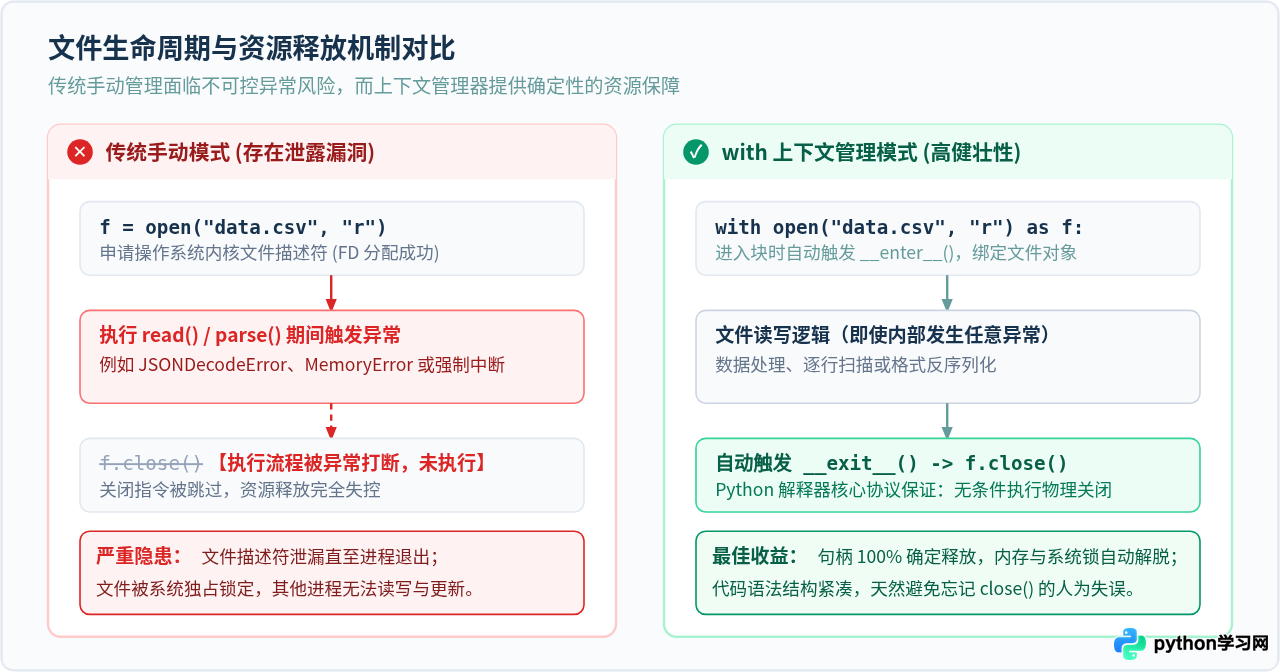
在 Python 中操作文件对象时,最基础但也最致命的失误是使用传统的 open() 并在函数末尾手动调用 f.close()。这种写法在理想逻辑下看似正常,但在真实生产环境中,一旦数据读取、解密、类型转换或格式反序列化过程中发生任何未预料的异常,解释器的执行流会立刻中断并跳转到外层调用栈,使得位于尾部的 f.close() 被彻底跳过。
操作系统对每个进程能够打开的最大文件描述符(File Descriptor,简称 FD)数量有硬性限制(例如 Linux 默认通常为 1024)。在常驻服务或高并发循环任务中,句柄泄漏会迅速耗尽可用描述符,引发 OSError: [Errno 24] Too many open files 故障,最终导致整个系统无法建立网络连接或读取任何新文件。
1.1 with 语句的底层保障机制
解决该问题的现代标准方案是严格采用 with open(...) as f: 语法。Python 的上下文管理器遵循 PEP 343 协议规范:
- 进入
with代码块时,解释器自动触发文件对象的__enter__()方法,获取底层文件系统句柄并将其赋给变量f; - 退出代码块时(无论是正常流转结束、遇到
return、抑或抛出了严重的未捕获异常),解释器均百分之百保证执行__exit__()方法; - 在
__exit__()内部,运行时会自动调用 C 层次的close()函数,清空内存缓冲区并向操作系统交还文件描述符。
# [推荐实践] 规范的上下文管理模式
def load_user_tokens(file_path: str) -> list[str]:
    # with 块保证退出时必定调用 close(),完全消除句柄泄漏
    with open(file_path, mode="r", encoding="utf-8") as f:
        tokens = [line.strip() for line in f if line.strip()]
    return tokens
1.2 跨平台编码陷阱:绝不省略 encoding 参数
另一个极其隐蔽但频繁引发生产事故的隐患是字符编码。许多开发者习惯直接写 open(path, "r") 或 open(path, "w")。如果在不传递 encoding 的情况下打开文本文件,Python 将退化使用操作系统的本地默认编码(由 locale.getpreferredencoding() 决定)。
这会导致严重的“开发环境正常、生产环境崩溃”现象:
- 在现代 Linux 服务器或 macOS 容器中,默认编码通常是
UTF-8; - 在中文简体 Windows 桌面或老旧 Windows Server 环境中,默认编码可能是
GBK或CP936。
当 Windows 上的程序读取 Linux 下生成的 UTF-8 中文日志时,遇到无法解析的多字节序列,会立即抛出 UnicodeDecodeError: 'gbk' codec can't decode byte 0x...。因此,在处理任何文本数据时,必须显式书写 encoding="utf-8"。
errors="replace"(将非法字节替换为问号或占位符)或 errors="ignore"。但在核心业务和账单场景中,应保持默认的 errors="strict",以便第一时间暴露数据损坏。
二、异常处理的最佳实践:精细化捕获与决策分流
在文件 I/O 领域,粗暴的异常捕获往往比没有异常处理更具破坏性。不少初学者或为了图省事,写出如下反面模式代码:
# [严重反面模式] 盲目吞没异常
try:
    with open(filename, "r") as f:
        data = f.read()
except Exception:
    pass  # 极其危险:发生错误时没有任何提示,故障被彻底掩盖
这种写法会无差别地吞掉所有派生自 Exception 的错误。如果代码中存在变量名拼写错误(NameError)、内存超出限制(MemoryError)或数据解析语法错误(json.JSONDecodeError),程序也会静默跳过,留给排查人员一片空白,引发连环数据混乱。
2.1 理解 OSError 体系分支
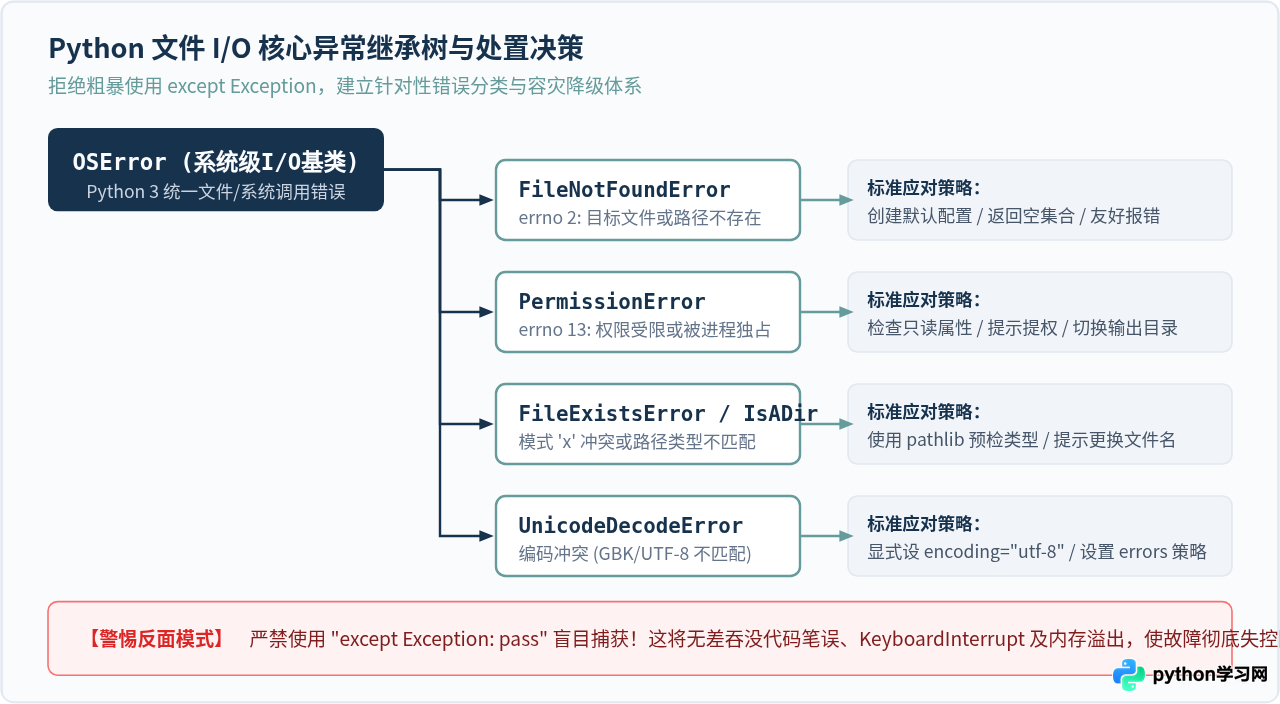
在 Python 3.3 之后,标准库统一整合了操作系统调用相关的异常,全部派生自内置基类 OSError。针对文件读写,最常见的具体异常包括:
| 具体异常类 | 操作系统 Errno 含义 | 典型触发场景 | 建议处置方案 |
|---|---|---|---|
FileNotFoundError |
Errno 2: No such file or directory | 目标路径不存在、文件名大小写错误或软链接失效 | 加载默认初始配置、创建初始空数据或提示检查环境 |
PermissionError |
Errno 13: Permission denied | 当前用户无读写权限、文件被只读保护或被其它进程排他锁定 | 记录报警日志、尝试回退至临时目录或提示运维调整权限 |
IsADirectoryError |
Errno 21: Is a directory | 对目录路径执行了读取或创建文件的文件级操作 | 使用 pathlib.Path.is_file() 预先校验路径类型 |
FileExistsError |
Errno 17: File exists | 使用独占写入模式 open(path, "x") 时目标已存在 |
生成自增后缀名称(如 log_1.txt)或提示用户确认覆盖 |
UnicodeDecodeError |
数据编解码错误 | 文本编码与指定的 encoding 参数不符 |
检查数据源编码、尝试自动识别编码或调整解码容错策略 |
2.2 生产级文件读取与解析范例
在实际业务中,我们应当将文件读写异常与业务解析异常分别捕获,并在发生错误时提供具有诊断意义的上下文日志:
import json
import logging
from pathlib import Path

logger = logging.getLogger(__name__)

def safe_load_app_config(config_path: Path) -> dict:
    """
    安全读取并反序列化 JSON 配置文件
    具备精确异常分支分流与上下文保留机制
    """
    if not isinstance(config_path, Path):
        config_path = Path(config_path)

    try:
        with config_path.open(mode="r", encoding="utf-8") as f:
            return json.load(f)

    except FileNotFoundError:
        logger.warning("配置文件未找到: %s,正在启用系统默认缺省配置", config_path)
        return {"theme": "light", "max_workers": 4, "timeout": 30}

    except PermissionError as err:
        logger.error("权限不足,无法访问配置文件: %s (错误代码: %s)", config_path, err.errno)
        raise  # 权限问题无法自动愈合,应显式向上抛出阻断启动

    except json.JSONDecodeError as err:
        logger.error("配置文件格式损坏,第 %s 行第 %s 列解析失败: %s",
                     err.lineno, err.colno, err.msg)
        raise ValueError(f"配置解析失败: {config_path.name} 语法不合法") from err

    except OSError as err:
        logger.error("读取文件遭遇未预期的底层 I/O 故障: %s", err)
        raise
三、高阶安全写入:原子性操作(Atomic Write)与防损坏
许多人认为,既然写了 with open(target, "w", encoding="utf-8") as f: f.write(content),文件写入就是安全的。这是一种极其危险的误解。
在操作系统底层,当执行 open(target, "w") 的瞬间,系统文件系统会立即执行 truncate(0) 操作——直接把磁盘上已有文件的长度截断清空为 0 字节!如果在这个瞬间,操作系统断电、宿主机宕机、进程由于 Out-Of-Memory 被内核 OOM Killer 强杀,或者新数据序列化时发生了异常,原来的历史文件已经被完全清空,而新数据根本还没写进去。这一事故常被称为生产环境的“零字节清空悲剧”。
3.1 原子写入三要素:同分区临时文件 + 物理落盘 + 原子重命名
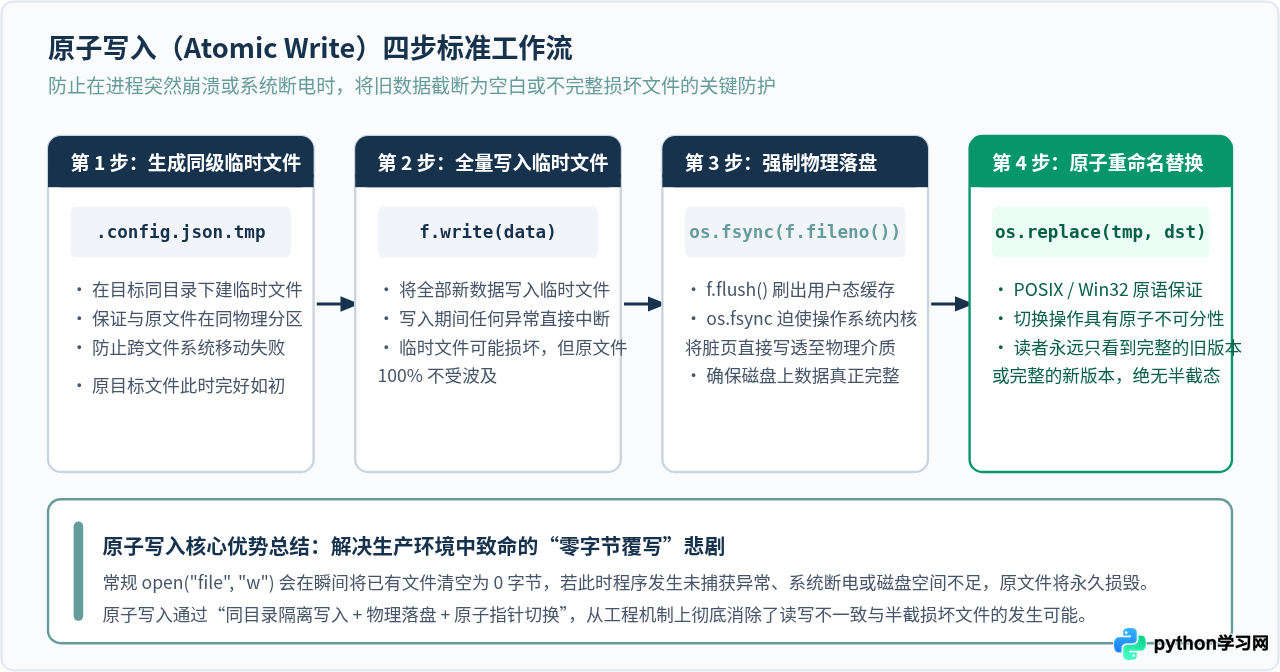
要实现工业级的安全保存,必须采用“原子性写入(Atomic Write)”模式。其核心哲学是:永远不要直接向生产使用的目标路径执行覆写。完整步骤如下:
- 同目录创建临时文件:必须确保临时文件与目标文件在同一个磁盘挂载分区上(通常直接放在目标文件的同级父目录下)。因为绝大多数操作系统(包括 Linux 的 ext4/xfs 和 Windows 的 NTFS)只允许在同文件系统内执行原子目录项替换;若跨分区移动,重命名会退化为“全量复制 + 删除源文件”,从而丧失原子性。
- 全量安全写入:将全部新数据写入该独立临时文件。在此期间如果发生任何中断,损坏的仅仅是一个临时孤儿文件,而原生产文件依然保持上一版本的完整可用状态。
-
强制物理落盘(flush + fsync):常规的
write()仅仅是把数据拷贝到 Python 进程内部缓冲区;调用flush()也仅仅是把数据提交给操作系统的内核页面缓存(Page Cache)。如果此时发生服务器掉电,数据依然会遗失。必须通过os.fsync(f.fileno())强制要求操作系统将脏数据块真正持久化至物理介质(SSD/HDD)。 -
原子重命名替换(os.replace):使用
os.replace(src, dst)。在 POSIX 标准及现代 Windows API 中,该操作在文件系统元数据层面属于原子操作(Atomic Swap)。无论外界怎么读取,外界要么读到旧版本的完整内容,要么读到新版本的完整内容,绝对不存在“半截写入”或“0 字节空文件”的中间状态。
3.2 生产级原子写入通用实现函数
以下是经过严格工程验证的通用原子写入函数,包含临时文件的自动清理与容灾保护:
import os
import tempfile
from pathlib import Path

def atomic_write_text(file_path: Path, content: str, encoding: str = "utf-8") -> None:
    """
    以原子方式将文本数据写入指定路径,杜绝覆写破坏与半截文件

    :param file_path: 目标文件完整路径
    :param content: 要写入的完整字符串内容
    :param encoding: 文本编码,默认严格使用 UTF-8
    """
    file_path = Path(file_path).resolve()
    target_dir = file_path.parent

    # 确保目标目录存在,避免父目录缺失抛出异常
    target_dir.mkdir(parents=True, exist_ok=True)

    # 关键点1: 在目标文件的同级目录下创建临时文件,确保处于同一物理文件系统
    # 使用 NamedTemporaryFile 自动管理临时文件名称生成
    tmp_file = tempfile.NamedTemporaryFile(
        mode="w",
        encoding=encoding,
        dir=target_dir,
        prefix=f".{file_path.name}.",
        suffix=".tmp",
        delete=False  # 手动控制其生命周期,写入成功后再重命名
    )

    tmp_path = Path(tmp_file.name)
    success = False

    try:
        with tmp_file as f:
            f.write(content)
            # 关键点2: 强制由用户态缓冲区刷入操作系统内核
            f.flush()
            # 关键点3: 迫使内核将脏页立刻同步至底层物理磁盘
            os.fsync(f.fileno())

        # 关键点4: 系统级原子替换。在 Windows/Linux 平台均具备原子语义
        os.replace(tmp_path, file_path)
        success = True

    finally:
        # 如果中途任何阶段抛出异常,清除产生的残留临时文件
        if not success and tmp_path.exists():
            try:
                tmp_path.unlink()
            except OSError:
                pass  # 清理失败不影响主异常向上抛出
四、大文件流式读写与内存防御
除了文件被意外截断清空外,另一个高频引发服务崩溃的场景是内存溢出(OOM, Out of Memory)。许多开发者习惯直接使用 f.read() 一次性将全部数据读入内存,或使用 f.readlines() 生成一个包含全部行的巨大列表。
如果处理的是几十兆的常规配置文件,这种写法尚可应付;但当业务日志、交易流水、CSV 报表达到数吉字节(GB)时,一次性读取会使 Python 进程瞬时占满可用物理内存,不仅导致本进程被操作系统强杀,还会引发同节点其他容器的雪崩。
4.1 行流式迭代与固定块(Chunk)处理
Python 文件对象天然实现了迭代器协议(Iterator Protocol)。通过 for line in f: 语法,Python 会使用内部高效的环形缓冲机制,按需按行从磁盘读取并产出字符串,读完当前行即释放对应内存,使内存占用始终恒定在极低水平(仅与最长的一行长度相关,通常不足几千字节)。
# [流式处理最佳实践 1] 逐行过滤与处理大规模文本(内存占用恒定极小)
def filter_error_logs(source_log: Path, output_filtered: Path) -> int:
    matched_count = 0
    # 同时打开输入与输出流,边读边写
    with source_log.open("r", encoding="utf-8") as in_f,          output_filtered.open("w", encoding="utf-8") as out_f:
        for line in in_f:  # 惰性迭代器,无需全量载入
            if "ERROR" in line or "CRITICAL" in line:
                out_f.write(line)
                matched_count += 1
    return matched_count
对于非以换行符分隔的二进制文件(如大型图像、音视频、压缩包或序列化数据库分片),则应使用固定大小的缓冲区进行分块(Chunk)读写:
# [流式处理最佳实践 2] 分块读写二进制数据
def copy_binary_large_file(src: Path, dst: Path, chunk_size: int = 64 * 1024) -> None:
    """以 64KB 为单位分块搬运文件,支持超大尺寸文件的平稳处理"""
    with src.open("rb") as in_f, dst.open("wb") as out_f:
        while True:
            chunk = in_f.read(chunk_size)
            if not chunk:
                break
            out_f.write(chunk)
五、总结:安全文件读写最佳实践矩阵与排查清单
编写高质量、抗风险的 Python 文件操作代码,并非单一维度的技术,而是涵盖语法习惯、异常分类、磁盘原语与内存控制的综合工程。以下自查矩阵汇总了本文讨论的全部核心要点,建议在团队代码评审(Code Review)中作为安全基线落地:
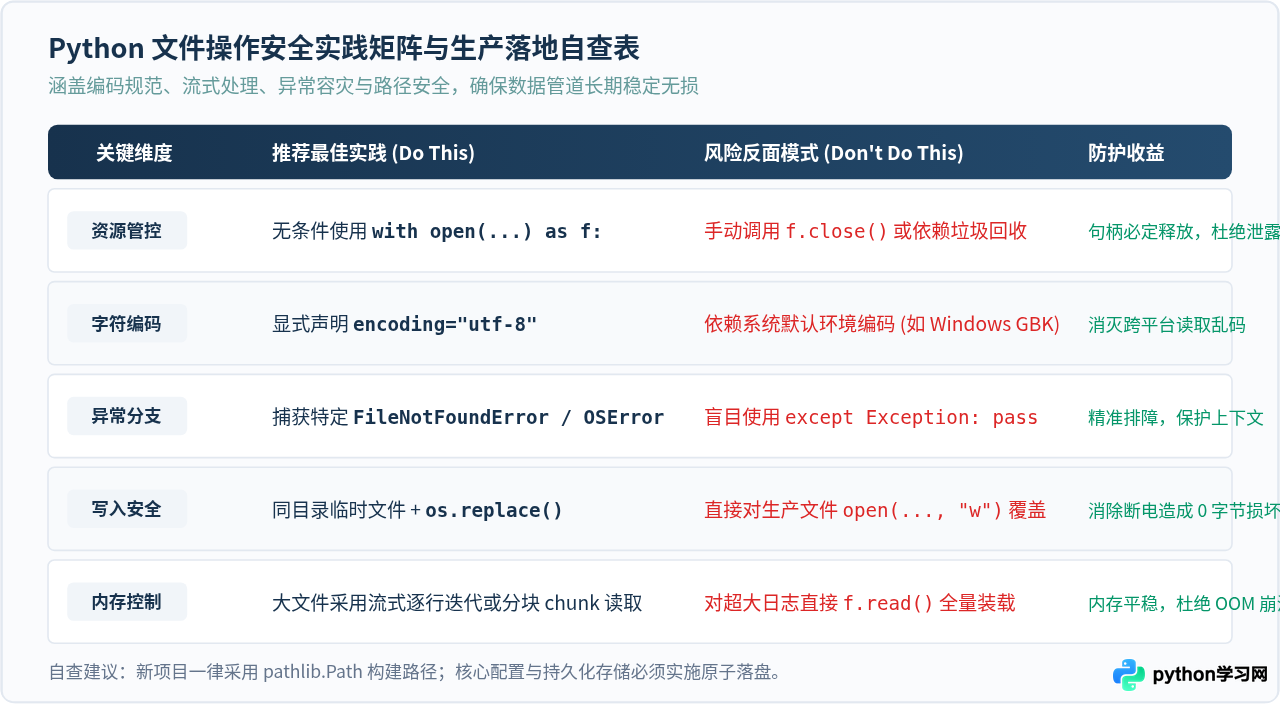
- 全面拥抱 pathlib.Path:优先采用现代面向对象的
Path操作路径,杜绝复杂的os.path.join字符串拼接和跨平台斜杠混淆问题; - 路径安全校验:对外部传入的动态文件名执行
path.resolve()检查,防范../..路径遍历(Path Traversal)安全漏洞; - 读操作必带 with 与 encoding:无论何种文本读写,均显式指定
encoding="utf-8"; - 精准异常分类:有针对性地拦截
FileNotFoundError与PermissionError,记录完备日志,严禁裸写except: pass; - 核心文件原子替换:针对配置文件、数据库状态文件及模型参数,一律采用同目录临时文件 +
os.replace原子写入机制,彻底终结半截文件损坏。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















