


Matplotlib、Seaborn和Plotly:Python绘图库怎么选
深入对比Python三大核心绘图库Matplotlib、Seaborn与Plotly的架构差异、适用场景、代码实现与选型决策树,帮助开发者和数据分析师根据交付媒介与交互需求快速选出最优工具。
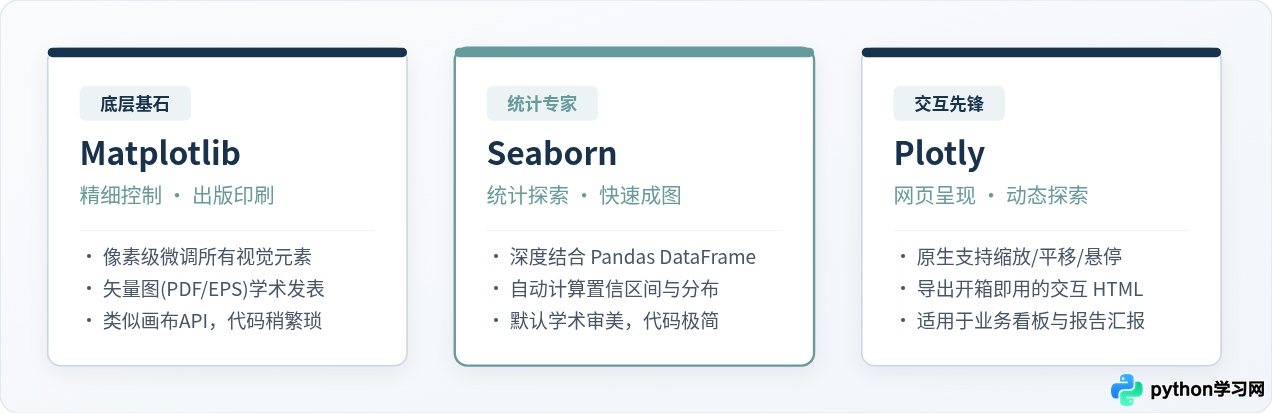
一、底层机制与渲染管线:它们在根本上有何不同
很多开发者习惯以“哪个库更高级”来评价绘图库,但决定工具边界的其实是底层的渲染链路。如果脱离底层的设计目标去选型,往往会在后续定制样式或发布集成时遇到难以逾越的障碍。
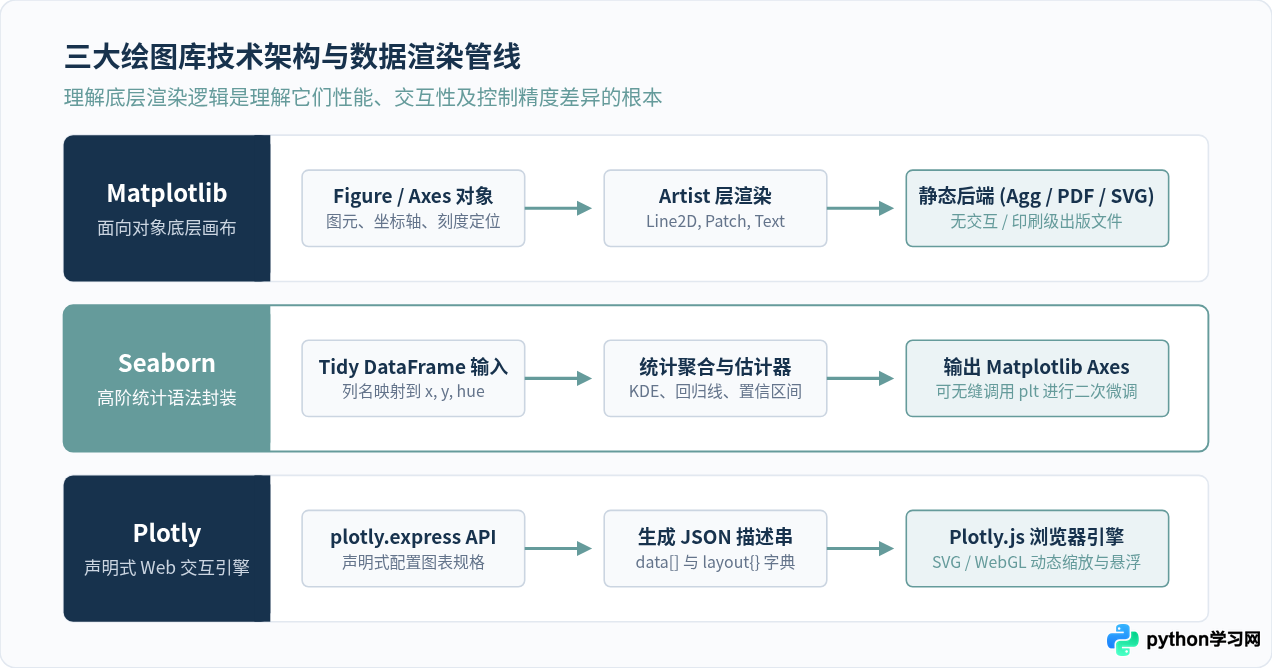
从上面的渲染管线可以清晰看到三者的结构性差异:
-
Matplotlib 的“画布与画笔”模式:
Matplotlib 采用经典的面向对象模型。它构建了层次严密的
Figure(整张图纸)、Axes(独立坐标区)以及各种具体的Artist(折线、文字、几何矩形)。这种设计模仿了传统绘图台,你必须显式指定坐标轴范围、图例锚点和刻度线间距。它的优势在于控制粒度达到极致,且通过静态矢量后端(如 PDF/SVG/Agg)输出,是各大期刊与书籍插图的标准依赖。 -
Seaborn 的“统计语法封装”模式:
Seaborn 是 Matplotlib 的高级门面(Facade)。它的输入高度绑定 Pandas DataFrame 的长表格(Tidy Data),内部集成了均值聚合、核密度估计(KDE)和线性回归等统计计算引擎。在生成图形后,Seaborn 返回的依然是标准的 Matplotlib
Axes或FacetGrid对象。这意味着你既享受了单行代码绘制复杂分布图的敏捷,又能随时用原生的 Matplotlib 语句修饰细节。 -
Plotly 的“声明式 Web 交互”模式:
Plotly 与前两者完全不同,它在 Python 端做的事情本质上是“拼装 JSON 配置数据”。Python 端的
plotly.express只是便捷的 DSL,生成的字典被发送给浏览器前端底层的Plotly.js引擎。因此,它的宿主环境是现代网页、Jupyter Notebook 或独立 HTML 文件,原生拥有 WebGL 加速、实时框选放大(Zoom)、平移(Pan)与动态悬浮信息卡(Hover Tooltip)。
二、实操对比:同一任务在三大库中的代码表现
为了具体感受这三个库的编写体验与思路差异,我们以常见的数据分析场景为例,展示如何分别用这三个库解决具体问题,并指出各自的注意细节。
1. Matplotlib:出版级精细控制与复合排版
当你需要在一张图上叠加两个刻度范围完全不同的指标(例如左轴为销售额,右轴为同比增速),并严格控制网格线透明度和边框留白时,Matplotlib 的面向对象 API 是最可靠的方案。
import matplotlib.pyplot as plt
import numpy as np

# 1. 模拟业务月度数据
months = [f"2026-{m:02d}" for m in range(1, 13)]
revenue = np.array([120, 135, 150, 142, 168, 190, 210, 205, 230, 245, 260, 290])
growth_rate = np.array([5.2, 6.1, 7.8, -2.1, 8.5, 9.2, 11.0, -1.5, 7.3, 6.8, 8.0, 12.4])

# 2. 面向对象创建独立画布与主坐标轴
fig, ax1 = plt.subplots(figsize=(9, 5), dpi=100)

# 3. 绘制主轴柱状图
bars = ax1.bar(months, revenue, color="#17324D", width=0.55, label="月度营收 (万元)")
ax1.set_ylabel("月度营收 (万元)", color="#17324D", fontsize=11)
ax1.tick_params(axis='y', labelcolor="#17324D")
ax1.set_ylim(0, 350)
ax1.grid(axis='y', linestyle='--', alpha=0.3)

# 4. 共享 X 轴创建副坐标轴
ax2 = ax1.twinx()
line = ax2.plot(months, growth_rate, color="#659B9B", marker='o', linewidth=2.5, label="同比增长率 (%)")
ax2.set_ylabel("同比增长率 (%)", color="#659B9B", fontsize=11)
ax2.tick_params(axis='y', labelcolor="#659B9B")
ax2.set_ylim(-5, 16)

# 5. 精细样式与边框隐藏
ax1.spines['top'].set_visible(False)
ax2.spines['top'].set_visible(False)
plt.title("年度经营指标走势 (Matplotlib 双轴精调示例)", fontsize=13, pad=15)
fig.tight_layout()

# 保存为印刷级矢量图
plt.savefig("business_kpi.pdf", format="pdf", bbox_inches="tight")
plt.close()
plt.plot()(状态机接口)与 fig, ax = plt.subplots()(面向对象接口)。在实际工程项目中,始终建议使用面向对象接口,否则在多子图排版与副轴控制时极易发生全局状态污染。
2. Seaborn:多维统计分布探索与快速洞察
在探索性数据分析(EDA)阶段,我们经常需要观察不同类别下连续变量的分布形态与置信区间。如果用 Matplotlib 绘制带置信区间的回归拟合或分面散点,需要手工计算聚合统计量,而 Seaborn 只需映射列名。
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt

# 1. 模拟包含分类和数值特征的 Tidy 数据集
df = pd.DataFrame({
    "ad_spend": [10, 20, 15, 30, 45, 50, 60, 25, 40, 55, 65, 70] * 3,
    "user_conversion": [120, 210, 180, 310, 420, 490, 580, 260, 390, 530, 610, 690] * 3,
    "channel": ["信息流", "搜索竞价", "KOL合作"] * 12
})

# 2. 设置统一样式主题
sns.set_theme(style="whitegrid", palette=["#17324D", "#659B9B", "#D97706"])

# 3. 单行代码实现按渠道分组的线性回归拟合与置信区间带
g = sns.lmplot(
    data=df,
    x="ad_spend",
    y="user_conversion",
    hue="channel",
    aspect=1.6,
    height=5,
    markers=["o", "s", "D"]
)

# 4. 结合 Matplotlib 进行坐标标题强化
g.set_axis_labels("广告投放预算 (万元)", "用户转化总量 (人)")
g.fig.subplots_adjust(top=0.9)
g.fig.suptitle("多渠道投放预算与转化效果拟合 (Seaborn 统计探索)", fontsize=13)

plt.savefig("channel_regression.png", dpi=300)
plt.close()
Seaborn 自动完成了按 channel 分组、计算 95% 置信区间透明阴影带以及绘制图例的所有繁琐工作。在探索阶段,这比编写几十行底层图元代码高效得多。
3. Plotly:现代 Web 交互与业务数据钻取
当图表用于业务月度例会或交付给非技术受众时,观众往往希望把鼠标移到某个点上看具体数值,或者拉动时间滑块放大局部。Plotly 的 plotly.express 模块能够以极简的代码直接输出可交互的 HTML 单文件。
import plotly.express as px
import pandas as pd

# 1. 业务时序与渠道分类数据
df_interactive = pd.DataFrame({
    "date": pd.date_range(start="2026-01-01", periods=20, freq="W"),
    "active_users": [12000, 13400, 14200, 15000, 14800, 16200, 17500, 18200,
                     19100, 18800, 20400, 21500, 22100, 21900, 23500, 24800,
                     25600, 26200, 27100, 28500],
    "region": ["华东", "华北", "华南", "西南"] * 5,
    "bounce_rate": [0.24, 0.22, 0.25, 0.21] * 5
})

# 2. 声明式生成交互式散点折线图
fig = px.line(
    df_interactive,
    x="date",
    y="active_users",
    color="region",
    symbol="region",
    markers=True,
    hover_data=["bounce_rate"],
    title="2026 年区域活跃用户走势 (Plotly 交互呈现)",
    color_discrete_sequence=["#17324D", "#659B9B", "#475569", "#D97706"]
)

# 3. 启用时间轴下方的滑动选择条与白底清爽主题
fig.update_layout(
    xaxis=dict(rangeslider=dict(visible=True), type="date"),
    template="plotly_white",
    hovermode="x unified"
)

# 4. 保存为不依赖本地 Python 环境的独立交互网页
fig.write_html("user_trend_interactive.html", include_plotlyjs="cdn")
生成的 user_trend_interactive.html 可以在任何人的浏览器中直接双击打开,不需要接收方安装 Python,用户能自主点击图例隐藏分类、圈选异常点或平移时间滑块。
三、技术选型决策树:按需定型的判断逻辑
面对具体项目时,不需要纠结谁的功能更强大,按照以下决策路径一步步过滤,结论就会自然呈现:
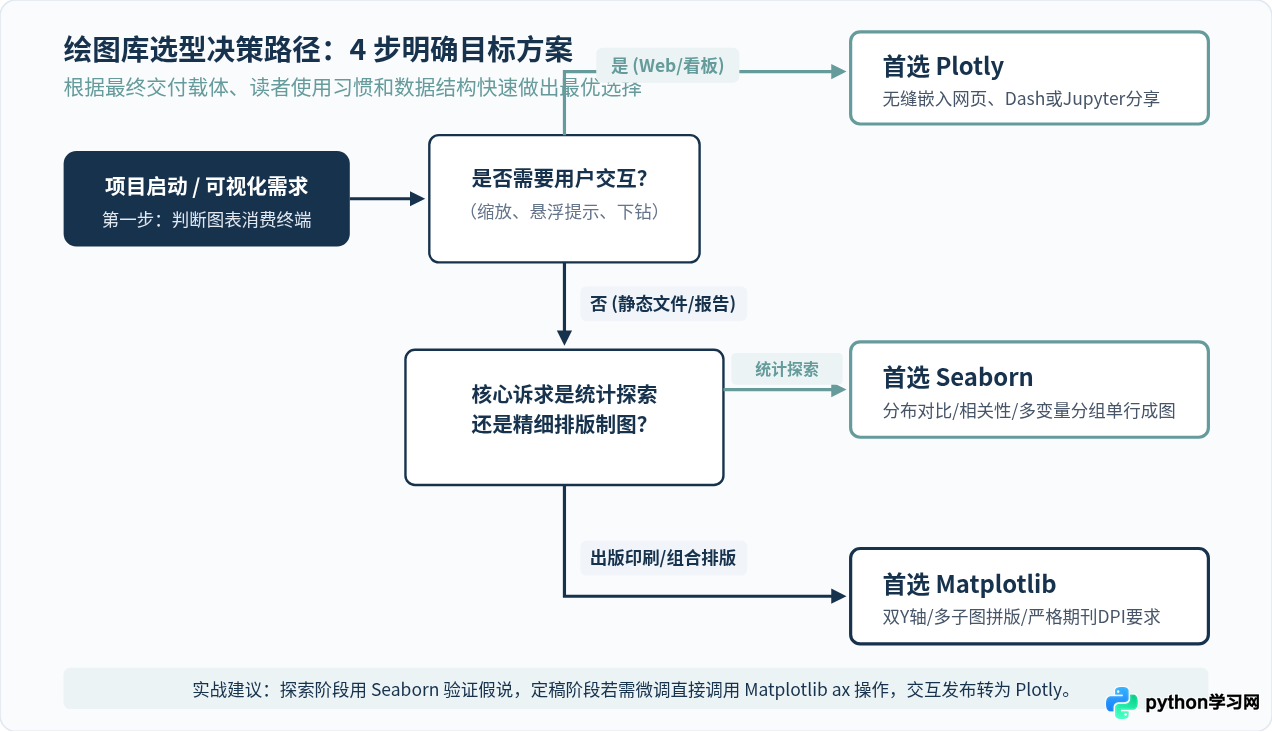
具体评估可以按照以下四个关键问题展开:
- 受众是以什么形式查看图形? 如果最终产物是印刷书籍、Word 报告、学术论文或对页面 DPI/格式有硬性要求的静态 PDF,优先在 Matplotlib/Seaborn 中选择;如果是内部仪表盘、Web 前端应用或发给同事的交互报表,首选 Plotly。
- 是否需要让读者自行探索细节数据? 当图表包含成百上千个散点或密集的股票行情,读者需要悬停看具体价格、放大查看震荡区间时,Plotly 的交互优势无法被静态图取代。反之,如果是总结性静态论据,交互反而会分散读者注意力。
-
数据处于清洗探索阶段还是成品交付阶段?
在数据刚拿到手的 EDA 阶段,核心是速度与认知效率。Seaborn 的
pairplot()、catplot()和heatmap()能在几秒内透视数十个维度的相关性;此时过早投入到 Plotly 调整悬浮格式或 Matplotlib 调坐标轴边距,属于过度优化。 - 是否涉及非标准的复合几何图形? 例如极坐标图、雷达图、复杂的误差棒拼图、双Y轴交叉标注等。这种高度非标的排版需求,在 Seaborn 或 Plotly 中往往缺乏原生配置项,用 Matplotlib 的底层绘图函数定制是最直接的。
四、工程落地:数据可视化的标准四阶段工作流
在成熟的工程与分析项目中,优秀团队极少只绑定一个库,而是让每个工具在它最擅长的阶段发挥价值:
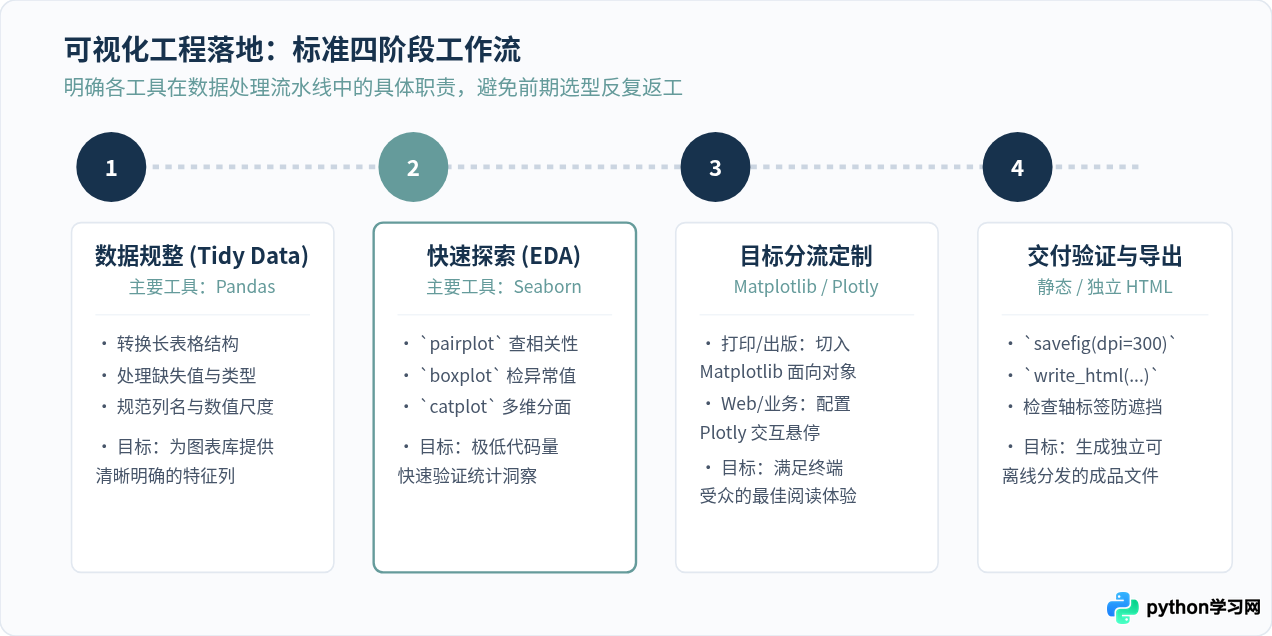
这个流水线包含四个清晰的阶段划分:
-
第一阶段:数据规整(Pandas Tidy Data)
任何优秀可视化的前提都是规范的数据结构。将宽表格用
pd.melt()转换为长表格,确保每一列代表一个明确的变量,每一行代表一个观测对象。这一步奠定了后续向 Seaborn 或 Plotly 快速传参的基础。 -
第二阶段:快速探索(Seaborn 验证)
通过核密度图(
kdeplot)检验分布偏态,通过箱线图(boxplot)定位离群点,通过多子图网格(FacetGrid)对比不同分组。这个阶段代码越短越好,重在验证假设。 - 第三阶段:目标交付分流 确认了要呈现的关键洞察后,依据交付目标分流:学术出版物由 Matplotlib 接管排版,业务 Web 系统由 Plotly 接管交互。
-
第四阶段:交付验证与资产固化
静态图检查文字防遮挡(
tight_layout()或constrained_layout=True),确保导出为矢量图(SVG/PDF)或 300 DPI 位图;交互图检查 CDN 依赖加载稳定性,确保单文件大小可控。
五、综合评测矩阵与总结速查表
为了在日常开发中随时查阅,下表与评测矩阵汇总了三大绘图库的核心技术指标:
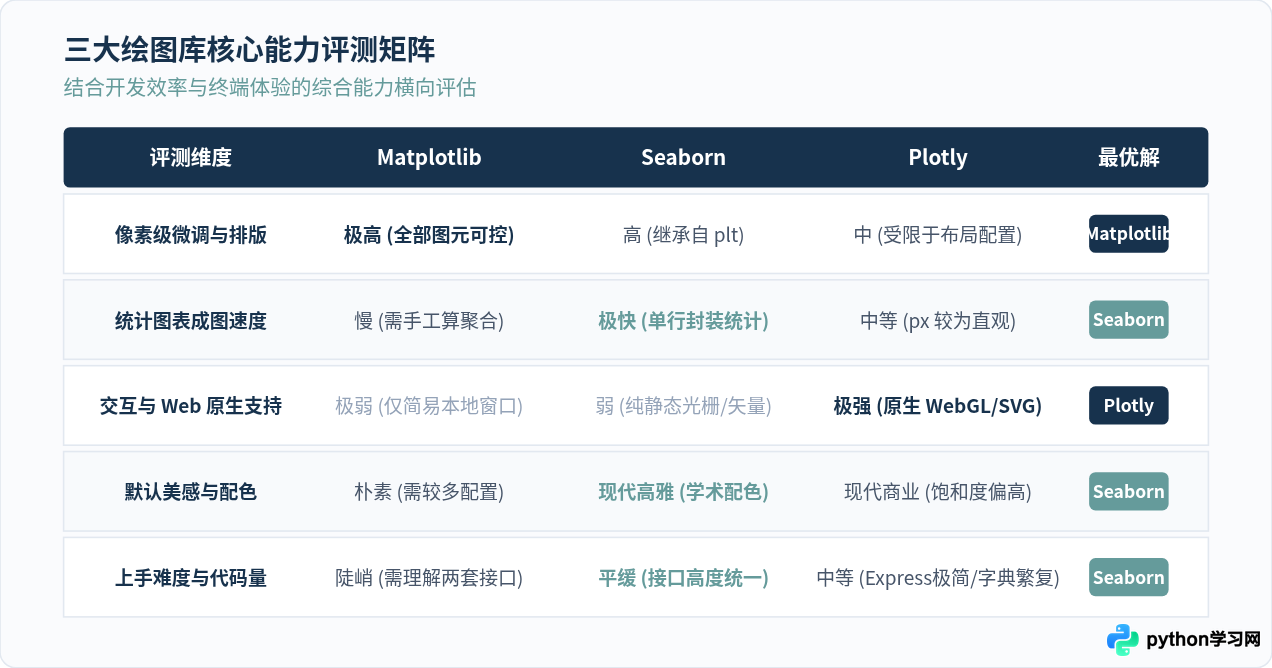
| 对比维度 | Matplotlib | Seaborn | Plotly |
|---|---|---|---|
| 核心设计哲学 | 完全控制的画布画笔 | 面向统计分析的语法门面 | 现代浏览器的声明式交互组件 |
| 与 Pandas 契合度 | 普通,需传纯数组或单列 | 极高,原生深度绑定长表格 | 极高,Express 模块原生契合长表格 |
| 交互能力 | 无(仅提供简易本地 GUI 缩放) | 无(纯静态图) | 极高(原生支持缩放、平移、悬停提示) |
| 输出形式 | PNG, PDF, SVG, EPS | PNG, PDF, SVG, EPS | 交互式 HTML, JSON, 静态图(需kaleido) |
| 单图代码量 | 多(需较多样板代码) | 极少(单行成图) | 中等(Express少,底包多) |
| 学术出版认可度 | 工业标准,学术界首选 | 高(基于 Matplotlib) | 低(主要用于 Web 与业务系统) |
- “要发论文、排版刁钻、双轴拼图” → 坚决使用 Matplotlib;
- “做 EDA、看统计分布、要好看配色不想写长代码” → 坚决使用 Seaborn;
- “做业务大屏、写网页报告、需要鼠标交互查数” → 坚决使用 Plotly。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















