


Python中为什么用元组而不用列表?
深入解析Python中元组与列表的核心差异,从数据安全契约、哈希寻址机制、底层内存布局及设计语义出发,清晰解释为什么在特定场景必须用元组而不用列表。
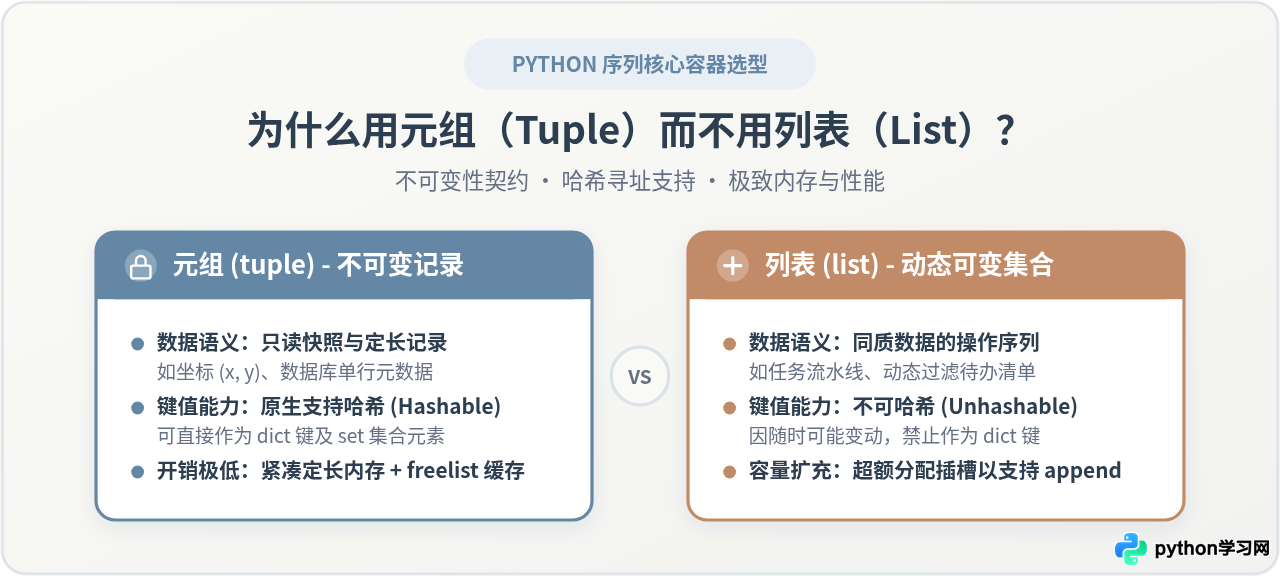
list)功能强大,能够随意追加、插入、删除和修改元素,为什么 Python 还要单独设计一个“不可修改”的元组(tuple)?核心原因在于:元组的不可变性保障了数据安全与明确语义,原生的可哈希性使其能直接充当字典键与集合元素,并且定长紧凑的底层结构带来了更低的内存开销与更高的创建效率。元组与列表并非“功能冗余”,而是各司其职。
一、不可变性:保证数据安全与明确业务语义
在 Python 中,列表是可变对象(Mutable),而元组是不可变对象(Immutable)。很多初学者容易把“不可变”看作一种功能缺陷,但在工业级代码和复杂系统架构中,不可变性其实是一种极其关键的防御性设计。
1. 规避函数调用中的意外“副作用”
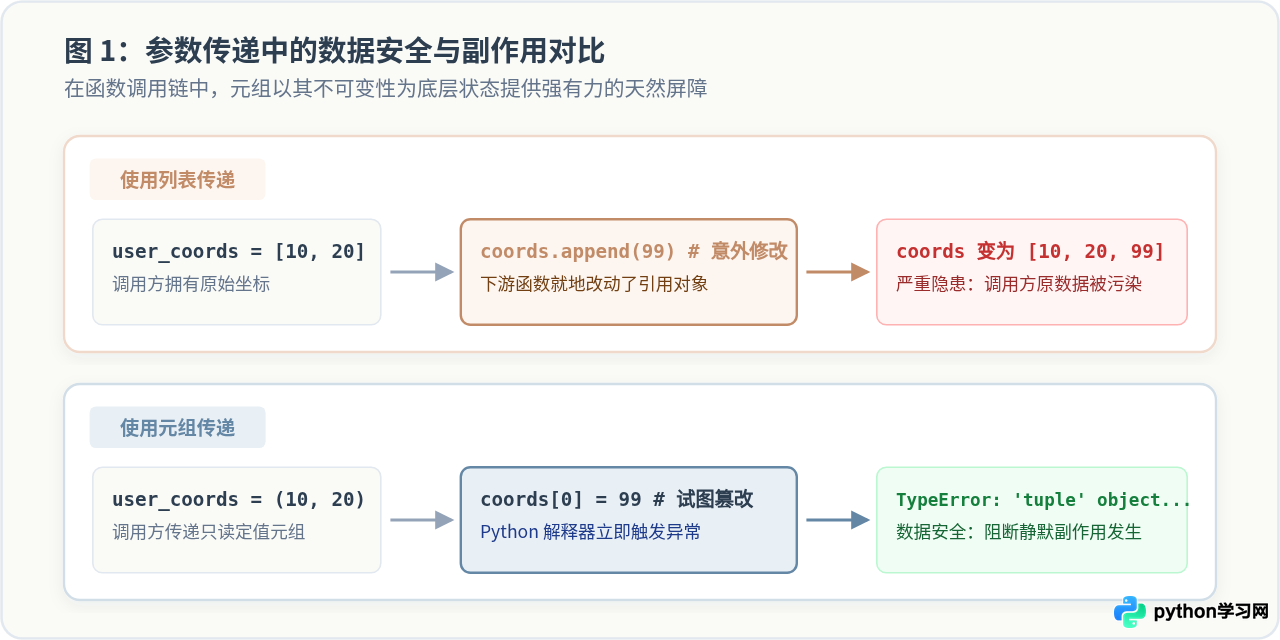
在 Python 中,对象作为参数传递给函数时采用的是“对象引用传递(Pass by Assignment)”。如果传递的是可变列表,下游函数任何未加防备的就地修改(如 append()、pop()、sort() 或下表赋值)都会直接污染上游调用方的原始变量,导致难以排查的幽灵 Bug。
# 传递列表时的潜在副作用风险
def process_user_location(coords):
    # 下游处理模块在不知情的情况下就地修改了列表
    coords.append(100.0)  # 原有列表被破坏
    return coords[0] + coords[1]

user_coords = [39.9042, 116.4074]
print("调用前:", user_coords)
process_user_location(user_coords)
print("调用后:", user_coords)
如果改用元组 user_coords = (39.9042, 116.4074),任何修改元组的企图都会立刻触发 TypeError。这种“只读屏障”让数据状态更可控,省去了编写多余拷贝代码(如 copy.deepcopy())的性能消耗。
2. 传达“异构记录”而非“同构集合”的语义
在 Python 设计哲学中,元组和列表有着约定俗成的语义分野:
- 列表(List):代表同构(Homogeneous)对象的动态集合。例如一组待处理的订单号
["ORD_101", "ORD_102", "ORD_103"],每个元素地位均等,集合长度可随业务流转增减。 - 元组(Tuple):代表异构(Heterogeneous)字段的固定记录(Record)。例如一个经纬度坐标
(39.9042, 116.4074)、一个 RGB 颜色值(255, 128, 0),或者单行用户信息("user_42", "admin", 28)。每个位置上的元素都有明确的字段语义,合在一起才构成一个完整的业务实体,随意增减元素会直接破坏其实体完整性。
二、哈希性:作为字典键与集合元素的硬性机制
在实际开发中,必须选用元组而不能使用列表的最直接原因,是 Python 字典(dict)和集合(set)的底层寻址规则。
1. 为什么字典的键必须不可变?
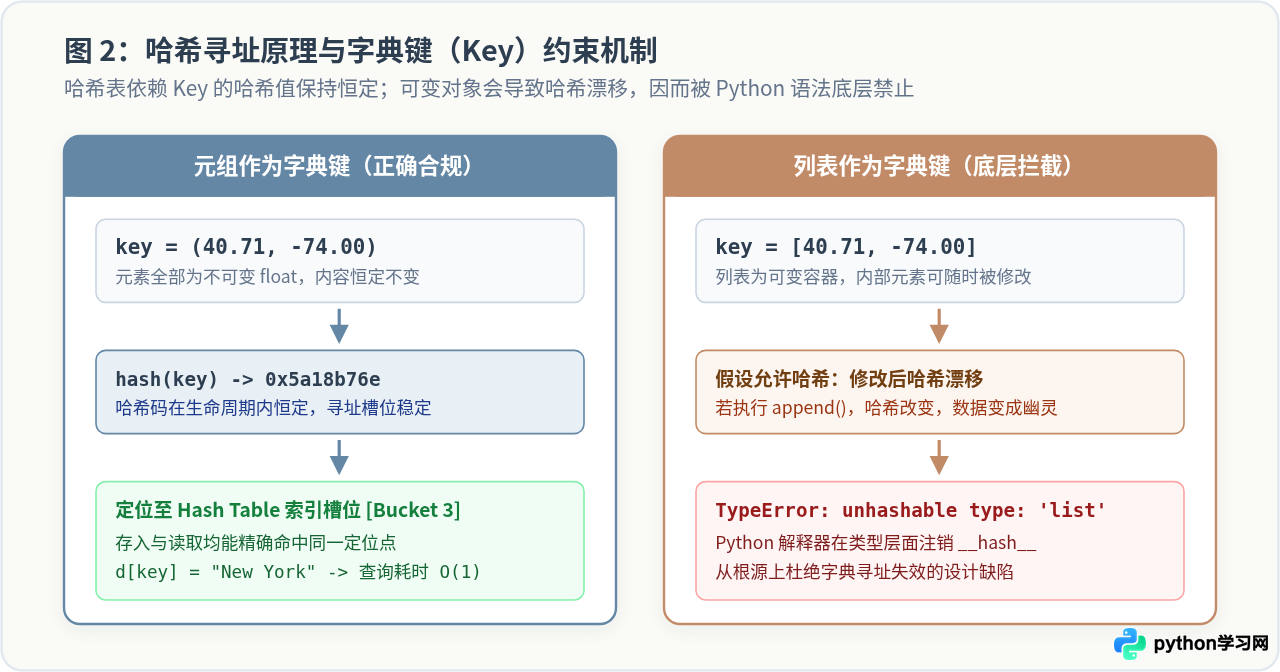
Python 字典是基于哈希表(Hash Table)实现的,具有平均 $O(1)$ 的高速查找性能。当存入一个键值对 d[key] = value 时,解释器会调用 hash(key) 计算出该键的哈希值,并通过哈希值计算出在内存哈希桶(Bucket)中的存储位置。
如果允许列表作为键,当列表内部元素发生变更时,其对应的哈希值也会改变。这会导致此前存入哈希桶的数据无法通过变更后的哈希值找到,产生“数据丢失”与哈希表结构损坏。
# 列表作为字典键将直接抛出异常
try:
    locations = {}
    locations[[39.9042, 116.4074]] = "北京"
except TypeError as e:
    print("捕获异常:", e)
为了杜绝这一隐患,Python 官方在 list 类型内部直接将 __hash__ 显式置为 None。而元组只要其内部元素全部是不可变类型(如整型、浮点型、字符串等),元组本身就是可哈希的(Hashable),可以安全作为字典的复合键,或存入集合进行去重。
注意:包含可变对象的元组依然不可哈希
元组的可哈希性取决于其所有子元素是否均可哈希。如果一个元组内包含列表(例如 t = (1, 2, [3, 4])),由于其内部列表可变,调用 hash(t) 依然会报 TypeError: unhashable type: 'list'。因此,作为字典键时必须确保元组各层级皆为不可变对象。
三、底层实现:内存开销与执行性能的显著优势
除了语义和哈希约束,在性能敏感或需要处理数百万级规模数据的场景中,元组在内存占用和实例化效率上的表现明显优于列表。
1. CPython 底层结构体与内存开销
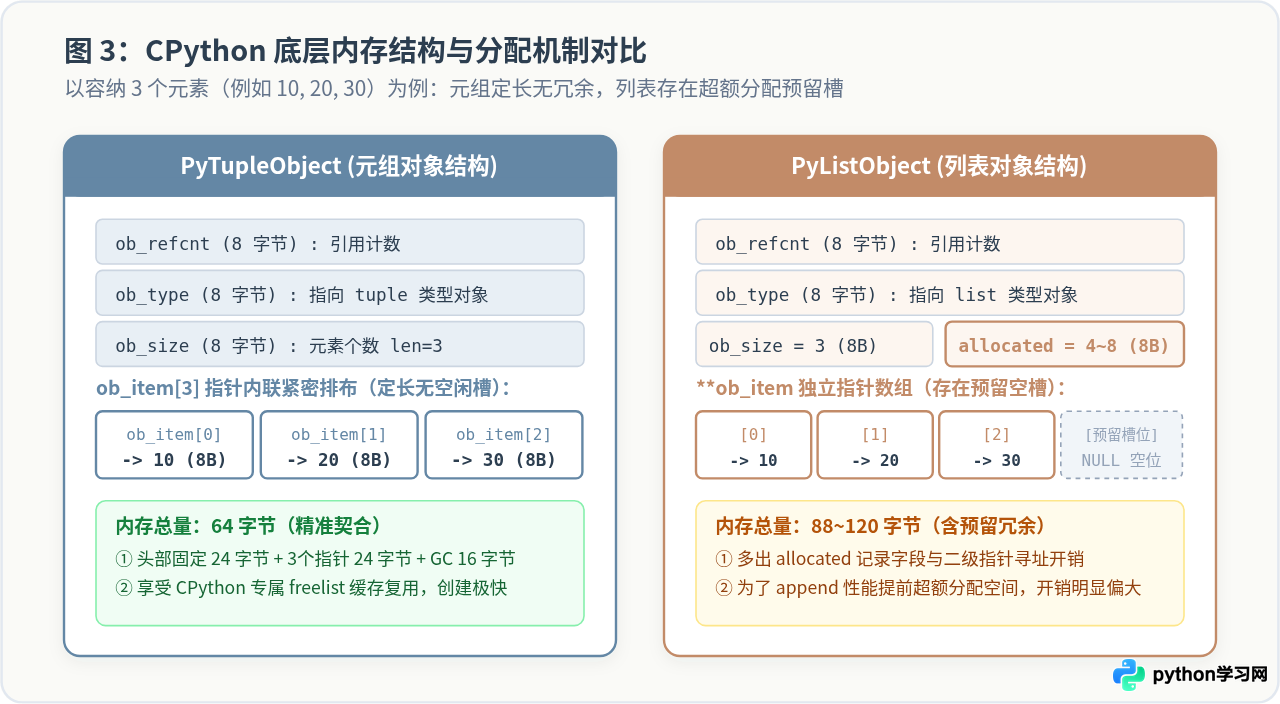
在 CPython 解释器底层,列表由 PyListObject 结构体实现,而元组由 PyTupleObject 结构体实现。我们可以通过 sys.getsizeof() 直接查看两者在不同元素规模下的内存占用(字节数):
import sys

# 比较空容器及不同长度容器的内存占用
print("空元组大小:", sys.getsizeof(()), "字节")
print("空列表大小:", sys.getsizeof([]), "字节")

tuple_3 = (1, 2, 3)
list_3 = [1, 2, 3]
print("3 元素元组:", sys.getsizeof(tuple_3), "字节")
print("3 元素列表:", sys.getsizeof(list_3), "字节")造成这种差距的原因有两个:
- 无额外管理字段:元组定长不可变,结构体中只需存储
ob_size记录元素数量,各指针紧随其后;而列表需要支持动态扩容,内部额外包含allocated字段来记录已分配的总容量。 - 避免过度分配(Over-allocation):列表为了保证在频繁调用
append()时具有均摊 $O(1)$ 的时间复杂度,采用了过度分配机制。当列表满载时,会自动申请比当前所需更多的空闲插槽。而元组按需定长分配,绝不产生一字节冗余空槽。
2. CPython 的 freelist 缓存机制带来极速创建
除了内存紧凑,元组在创建速度上也往往比列表快 2 到 5 倍。CPython 源码中对小型元组(长度在 1 到 20 之间)设计了全局 free_list 缓存链表。
当一个小型元组生命周期结束被垃圾回收时,其申请的系统内存并不立即释放给操作系统,而是存入缓存池中。当下一次代码需要新建相同长度的元组时,直接从缓存池取出现成块复用,省去了向操作系统申请堆内存和初始化的时间。这对于高频调用的轻量函数来说,性能收益非常显著。
四、常见场景选型:什么时候用元组?什么时候用列表?
理解了底层原理之后,在实际编写 Python 代码时,可以按照清晰的决策路径来选择最合适的容器类型。
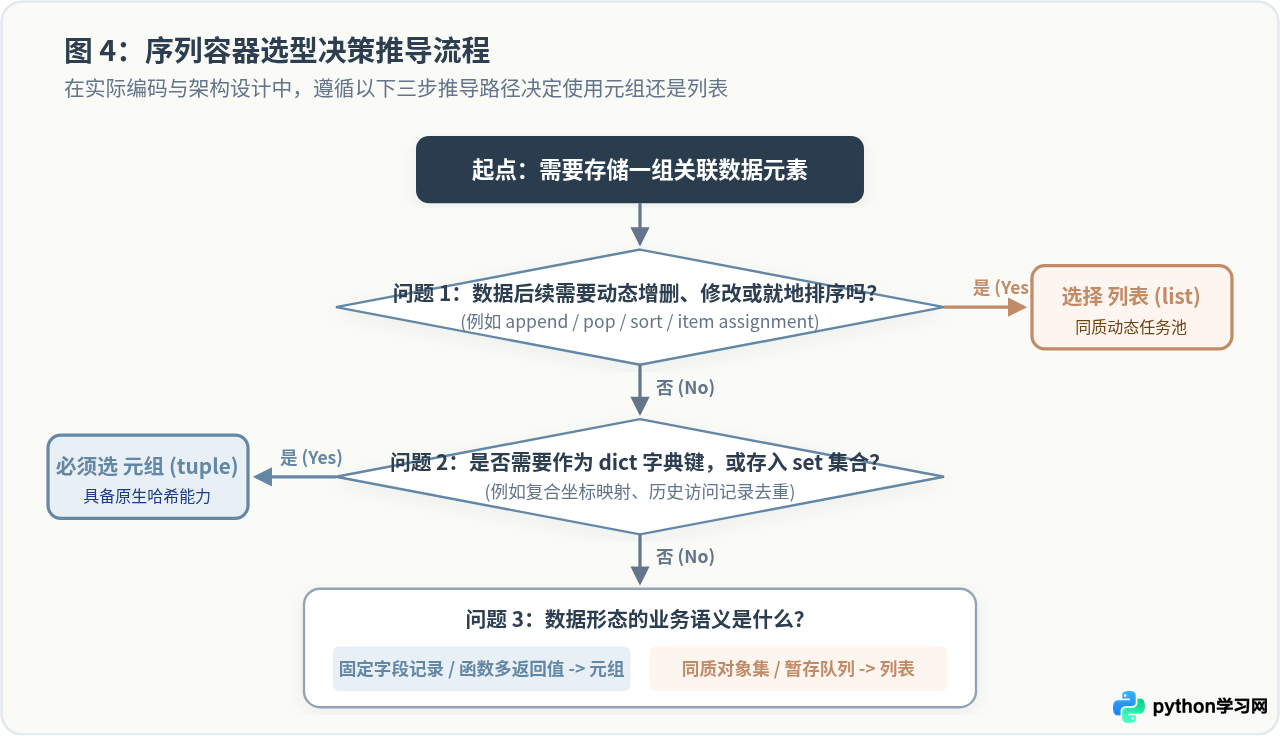
1. 必须或强烈建议使用元组的场景
- 函数多值返回与解包:例如
return status_code, message, elapsed_time。Python 在语法层面会自动将其打包为元组返回,接收方通过code, msg, t = get_result()解包。这表达了“多值作为一个不可拆分的事实快照”的语义。 - 字典的复合键与集合元素:如使用二维网格坐标
(x, y)或多维属性作为字典的键。 - 只读配置项与常量集合:如
SUPPORTED_FORMATS = ('jpg', 'png', 'webp'),防止程序运行过程中被误操作修改。 - 代表结构固定的实体记录(Record):如从数据库中
fetchone()取出的某一行数据,其字段顺序与列定义强绑定。
2. 应当使用列表的场景
- 需要动态追加、删除或过滤元素:如用户实时输入收集、待处理的任务队列。
- 同类对象的大规模流水线流转:如经过
map()、filter()或列表推导式不断变换的同类型数据。 - 需要就地排序或翻转:需要直接调用
list.sort()或list.reverse()操作内存的场景。
五、特性对照与总结
综上所述,元组绝不是“阉割版的列表”,而是在保证安全契约、实现哈希寻址与压榨运行效率三个维度上不可或缺的核心数据结构。
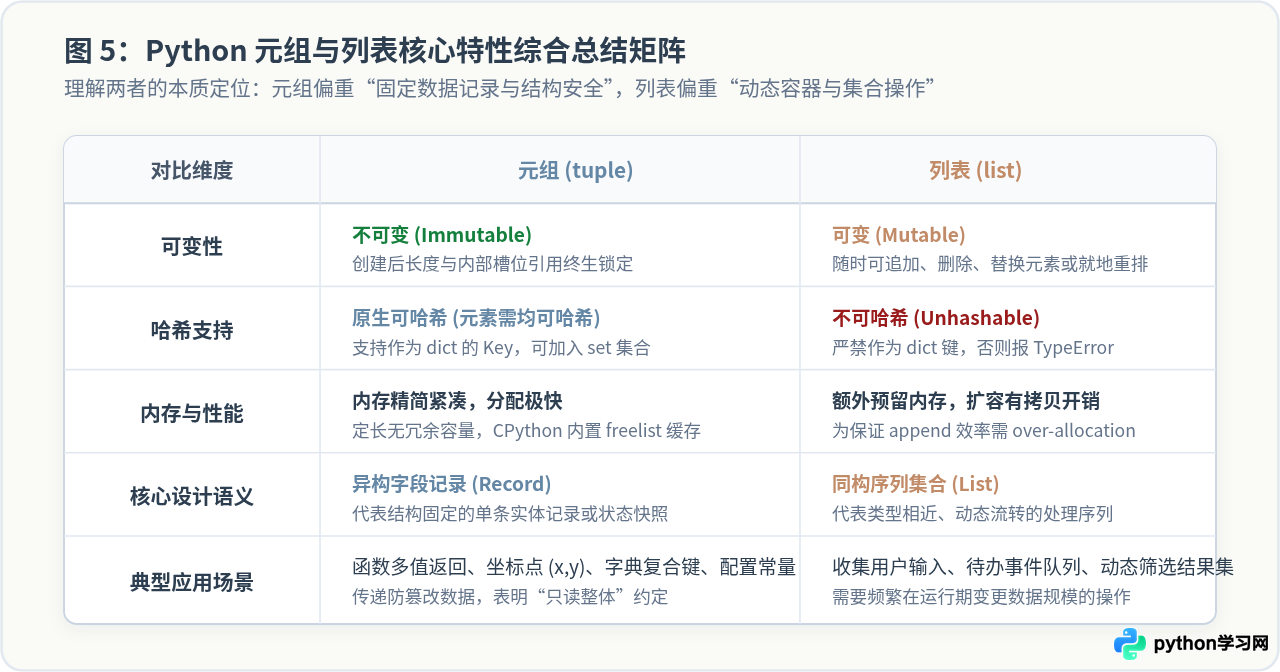
在编写 Python 代码时,可以牢记一条黄金实践原则:“默认优先考虑不可变的元组(表达结构、保护数据、提升性能),唯有在明确需要动态变更集合内容时,才引入可变的列表”。遵循这一原则,不仅能让程序拥有更高的执行性能,更能从类型设计层面杜绝大量隐蔽的数据状态漏洞。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















