


Google Colab与普通在线Python编辑器的区别是什么
深入对比Google Colab与普通在线Python编辑器的底层执行机制、GPU算力支持、预装依赖生态、存储生命周期及实际选型建议,帮助开发者针对数据科学、算法学习等不同场景选择最合适的工具。
初学者在接触线上 Python 工具时,常常误以为所有能在浏览器里跑代码的工具都是同一类“网页编译器”。实际上,两者的技术架构、交互习惯、资源分配以及适用任务有着十分明确的界限。下面围绕读者在实际编码中最关心的几个核心差异展开逐一拆解。
一、代码组织与执行架构:有状态单元格 vs. 单次无状态脚本
普通在线 Python 编辑器通常遵循传统的脚本批处理模型。用户在一个单文件编辑框中编写完整的 .py 代码,点击“运行(Run)”按钮后,后台服务启动一个临时解释器进程,从第一行代码线性执行到最后一行,将控制台输出(stdout / stderr)推送到浏览器页面,执行完毕后进程随之销毁。这意味着,如果你的程序第一步需要花费 30 秒从网络下载数据,那么你每次修改后续代码并重新点击运行时,都必须从头重新等待下载 30 秒。
与此形成鲜明对比的是,Google Colab 基于 Jupyter Notebook(.ipynb)分块交互架构。在 Colab 中,代码被划分为若干个独立的“单元格(Cell)”。背后的 Python 内核(Kernel)在独立的云端虚拟机中常驻运行:
- 内存状态持续驻留:在前面的单元格中加载的数据集、导入的模块或训练好的模型对象,会完整保留在虚拟机内存中。调试后续的数据分析逻辑时,只需单独重新执行后续单元格,耗时仅需数毫秒。
- Markdown 与代码混排:Colab 允许穿插丰富的排版文字、数学公式(LaTeX)以及实时生成的动态图表,适合作为科研推导、数据分析报告与算法教学的载体。
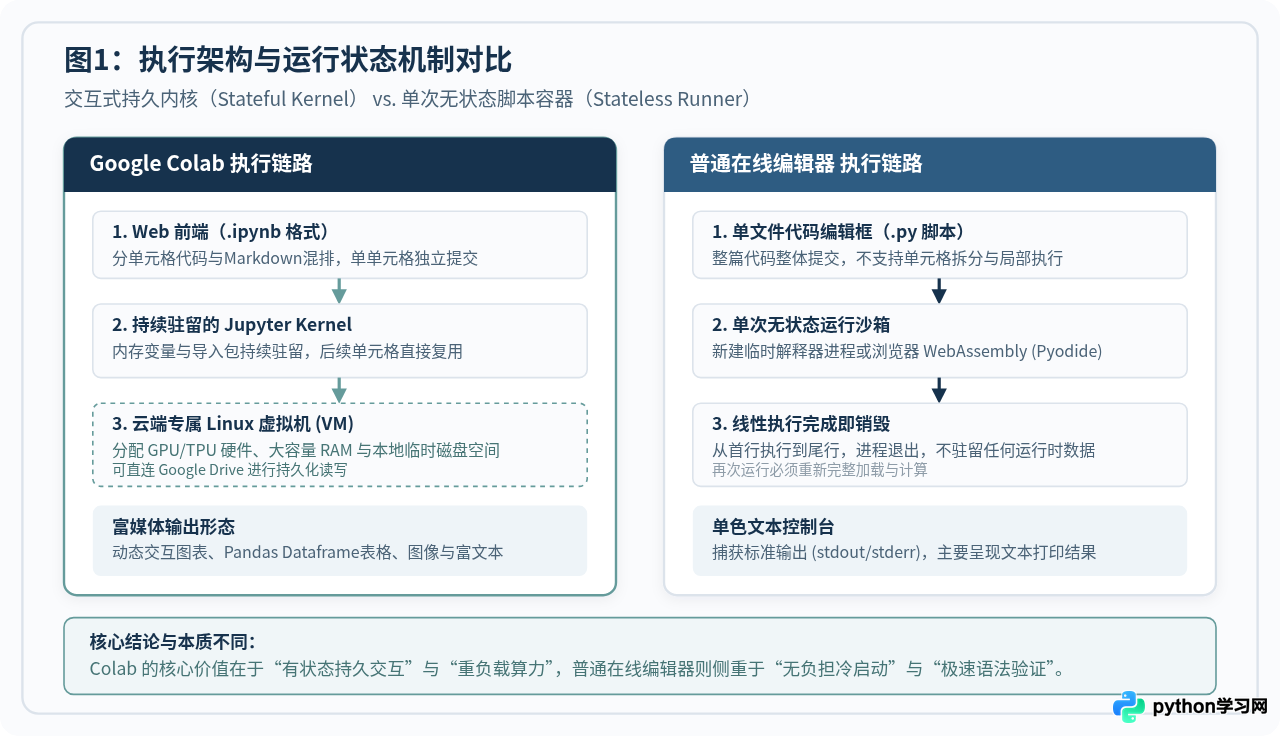
这种架构差异决定了两者的代码编写心智完全不同:普通在线编辑器要求代码是一篇结构自洽、端到端完整运行的脚本;而 Colab 则支持“边思考、边清洗、边看图、边调试”的渐进式探索。
二、算力分配与硬件加速:从轻量CPU到企业级GPU/TPU
代码运行的物理算力是两者的第二大分水岭。这也是数据科学和人工智能从业者几乎人手一个 Colab 账号的关键原因。
Google Colab 的算力规格
- 免费提供硬件加速:可随时在运行时设置中挂载 Nvidia T4 GPU,付费订阅甚至可使用 V100 或 A100 Tensor Core GPU,并支持专为神经网络打造的 TPU。
- 充裕的内存配额:免费实例通常配备 12GB 左右的系统内存与 15GB 显存,高内存模式可扩充至 25GB~50GB+。
- 并行计算支持:底层环境深度整合了 CUDA 与 cuDNN 驱动,张量计算速度相比纯 CPU 提升数十倍至上百倍。
普通在线编辑器的算力规格
- 极简单核 CPU:服务提供商为降低服务器并发成本,通常只为单个用户分配容器的部分单核 CPU 时间片。
- 内存限制极严格:内存配额通常在 256MB 至 1GB 之间,一旦加载稍大的 CSV 表格或图像数据集,就会立即触发 OOM(Out of Memory)进程被强行杀掉。
- 无硬件加速:几乎完全不提供 GPU 算力支持,无法承担任何深度神经网络的训练任务。
举一个直观的例子:如果你需要使用 PyTorch 构建一个卷积神经网络(CNN)并在 CIFAR-10 数据集上训练 10 个周期。在普通在线 Python 编辑器中,由于只能调用轻量 CPU,往往需要耗费十数分钟甚至因内存不足崩溃;而在 Colab 挂载 T4 GPU 后,每个周期可能仅需数秒钟。
在 Colab 中,你可以通过以下几行简洁的代码直接确认当前所分配的加速器型号:
# 示例:在 Colab 单元格中检测当前分配的 GPU 硬件
import torch

if torch.cuda.is_available():
    print(f"当前成功连接 GPU 算力: {torch.cuda.get_device_name(0)}")
    print(f"显存总容量: {torch.cuda.get_device_properties(0).total_memory / 1e9:.2f} GB")
else:
    print("当前处于纯 CPU 运行时模式")
三、依赖生态与操作系统权限:开箱即用AI库与Shell命令
在日常使用中,另一个让开发者体会深刻的差异在于第三方库的安装自由度与底层操作权限。
普通在线 Python 编辑器大多提供的是高度受限的沙盒环境。部分基于浏览器端 WebAssembly(如 Pyodide)运行的轻量编辑器,仅支持纯 Python 编写的标准库,无法安装包含 C/C++ 底层编译扩展的库;即使支持 pip install 的后端沙盒,也往往因无法持久化虚拟环境,导致每次重新载入页面时都要重复耗时下载,体验极其割裂。
而 Google Colab 为每个会话动态分配了一台运行 Ubuntu 系统的独立虚拟主机(Virtual Machine),带来了极高的灵活性:
- 主流 AI 库开箱即用:系统已提前预装了当前主流版本的 PyTorch、TensorFlow、Scikit-learn、Pandas、Numpy、OpenCV、Matplotlib、Seaborn 等数百个数据科学重磅库,省去了在个人电脑上繁琐配置 CUDA 驱动与环境冲突的痛苦。
- 原生 Shell 命令支持:在单元格中以感叹号
!开头,可以直接向底层 Linux 系统发送 Bash 终端指令。例如使用!pip install -q transformers快速安装大模型生态工具,使用!git clone <repo_url>拉取开源项目代码,甚至使用!nvidia-smi实时监控显存温度与占用率。 - 魔法命令(Magic Commands):支持 IPython 原生的
%timeit(单行/多行代码基准性能测试)、%cd(变更工作目录)、%matplotlib inline(内联图形渲染)等,极大地丰富了交互效率。
四、存储机制与使用流程:临时虚拟机与云端硬盘持久化
理解 Colab 的一个关键概念是其临时性生命周期(Ephemeral Lifecycle)。普通在线编辑器要么不保存文件,要么把几行代码以代码片段(Snippet)形式保存在平台数据库中。而 Colab 的底层是一台真实的虚拟机,其根目录下的临时文件系统(如 /content)仅在当前会话激活期间存在。
/content/my_model.pt)上的临时数据都会被彻底清空!为了兼顾高负载算力与数据持久化安全,Colab 提供了与 Google Drive(云端硬盘)的原生挂载机制。以下是使用 Colab 完成典型深度学习任务的四个核心步骤:
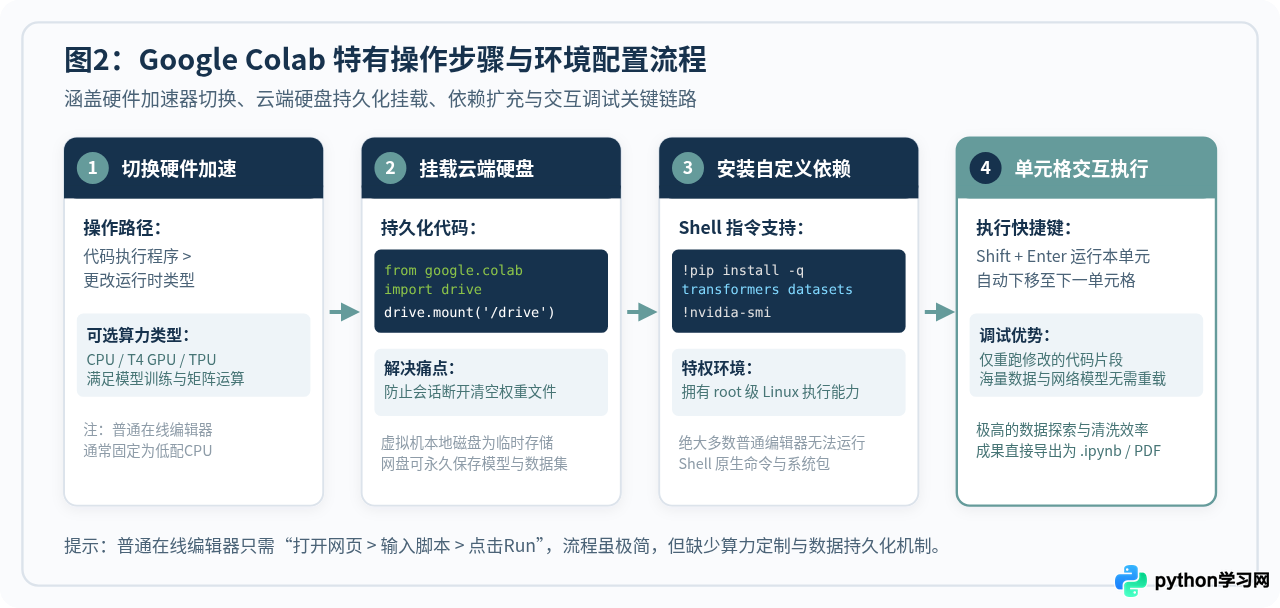
在实际操作中,推荐按照以下规范化的初始化代码进行目录挂载与路径定义:
# 第一步:在 Colab 首个单元格中挂载个人云端硬盘
from google.colab import drive
drive.mount('/content/drive')

# 第二步:指定工程持久化存储路径,所有需要长期保留的模型权重均应写入此目录
import os
save_dir = '/content/drive/MyDrive/colab_projects/exp_01'
os.makedirs(save_dir, exist_ok=True)
print(f"持久化保存路径已就绪: {save_dir}")
通过这种方式,既能利用云端虚拟机的高性能 GPU 进行矩阵运算,又能将耗时训练出来的模型权重安全地同步沉淀在云端硬盘中,不再惧怕虚拟机超时断开。
五、选型决策指南:什么时候用谁最合适
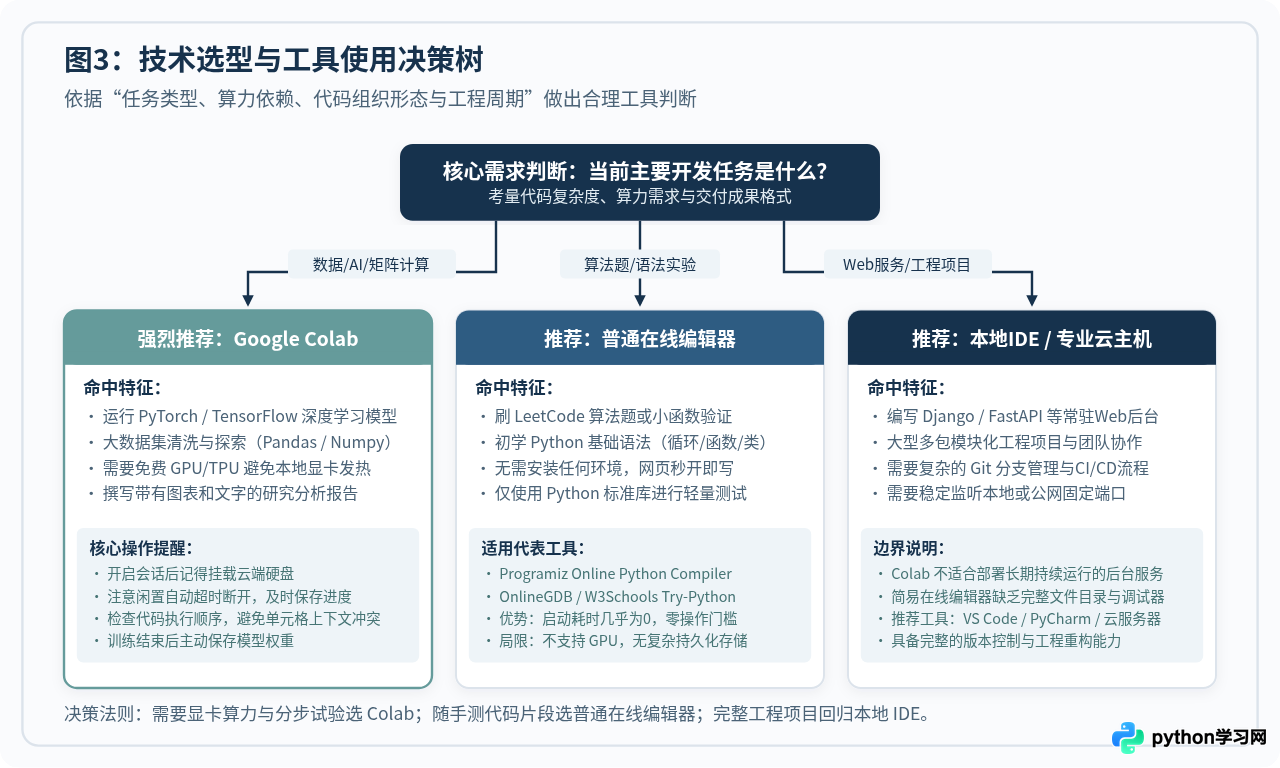
工具并无绝对优劣,关键在于它是否契合当前的开发目标与精力投入产出比。面对具体的开发或学习任务时,可以根据以下决策树快速确定选型路线:
1. 什么时候坚决选择 Google Colab?
- 深度学习与 AI 算法实战:需要微调预训练模型(如 HuggingFace Transformers、Stable Diffusion)、运行 PyTorch / TensorFlow 神经网络项目,且本地设备没有高性能独立显卡。
- 探索性数据分析(EDA):需要导入几百兆甚至几千兆的 CSV/Parquet 文件,使用 Pandas 进行分组聚合计算,并用 Matplotlib/Seaborn 绘制数十幅对比图表。
- 技术方案复现与研究协作:目前学术论文与顶级开源项目的演示教程(Demo Notebook),绝大多数都以 Colab 一键运行链接的形式分发,点击即能直接复现运行结果。
2. 什么时候选择普通在线 Python 编辑器?
- 学习 Python 基础语法:初学变量、条件分支、循环结构、列表字典操作或面向对象类概念,完全不需要庞大的 GPU 与数据科学库,普通在线编译器零门槛即开即用。
- 刷算法面试题与快速验证:在做 LeetCode、Codewars 算法题时,或者在写一个辅助正则表达式、日期转换函数时,希望在 2 秒内打开页面、粘贴代码、看到控制台输出。
- 受限网络或低配终端环境:在轻薄本、平板电脑甚至手机端临时需要验证一段 Python 语法,普通在线编辑器页面轻量、加载极快,对网络延迟要求极低。
3. 什么时候两者都不合适?
如果你的目标是编写一个长期运行的常驻 Web 后端(如 Django、FastAPI 接口服务)、需要对外开放固定公网端口、或者正在构建包含数十个模块的大型工程项目(需要严格的本地 Git 分支管控与集成测试),那么无论 Colab 还是普通在线编辑器都不是正确选择。此时应当回归本地专业 IDE(如 VS Code、PyCharm)配合虚拟环境,或购买专属的云服务器进行部署。
六、核心维度全面汇总与高频避坑提醒
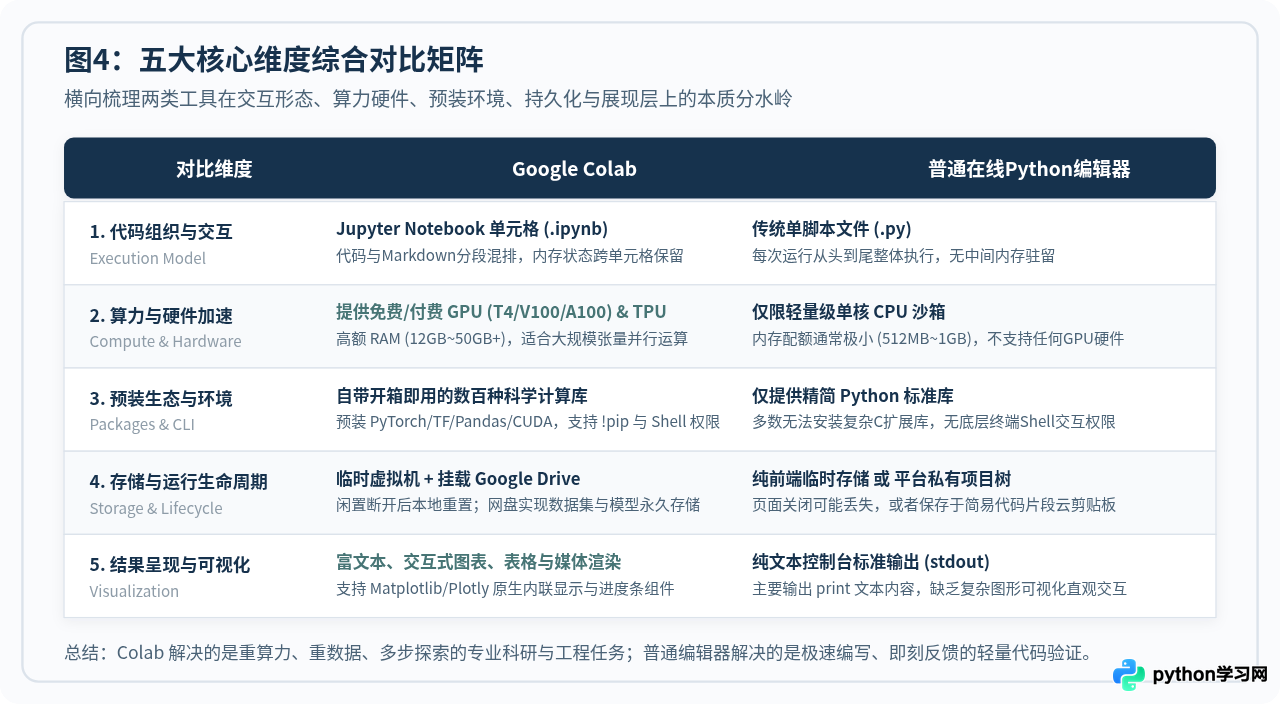
为了让两者的特性对比更加直观,下表从代码组织、算力分配、软件生态、数据存储与可视化五个关键技术维度进行了横向汇总:
使用 Google Colab 的三条关键避坑准则
- 警惕“单元格乱序执行”引发的隐蔽逻辑错误:Jupyter Notebook 允许任意跳跃执行单元格。如果在修改了中间某个变量后没有按顺序向下重跑,内存中的状态可能与当前屏幕上显示的代码顺序不一致。排查建议:在得出最终结论或保存模型前,务必点击菜单栏的“代码执行程序 > 重新启动会话并运行所有代码”,确保整篇 Notebook 可以从首至尾无错执行。
- 避免直接对挂载的 Google Drive 进行高频海量小文件 I/O:Google Drive 属于网络文件系统,连续读取数万张小尺寸图片(如解压数据集)时网络延迟会严重拖慢训练速度。最佳实践:先把数据集压缩包从网盘拷贝到本地虚拟机
/content下解压训练,训练完成后将权重文件打包复制回云端硬盘。 - 养成随手保存检查点(Checkpoint)的好习惯:因为免费算力随时可能因长时间无交互而触发休眠,务必在训练循环中设置自动保存逻辑(如每训练 5 个 Epoch 自动写一次
torch.save()到 Drive 路径下),避免突发断连导致训练进度归零。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















