


Python注释会被执行吗?解释器处理机制详解
深入解析Python解释器对注释的处理机制,剖析词法分析器(Tokenizer)如何剔除#号注释,对比文档字符串(Docstring)与普通表达式的字节码差异,并详解编码声明与Shebang等特殊注释的底层工作原理。
# 开头的标准注释绝对不会被执行。Python 在编译源文件的词法分析阶段就会彻底剥离所有注释,语法分析器(Parser)与字节码编译器(Compiler)根本不会感知到它们的存在。然而,在日常开发中,诸如编码声明(# coding: utf-8)、Shebang(#!/usr/bin/env python3)以及常被误当成“多行注释”的未赋值三引号字符串,常常给开发者带来“注释似乎能影响执行”的错觉。本文将结合词法扫描器、AST 抽象语法树与 dis 字节码反编译,彻底拆解解释器对各类注释的处理全过程。
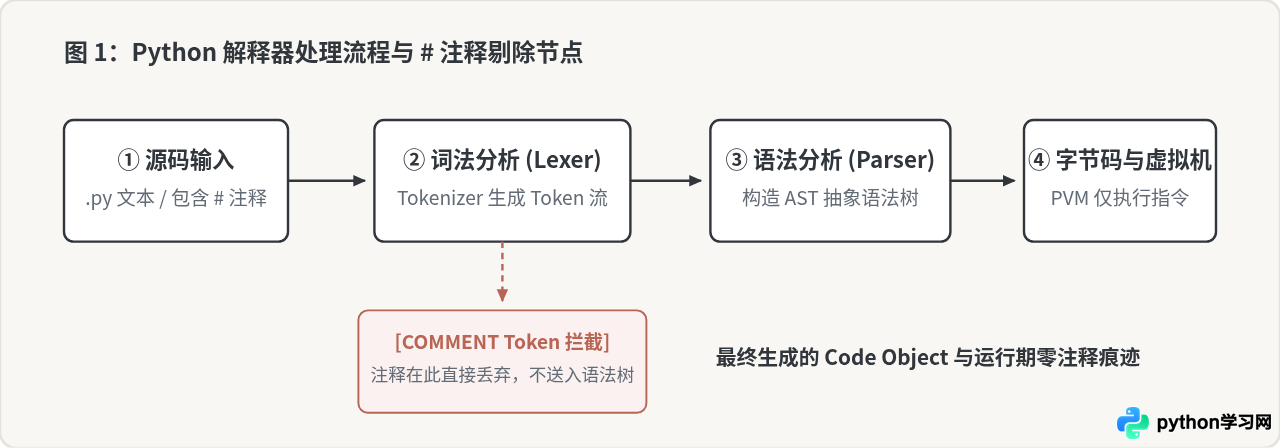
一、解释器解析流水线:注释究竟在哪个环节消失?
要确切理解 Python 注释为何不会被执行,我们需要跟随 CPython 解释器的核心编译流水线。Python 并不是直接逐行阅读并执行文本代码,而是经历四个严格的前端处理阶段:
- 源码解码(Source Decoding):将原始字节流(Bytes)根据文件编码规范解码为 Unicode 字符流。
- 词法分析(Lexical Analysis / Tokenizer):将字符流按语法规则切割成离散的标记(Tokens),如标识符、关键字、操作符、常量和注释。
- 语法分析(Syntax Parsing / AST Generation):根据 Python 文法规范将 Token 流组织为抽象语法树(AST)。
- 字节码编译与运行(Bytecode Compilation & PVM Execution):将 AST 遍历编译为 Python 虚拟机专属的操作码(Opcode),由 PVM 执行栈帧。
关键的分水岭就在词法分析向语法分析的过渡。我们可以使用 Python 标准库自带的 tokenize 与 ast 模块,直接在终端中验证这一过程。
1. 编写测试样本与提取 Token 流
假设我们编写了一个名为 demo.py 的简单代码文件,其中包含单行独立注释与行尾注释:
# demo.py 示例代码
# 全局说明:计算商品折后价
price = 100  # 基础价格
discount = 0.8  # 折扣系数
final_price = price * discount
在终端中调用 Python 词法分析工具:
python3 -m tokenize demo.py示例输出结果如下:
0,0-0,0:            ENCODING       'utf-8'
1,0-1,19:           COMMENT        '# 全局说明:计算商品折后价'
1,19-1,20:          NL             '
'
2,0-2,5:            NAME           'price'
2,6-2,7:            OP             '='
2,8-2,11:           NUMBER         '100'
2,13-2,21:          COMMENT        '# 基础价格'
2,21-2,22:          NEWLINE        '
'
3,0-3,8:            NAME           'discount'
3,9-3,10:           OP             '='
3,11-3,14:          NUMBER         '0.8'
3,16-3,24:          COMMENT        '# 折扣系数'
3,24-3,25:          NEWLINE        '
'
4,0-4,11:           NAME           'final_price'
4,12-4,13:          OP             '='
4,14-4,19:          NAME           'price'
4,20-4,21:          OP             '*'
4,22-4,30:          NAME           'discount'
4,30-4,31:          NEWLINE        '
'
5,0-5,0:            ENDMARKER      ''
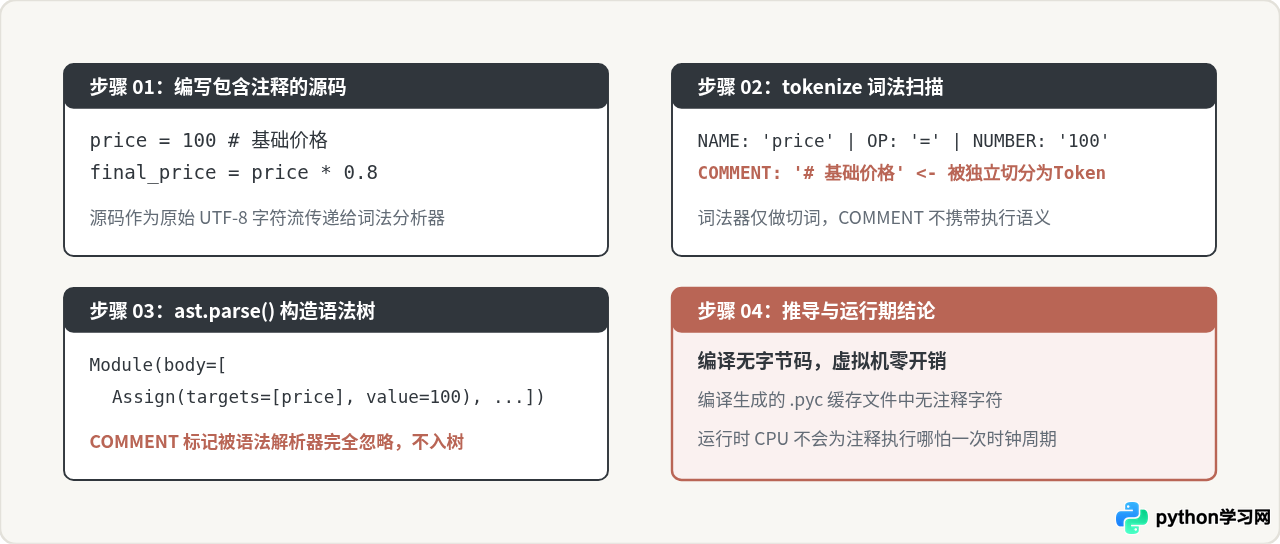
从输出可以观察到,词法扫描器准确识别出了 COMMENT 类型的 Token。但当解释器的语法分析器(PEG Parser)开始工作时,文法规则只消费与语句、表达式相关的 Token(如 NAME、NUMBER、NEWLINE),所有的 COMMENT Token 被直接略过。
2. AST 语法树检查:注释完全不存在
我们接着运行 ast 模块对该文件进行抽象语法树转储:
python3 -c "import ast; print(ast.dump(ast.parse(open('demo.py').read()), indent=2))"示例输出结果:
Module(
  body=[
    Assign(
      targets=[Name(id='price', ctx=Store())],
      value=Constant(value=100)),
    Assign(
      targets=[Name(id='discount', ctx=Store())],
      value=Constant(value=0.8)),
    Assign(
      targets=[Name(id='final_price', ctx=Store())],
      value=BinOp(
        left=Name(id='price', ctx=Load()),
        op=Mult(),
        right=Name(id='discount', ctx=Load())))],
  type_ignores=[])
检查 AST 结构,整个语法树的 body 列表中仅有三个 Assign 赋值节点。无论是开头的独立注释还是行尾的注释,连一个字段都没有进入语法树。由于字节码编译器完全是依照 AST 节点生成的,没有 AST 节点,就绝对不可能生成任何字节码。
二、终极求证:dis 反编译看字节码差异
在很多初学者的认知中,常常会混淆“以 # 开头的单行注释”与“三引号包裹的多行字符串”。不少人习惯用 """这是注释""" 来做大段临时屏蔽或说明,这导致了“注释会产生开销或被执行”的误区。
我们使用 Python 的反编译模块 dis,直接观察两个函数的底层字节码指令差异。
import dis

def func_with_hash():
    # 这是单行注释1
    # 这是单行注释2
    x = 1
    return x

def func_with_strings():
    """这是函数文档字符串(Docstring)"""
    """这是孤立的普通多行字符串"""
    x = 1
    return x
1. 查看 func_with_hash 的反编译结果
dis.dis(func_with_hash)示例输出:
  5           0 LOAD_CONST               1 (1)
              2 STORE_FAST               0 (x)

  6           4 LOAD_FAST                0 (x)
              6 RETURN_VALUE
整个函数生成的字节码极其精简:只有 LOAD_CONST 载入数值 1,STORE_FAST 存入局部变量 x,然后 LOAD_FAST 取出并 RETURN_VALUE。第 3 行和第 4 行的 # 注释没有在指令序列中留下任何痕迹。
2. 查看 func_with_strings 的反编译结果与属性
dis.dis(func_with_strings)示例输出:
  9           0 LOAD_CONST               1 (1)
              2 STORE_FAST               0 (x)

 10           4 LOAD_FAST                0 (x)
              6 RETURN_VALUE
这里出现了一个很有趣的现象:在字节码指令中,似乎也看不到三引号字符串的执行指令。这是不是意味着三引号也是注释?
绝对不是。我们检查函数的代码对象(Code Object)内部存储:
print("常量池 co_consts:", func_with_strings.__code__.co_consts)
print("函数 doc 属性:", repr(func_with_strings.__doc__))
示例输出:
常量池 co_consts: ('这是函数文档字符串(Docstring)', 1, None)
函数 doc 属性: '这是函数文档字符串(Docstring)'
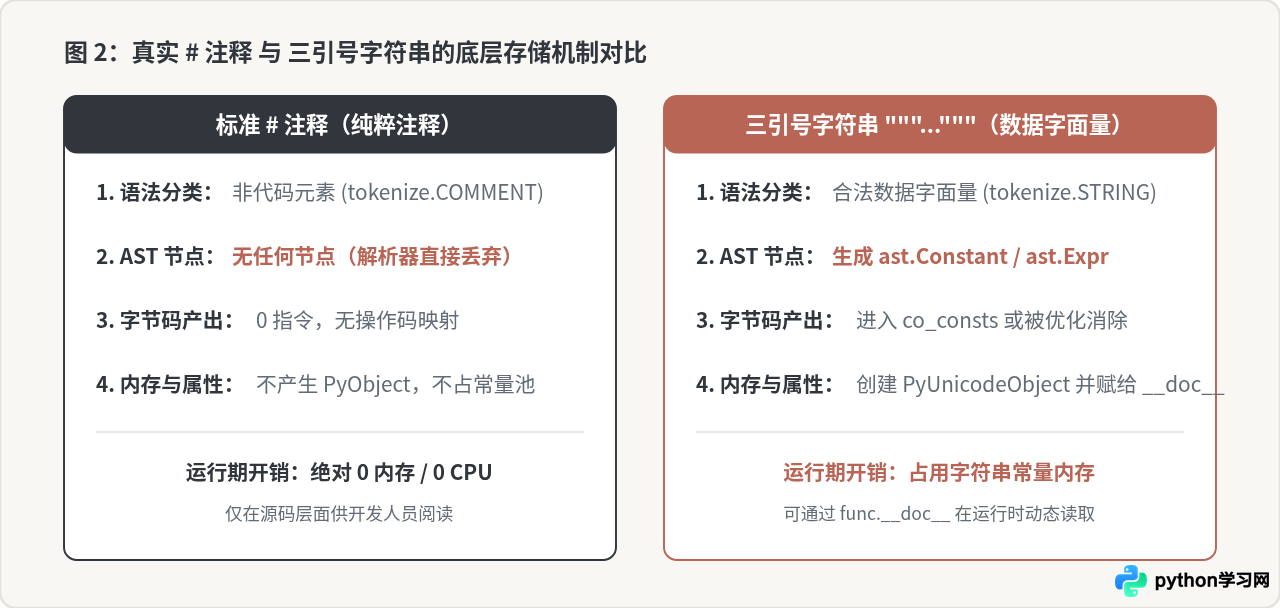
这揭示了三引号字符串的真实底细:
- 位于函数或类定义顶部的字符串字面量,被 Python 编译器赋予了文档字符串(Docstring)的特殊语义。编译器会把该字符串存入该代码对象的常量元组
co_consts,并在函数创建时将其绑定到__doc__属性上。它占用了实际的堆内存对象! - 而紧随其后的第二个孤立三引号字符串
"""这是孤立的普通多行字符串""",在语法分析器看来是一个普通的表达式语句(ast.Expr)。虽然现代 CPython 编译器的窥孔优化器(Peephole Optimizer)发现它没有副作用且未被使用,从而在生成最终字节码时优化掉了载入指令,但在词法和 AST 阶段它都是真实合法的语言表达式,绝非注释。
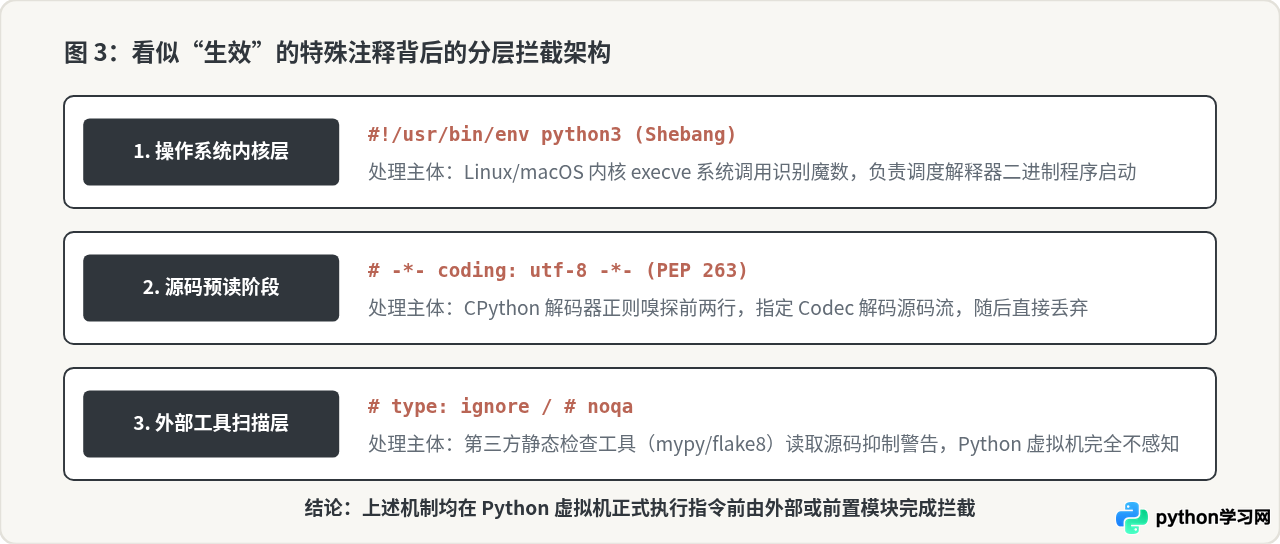
三、为什么有些“注释”看似起作用了?特殊注释的预扫描机制
既然注释不会被执行,为什么很多人会觉得“Python 注释有时能生效”?典型的情况有三个:
- 设置文件编码:
# -*- coding: utf-8 -*-能避免编码报错。 - 脚本直接运行:
#!/usr/bin/env python3让脚本具备可执行权限后直接在终端运行。 - 静态类型忽略:
# type: ignore让mypy检查跳过报错。
这些形式虽然外观上都是 # 开头,但它们的实际处理主体并不是 Python 虚拟机(PVM)。
1. 源码编码声明(PEP 263):编译前端预读
当你在 Python 源码的第一行或第二行写入 # -*- coding: utf-8 -*- 时,并不是解释器在运行时“执行”了这行代码,而是 CPython 在读取源文件原始字节流(Raw Bytes)时的一个前置嗅探机制:
- CPython 打开文件,首先以纯二进制模式读取前两行。
- 使用内置的正规正则表达式模式
coding[:=]\s*([-\w.]+)扫描这前两行文本。 - 如果匹配到编码名称(例如
utf-8或gbk),解释器就会使用对应的编码转换器(Codec)将后续的所有字节流解码为 Unicode。如果未声明,在 Python 3 中默认按 UTF-8 解码。 - 解码完成后,这行文本在进入 Tokenizer 时,依然被当做普通的
COMMENT丢弃。
因此,编码声明是词法分析前的解码配置项,而非运行时执行语句。
2. Shebang 行(#!):操作系统内核的行为
在 Unix/Linux 环境下,以 #!/usr/bin/env python3 开头的脚本可以直接通过 ./script.py 运行。这同样不是 Python 解释器的功能,而是操作系统内核的程序加载器(execve 系统调用)的标准行为:
内核读取可执行文件的前两个字节,发现魔数(Magic Number)是 0x23 0x21(即 ASCII 的 #!),就会提取后面的解释器路径,将当前脚本路径作为参数传给该解释器来启动进程。当 Python 解释器被启动并打开该文件时,它看到的仅仅是一个普通的以 # 开头的单行注释,按常规流程直接丢弃。
3. 静态检查注解(# type: ignore 与 # noqa)
像 mypy、pyright 或 flake8 这类静态分析工具,并不是在代码运行时工作的。它们在独立检查代码时,会单独读取源码并结合 Token 位置来决定是否抑制对应的告警信息。当这段代码被真正的 Python 解释器运行时,这些指令与普通注释毫无区别,彻底被过滤。
四、各类“注释”机制对比矩阵与工程实践指南
为了帮助开发者在实际开发中清晰分辨不同注释与字面量的行为边界,以下汇总了 Python 中所有类似注释形态的底层处理对照表:
| 语法形态 | 实际生效阶段 | 处理主体 | 是否进入 AST | 是否生成字节码 | 运行时开销 |
|---|---|---|---|---|---|
单行注释 (# comment) |
词法分析阶段剥离 | Tokenizer | 否 | 否 (0 指令) | 完全无开销 (0 Byte) |
函数/类文档字符串 ("""doc""") |
编译与运行期 | Compiler / PVM | 是 (Constant) | 是 (存入常量池) | 占用字符串对象内存 |
代码块孤立字符串 ("""memo""") |
编译期被丢弃/优化 | Parser / Optimizer | 是 (Expr 节点) | 可能优化消除 | 编译期微量开销 |
编码声明 (# coding: utf-8) |
源码读取期 (Pre-scan) | Source Reader | 否 | 否 | 仅在加载文件时解析一次 |
脚本头 (#!/usr/bin/env ...) |
进程创建启动期 | OS 内核 (execve) | 否 | 否 | 操作系统进程调度开销 |
类型忽略 (# type: ignore) |
CI/编译前静态检查 | Mypy / Linter | 否 | 否 | PVM 执行期完全零开销 |
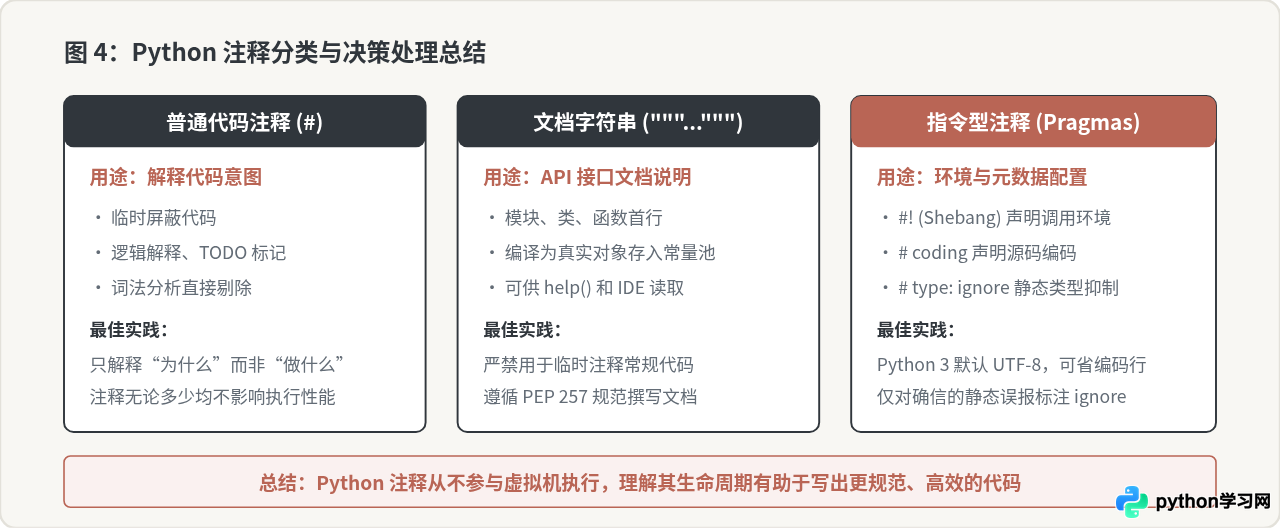
- 不要担心写太多注释会拖慢代码运行速度:因为所有的
#注释在词法分析阶段就已经被彻底清除,编译后生成的.pyc文件和内存中的虚拟机栈帧都不包含任何注释文本,注释行数增加对运行速度的影响为绝对零。 - 切勿使用多行三引号字符串临时屏蔽大块代码:三引号字符串在语法分析中是合法的表达式语句,不仅会在 AST 中创建节点,如果位置敏感还会污染函数的
__doc__属性,甚至在未被优化消除时占用常量池内存。临时屏蔽代码应统一使用现代编辑器的批量单行注释快捷键(如Ctrl + /或Cmd + /)。 - 区分文档与实现细节:接口调用说明、参数类型与返回值使用标准的函数 Docstring;而实现内部的算法逻辑、设计折衷与注意事项,务必使用行内
#注释。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















