


Python字符串常用内置方法详解:split、join与replace用法
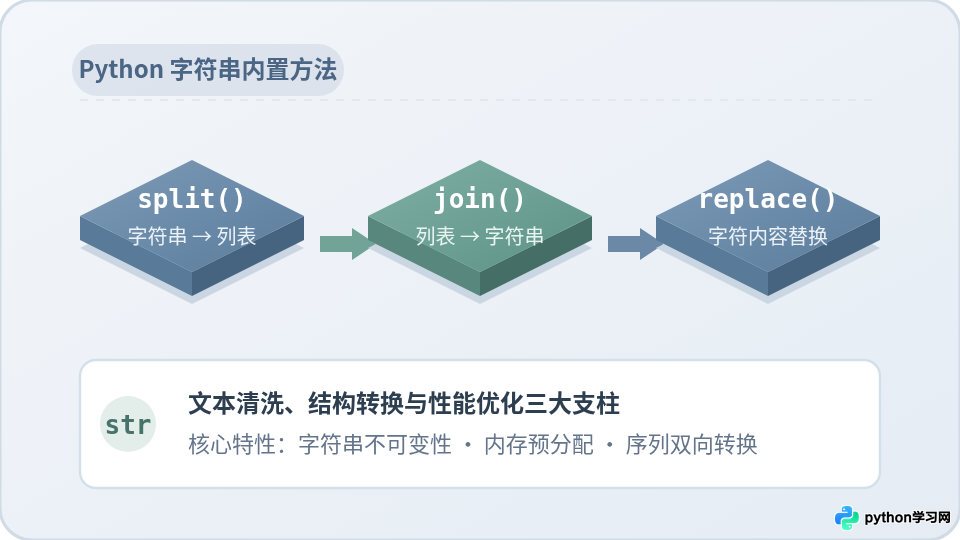
深入解析 Python 常用字符串内置方法 split、join 与 replace 的核心语法、参数细节、执行机制、性能特征与实际应用场景,通过直观的结构图示全面掌握字符串处理关键技术。
在 Python 的文本解析与数据处理任务中,字符串的切分、拼接与内容替换是最基础且高频的操作。str.split()、str.join() 与 str.replace() 分别承担了将字符串解构为列表、将序列重组成字符串,以及在原字符序列基础上创建修改后副本的核心职责。由于 Python 字符串具有天然的“不可变性”(Immutability),理解这三个方法的底层参数规则、返回值类型以及内存分配逻辑,是编写出健壮、高效文本处理程序的关键。
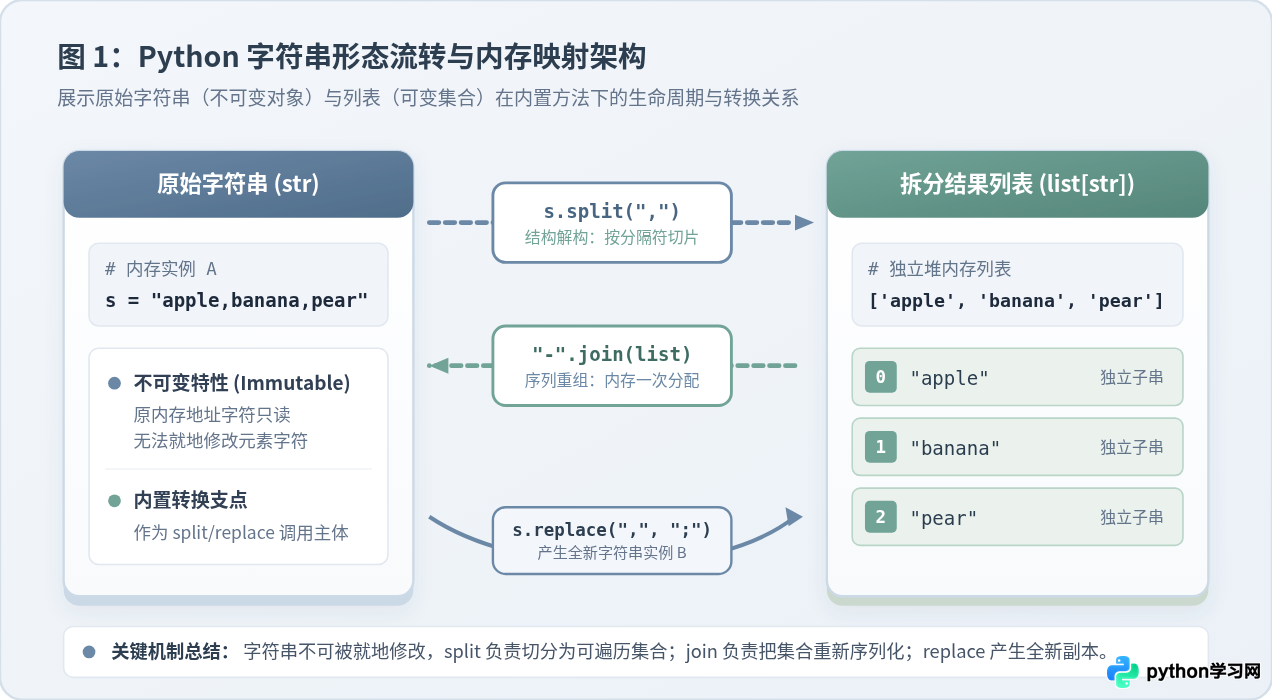
字符串不可变性与集合流转架构
在深入具体方法之前,需要建立一个明确的认知:Python 中的字符串对象一旦在内存中创建,其内部的字节序列便无法被就地修改。无论是调用 split() 还是 replace(),都不会改变变量最初绑定的原字符串对象,而是生成全新的数据容器或新字符串。
split() 与 join() 构成了一对互逆的形态转换工具:split() 负责将不可变的单体字符串按照特定规则打散为可迭代的动态列表(list[str]),以便进行索引提取、循环过滤或重排序;当元素清洗完毕后,join() 则利用指定的分隔符将列表中的子项重新压缩聚合为一条新的不可变字符串。而 replace() 则专注于在字符串内部进行子串模式匹配,并直接生成替换后的全新字符串对象。
一、split():字符串的结构化拆分
str.split() 的核心功能是按照指定的分隔符,将一个长字符串拆分为包含多个子字符串的列表。它的标准语法定义如下:
str.split(sep=None, maxsplit=-1)
1.1 sep 参数:默认空白吞咽 vs 指定单字符分隔
很多初学者容易忽略 sep=None 与 sep=" "(显式指定空格)之间的本质差异。这是实际开发中最容易产生意外空字符串的边界之一:
- 当
sep=None(默认缺省时):Python 会采用特殊的“空白字符压缩算法”。它会将空格、制表符(""。 - 当显式指定
sep=" "时:Python 会严格按照“单个空格”进行切分。若存在连续空格,相邻两个空格之间会被判定为一个长度为 0 的内容,从而在列表中保留空字符串"";字符串开头或结尾的空格也会在对应侧产生空字符串。
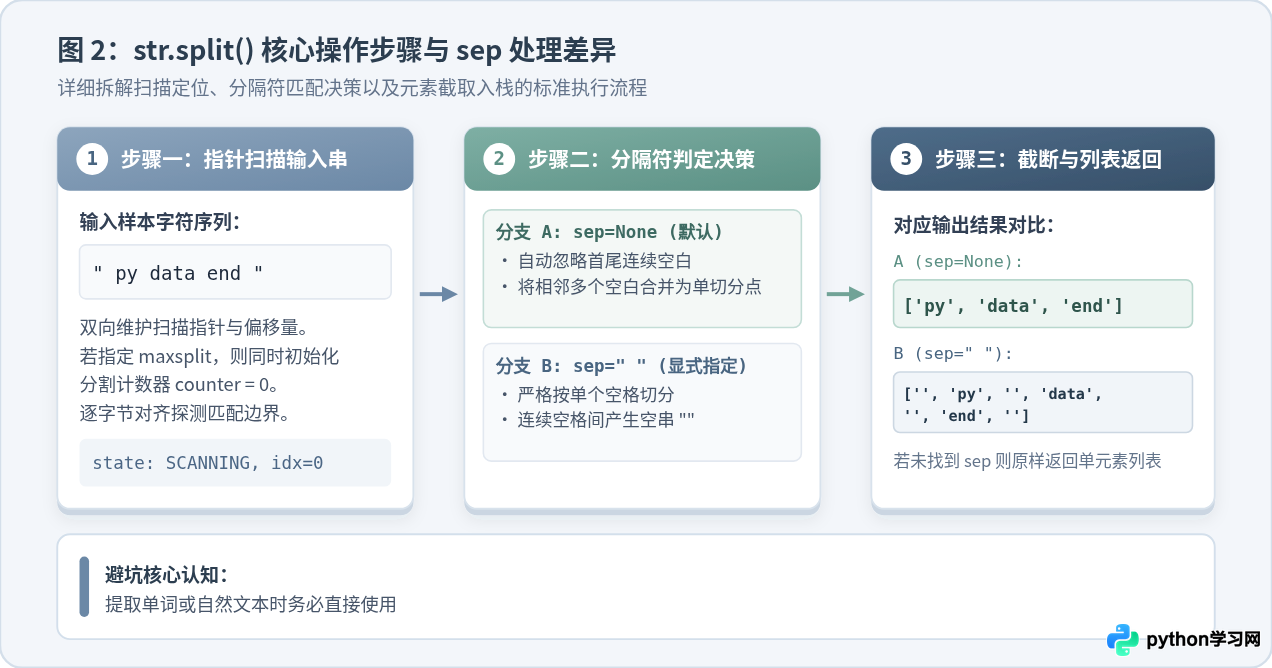
下面通过具体代码观察这两种策略在处理相同多空格输入时的输出差异:
# 包含多余前导、尾随空格及连续空格的样本
raw_text = "   Python    Data   Science   "

# 1. 采用默认 sep=None
result_default = raw_text.split()

# 2. 显式指定单空格 sep=" "
result_explicit = raw_text.split(" ")

print("默认缺省结果:", result_default)
print("指定单空格结果:", result_explicit)
当目标是提取文本中的自然单词或字段,且文本中可能混杂不规则空格或制表符时,应始终直接调用无参的 text.split(),避免使用 text.split(' ') 引入大量脏空串。
1.2 maxsplit 参数:控制切分次数与保留尾部
参数 maxsplit 用于限制拆分的最大次数,默认值为 -1,表示不设上限、完全切分。如果设置为正整数 $K$,则拆分只会发生前 $K$ 次,剩余未切分的整个后缀内容将完整保存在列表的最后一个元素中,最终返回的列表长度最多为 $K + 1$。
这一特性在解析“键值对”或特定报文协议时极为实用。例如解析配置项 key=value1=value2 时,通常只希望在第一个等号处断开:
config_entry = "database_uri=postgresql://user:secret@localhost:5432/app_db"

# 仅切分 1 次,确保连接字符串中的冒号或额外符号不被破坏
parts = config_entry.split("=", 1)

key = parts[0]
val = parts[1]

print(f"Key: {key}")
print(f"Val: {val}")
print(f"列表长度: {len(parts)}")
如果需要从字符串右侧开始限制切分次数,可以使用兄弟方法 rsplit()。例如从文件完整路径中只拆分出最后的扩展名或文件名时,rsplit('/', 1) 能直接分离目录路径与目标文件。
二、join():序列到字符串的高效拼接
join() 方法是 split() 的逆过程,负责将一个包含多个字符串的可迭代序列(列表、元组、集合或生成器)拼接为一个连续的字符串对象。其标准语法形式为:
separator.join(iterable)
2.1 设计思考:为什么是 separator.join(iterable)?
初学 Python 时常有疑问:“为什么不是 my_list.join(','),而是 ','.join(my_list)?”这种设计的根本原因在于接口解耦与类型通用性:
- 连接器(Separator)本身是一个字符串,而待拼接的数据源只要是任意的可迭代对象(Iterable)即可,包括列表(
list)、元组(tuple)、集合(set)、生成器表达式(generator)甚至是文件读取流。 - 如果将
join定义在list上,那么每当出现新的可迭代容器时,都需要重复实现一套拼接逻辑;将方法挂载在str上,只需保证容器内的元素是字符串,便能对所有可迭代对象提供一致的拼接能力。
2.2 核心限制:元素必须全为字符串类型
join() 对传入序列的元素类型有严格校验:可迭代对象中的每一个子项都必须是 str 实例。如果序列中混入了整数、浮点数或 None,解释器将立即抛出 TypeError。
id_list = [101, 204, 308, 412]

# 错误写法:",".join(id_list) 会引发:
# TypeError: sequence item 0: expected str instance, int found

# 正确做法:使用生成器表达式或 map 将各元素转换为字符串
joined_str = ",".join(str(item) for item in id_list)
print("拼接结果:", joined_str)
2.3 性能机制:join() 相比循环 '+' 累加的决定性优势
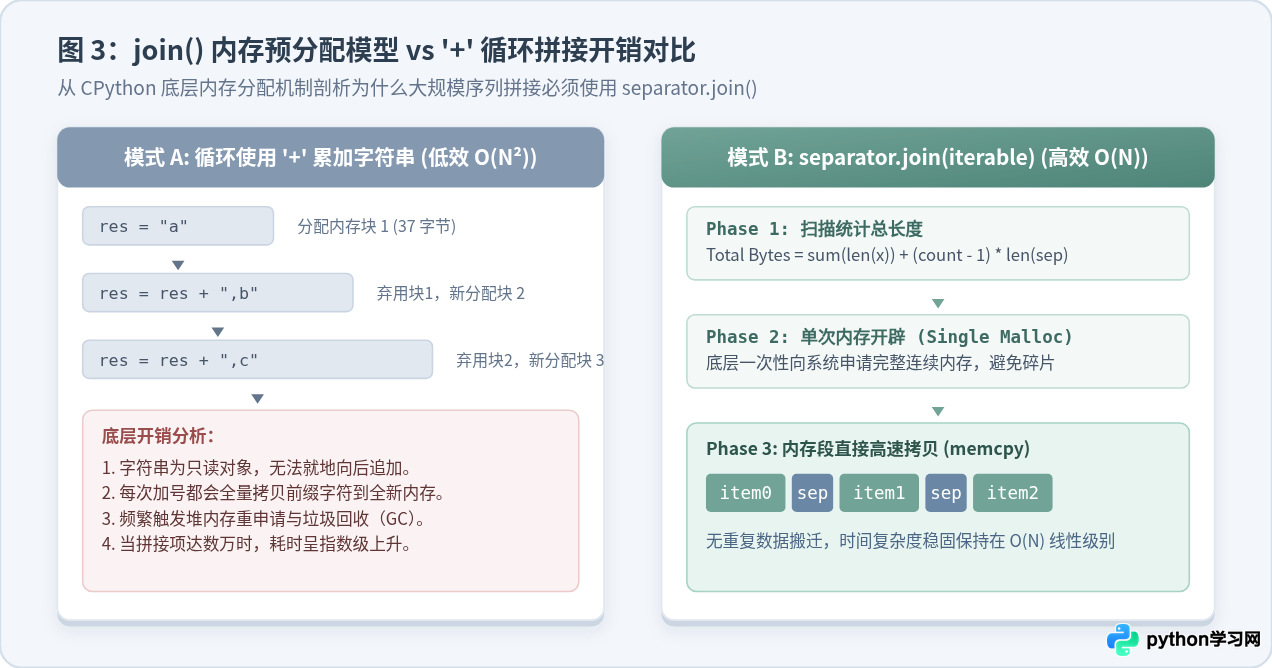
在需要拼接成千上万个子串时,绝不应该在 for 循环中使用 s = s + item。由于 Python 字符串在 CPython 底层对应只读的 PyUnicodeObject,每次执行加号拼接,底层都必须重新开辟一块更大的堆内存,并将之前累积的所有字符全量拷贝到新区域。当拼接 $N$ 个字符串时,总拷贝次数呈等差数列累积,整体时间复杂度急剧恶化至 $\mathcal{O}(N^2)$。
相比之下,separator.join() 采用了高效的两阶段内存预分配机制:
- 第一阶段(统计尺寸):首先以 $\mathcal{O}(N)$ 线性遍历一遍序列,计算所有子串长度以及所需分隔符的总字符数。
- 第二阶段(单次开辟与内存拷贝):向操作系统申请一块刚刚好能够容纳最终结果的连续内存缓冲区,随后通过底层 C 语言级的
memcpy高速将各子串与分隔符依次灌入。整个过程仅发生一次内存分配,时间复杂度保持为纯粹的 $\mathcal{O}(N)$。
三、replace():字符串内容的精准替换
str.replace() 用于将字符串中所有或指定次数的旧子串替换为新子串。其语法形式如下:
str.replace(old, new, count=-1)
3.1 原理验证:原地修改与返回值
再次强调不可变性原理:调用 text.replace("a", "b") 之后,text 变量指向的字符串对象没有任何变化。必须通过重新赋值或接收返回值,才能获取包含替换结果的新字符串:
original = "alpha-beta-gamma"

# 错误认知:以为执行了就地替换
original.replace("-", "_")
print("未接收返回值:", original)  # 原串依然不变

# 正确做法:接收生成的新对象
modified = original.replace("-", "_")
print("接收新字符串:", modified)
print("内存地址是否相同:", id(original) == id(modified))
3.2 count 参数的控制与链式替换
参数 count 用于指定替换的最大频次。当明确只需替换首次匹配项(例如模板标记或局部修饰)时,传入 count=1 可以避免后续内容被意外篡改,同时减少无效的扫描工作:
template = "User: [NAME], Role: [ROLE], Sign: [NAME]"

# 仅替换第 1 个 [NAME],保留后续项用于二次比对
step1 = template.replace("[NAME]", "Alice", 1)

# 链式连续替换多个模式
clean_query = "SELECT * FROM  tbl   WHERE id = 1"    .replace("tbl", "users")    .replace("id = 1", "status = 'ACTIVE'")

print("受限替换:", step1)
print("链式替换:", clean_query)
如果需要同时替换成百上千个单个字符的映射(例如去除所有标点),链式调用多次 replace() 会产生多个中间临时字符串。此时应优先使用 str.maketrans() 配合 str.translate()。而如果替换规则涉及模糊匹配、通配符或动态模式提取,则应选用标准库的正则表达式模块 re.sub()。
四、综合实战:构建数据清洗与规范化流水线
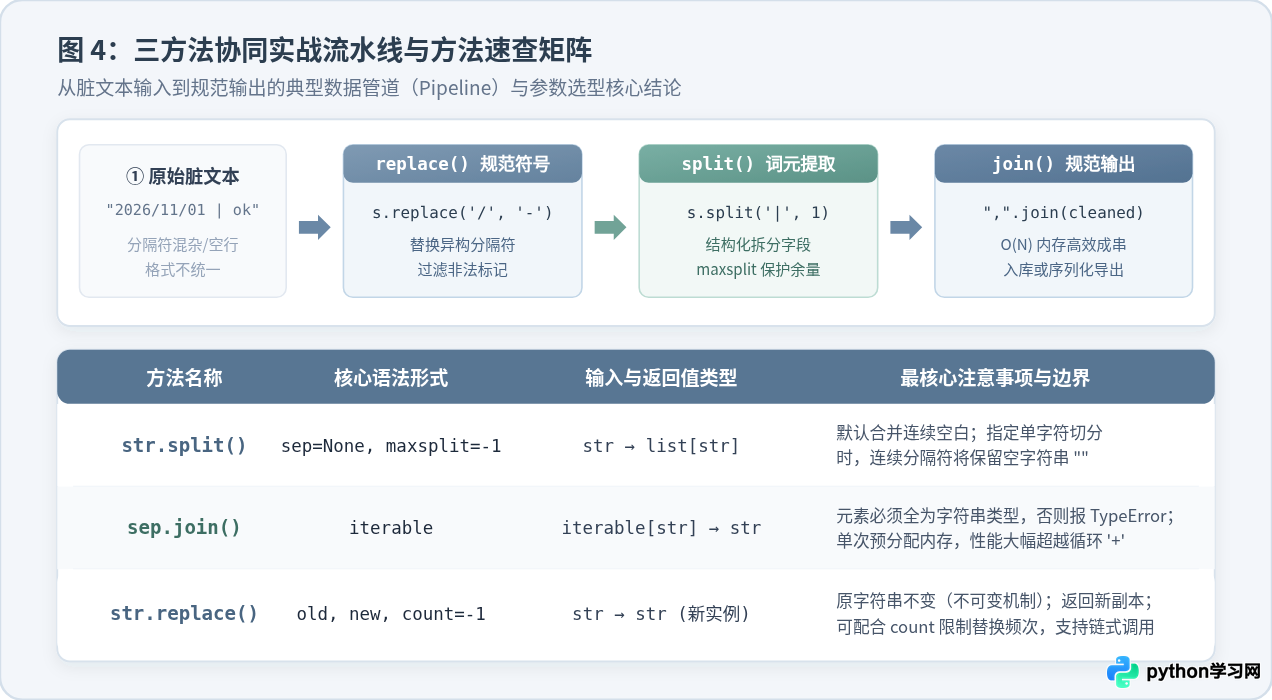
在日志解析、爬虫数据萃取或 CSV 报表加工中,replace、split 与 join 经常以组合拳的形式协同工作。典型的清洗流程通常包含三个阶段:
- 预处理与符号归一化:使用
replace()剔除异常标点或将异构分隔符统一为标准标识。 - 结构化抽取与过滤:使用
split()将长文本分解为词元列表,并借助列表推导式或生成器剔除多余空白项与空字符串。 - 序列重组与格式导出:使用
join()将校验合规的字段重新组装为标准格式的记录行。
# 模拟一条来源不规范的日志文本:包含斜杠日期、制表符分隔、多余首尾空格
dirty_log = "  2026/11/01 	 ERROR 	 [DB_CONN_TIMEOUT] 	 Retry-Count:3   "

# 步骤 1:利用 replace 统一时间格式中的分隔符
normalized_date = dirty_log.replace("/", "-")

# 步骤 2:利用 split 默认切分机制,自动剥离首尾多余空白,并将制表符整体打散
tokens = normalized_date.split()

# 步骤 3:对字段进行清洗与轻度加工(提取模块标记)
cleaned_tokens = [tok.strip("[]") for tok in tokens]

# 步骤 4:利用 join 组装为符合标准 CSV 规范的逗号分隔行
standard_csv_line = ",".join(cleaned_tokens)

print("提取的词元列表:", cleaned_tokens)
print("最终规范输出行:", standard_csv_line)
五、核心方法快速查阅表
为了在实际编码时快速做出准确的技术选型,下表汇总了这三个内置方法的核心参数、数据流向及常见陷阱:
| 方法名称 | 典型调用方式 | 返回值类型 | 时间复杂度 | 核心注意事项 |
|---|---|---|---|---|
str.split() |
s.split(sep=None, maxsplit=-1) |
list[str] |
$\mathcal{O}(N)$ | 默认 sep=None 合并空白并清理首尾;指定单个字符切分时不压缩连续分隔符。 |
str.join() |
separator.join(iterable) |
str |
$\mathcal{O}(N)$ | 由分隔符字符串发起调用;容器内元素必须全是 str;底层单次预分配内存。 |
str.replace() |
s.replace(old, new, count=-1) |
str |
$\mathcal{O}(N)$ | 原字符串对象严格不可变,务必接收返回的新字符串;支持通过 count 限制替换次数。 |
综上所述,split 专精于将单体结构解构为离散元素,join 专注于将离散元素高效聚合为单体,而 replace 负责模式映射与局部修正。在日常开发中牢记 sep=None 的空白合并机制、join 的字符串类型约束与内存预分配优势,以及 replace 的不可变性,就能从容应对绝大多数日常文本处理场景。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















