


Python字符串切片生成的是新对象还是原引用?
发布时间:2026-11-05 |
8人浏览过
深度解析 Python 字符串切片机制:切片究竟是生成独立新对象还是复用原引用?结合底层 CPython 对象内存结构、is 与 id 实验验证、全切片特例优化及高性能零拷贝方案进行详尽阐述。
Python 核心机制与性能实践
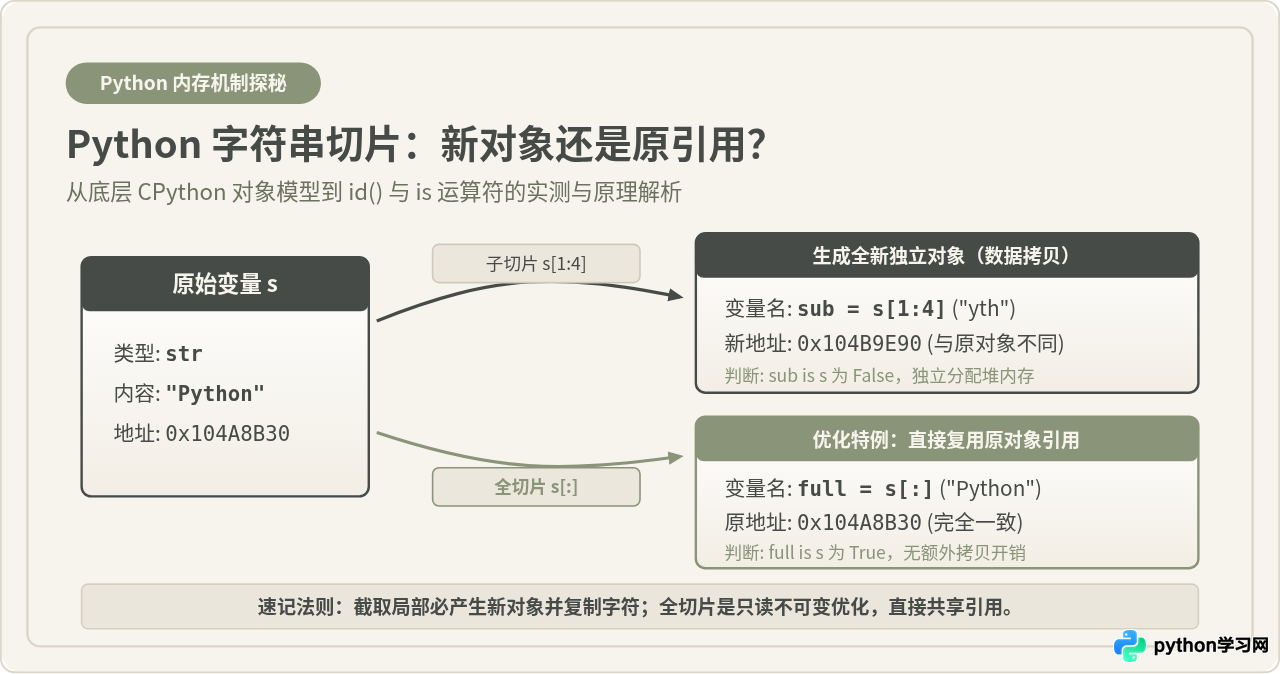
图 0:Python 字符串切片核心行为概览——普通子切片分配新对象与数据拷贝,全切片复用原引用
主题分类:Python 内部原理 / 内存模型 / 切片优化
核心答案:在 Python(CPython 标准实现)中,对字符串进行子切片操作(如
s[1:5])必然会生成一个全新的字符串对象,并在内存中独立复制对应区间的字符数据;但存在一个重要的例外优化——当切片范围覆盖整个字符串(如 s[:] 或 s[0:len(s)])时,CPython 出于节约内存与性能优化的考虑,会直接返回原字符串对象的引用。此外,空切片(如 s[3:3])通常直接复用全局唯一的空字符串单例。
一、为什么常规字符串切片必须生成新对象?
很多刚从其他语言(如 Go 的 string 切片视图或 C++ 的 std::string_view)转到 Python 的开发者,常常会潜意识地认为:“既然 Python 中的字符串是不可变类型(Immutable),那么切片操作完全可以只保存一个指向原字符串的指针、偏移量和长度,直接共享底层字符缓冲区,而无需重新分配内存。”
这种设想看似非常符合不可变对象的设计直觉,但在 Python 的官方 CPython 实现中,普通的子字符串切片并不会复用底层字符缓冲区,而是会完整分配一个全新的字符串对象并拷贝字符。要理解其背后的根本原因,需要深入观察 CPython 的内部对象模型。
1. CPython 中字符串的底层存储结构
在 Python 3 中,标准字符串是基于 PEP 393(灵活字符串表示)构建的。根据字符串内字符的最大 Unicode 码位,CPython 会在底层选用不同的紧凑结构(例如仅包含 ASCII 字符时使用 PyASCIIObject / PyCompactUnicodeObject)。
这种紧凑对象结构的特点在于:字符串的元数据头(引用计数、类型、长度、状态标志等)与实际的字符数据是在一段连续的内存块中一次性分配的。字符串末尾还会额外紧跟一个
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















