


怎么在Python数据库操作中防止SQL注入
深入解析在Python数据库开发中防止SQL注入的核心方法,通过原生驱动参数化查询、动态标识符白名单验证与ORM安全实践,彻底消除代码层面的SQL注入隐患。
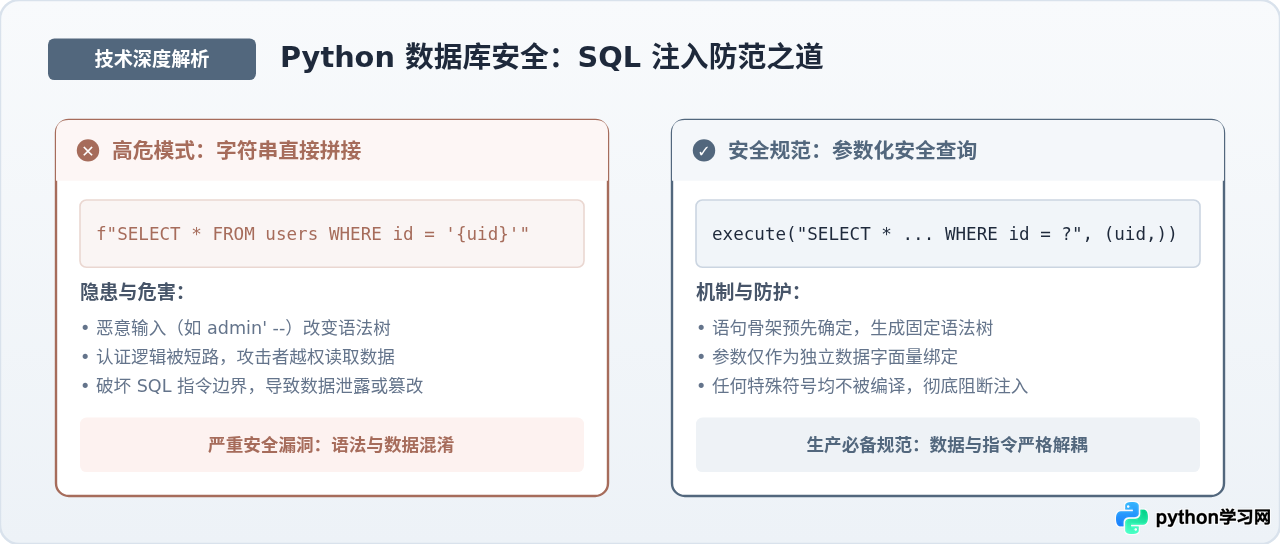
很多开发者在编写 Python 数据库交互代码时,习惯直接使用 Python 的字符串拼接方式(例如 f-string、加号运算符或 % 格式化)将变量塞进 SQL 语句中。这种写法在测试时看似运作顺畅,却把执行指令与输入数据的边界彻底抹去。防止 Python 数据库操作中出现 SQL 注入的核心手段,是彻底摒弃任何形式的字符串拼接,严格采用数据库驱动原生支持的参数化查询(Parameterized Queries),并在处理表名、列名等动态标识符时辅以严格的白名单校验与标识符安全转义。
一、字符串拼接为何必然引发 SQL 注入
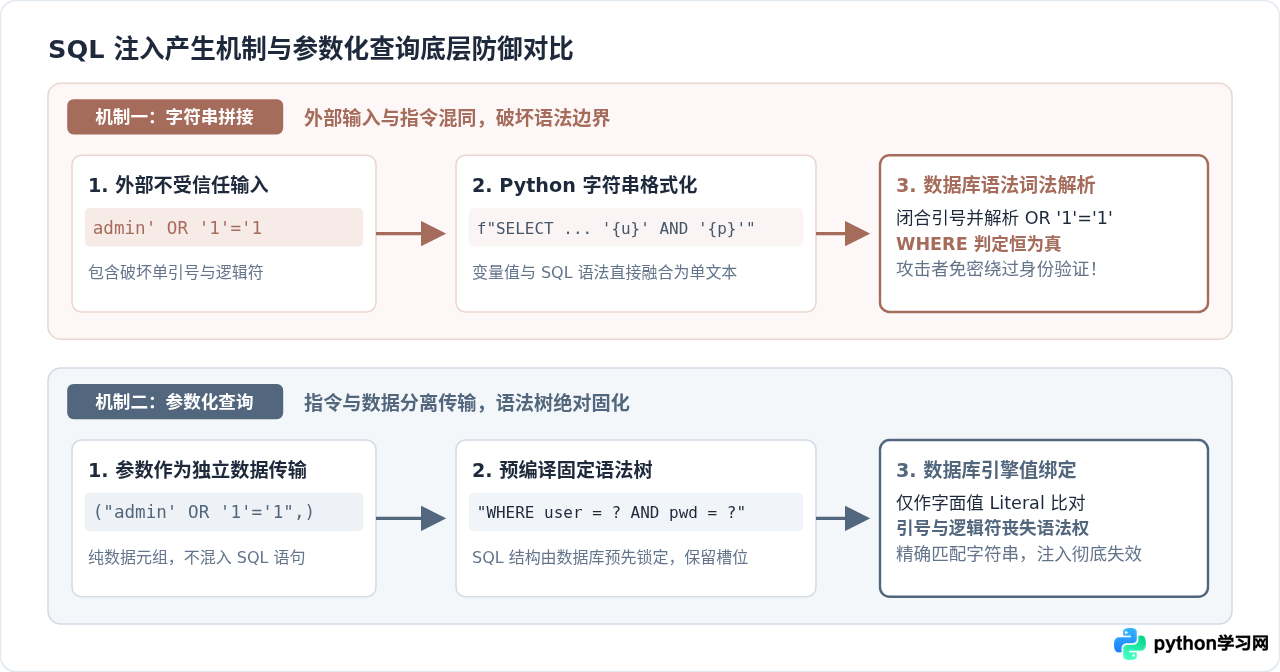
SQL 是一种解释型语言,数据库服务端接收到的是一段待解析的字符文本。当开发者在 Python 中使用字符串拼接来构造查询时,SQL 的控制语法与外部传入的数据在进入数据库之前就已经混淆为一个整体。数据库的词法与语法分析器无法感知哪些字符是开发者原本期望的固定逻辑,哪些字符是用户传入的动态数据。
观察下面这段常见的漏洞代码:
import sqlite3

def query_user_vulnerable(username, password):
    conn = sqlite3.connect("app.db")
    cursor = conn.cursor()
    # 危险示范:直接使用 f-string 拼接 SQL 语句
    sql = f"SELECT id, username FROM users WHERE username = '{username}' AND password = '{password}'"
    cursor.execute(sql)
    return cursor.fetchall()
当外部传入的 username 为普通字符串时,查询逻辑符合预期。但如果外部输入构造了恶意载荷,例如 admin' --,拼接后的完整 SQL 将变为:
SELECT id, username FROM users WHERE username = 'admin' --' AND password = '...'
在 SQL 标准规范中,-- 代表单行注释。数据库解析器解析到该位置时,认为条件判断已经结束,后续用于核验密码的逻辑被全部注释丢弃。最终,查询直接以管理员身份匹配成功,攻击者在完全不知道密码的情况下完成了越权登录。
问题的症结在于:试图在 Python 层面用正则清洗特殊符号(如单引号或连字符)是不可靠的。数据库支持多种字符集编码、转义规则与宽字节特性,黑名单式的自制过滤极难穷尽所有绕过路径。要彻底规避这一风险,必须从底层改变数据的传递方式。
二、Python 原生驱动参数化查询的标准规范
参数化查询(在底层通常对应预编译语句 Prepared Statements)从根本上解决了上述混同问题。它的工作机制是“分离传输”:数据库引擎首先接收包含占位符的 SQL 结构模板,对其进行语法分析并生成固定的抽象语法树(AST);随后,驱动程序将外部变量作为纯粹的字面量(Literal Value)填入对应槽位。
在此机制下,即便用户输入包含了单引号、分号或注释符,数据库也只会将其当作字符串本身的内容进行等值匹配,绝对不会将其解析为控制指令。
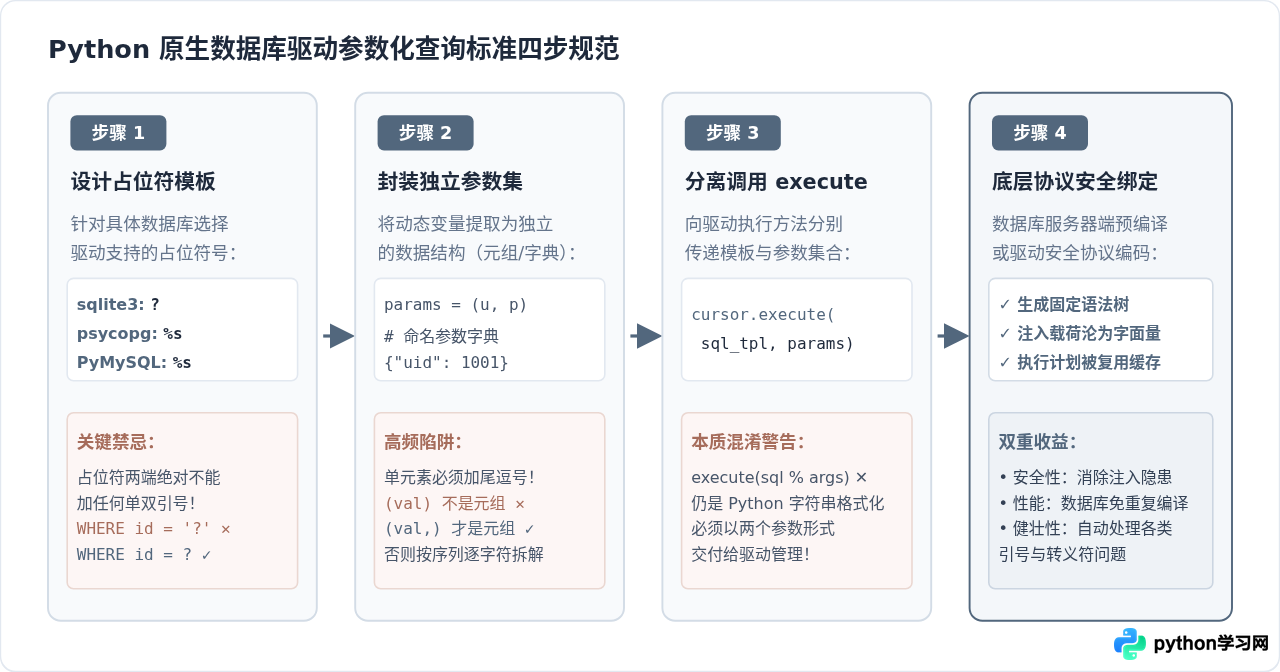
1. 四步标准操作流程
- 使用驱动规定的占位符替换动态变量:在编写 SQL 文本时,仅保留语句骨架,将所有动态数据替换为占位符。
- 提取并封装独立参数容器:将所有变量按占位符顺序封装为元组(tuple)或列表(list)。若使用命名占位符,则封装为字典(dict)。
- 以独立实参方式调用 cursor.execute():将 SQL 模板与参数容器作为两个独立的参数传递给执行函数,严禁在函数外部自行求值。
- 依赖驱动与底层协议安全绑定:底层通信协议将两部分分开传输并绑定,实现语法树与输入数据的彻底物理隔离。
2. 主流 Python 数据库驱动的占位符规范
不同数据库驱动在占位符的语法表示上存在差异,混用或记错占位符会导致语法错误。下表归纳了 Python 生态中最主流的数据库驱动占位符格式:
| 数据库 / 驱动 | 位置占位符 | 命名占位符 | 示例用法 |
|---|---|---|---|
| sqlite3(标准库) | ? |
:name |
cursor.execute("SELECT * FROM t WHERE id = ?", (uid,)) |
| PyMySQL / mysql-connector | %s |
%(name)s |
cursor.execute("SELECT * FROM t WHERE id = %s", (uid,)) |
| psycopg2 / psycopg(PostgreSQL) | %s |
%(name)s |
cursor.execute("SELECT * FROM t WHERE id = %s", (uid,)) |
| oracledb(Oracle) | :1, :2 |
:name |
cursor.execute("SELECT * FROM t WHERE id = :id", {"id": uid}) |
3. 正确编写的代码范例
在实际项目中,规范的代码应当如下所示:
import sqlite3

def query_user_secure(username, password):
    conn = sqlite3.connect("app.db")
    cursor = conn.cursor()

    # 正确示范:使用 ? 占位符,变量放入独立元组
    sql = "SELECT id, username FROM users WHERE username = ? AND password = ?"
    params = (username, password)

    cursor.execute(sql, params)
    return cursor.fetchall()

def query_user_by_id(user_id):
    conn = sqlite3.connect("app.db")
    cursor = conn.cursor()

    # 注意:单元素元组必须带有末尾逗号 (user_id,)
    sql = "SELECT id, username, email FROM users WHERE id = ?"
    cursor.execute(sql, (user_id,))
return cursor.fetchone()WHERE username = '?' 或 WHERE name = '%s',数据库引擎会将其解释为一个寻找字面值为问号或百分号字母的常量查询,参数将完全无法生效,甚至引发类型错误。
三、常见认知误区与动态标识符处理边界
在掌握了基础参数化之后,开发实践中常常出现两类较为隐蔽的错误。
误区一:混淆 Python 原生格式化与驱动占位符
这一误区在 MySQL 与 PostgreSQL 驱动中最具迷惑性。因为这些驱动采用 %s 作为占位符,恰好与 Python 旧式的 % 字符串格式化操作符相同。许多人无意间写出如下代码:
# 致命错误:虽然用了 %s,但触发了 Python 的 % 运算符!
cursor.execute("SELECT * FROM users WHERE username = %s" % (username,))
在这段代码中,括号内的格式化表达式在传入 execute 之前就已经被 Python 解释器执行完毕,本质上依然是将变量拼成裸字符串送入数据库,注入漏洞完全没有被消除。正确的做法始终是让 execute 接收两个独立的参数:
# 正确做法:由驱动接管 %s 的底层安全转义与参数绑定
cursor.execute("SELECT * FROM users WHERE username = %s", (username,))
误区二:试图对表名、列名与 ORDER BY 进行参数化
SQL 语法有着明确的边界:参数化查询只能绑定“数据值(Values)”,无法绑定“SQL 标识符(Identifiers)”或关键字。
如果尝试编写 cursor.execute("SELECT * FROM ?", (table_name,)),或者 cursor.execute("SELECT * FROM users ORDER BY ?", (column_name,)),数据库执行器会直接报错,或者将其作为普通常量处理(例如 ORDER BY 'created_at',由于排序目标是一个恒定字符串字面量,排序机制直接失效)。
在需要根据用户请求动态变更排序列或切换数据表时,唯一的安全策略是白名单映射校验(Whitelist Validation):
import sqlite3

# 1. 显式定义合法的列名与排序方向白名单映射
ALLOWED_SORT_COLUMNS = {
    "created_at": "created_at",
    "username": "username",
    "score": "score"
}
ALLOWED_DIRECTIONS = {
    "asc": "ASC",
    "desc": "DESC"
}

def fetch_users_sorted(sort_by, direction, min_score):
    conn = sqlite3.connect("app.db")
    cursor = conn.cursor()

    # 2. 严格核验入参是否位于白名单内
    col = ALLOWED_SORT_COLUMNS.get(sort_by)
    dir_val = ALLOWED_DIRECTIONS.get(direction.lower())

    if not col or not dir_val:
        raise ValueError(f"非法的排序参数: sort_by={sort_by}, direction={direction}")

    # 3. 经过白名单核验的受限安全常量可安全拼入结构;数据值 min_score 仍使用参数化
    sql = f"SELECT id, username, score FROM users WHERE score >= ? ORDER BY {col} {dir_val}"
    cursor.execute(sql, (min_score,))
    return cursor.fetchall()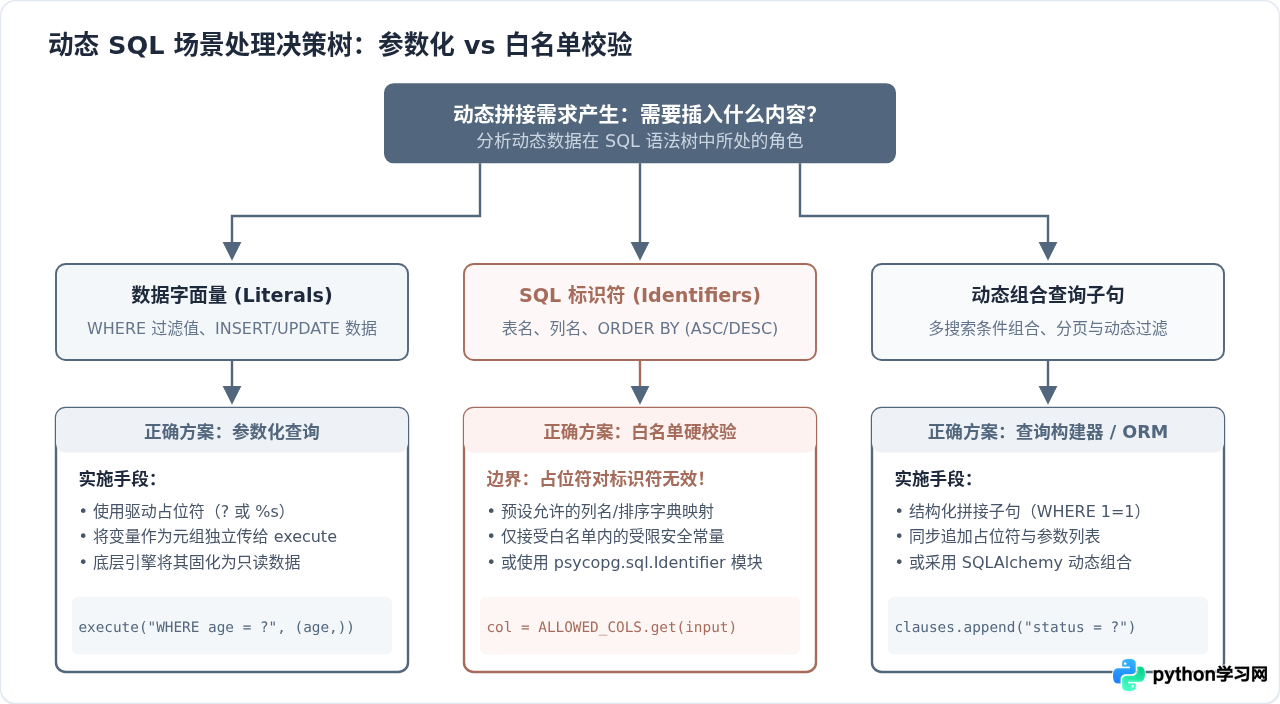
四、ORM 框架安全防线与纵深防御策略
在现代 Python 架构中,SQLAlchemy、Django ORM、Peewee 等对象关系映射工具得到了广泛应用。ORM 默认会将对象的属性过滤(例如 filter(User.username == name))在内部转换为参数化查询,从而在日常开发中自动化防御 SQL 注入。
然而,引入 ORM 并不代表可以高枕无忧。许多安全事故正是源自“以为使用了 ORM 就能随心所欲写原生 SQL”的松懈心理。例如在 SQLAlchemy 中使用 text() 执行复杂语句时,错误地插入了 f-string:
from sqlalchemy import text

# 危险反例:在 ORM 原生 SQL 中使用 f-string 拼接,防护形同虚设
session.execute(text(f"SELECT * FROM users WHERE username = '{username}'"))

# 正确做法:使用 SQLAlchemy 提供的命名绑定参数
stmt = text("SELECT * FROM users WHERE username = :uname")
session.execute(stmt, {"uname": username})- 数据库账号最小权限分配:Web 应用程序日常连接的数据库账号,严禁授予
DROP TABLE、ALTER TABLE等 DDL 权限;后台只读报表模块应使用专属的只读数据库账号。 - API 接入层强类型约束:在数据到达数据库驱动之前,使用 Pydantic、dataclasses 或框架表单验证组件进行强类型转换。将 ID 约束为
int或UUID,将枚举约束为固定集合,可在最外层剔除非法载荷。 - 持续集成自动化扫描:在 CI/CD 流水线中集成
bandit等静态代码分析工具,自动检出代码中潜在的execute字符串格式化特征,在代码合入前扼杀漏洞。
五、防护准则与核查总结
防范 SQL 注入的核心在于“确立数据与指令的清晰边界”。在日常编码与代码审查过程中,建议对照以下四项基本要求进行逐项核查:
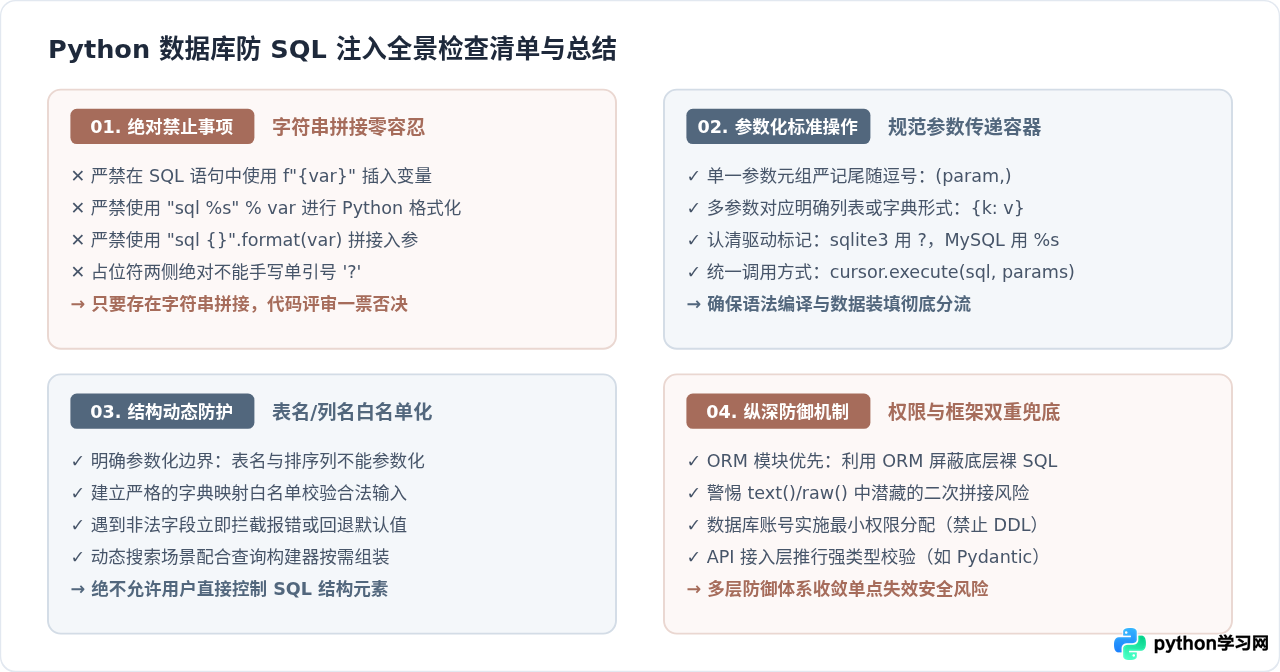
总结而言,凡是涉及变量传递的 SQL 执行场景,只要遵守“数据值必参数化、标识符必白名单、原生查询禁用 f-string”这三条基本准则,就能在 Python 数据库操作中构筑坚实的安全防线,彻底消除 SQL 注入漏洞隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















