


Python列表与字符串怎么取值?索引、切片及解包详解
全面解析Python中列表与字符串的三种核心取值方法:正负索引的定位与越界机制、切片步长与边界推导逻辑、以及常规解包与星号扩展解包的高效赋值与避坑技巧。
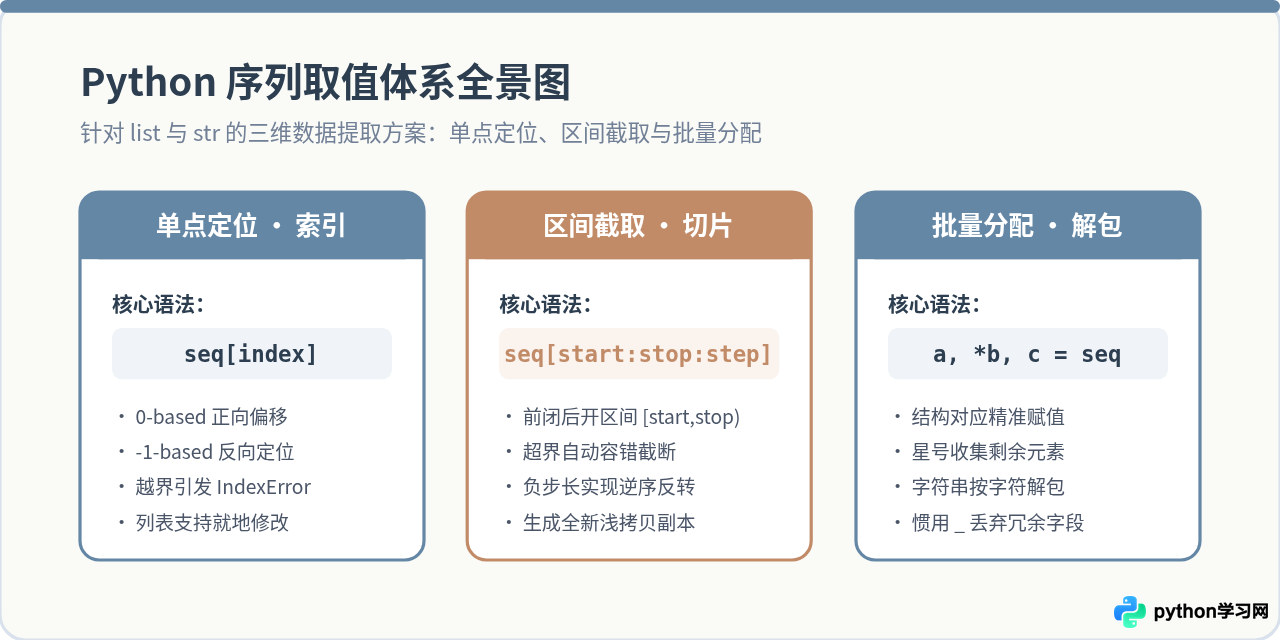
在 Python 中,列表(list)与字符串(str)都遵循序列(Sequence)协议。从这两种数据结构中取值,核心途径主要分为三类:利用索引(Indexing)定位单一元素、利用切片(Slicing)截取子区间、以及利用解包(Unpacking)完成多变量对应赋值。掌握它们的底层索引标定、边界容错特征与可变性限制,是准确提取数据并规避运行期报错的基础。
一、单元素定位:正负索引机制与越界防范
索引是访问序列中单个元素最直接的方式。Python 序列在内存中拥有连续的逻辑槽位,并支持两套对齐的坐标系统:从序列头部以 0 为起点的非负索引,以及从序列尾部以 -1 为起点的负数索引。
无论是列表还是字符串,都可以通过 seq[index] 语法读取指定位置的值。两者的行为差异在于:对字符串取单索引会返回一个长度为 1 的新字符串(因为 Python 没有单独的字符类型);对列表取单索引则直接返回存储在对应槽位上的对象引用。
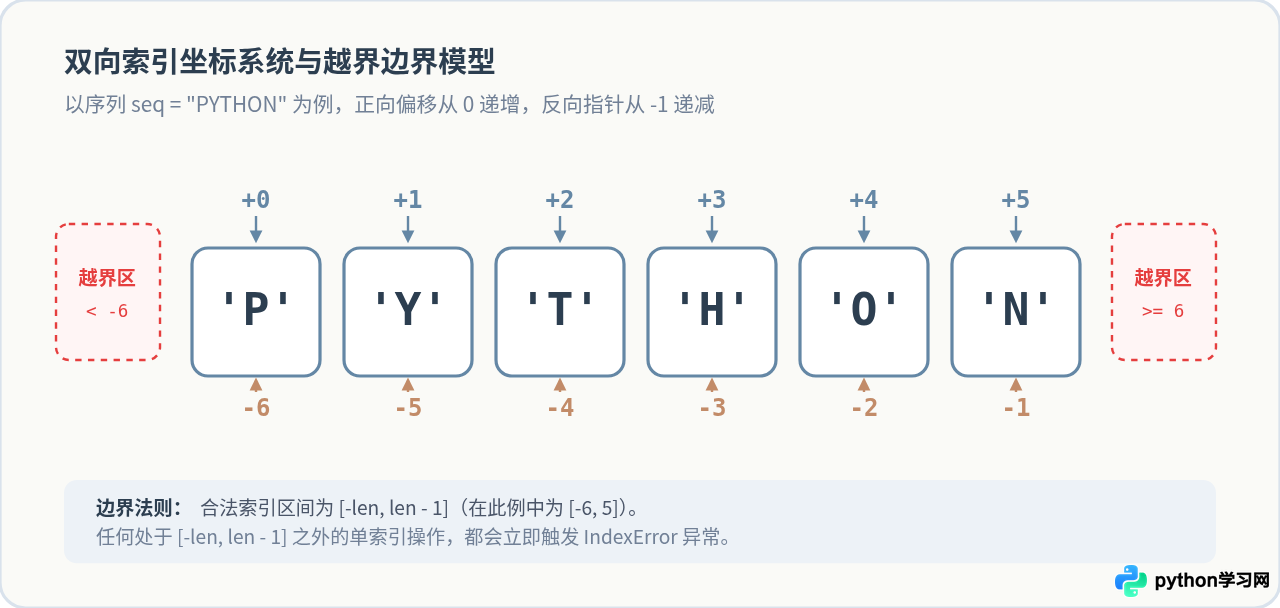
在索引取值时,最需要注意的规则是严格越界检查。如果序列的长度为 N,则合法正索引范围是 [0, N - 1],合法负索引范围是 [-N, -1]。一旦索引超出这一闭区间,Python 解释器会立即抛出 IndexError 异常。
# 定义演示列表与字符串
text = "Python"
fruits = ["apple", "banana", "cherry", "date"]

# 1. 正向索引提取
first_char = text[0]
first_fruit = fruits[0]

# 2. 负向索引提取末尾元素
last_char = text[-1]
second_last_fruit = fruits[-2]

print("text[0]:", first_char)
print("fruits[0]:", first_fruit)
print("text[-1]:", last_char)
print("fruits[-2]:", second_last_fruit)

# 3. 越界异常验证
try:
    invalid_item = fruits[10]
except IndexError as err:
print("捕获越界错误:", err)fruits[0]: apple
text[-1]: n
fruits[-2]: cherry
捕获越界错误: list index out of range
text[0] = "J" 将抛出 TypeError)。而列表属于可变对象(Mutable),可以通过合法的单索引直接覆写对应位置的元素(例如 fruits[0] = "avocado")。
二、子序列提取:切片(Slicing)语法与步长推导
当需要从序列中批量截取一段数据时,应当使用切片语法。切片的核心形式为 seq[start:stop:step],其中包含三个可选参数,均以冒号分隔:
start:提取区间的起始索引(包含该位置)。stop:提取区间的结束索引(不包含该位置,即数学上的左闭右开区间[start, stop))。step:步长,决定遍历方向与跳跃间隔,默认为1。
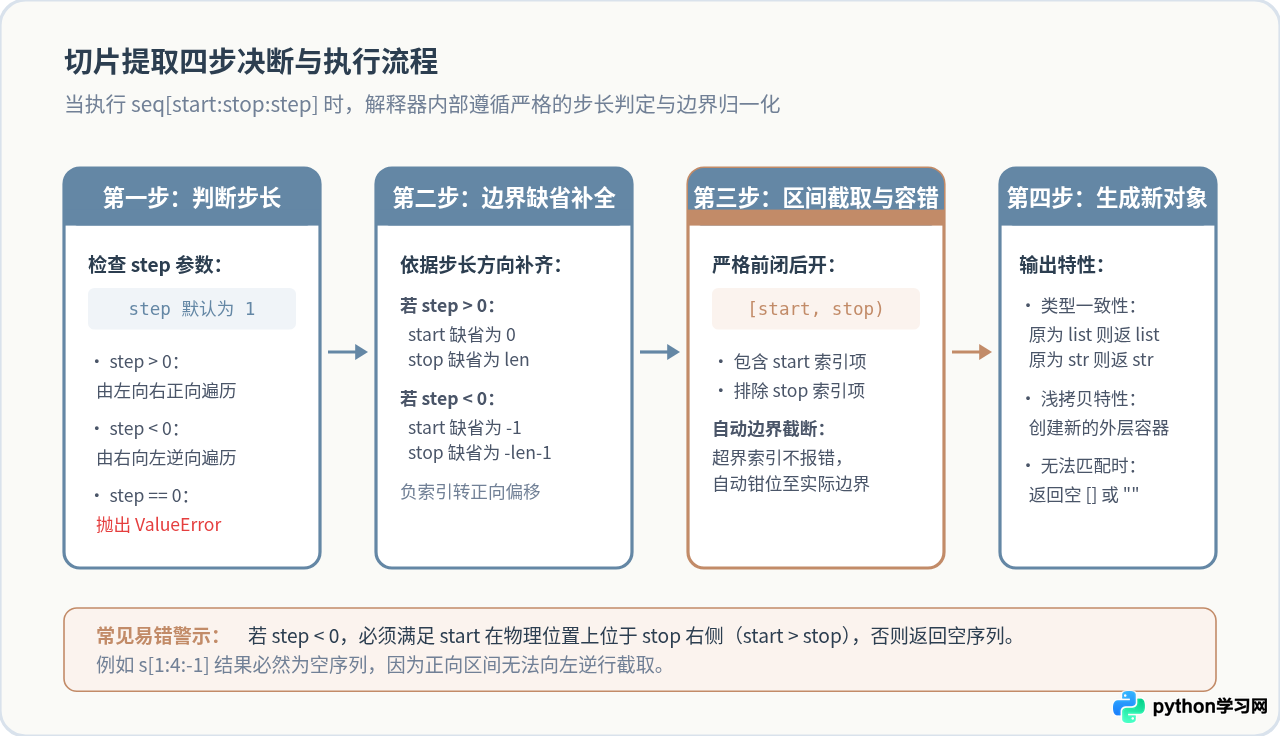
与单索引取值相比,切片最大的特性是自动边界容错截断。当 start 或 stop 超过序列实际长度时,Python 不会抛出 IndexError,而是自动将边界限制在序列两端。如果给定的区间无法匹配到任何元素,切片会安全地返回同类型的空对象(列表返回 [],字符串返回 "")。
1. 正向步长切片与默认参数
当 step > 0 时,遍历方向为从左向右:若省略 start,默认从头部 0 开始;若省略 stop,默认延伸到序列末尾包含所有元素。例如 seq[:] 表示从头到尾的完整浅拷贝。
2. 负向步长与逆序反转
当 step < 0 时,遍历方向变为从右向左:此时若省略 start,默认从末尾 -1 开始;若省略 stop,默认向左遍历直至越过头部。因此,seq[::-1] 是 Python 中反转字符串或列表的标准惯用法。
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
message = "Hello, World!"

# 1. 基础区间截取 [start:stop]
sub_num = numbers[2:6]        # 索引 2 到 5
sub_str = message[7:12]       # 索引 7 到 11

# 2. 步长采样与边界省略
evens = numbers[::2]          # 每隔 2 个取一个
tail = message[7:]            # 从索引 7 直到结尾

# 3. 逆向步长与反转
reversed_str = message[::-1]  # 完整反转
sub_reverse = numbers[8:2:-2] # 从 8 开始向左走,每次跳 2 格

# 4. 超界容错测试(不会抛出 IndexError)
out_of_bounds = numbers[8:100]

print("numbers[2:6]    :", sub_num)
print("message[7:12]   :", sub_str)
print("numbers[::2]    :", evens)
print("message[7:]     :", tail)
print("message[::-1]   :", reversed_str)
print("numbers[8:2:-2] :", sub_reverse)
print("numbers[8:100] :", out_of_bounds)message[7:12] : World
numbers[::2] : [0, 2, 4, 6, 8]
message[7:] : World!
message[::-1] : !dlroW ,olleH
numbers[8:2:-2] : [8, 6, 4]
numbers[8:100] : [8, 9]
start 在物理位置上位于 stop 的右侧。例如 numbers[1:5:-1] 会得到空列表 [],因为从索引 1 无法通过负步长到达索引 5。
三、结构化提取:常规解包与星号(*)扩展解包
当需要从序列中同时提取多个位置的元素并赋予独立变量时,解包(Unpacking)比反复调用索引更加直观与优雅。
1. 等量基础解包
在基础解包中,左侧变量的数目必须与右侧序列的长度严格相等。如果左侧变量数量少于或多于序列元素个数,解释器会抛出 ValueError。
2. 星号扩展解包(Extended Iterable Unpacking)
Python 3 引入了带星号的扩展解包语法(*rest)。它允许在解包时指定一个收集器变量,该变量会以 list 的形式自动吸收所有未被固定变量匹配的剩余元素。这种模式非常适合用于提取“首尾项”或“固定头部+不定长尾部”的数据结构。
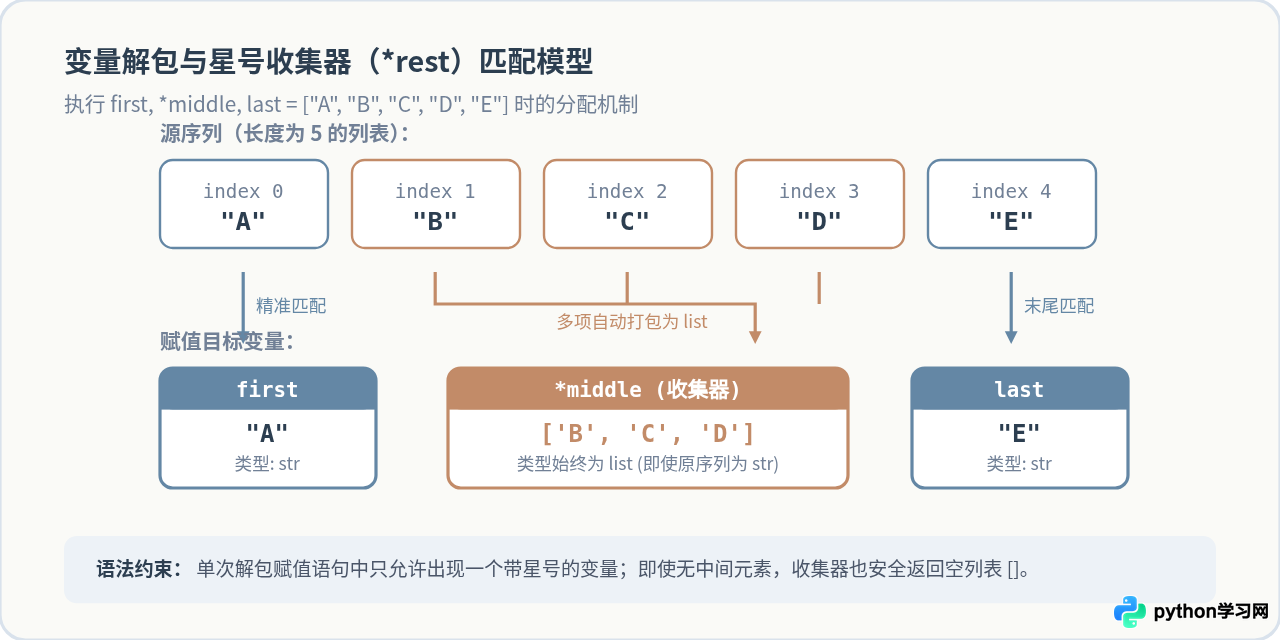
# 1. 基础精确解包
coord = [100, 200]
x, y = coord

# 2. 星号解包提取头部、中间与尾部
records = ["Alpha", "Beta", "Gamma", "Delta", "Omega"]
first_item, *middle_items, last_item = records

# 3. 丢弃不需要的字段(惯用单下划线 _)
head, *_, tail = records

# 4. 字符串的逐字符解包
code = "VIP"
c1, c2, c3 = code

print(f"坐标解包: x={x}, y={y}")
print(f"首项: {first_item}, 尾项: {last_item}")
print(f"中间项收集器 (*middle_items): {middle_items} (类型: {type(middle_items).__name__})")
print(f"首尾保留并忽略中间项: head={head}, tail={tail}")
print(f"字符串解包: c1={c1}, c2={c2}, c3={c3}")首项: Alpha, 尾项: Omega
中间项收集器 (*middle_items): ['Beta', 'Gamma', 'Delta'] (类型: list)
首尾保留并忽略中间项: head=Alpha, tail=Omega
字符串解包: c1=V, c2=I, c3=P
*a, *b = seq 属于非法语法,会触发 SyntaxError)。另外,无论原序列是列表还是字符串,带星号变量收集到的值始终为 list 类型。
四、序列取值方式对比与避坑指南
为了在实际开发中做出最合适的取值选型,需要全面了解索引、切片和解包在异常边界、内存占用和可变性上的差异:
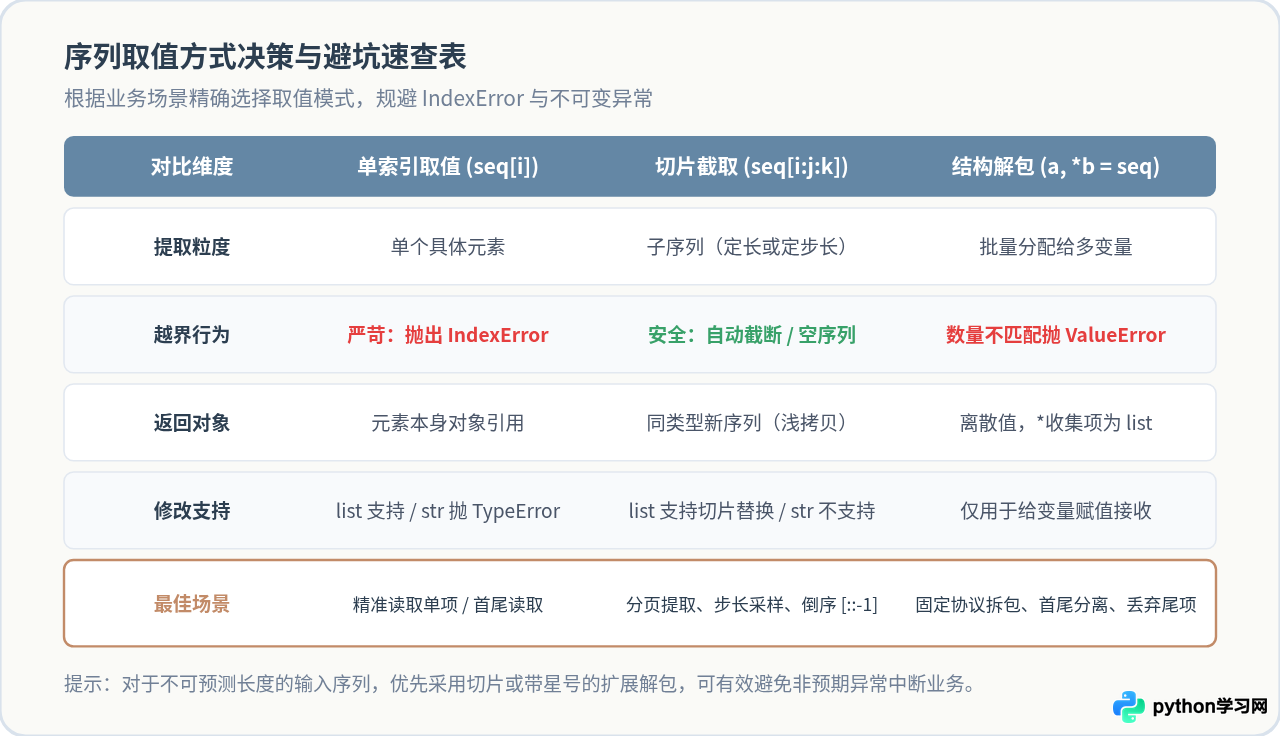
1. 内存机制与浅拷贝
单索引提取元素时,拿到的是对应元素的直接引用,不会产生新的容器;解包则是将引用分散赋给具体变量。切片操作则不同:对列表进行切片会开辟一块新的内存,生成一个包含子区间元素引用的全新列表对象(浅拷贝)。如果原列表中包含可变嵌套对象(如嵌套列表或字典),修改切片中的嵌套元素仍会影响原列表。
2. 取值模式选型建议
- 使用单索引(
seq[i]):适用于明确知道目标位置(例如获取首项seq[0]、末尾seq[-1])的场景。调用前应确保索引未越界,或配合异常捕获使用。 - 使用切片(
seq[start:stop:step]):适用于需要截取连续段落、每隔固定步长采样或反转序列的场景。在外部数据长度不确定时,切片的高容错特性能够有效防止程序崩溃。 - 使用解包(
first, *rest = seq):适用于具有明确结构的数据元组或列表解析。相较于编写多行下标取值(如a=s[0]; b=s[1:]),解包更加地道且语义清晰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















