


Python列表与字典常用操作代码:增删改查及遍历
系统详解Python列表(List)与字典(Dictionary)的核心增删改查方法、遍历技巧、底层内存与哈希寻址机制、复杂度对比及常见工程避坑实践。
list)与字典(dict)是最常用的两种复合数据结构。列表是基于连续内存地址的动态有序序列,适合依赖索引顺序和支持重复元素的数据集;字典则是基于散列表(Hash Table)的键值对容器,擅长通过唯一标识进行高速查找。掌握两者的增、删、改、查与遍历代码及其底层时空复杂度差异,是编写健壮、高效 Python 代码的核心基础。
一、列表(List)的增删改查基础与代码实践
Python 中的列表属于变长数组(Dynamic Array),内部存储的是连续的指向具体 Python 对象的指针。访问特定索引元素的时间复杂度为常数级 O(1),但在中间插入或删除元素会引起后续指针的整体搬移。
1. 增加元素:append、insert、extend 与拼接
列表提供了多种追加或插入数据的方法,其适用条件与执行效率各有侧重:
append(x):将元素作为一个整体追加至列表末端。时间复杂度为均摊O(1),是日常最推荐的单元素添加方式。insert(index, x):在指定索引位置插入元素。插入位置后续的所有元素都会向后移动一位,时间复杂度为O(n)。extend(iterable):接收一个可迭代对象,逐个解包并追加到列表末尾,原地修改原列表。+运算符:新建并返回一个合并后的全新列表,不会改变原列表,但需要为新列表分配全新内存。
# 列表新增操作示例
scores = [85, 92]

# 1. 末尾追加单元素
scores.append(88)

# 2. 指定位置插入(在索引 1 处插入 99)
scores.insert(1, 99)

# 3. 批量追加可迭代对象
scores.extend([76, 84])

# 4. 加号拼接(生成新列表)
extra_scores = scores + [95, 100]

print("原地操作后 scores:", scores)
print("拼接生成的新列表 extra_scores:", extra_scores)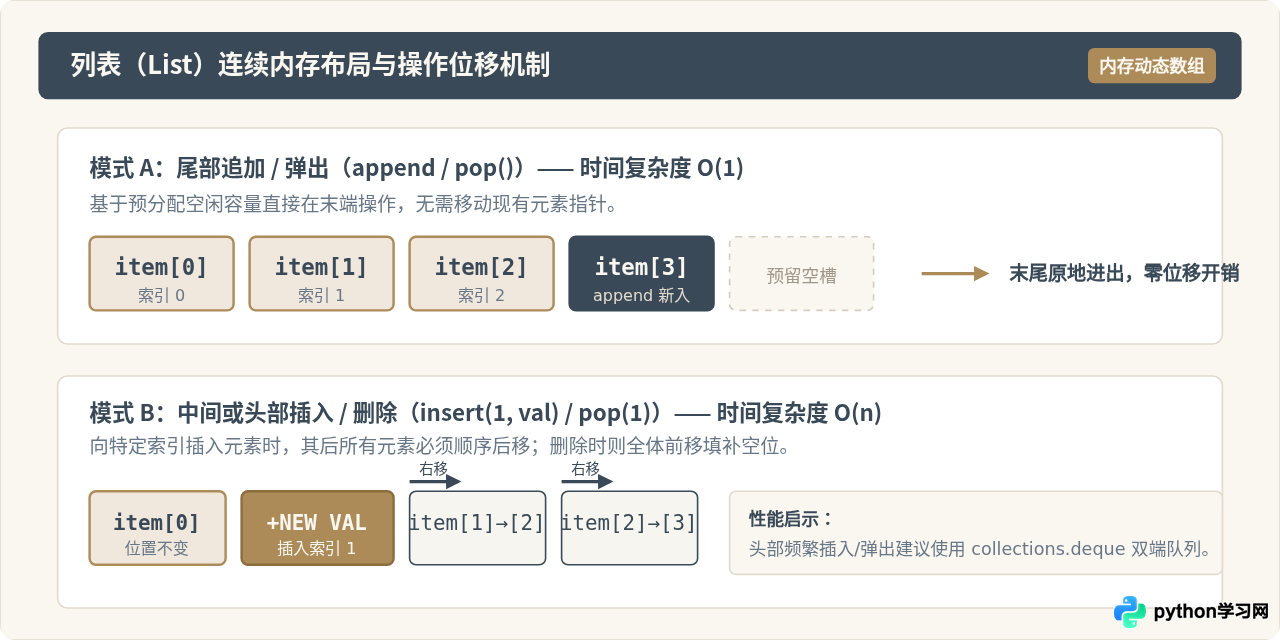
2. 删除元素:pop、remove、del 与 clear
根据删除依据(依据索引、依据值、或者彻底清空),选择对应的操作命令:
pop([index]):移除并返回指定索引处的元素。若省略参数,默认弹出末尾元素pop(),耗时O(1);若指定非末尾索引(如pop(0)),耗时O(n)。索引越界时抛出IndexError。remove(value):按值查找并移除首次出现的匹配项。需要遍历比对元素,耗时O(n)。若目标值不存在,抛出ValueError。del lst[index]/del lst[start:end]:语句级别删除,支持单索引或切片批量清除,直接回收对应槽位。clear():移除列表中所有元素,保留原列表对象引用,长度归零。
tasks = ["email", "review", "meeting", "review", "deploy"]

# 1. 弹出末尾元素并获取返回值
last_task = tasks.pop()

# 2. 弹出指定索引元素
first_task = tasks.pop(0)

# 3. 移除指定值的第一个匹配项(删除第一个 "review")
tasks.remove("review")

# 4. 使用 del 删除切片或指定位置
del tasks[0]

# 5. 清空列表
backup = ["temp"]
backup.clear()

print("当前 tasks:", tasks)
print("弹出的任务:", first_task, last_task)
print("清空后的 backup:", backup)lst.remove(x) 在元素不存在时必定抛出 ValueError: list.remove(x): x not in list。在不确定元素是否存在时,应通过 if x in lst: lst.remove(x) 或使用 try...except ValueError: 包裹执行。
3. 修改与查询元素
由于列表具备整齐的数字索引,直接索引取值和赋值均为 O(1) 极速操作。此外还支持切片批量替换与元素查找:
nums = [10, 20, 30, 40, 50]

# 1. 单元素索引修改
nums[1] = 25

# 2. 切片批量修改(将索引 2 至 4 的切片替换为新序列)
nums[2:4] = [35, 45, 48]

# 3. 查询元素:通过正向或反向索引
val = nums[-1]

# 4. 判断成员是否存在(时间复杂度 O(n))
exists = 35 in nums

# 5. 查找元素首个出现索引与出现频次
idx = nums.index(35)
cnt = nums.count(35)

print("修改后 nums:", nums)
print(f"末尾值: {val}, 存在性: {exists}, 35首次出现的索引: {idx}, 出现频次: {cnt}")二、字典(Dictionary)的增删改查机制与代码实践
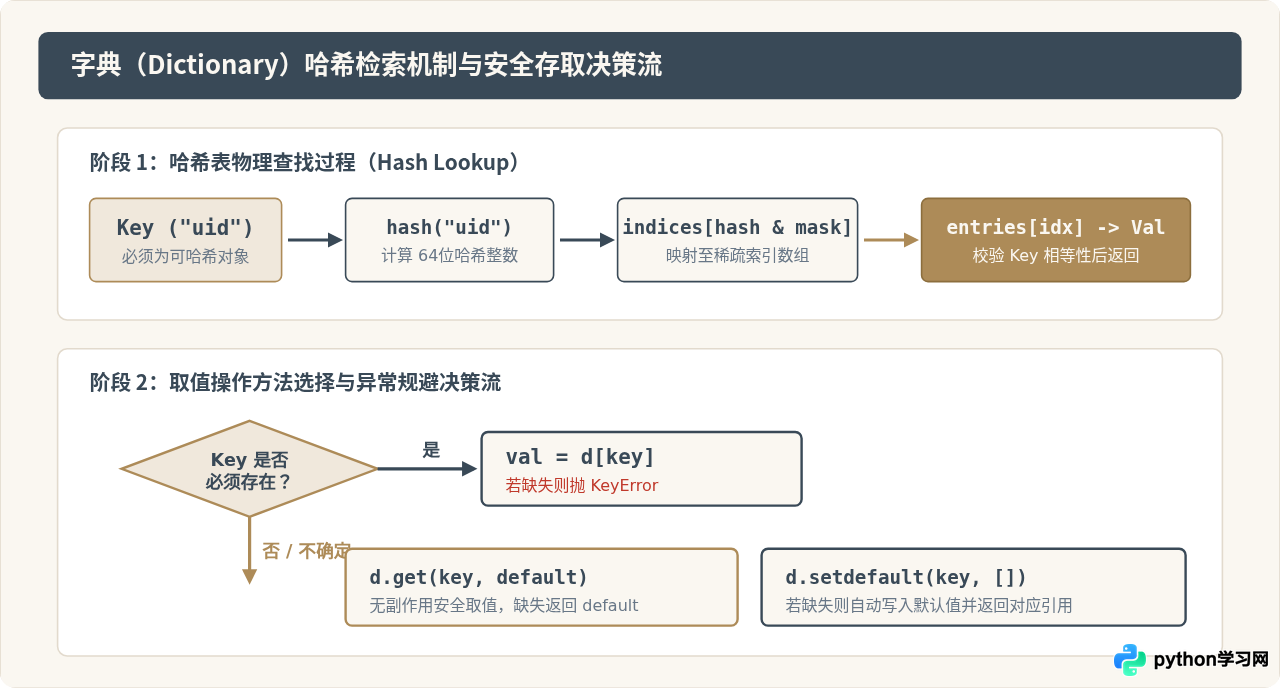
Python 字典是基于哈希表实现的键值关联映射。自 Python 3.7 起,标准字典官方保证保留键值对的插入顺序。向字典中检索、插入或删除任意键值的平均时间复杂度均为 O(1)。
1. 增加与修改键值对:方括号、update 与 setdefault
在字典中,增加一个新键与修改已有键在语法上是完全统一的:
d[key] = value:当key不存在时新增键值对;当key已存在时直接覆盖对应的值。update(other_dict_or_iterable):批量合并另一个字典或键值对迭代器。相同键会被新值覆盖,缺失键会被新增。setdefault(key, default):若key存在,则直接返回其当前值;若不存在,则在原字典中插入key: default并返回该默认值。非常适合在分组或聚合计数时初始化容器。
# 字典增改代码示例
user_profile = {"id": 1001, "name": "Alice"}

# 1. 单键赋值(不存在则新增,存在则更新)
user_profile["role"] = "Engineer"
user_profile["name"] = "Alice Cooper"

# 2. 批量合并与更新
user_profile.update({"dept": "R&D", "status": "Active"})

# 3. setdefault 用于安全初始化复杂嵌套类型
user_tags = {}
user_tags.setdefault(1001, []).append("Python")
user_tags.setdefault(1001, []).append("Backend")

print("更新后的 profile:", user_profile)
print("分组标签字典:", user_tags)2. 查询与读取:方括号 vs get 方法
访问字典数据时,需根据键是否确定存在来选择策略:
d[key]:直接访问。若键不存在,立即抛出KeyError。只在业务逻辑百分之百确认该键必须存在时使用。d.get(key, default=None):安全取值。若键存在返回对应值;若不存在返回default(默认为None),不会抛出异常。key in d:检查指定键是否位于字典中,平均耗时仅O(1)。
config = {"timeout": 30, "retries": 3}

# 1. 确定存在的键直接方括号访问
timeout = config["timeout"]

# 2. 不确定存在的键使用 get 并赋予默认备选值
host = config.get("host", "127.0.0.1")
port = config.get("port", 8080)

# 3. 成员检查
has_retries = "retries" in config
has_ssl = "ssl" in config

print(f"超时: {timeout}, 主机: {host}, 端口: {port}")
print(f"包含retries: {has_retries}, 包含ssl: {has_ssl}")3. 删除键值:pop、popitem、del 与 clear
字典提供了多种针对键的删除策略:
pop(key[, default]):移除指定键并返回对应的值。若键不存在且提供了default参数,则返回default;若未提供则抛出KeyError。popitem():按照后进先出(LIFO)顺序移除并返回最后一个键值对元组(key, value)。字典为空时调用抛出KeyError。del d[key]:删除指定键值。若键不存在抛出KeyError。clear():清空字典内所有键值对。
session = {"token": "xyz890", "ip": "192.168.1.10", "login_time": 1700000000}

# 1. pop 安全删除并取值(设置默认值防崩)
token_val = session.pop("token", None)
missing_val = session.pop("device_id", "Unknown")

# 2. popitem 移除最新加入的项
last_pair = session.popitem()

# 3. del 语句删除
if "ip" in session:
    del session["ip"]

print("剩余 session:", session)
print("获取到的 token:", token_val, "缺失键安全返回值:", missing_val)
print("弹出的最后键值对:", last_pair)三、列表与字典的遍历技巧与实战模式
遍历是处理集合数据的必经步骤。针对不同场景,选用正确的遍历语法能显著提高代码的可读性与运行效率。
1. 列表的高效遍历方式
- 直接迭代元素:
for item in lst:最自然的迭代方式,无需维护索引变量。 - 带索引迭代(enumerate):
for idx, item in enumerate(lst, start=0):同时获得当前索引与对应元素,避免使用低效且冗长的range(len(lst))。 - 并行迭代(zip):
for a, b in zip(list_a, list_b):同时配对遍历多个等长或不等长列表。 - 列表推导式(List Comprehension):
[expr for item in lst if condition]简洁、高效地过滤或映射并生成新列表。
names = ["Alice", "Bob", "Charlie"]
roles = ["Admin", "Dev", "QA"]

# 1. 同时需要索引和值:enumerate
print("--- enumerate 遍历 ---")
for idx, name in enumerate(names, start=1):
    print(f"编号 {idx}: {name}")

# 2. 多列表并行聚合:zip
print("--- zip 遍历 ---")
for name, role in zip(names, roles):
    print(f"成员 {name} -> 角色 {role}")

# 3. 列表推导式提取大写
upper_names = [n.upper() for n in names if len(n) > 3]
print("长度大于3的大写名称:", upper_names)2. 字典的高效遍历方式
字典提供了三种动态视图对象:keys()、values()、items():
for key in d:默认直接遍历所有键。for val in d.values():仅遍历所有值,当不需要键时省去查询开销。for key, val in d.items():同时解包遍历键和值,工程中最常用的模式。- 字典推导式:
{k: v for k, v in d.items() if condition}快速完成字典的键值翻转、条件过滤或数据转换。
product_prices = {"Apple": 6.5, "Banana": 3.2, "Cherry": 18.0}

# 1. 遍历键值对并解包
print("--- items 遍历 ---")
for fruit, price in product_prices.items():
    print(f"商品: {fruit:8s} 单价: ¥{price:.2f}")

# 2. 仅遍历值计算总和
total_price = sum(product_prices.values())
print(f"商品价格总和: ¥{total_price:.2f}")

# 3. 字典推导式:打折并筛选高价商品
discounted = {f: round(p * 0.9, 2) for f, p in product_prices.items() if p > 5.0}
print("九折高价商品:", discounted)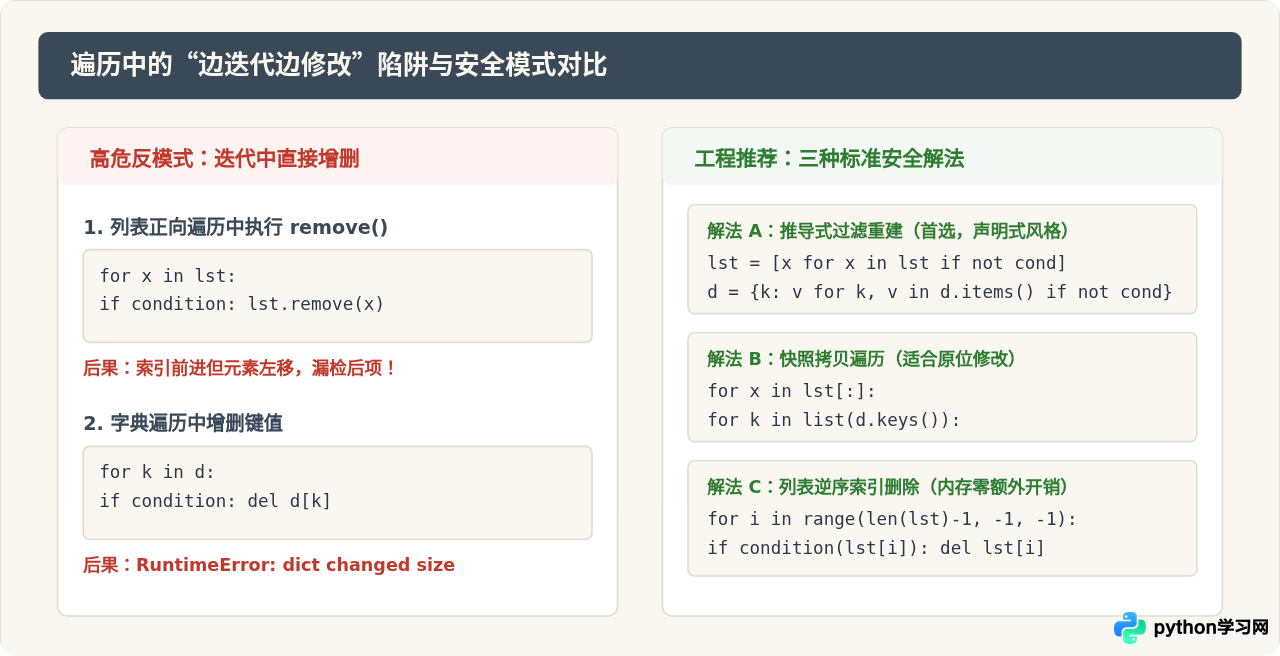
四、关键转折与高频避坑实践
1. 为什么“边遍历边删除”会导致严重逻辑漏洞?
这是初学者最容易踩中的暗坑:
- 列表跳项问题:在正向
for x in lst:循环中,Python 内部通过累加的整数游标追踪当前读取位置。一旦调用lst.remove(x)或del lst[i],后面的所有元素会被立即向前搬移填补空缺,导致紧邻被删元素的下一个元素跳过了当前游标的检查。 - 字典运行时崩溃:在字典遍历过程中如果直接添加或删除键,Python 解释器在检测到哈希表结构变更后会立即抛出
RuntimeError: dictionary changed size during iteration。
工程推荐解决策略:
- 优先使用列表/字典推导式重新生成过滤后的新对象,表达清晰且执行速度最快。
- 若必须在原对象上进行原地清理,可使用切片浅拷贝或键列表快照:
for x in lst[:]:或for k in list(d.keys()):。 - 对于极长列表且内存敏感时,采用逆序循环索引:
for i in range(len(lst)-1, -1, -1): del lst[i],从后向前删除不会影响前部待处理元素的索引相对位置。
2. 函数默认参数切勿使用可变对象([] 或 {})
在定义函数时,默认参数在函数定义被解释执行时仅创建一次。如果将默认参数写为 def add_item(val, container=[]),后续多次调用该函数且不传递实参时,所有调用都将共享这同一个列表对象,造成隐蔽的数据污染。
# 错误示例:共享可变对象
def append_wrong(item, bag=[]):
    bag.append(item)
    return bag

# 正确示例:使用 None 并在函数体内动态初始化
def append_correct(item, bag=None):
    if bag is None:
        bag = []
    bag.append(item)
    return bag

print("错误调用第1次:", append_wrong(1))
print("错误调用第2次:", append_wrong(2)) # 输出 [1, 2],状态发生意外残留!

print("正确调用第1次:", append_correct(10))
print("正确调用第2次:", append_correct(20)) # 输出 [20],各次调用相互独立五、常用操作时间复杂度与选型全景矩阵
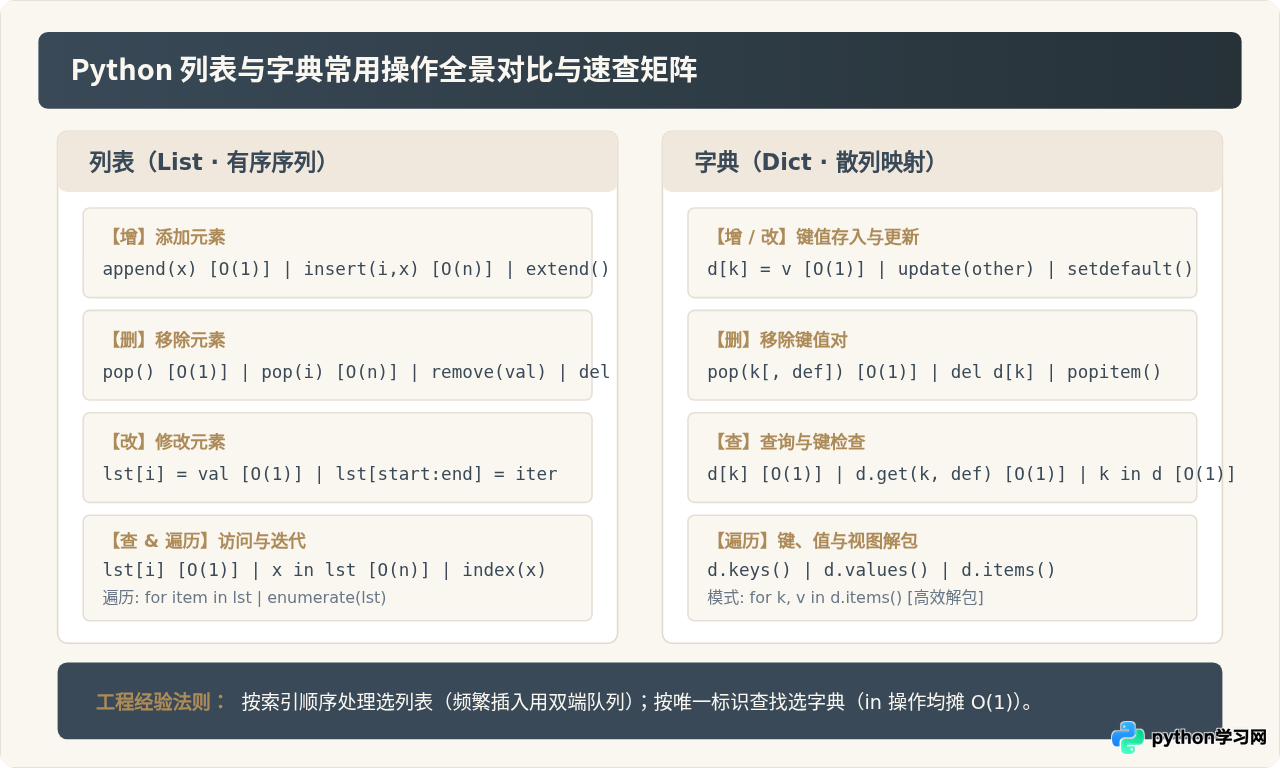
合理选择数据结构的前提是理解底层计算成本。下表汇总了列表与字典常用操作的时间复杂度:
| 数据结构 | 操作类型 | 典型方法 / 语法 | 时间复杂度 | 潜在异常与安全建议 |
|---|---|---|---|---|
| 列表 (List) | 追加 / 尾删 | append() / pop() |
O(1) 均摊 | 性能最优;空列表 pop 抛出 IndexError |
| 任意插入 / 删除 | insert(i, x) / pop(i) / remove() |
O(n) | 引起元素指针整体移位;remove 缺失抛 ValueError | |
| 按索引查 / 改 | lst[i] / lst[i] = v |
O(1) | 索引越界抛 IndexError,需验证 0 <= i < len(lst) | |
| 成员包含性检查 | x in lst |
O(n) | 线性扫描比对;数据量大且需频繁查重时应转用 set/dict | |
| 字典 (Dict) | 增 / 改键值 | d[k] = v / setdefault() |
O(1) 平均 | Key 必须为可哈希对象(如 str、int、tuple) |
| 安全删除 | pop(k, default) |
O(1) 平均 | 必须提供 default 兜底,防止抛 KeyError | |
| 查键值 | d.get(k, default) |
O(1) 平均 | 键缺失无异常,返回默认值;比 k in d 更具可读性 |
|
| 键存在性检查 | k in d |
O(1) 平均 | 基于哈希算法快速定址,效率显著高于列表遍历 |
六、总结与工程选型启示
在 Python 日常开发中,列表与字典各司其职,遵循清晰的权衡边界:
- 当处理具有自然先后顺序、允许重复项、主要在尾部增删的数据集合时,列表(
list)是最轻量、直观的选择。如果你的应用场景需要频繁在头部插入或移除元素,则应选用标准库中的collections.deque。 - 当处理需要按唯一标识高速存取、关联属性映射、频繁进行存在性查重的数据集时,字典(
dict)是绝对首选。其平均O(1)的查找与插入开销能让千万级数据在毫秒级内完成检索。 - 在编写涉及动态集合修改的业务逻辑时,牢记推导式重构优先、快照迭代保底的准则,彻底避免“边循环遍历边直接增删”造成的逻辑死角与运行时异常。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















