


Python使用copy.deepcopy处理自定义类对象的方法
深入讲解Python中使用copy.deepcopy处理自定义类对象的完整方法。包含默认深拷贝机制、自定义__deepcopy__方法的5步实现标准、memo字典防范循环引用的原理,以及过滤不可复制系统资源的实战代码。
copy.deepcopy() 可以直接对绝大多数自定义类的对象进行深拷贝,递归复制其全部属性并建立独立的内存副本。但当类对象包含文件句柄、网络套接字、线程锁等不可复制资源,或需要定制属性过滤与性能优化时,必须在类中定义 __deepcopy__(self, memo) 特殊方法,通过 memo 字典安全阻断循环引用并精确控制对象初始化流程。
一、默认行为:copy.deepcopy 如何处理普通自定义类
很多初学者误以为 copy.deepcopy() 只能识别 Python 内置的字典、列表等容器,对用户自己定义的 class 无能为力。实际上,Python 的 copy 模块对自定义类对象有一套成熟的默认处理协议。
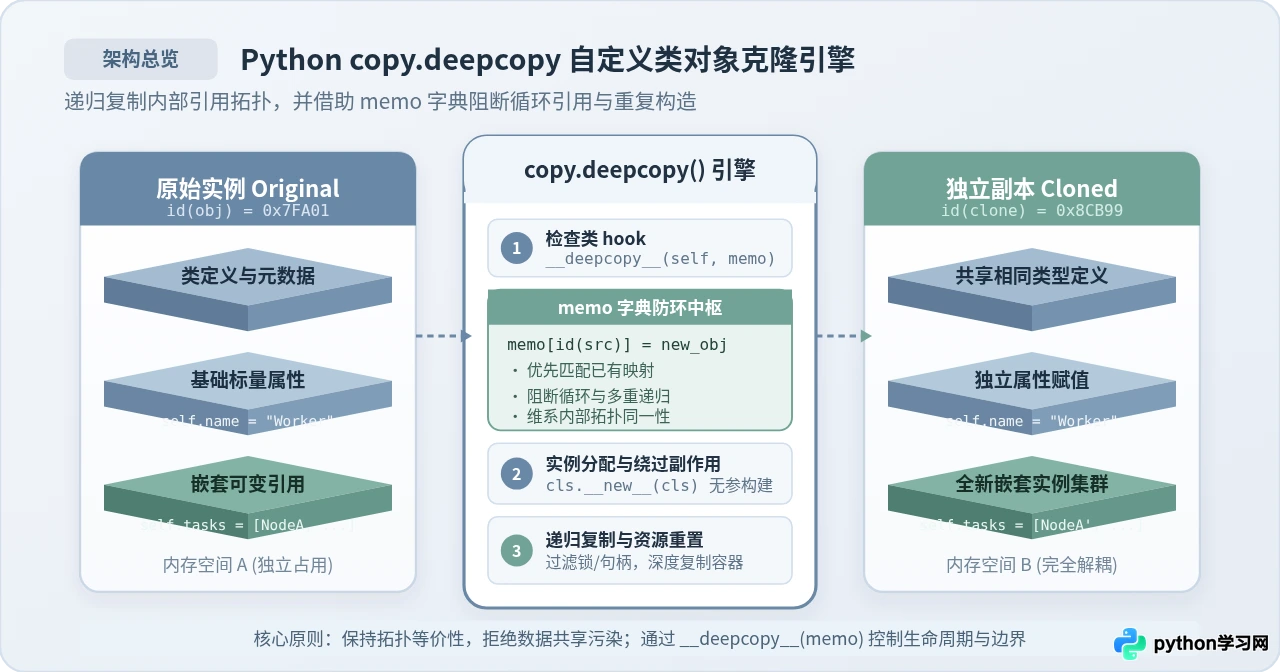
当对一个普通的自定义类实例调用 copy.deepcopy(obj) 时,标准库底层会首先通过 copyreg 机制或类的分派表寻找复制方式。如果没有自定义的 __deepcopy__ 方法,它会使用 __reduce_ex__ 协议或通过类的 __dict__ 属性获取当前对象存储的全部变量,自动为新实例分配内存空间,并对每一个属性递归调用 copy.deepcopy()。
import copy

class Task:
    def __init__(self, name, tags):
        self.name = name
        self.tags = tags  # 可变对象(列表)

task1 = Task("数据整理", ["Python", "IO"])
task2 = copy.deepcopy(task1)

# 验证内存地址独立性
print(task1 is task2)            # 输出: False
print(task1.tags is task2.tags)  # 输出: False

# 修改副本不会影响源对象
task2.tags.append("Done")
print(task1.tags)  # 输出: ['Python', 'IO']
print(task2.tags)  # 输出: ['Python', 'IO', 'Done']
在上面的示例中,task2 不仅拥有独立的顶级对象引用,其内部存储的 self.tags 列表也同样被深层复制到了全新的内存地址中。这种“开箱即用”的特性满足了日常绝大部分简单数据类的拷贝需求。
二、浅拷贝与深拷贝在自定义对象中的核心区别
理解深拷贝的前提是清晰识别浅拷贝(copy.copy)带来的隐藏风险。浅拷贝只会为最外层的对象容器创建新实例,但该对象内部引用的所有成员变量(尤其是列表、字典或其他嵌套自定义类的实例)仍然指向原有的内存地址。
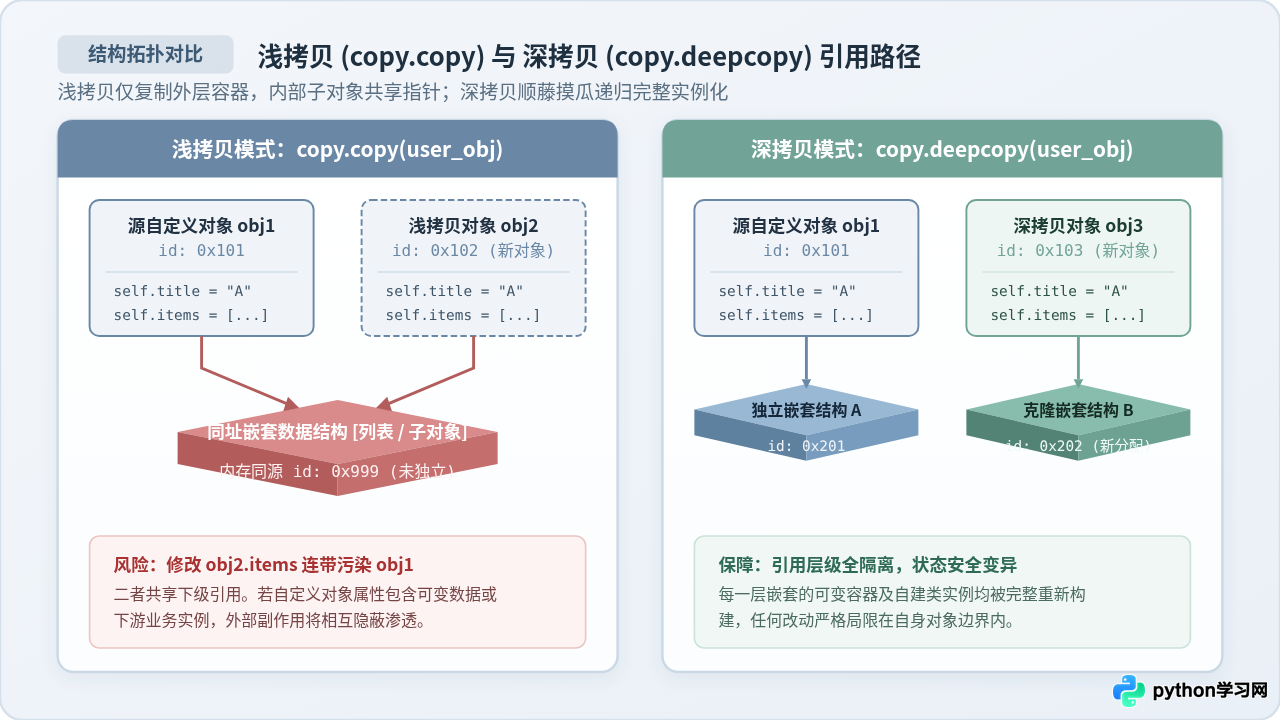
如上图所示,当使用浅拷贝 copy.copy(obj1) 生成 obj2 时,尽管 id(obj1) != id(obj2),但它们内部的 items 属性却共享着同一个内存指针 0x999。只要任何一方修改了该列表中的元素,另一方就会在毫无感知的情况下受到隐蔽污染。而 copy.deepcopy() 会沿引用路径向下追踪,为沿途所有可变结构创建全新拷贝,彻底阻断副作用蔓延。
三、默认深拷贝会失效的典型场景
虽然默认的 copy.deepcopy() 足够方便,但在以下三类常见工程场景中,默认机制会直接抛出异常或引发难以预料的逻辑错误:
-
包含不可复制的系统级外部资源:自定义类若持有打开的文件句柄(
_io.TextIOWrapper)、数据库连接(sqlite3.Connection)、网络套接字(socket.socket)或线程锁(threading.Lock),调用默认deepcopy会触发TypeError: cannot pickle '...' object报错。这类操作系统底层句柄无法被镜像克隆。 - 对象持有庞大的瞬态缓存数据:例如机器学习模型类中缓存的临时预测特征矩阵、网络计算的本地临时缓存。如果完整深拷贝,会导致严重的内存暴涨和复制延迟。此时往往希望深拷贝得到的新对象重置或清空这些临时缓存。
-
带有外部通信副作用的
__init__构造器:某些类的__init__方法会在实例化时自动递增全局计数器、向服务端注册心跳或分配系统端口。默认深拷贝在还原对象时虽然通常绕过__init__,但若开发者直接通过重新实例化方式克隆,极易引发严重逻辑冲突。
四、实现 __deepcopy__(self, memo) 的标准规范与步骤
为了精确掌控对象的复制流程并妥善处理不可复制资源,Python 规定:只要在自定义类中实现了名为 __deepcopy__(self, memo) 的特殊方法,copy.deepcopy() 就会优先调用该方法完成复制。
该方法接收且必须接收两个参数:self(当前需要拷贝的实例)和 memo(用于记录对象映射关系并阻止循环引用的字典)。
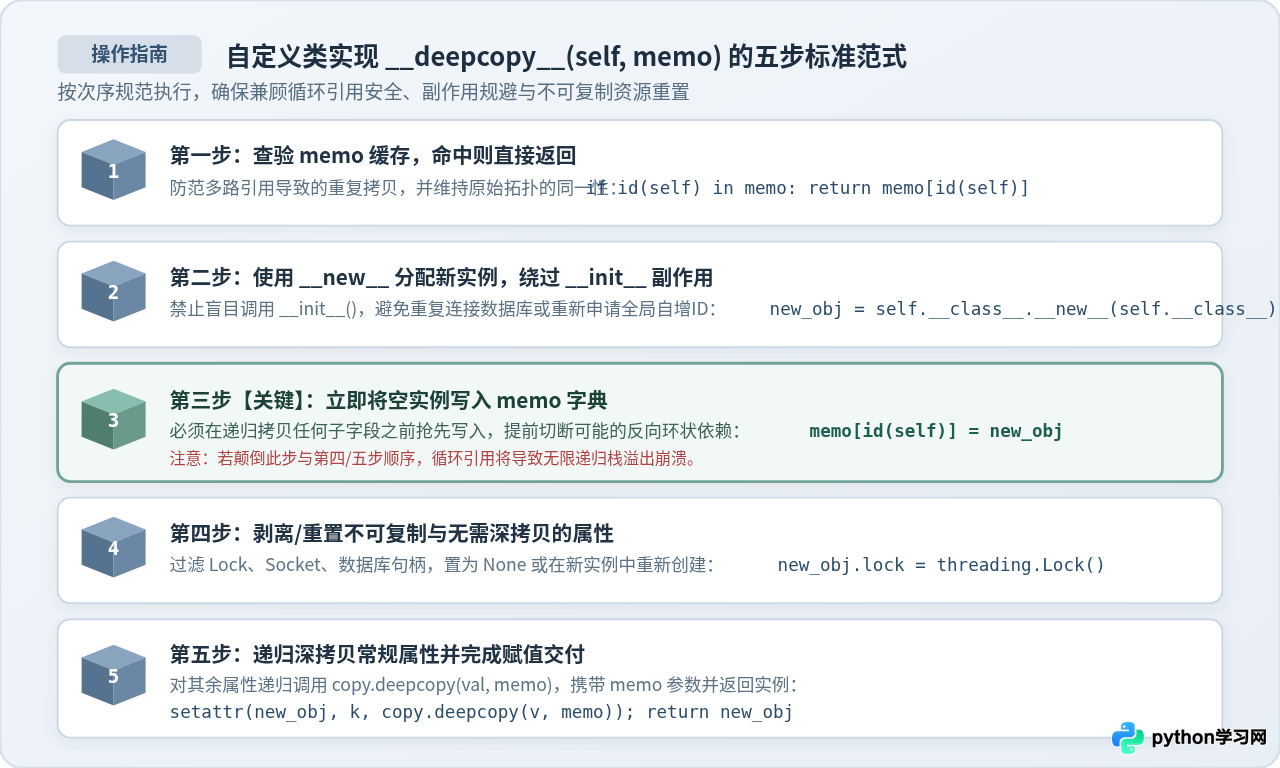
编写高质量的 __deepcopy__ 方法应当严格遵守以下五个标准步骤:
步骤 1:查验 memo 缓存
首先检查当前对象的 id(self) 是否已存在于 memo 字典中。如果已经存在,说明该对象在先前的深拷贝遍历路径中已经被构造过,直接返回 memo[id(self)] 即可。这保证了复杂图结构中多重引用的对象在拷贝后依然保持单一同体。
步骤 2:分配未初始化的新实例(绕过 __init__)
推荐使用 cls = self.__class__; new_obj = cls.__new__(cls) 来创建空白实例。调用 __new__ 只负责在内存中分配对象的槽位,而不会执行 __init__ 中的业务初始化代码,避免触发任何重复的网络请求或自增副作用。
步骤 3:立即将新实例写入 memo 字典【核心防环】
在创建好 new_obj 之后、开始对内部成员属性进行任何递归复制之前,必须立刻执行 memo[id(self)] = new_obj。只有先将自身登记进缓存,当后续属性存在指向自身或上级节点的循环引用时,下层调用才能查表命中并终止递归。
步骤 4:处理/剔除不可复制的特殊资源
对于文件句柄、网络连接或线程锁等字段,不能对其执行 copy.deepcopy()。应根据业务需要,在新实例中重新创建全新的独立资源(如 new_obj.lock = threading.Lock()),或将其初始化为 None 等待后续按需懒加载。
步骤 5:递归深拷贝其余成员属性
对类中其余常规数据属性,显式调用 copy.deepcopy(attr, memo)。格外注意:此时必须将 memo 字典作为第二个参数向下透传,确保整个复制链条共享同一个引用追踪上下文。
五、实战示例:可自愈资源类与循环引用结构
场景 1:包含不可复制资源(线程锁与日志文件)的自定义类
下面的代码展示了一个具备线程安全保护与日志记录能力的自定义服务类。通过编写 __deepcopy__,我们实现了不可复制资源的安全重置与常规数据的完整克隆:
import copy
import threading

class WorkerNode:
    def __init__(self, node_id, config):
        self.node_id = node_id
        self.config = config        # 嵌套字典
        self.state_history = []     # 状态列表
        self.lock = threading.Lock() # 不可复制资源:线程锁
        self.file_handle = None     # 假设代表打开的外部文件句柄

    def __deepcopy__(self, memo):
        # 1. 查验缓存
        if id(self) in memo:
            return memo[id(self)]

        # 2. 分配空白实例,不执行 __init__
        cls = self.__class__
        new_node = cls.__new__(cls)

        # 3. 抢先在 memo 中注册,阻断循环引用
        memo[id(self)] = new_node

        # 4. 递归深拷贝普通可变数据,并透传 memo
        new_node.node_id = self.node_id
        new_node.config = copy.deepcopy(self.config, memo)
        new_node.state_history = copy.deepcopy(self.state_history, memo)

        # 5. 特殊资源定制:为副本分配全新的线程锁,并将文件句柄置空
        new_node.lock = threading.Lock()
        new_node.file_handle = None

        return new_node

# 运行验证
node_a = WorkerNode("node-01", {"max_concurrency": 8, "env": "prod"})
node_a.state_history.append("INIT_SUCCESS")

# 执行深拷贝
node_b = copy.deepcopy(node_a)

print(f"源节点 ID: {node_a.node_id}, 副本节点 ID: {node_b.node_id}")
print(f"锁对象是否独立: {node_a.lock is not node_b.lock}")
print(f"配置字典是否独立: {node_a.config is not node_b.config}")

# 修改副本字典验证隔离性
node_b.config["max_concurrency"] = 16
print(f"源节点配置: {node_a.config['max_concurrency']}") # 保持 8 不变
print(f"副本节点配置: {node_b.config['max_concurrency']}") # 成功修改为 16
场景 2:带循环引用的双向图节点结构
在双向链表、树或图数据结构中,父子节点往往互持引用。若没有 memo 协同,深拷贝将在两点之间无限递归直至崩溃。
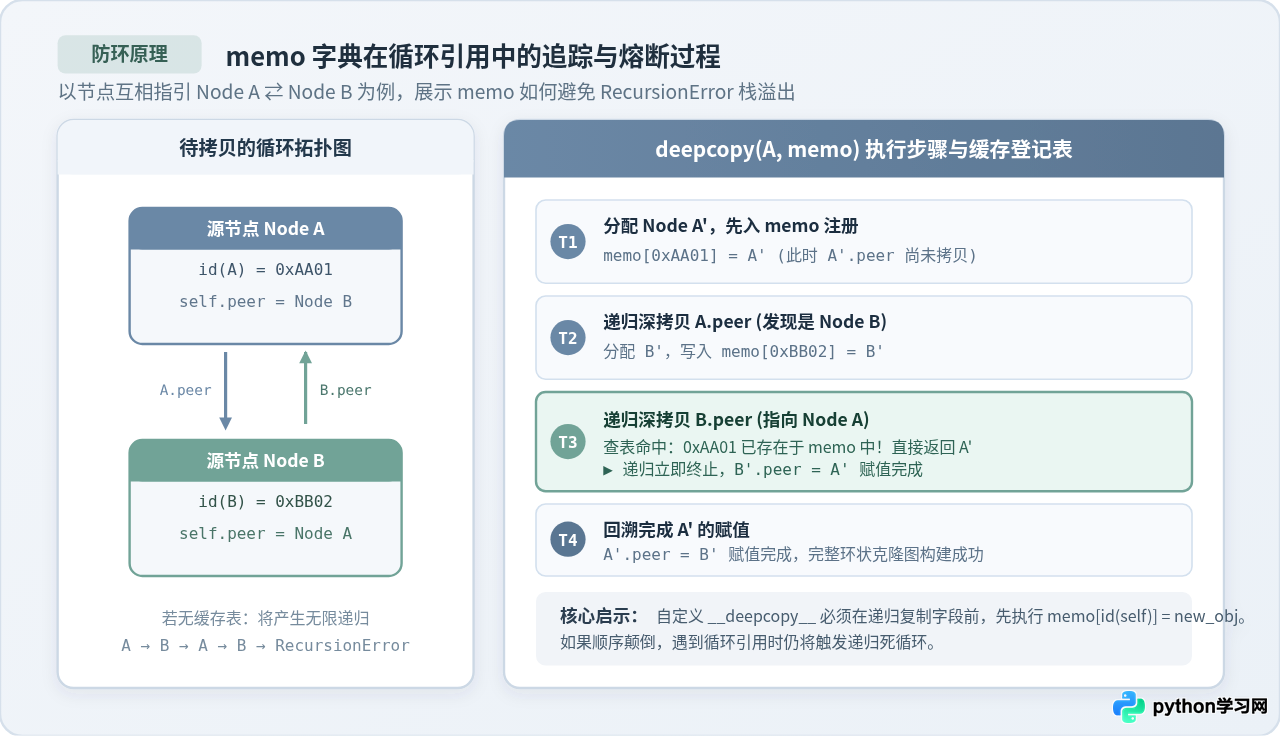
以下代码演示了图节点如何在 __deepcopy__ 中借助 memo 实现自循环与双向引用的安全克隆:
class GraphNode:
    def __init__(self, name):
        self.name = name
        self.neighbors = []

    def add_edge(self, node):
        self.neighbors.append(node)

    def __deepcopy__(self, memo):
        if id(self) in memo:
            return memo[id(self)]

        new_node = self.__class__.__new__(self.__class__)
        memo[id(self)] = new_node

        new_node.name = self.name
        # 递归深拷贝邻接列表,内含指向自身或彼此的节点
        new_node.neighbors = copy.deepcopy(self.neighbors, memo)
        return new_node

# 构建环状引用:n1 -> n2 -> n1
n1 = GraphNode("Node-1")
n2 = GraphNode("Node-2")
n1.add_edge(n2)
n2.add_edge(n1)

# 执行深拷贝
cloned_n1 = copy.deepcopy(n1)

print(cloned_n1 is n1)                             # False (完全独立)
print(cloned_n1.neighbors[0] is n2)                # False (对端也是全新副本)
print(cloned_n1.neighbors[0].neighbors[0] is cloned_n1) # True (内部拓扑环完整保留!)cloned_n1.neighbors[0].neighbors[0] is cloned_n1 返回 True,表明克隆后的图结构完整保留了原有的闭环关系,而没有退化为两组相互分离的断裂对象。这正是 memo 字典的核心价值所在。
六、必须掌握的注意事项与避坑指南
-
严禁遗漏透传
memo参数:在__deepcopy__内部调用copy.deepcopy(attr, memo)时,新手最常犯的错误是写成copy.deepcopy(attr)。漏传memo会导致下层属性拷贝开启一个崭新的空缓存,破坏全局防环机制并导致多重引用的相同对象被重复复制多份。 -
警惕类属性中使用了
__slots__:定义了__slots__的自定义类没有__dict__属性字典。此时不能使用new_obj.__dict__.update(...),必须显式通过getattr和setattr遍历类的__slots__元组逐一处理。 -
区分
__copy__与__deepcopy__:如果希望自定义类既支持浅拷贝也支持深拷贝,可以同时实现这两个钩子。__copy__(self)不需要memo参数,只需返回一个拷贝了外层引用的浅副本即可。 -
利用
__getstate__与__setstate__作为备选机制:如果不希望逐个字段手动复制,还可以实现 Python 的序列化钩子__getstate__和__setstate__。copy.deepcopy()在没有__deepcopy__时会自动遵循该协议,在__getstate__中剔除不可复制属性即可一并解决深拷贝与pickle序列化问题。
七、克隆策略决策全景与总结
为了在实际开发中兼顾代码简洁性、执行性能与状态安全性,可参考下方的决策架构图选择最适合你自定义类的拷贝策略:
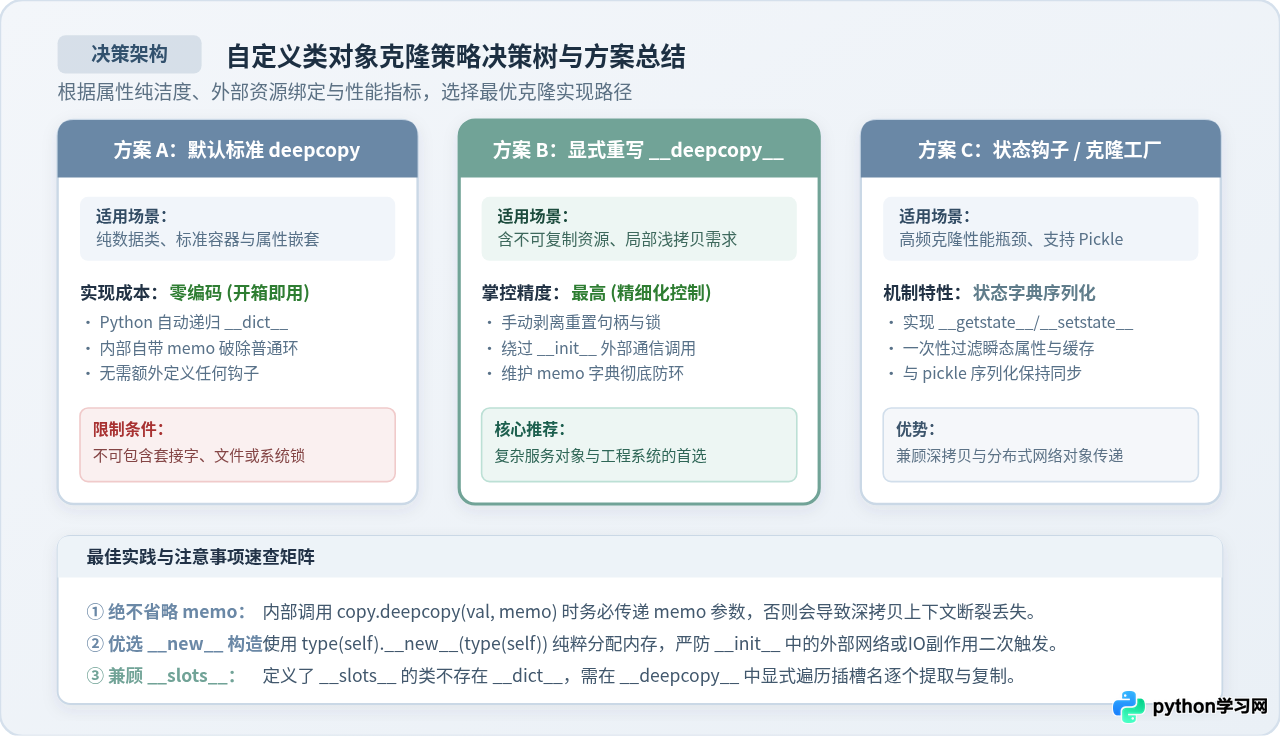
| 方案类型 | 实现方式 | 适用场景 | 优缺点评估 |
|---|---|---|---|
| 默认标准深拷贝 | 直接使用 copy.deepcopy(obj) |
无不可复制系统资源、常规数据模型类 | 零开发成本,全自动递归;但遇底层锁或套接字会报错 |
重写 __deepcopy__ |
显式实现 def __deepcopy__(self, memo): |
包含线程锁、文件句柄,或需定制缓存清理的复杂服务类 | 掌控力极强,安全过滤不可复制字段;需遵循 5 步防环范式 |
| 状态钩子协议 | 实现 __getstate__ / __setstate__ |
类既需要支持 deepcopy,又需要支持 pickle 网络传输与持久化 | 代码复用度高,一次定义满足两种序列化诉求;灵活性略低于前者 |
综上所述,Python 的 copy.deepcopy() 为自定义类对象提供了从“全自动默认处理”到“深度细粒度控制”的完整分层支持。面对常规数据类直接使用内置方法即可;而一旦涉及外部资源、复杂拓扑结构或性能瓶颈,遵循标准 5 步法实现 __deepcopy__(self, memo) 则是最稳健、专业的解决路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















