


Python字符串split()基础用法:默认空白分割与返回值
深入解析Python中字符串split()基础用法,详述无参默认空白分割的字符识别范围、连续空白折叠与首尾空白剔除规则,对比split(' ')的本质差异,并剖析返回值list的各种边界表现。
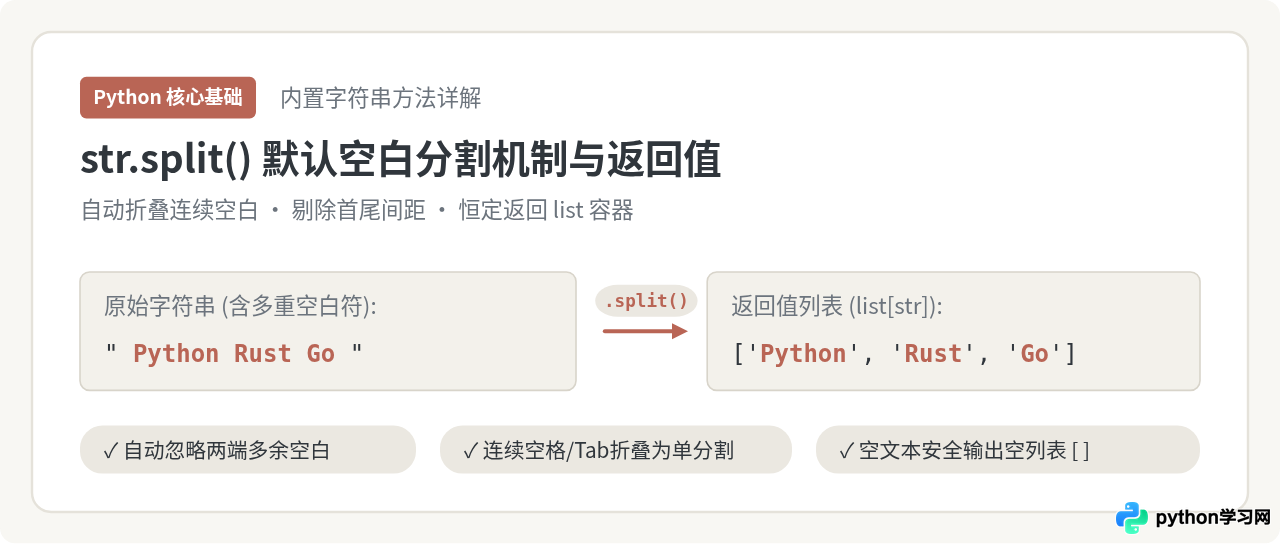
str.split() 是最基础也是最高频的字符串切分方法。当不传入任何参数(或显式设置 sep=None)时,它会启动默认空白分割机制:不仅匹配标准空格,还能识别制表符 、换行符
等全范围空白字符,并自动执行“连续空白折叠”与“剔除首尾空白”。其返回值始终是一个由字符串元素构成的全新 list 列表。理解这一机制是写出简洁、健壮的文本解析代码的必修功。
一、不传参数时的 split():默认空白分割机制
Python 字符串对象的 split() 完整签名形式为 str.split(sep=None, maxsplit=-1)。当省略 sep 参数或将其明确指定为 None 时,方法将采用与指定字符分割完全不同的解析逻辑。
具体而言,默认空白分割严格遵循以下三项运行原则:
- 识别所有 ASCII 空白字符:匹配范围不仅限于半角空格(
' '),还覆盖水平制表符()。 - 自动合并连续空白(折叠机制):任意连续出现的多个空白字符均被整体视作一个单一的逻辑分隔断点,中间绝不会生成多余的空字符串
""。 - 自动剥离首尾空白:若字符串以空白字符开头或结尾,这些两端间隙会被静默丢弃,不会像字符截断那样在列表首尾产生空元素。
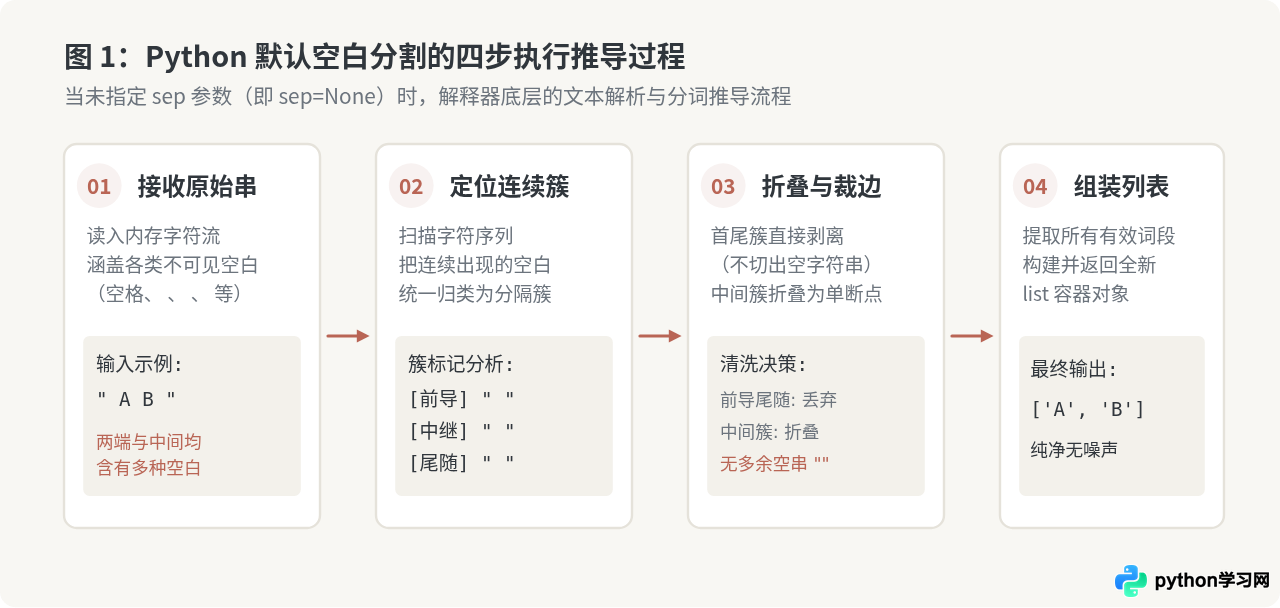
下面是一段基础代码示例,直观展示包含空格、制表符与换行符混合时的拆分过程:
# 示例 1:默认参数下的多重空白分割
text = "   Python    3.12
  Standard   Library
 "
result = text.split()

print("切分后列表:", result)
print("提取元素个数:", len(result))
从输出可以观察到,原始字符串首尾的大段空白没有在结果中留下任何 "";中间由空格与
混杂的间隔,也都被干净利落地切开,仅保留了有效词汇。这意味着在大多数场景下,我们不需要在调用 split() 前手动调用 strip()。
二、核心区别:split() 与 split(' ') 的本质差异
初学者最容易产生的一个误解是:认为 s.split() 等价于 s.split(' ')。实际上,两者在 Python 解释器内部执行完全不同的算法,处理连续空格与非空格空白时的结果大相径庭。
当显式传入单个空格 sep=' ' 时,split() 退化为严格的定界符截断模式:每一个空格都被视作绝对的分隔点,制表符和换行符不再被当作分隔符,连续的空格之间则一定会生成空字符串元素。
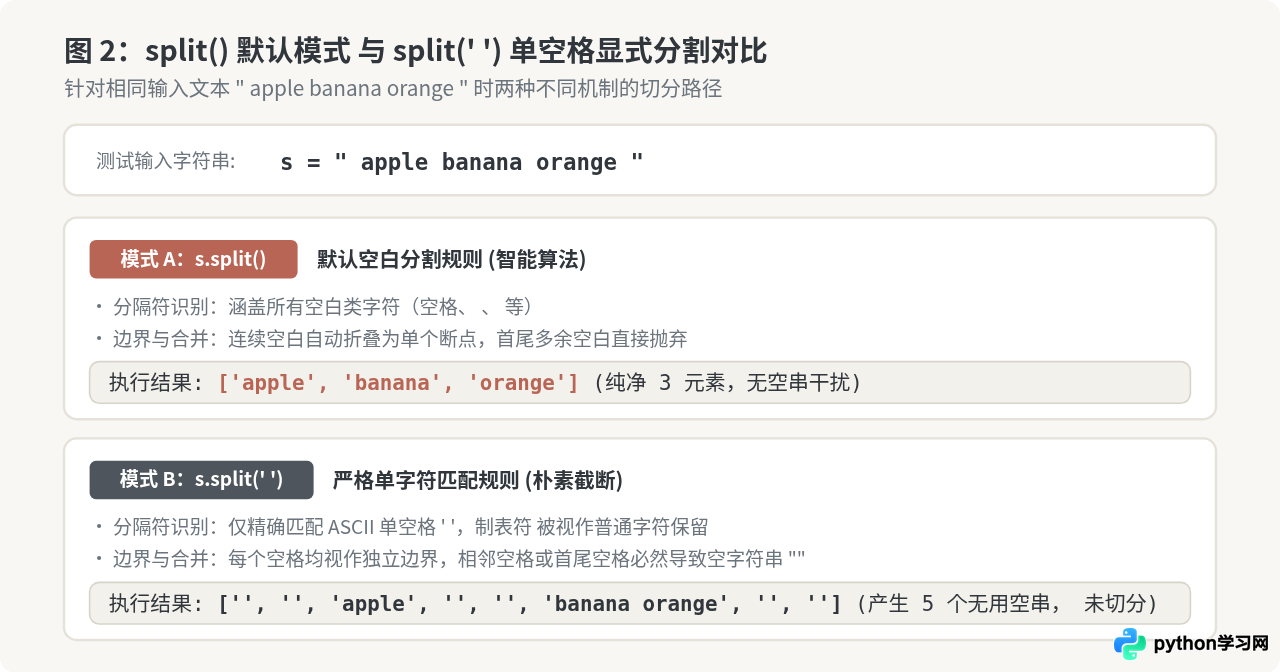
我们可以通过同一段字符串在两种调用模式下的运行结果进行对照验证:
# 示例 2:split() 与 split(' ') 的输出对比
sample_str = "  apple   banana 	 orange  "

# 默认空白分割模式
res_default = sample_str.split()

# 显式单空格分割模式
res_explicit = sample_str.split(' ')

print("默认 split():", res_default)
print("显式 split(' '):", res_explicit)
为了更清晰地对比二者的行为,下表列出了核心规则的对照:
| 对比维度 | 默认模式:s.split() 或 split(None) | 显式单空格:s.split(' ') |
|---|---|---|
| 匹配字符集 | 所有空白(空格、 、 、 、、) | 仅匹配单一 ASCII 空格(' ') |
| 连续分隔符 | 自动折叠合并,视作单一分隔符 | 不折叠,每两个相邻空格间切出 "" |
| 首尾多余空格 | 自动忽略,两端不生成元素 | 在结果首尾各生成对应数量的 "" |
| 典型应用场景 | 自然语言分词、清洗命令行输入、提取单词 | 严格按单个空格对齐的结构化协议解析 |
s.split(),切忌顺手写成 s.split(' '),否则将引入大量毫无业务意义的空字符串元素 "",增加后续过滤的复杂度。
三、返回值深度解析:容器类型与边界情况
str.split() 的返回值类型恒定为 Python 内置列表(list),列表内部的每个元素均为新生成的字符串对象。不论原字符串是长篇段落还是极端边界,这一容器契约始终不变。
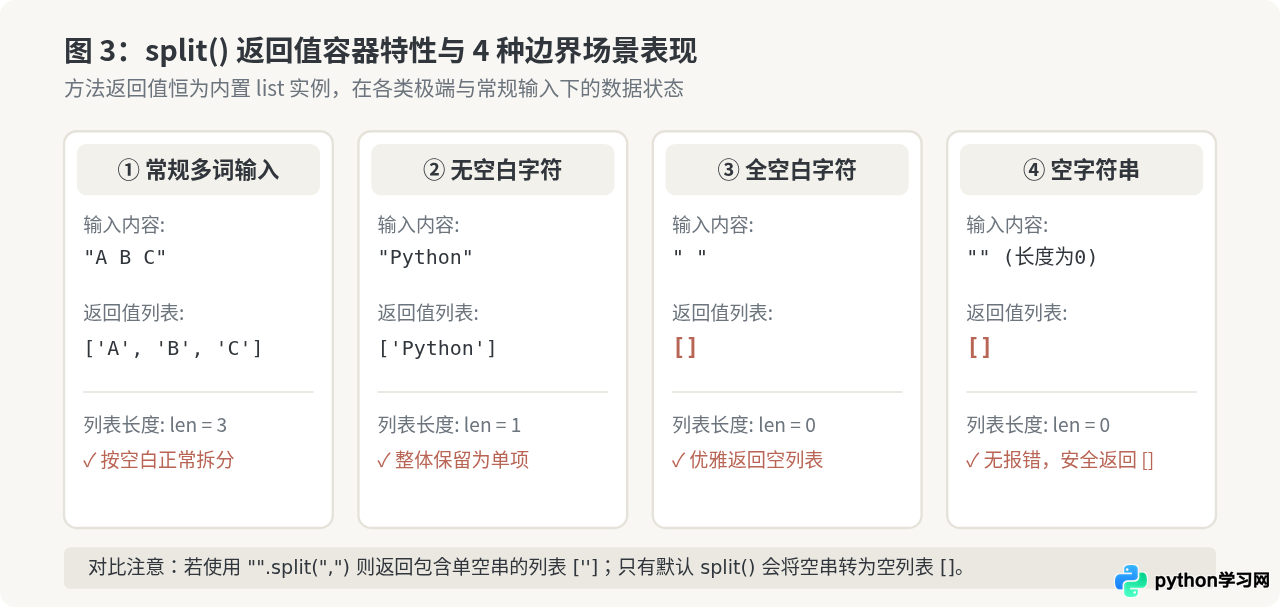
在编写健壮的生产代码时,需要特别关注以下四种边界情况:
1. 空字符串处理:"".split()
如果对空字符串 "" 调用无参 split(),其返回结果是一个空列表 [],长度为 0:
# 示例 3:空字符串切分
empty_s = ""
print("空串无参 split():", empty_s.split())
print("空串显式逗号 split(','):", empty_s.split(','))
请注意这一关键差异:当指定分隔符(如 empty_s.split(','))时,返回值是包含一个空串的列表 [''](len=1);而默认无参 split() 则安全返回 [](len=0)。这意味着我们直接使用 if not s.split(): 即可优雅判断文本是否不包含任何有效字符。
2. 全空白字符串:全空格或全换行
当字符串中只包含空白符号(如 "
")时,由于默认机制自动剔除了所有前导与尾随空白,其提取出的有效子串为 0 个,因此同样安全返回空列表 []。
3. 不含空白的单单词字符串
若字符串中没有出现任何空白字符(例如 "Hello"),由于找不到分割断点,split() 会把原字符串完整包裹在单元素列表中返回,即 ['Hello'],len=1。
四、进阶参数配合:利用 maxsplit 控制分割次数
str.split() 还支持第二个位置参数 maxsplit(默认值为 -1,表示不限制拆分次数)。当赋予其非负整数时,方法将从左至右至多执行 maxsplit 次分割,字符串剩余部分将作为最后一个列表元素原样保留。
在默认空白分割机制下,maxsplit 依然严格保持空白折叠特性:用于切分的前 maxsplit 个空白簇会被合并切除,而最后保留的那一段内容内部的空白将不再被折叠,完整予以保留。
# 示例 4:结合 maxsplit 提取日志或键值信息
log_line = "  INFO    2026-11-01   Worker process initialized successfully with PID 1024  "

# 只按空白拆分前两次(提取级别与日期),保留后续完整日志正文
tokens = log_line.split(maxsplit=2)

print("拆分后元素:", tokens)
print("各字段提取:")
print(" - 日志级别:", tokens[0])
print(" - 记录时间:", tokens[1])
print(" - 日志详情:", tokens[2])
从输出可见,前两个有效字段 INFO 和 2026-11-01 被精准提取,多余空格被消除;而第三个字段作为未耗尽的尾部整体,保留了其后所有的原始内容。这种搭配极大简化了日志解析与命令行参数提取的逻辑。
五、知识总结与实践决策
掌握 Python str.split() 的核心在于明确何时依赖其默认机制,何时必须指定分隔符。
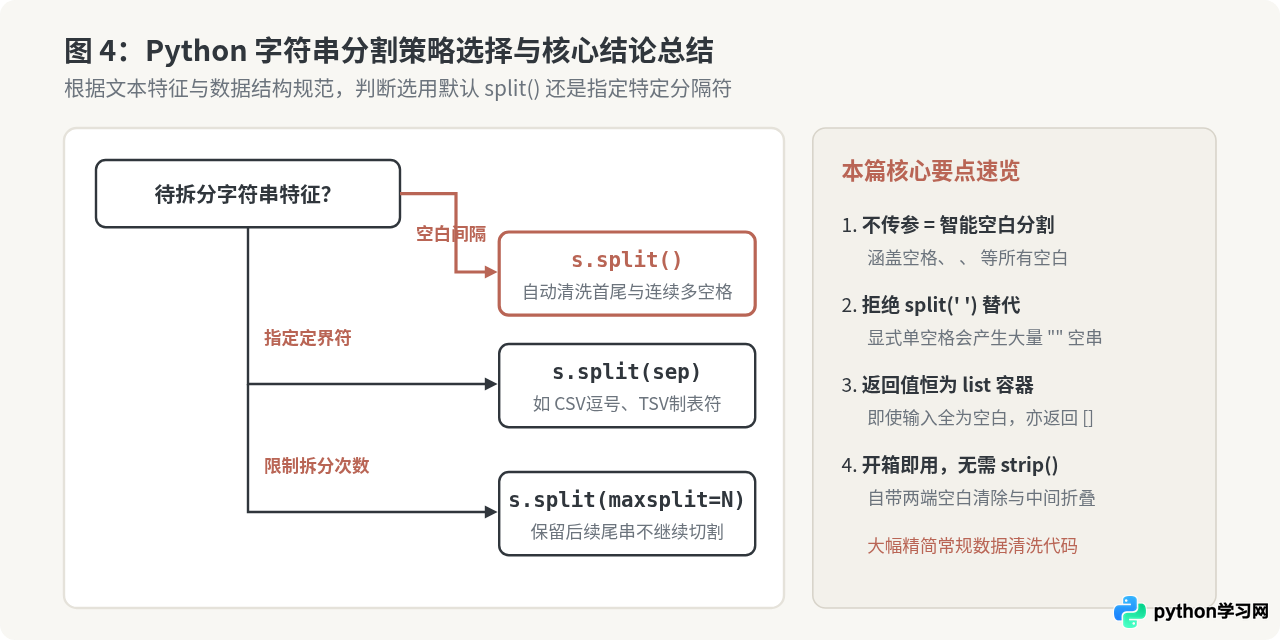
在实际工程开发中,可以依照以下简明原则作出决策:
- 解析非结构化文本、自然语言词汇或多重空格格式时:直接使用无参
s.split(),享受自动去除首尾空白、自动折叠连续空格的便利,省去调用s.strip()与过滤空串的冗余步骤。 - 解析结构化表格数据(如 CSV、TSV)或固定协议(如冒号配置行
host:port)时:必须显式传入对应的定界符s.split(',')或s.split(':'),此时应注意处理相邻分隔符产生的空字符串。 - 需要限制提取字段数量时:结合
maxsplit=N参数,避免整行内容被过度拆碎,提升处理性能与代码可读性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















