


Python for循环与while循环的区别及适用场景
深入解析Python中for循环与while循环在底层执行机制、推进方式、退出条件及性能表现上的核心区别,结合完整代码示例与场景选型指南,帮助开发者在实际编码中做出准确选择。
在阅读他人编写的 Python 代码时,常能看到一个现象:同样是按顺序处理列表里的元素,有人直接写 for item in items:,也有人先定义 i = 0,再用 while i < len(items): 配合 i += 1 推进。两种写法都能跑通,但它们在 Python 解释器内部的运行逻辑完全不同:for 循环本质上是受迭代器协议驱动的遍历工具,由被遍历对象自身决定何时结束;while 循环则是受布尔条件驱动的状态重复工具,只要条件表达式的计算结果为真,就会一直执行下去。明确“遍历已知数据集合”还是“等待某个运行状态发生改变”,是区分和选择这两种循环的核心依据。
从语法表象到底层机制:两者究竟差在哪里
不少从 C 或 Java 转向 Python 的读者,习惯把 for 循环理解成“自带计数器的 while 循环”。但在 Python 中,for 循环并没有初始化计数器、判断条件、自增步长这三段式结构,它直接构建在迭代器协议(Iterator Protocol)之上。
当 Python 执行 for x in iterable: 时,解释器在背后自动完成了三件事:调用 iter(iterable) 获取一个迭代器对象;在每一轮循环开始时调用 next(iterator) 取出下一个值并赋给变量 x;当序列耗尽、迭代器抛出 StopIteration 异常时,解释器自动捕获该异常并正常结束循环。整个过程中,开发者不需要自己维护索引,也不需要手写终止条件。
相比之下,while 循环不关心数据是不是可迭代对象。它只做一件事:在每一轮开始前对紧跟其后的条件表达式调用布尔求值(即 bool(condition))。只要结果为 True,就进入循环体;结果为 False,就跳过循环体继续向下执行。至于那个条件何时变成 False,完全取决于循环体内部有没有修改相关的状态变量。
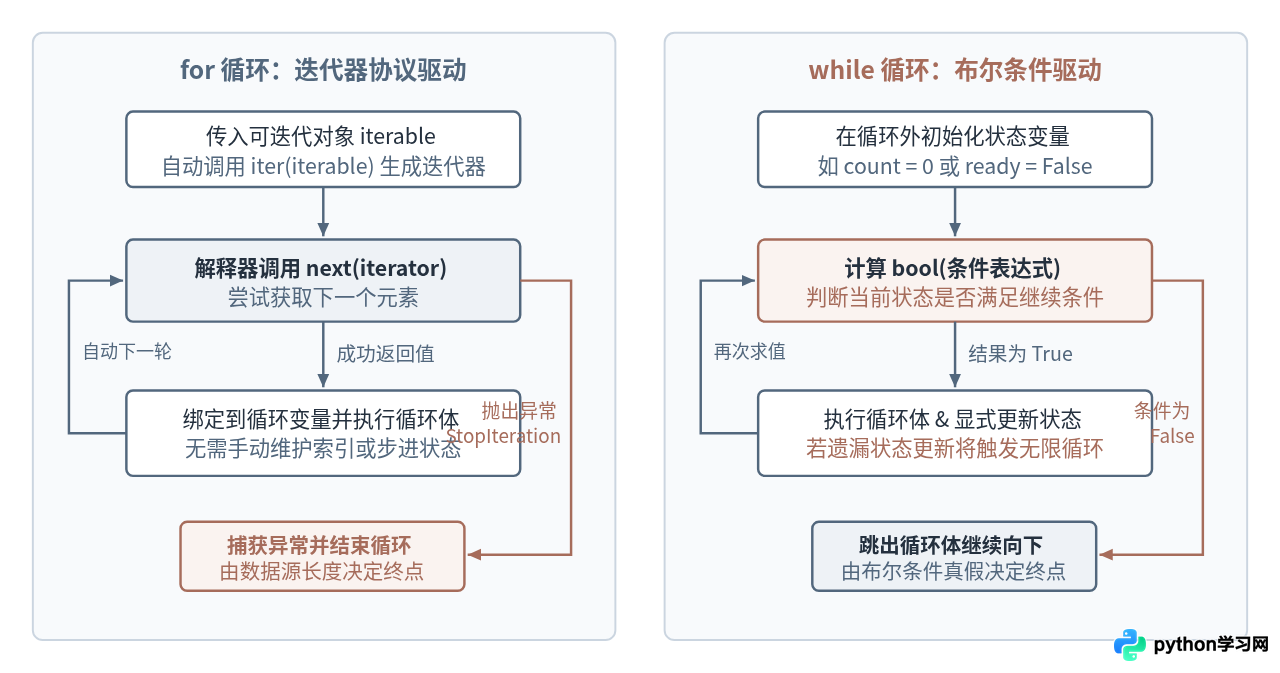
为了直观看到 for 循环背后的动作,可以在 Python 3 环境中把一段普通的 for 循环拆解成等价的 while 循环写法。在终端或脚本文件中运行以下代码:
tasks = ["读取配置", "校验参数", "写入日志"]

print("--- 1. 标准 for 循环写法 ---")
for current_task in tasks:
    print(f"正在处理: {current_task}")

print("\n--- 2. 等价的底层迭代器 + while 实现 ---")
task_iterator = iter(tasks)
while True:
    try:
        current_task = next(task_iterator)
    except StopIteration:
        break
print(f"正在处理: {current_task}")--- 1. 标准 for 循环写法 ---
正在处理: 读取配置
正在处理: 校验参数
正在处理: 写入日志
--- 2. 等价的底层迭代器 + while 实现 ---
正在处理: 读取配置
正在处理: 校验参数
正在处理: 写入日志从这段对比能看出为什么处理已知集合时 for 循环更受青睐:它把 iter()、next() 以及 StopIteration 的异常捕获全部下沉到了 C 语言级别的字节码(GET_ITER 与 FOR_ITER 指令)中执行。若改用 while 搭配索引变量去遍历列表,不仅多了两行维护索引的样板代码,每一轮还要在 Python 层面额外执行一次比较运算和一次加法赋值,执行效率和可读性都会下降。
核心差异对比:推进方式、退出条件与资源开销
在实际编写代码时,两种循环的差异主要体现在四个维度:循环推进的主导权、迭代次数的可预测性、对无限循环的容错性,以及执行开销。下表汇总了它们在具体编码层面的区别:
| 对比维度 | for 循环 | while 循环 |
|---|---|---|
| 推进方式 | 由迭代器自动推进,每轮自动请求下一个元素,无需手写步进逻辑。 | 必须在循环体内显式修改参与条件判断的变量或外部状态。 |
| 终止依据 | 可迭代对象耗尽(触发 StopIteration)或遇到 break。 |
条件表达式求值为 False 或遇到 break。 |
| 循环次数特征 | 通常在进入循环前已由容器长度、生成器范围或文件行数限定。 | 进入循环前往往无法确定具体执行多少轮,取决于运行时状态变化。 |
| 死循环风险 | 遍历有限集合(列表、元组、字典、range)时不会因漏写步进而死循环。 |
若状态更新逻辑遗漏,或分支条件跳过了状态更新语句,极易卡死。 |
| 局部性能表现 | 由 C 层字节码直接驱动迭代器前进,步进开销小。 | 每轮需在 Python 层重新计算布尔表达式并执行赋值语句,固定次数下略慢于 for。 |
什么时候该用 for 循环:面向确定集合与惰性流
只要任务的核心是“把一批元素逐个拿出来处理”,或者“把某段操作固定重复 N 次”,for 循环就是直接且稳妥的选择。除了直接遍历列表、字典和集合外,Python 还提供了一系列内置工具,让原本在其他语言里需要写 while 的场景,在 Python 中也能用更清晰的 for 循环完成。
1. 同时需要元素和下标:用 enumerate 替代手动计数
很多初学者为了拿到当前元素的索引,会退回去写 i = 0 和 while i < len(data)。实际上,内置的 enumerate() 函数可以直接在每次迭代时同时产出索引和元素值,既保留了 for 循环的安全边界,又省去了手动递增。
2. 固定次数或等差步进:使用 range 对象
当需要重复执行某项操作固定次数,或者按固定步长(例如每次加 2、倒序递减)生成整数序列时,使用 for i in range(start, stop, step)。range 是惰性计算的序列对象,不管范围多大,它只保存起始值、终点值和步长,不会一次性在内存里生成完整的整数列表。
3. 逐行读取大文件或处理生成器
文件的行数在读取完之前虽然未知,但 Python 的文件对象本身实现了迭代器协议。直接写 for line in file_obj:,每次只从缓冲区读取一行,读到文件末尾(EOF)自动触发 StopIteration 退出,比手写 while True: line = file_obj.readline() 更简洁,也不容易漏写空字符串判断。
# 场景 A:同时获取序号与内容(start=1 表示序号从 1 开始)
servers = ["10.0.0.11", "10.0.0.12", "10.0.0.13"]
for idx, ip in enumerate(servers, start=1):
    print(f"节点 #{idx} 地址: {ip}")

# 场景 B:按固定步长倒序采样(从 10 递减到 2,步长为 -4)
sampled_points = []
for tick in range(10, 0, -4):
    sampled_points.append(tick)
print(f"倒序采样点: {sampled_points}")

# 场景 C:并行遍历两个关联列表(在较短列表耗尽时自动安全停止)
metrics = ["CPU使用率", "内存占用"]
values = ["42%", "68%"]
for name, val in zip(metrics, values):
print(f"{name}: {val}")节点 #1 地址: 10.0.0.11
节点 #2 地址: 10.0.0.12
节点 #3 地址: 10.0.0.13
倒序采样点: [10, 6, 2]
CPU使用率: 42%
内存占用: 68%什么时候必须用 while 循环:面向动态条件与自定义步进
既然 for 循环如此省心,为什么还需要 while 循环?原因在于迭代器的推进规则是固定的——每次调用 next() 只会单向往前走一步。一旦遇到以下三类问题,for 循环就会变得捉襟见肘,而 while 循环则刚好契合。
1. 循环结束时机取决于外部状态或数值收敛
例如等待用户输入合法的参数、轮询外部接口直到任务状态变为已完成、或者在数值计算中不断逼近直到误差小于某个阈值。这类任务在开始前根本不存在一个可供遍历的“集合”,甚至无法预知会循环 1 次还是 100 次。
2. 索引移动方向或步长在运行途中动态变化
在双指针算法(左右指针同时向中间收缩)、二分查找(每次将搜索区间折半)或解析变长数据包(根据当前字节的值决定往后跳过几个字节)时,下一步跳到哪个位置是由当前轮的计算结果临时决定的。for i in range(...) 在循环开始那一刻步长就已经锁死,即使在循环体里强行修改变量 i,下一轮开始时 i 仍会被迭代器吐出的新值覆盖。
3. 遍历列表的同时需要在原地删除或插入元素
这是一个非常容易踩坑的细节:如果用 for 循环遍历一个列表,同时在循环体内部调用 remove() 或 pop() 删除当前元素,会导致后续元素整体左移,而列表迭代器的内部索引依然按原计划加 1,结果直接跳过紧随其后的那个元素。
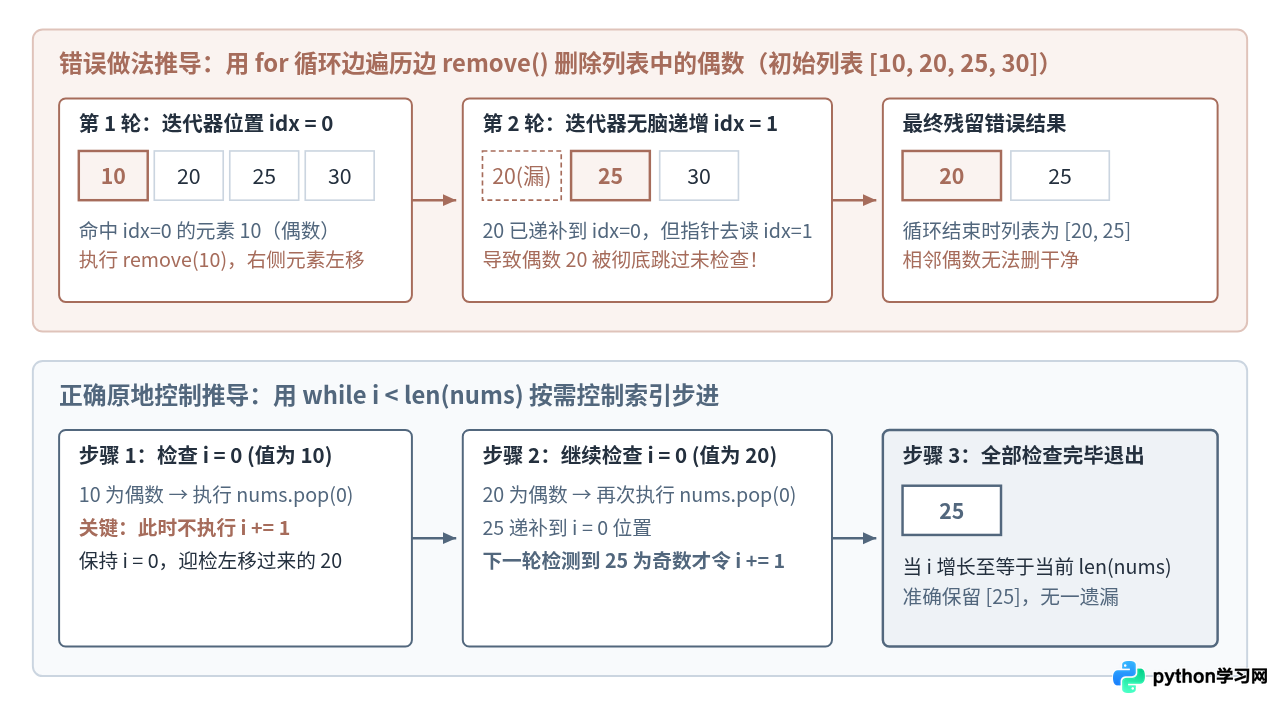
下面这段代码演示了 while 循环在“原地按条件剔除列表元素”以及“带最大重试限制的状态轮询”两个典型场景中的具体写法:
# 场景 1:在原列表上直接剔除所有偶数(不创建新列表)
nums = [10, 20, 25, 30]
i = 0
while i < len(nums):
    if nums[i] % 2 == 0:
        nums.pop(i)  # 删除元素后,右侧元素左移,i 保持不变以检查递补上来的新元素
    else:
        i += 1       # 只有当前元素保留时,才将索引向后移动一位

print(f"原地剔除偶数后的列表: {nums}")

# 场景 2:模拟带重试上限的任务状态轮询
simulated_responses = ["PENDING", "PENDING", "READY"]
max_retries = 5
attempt = 0
task_status = "PENDING"

while task_status != "READY" and attempt < max_retries:
    # 模拟从外部接口获取当前状态
    task_status = simulated_responses[attempt]
    attempt += 1
    print(f"第 {attempt} 次轮询,当前状态: {task_status}")

if task_status == "READY":
print("任务已就绪,进入后续处理流程。")原地剔除偶数后的列表: [25]
第 1 次轮询,当前状态: PENDING
第 2 次轮询,当前状态: PENDING
第 3 次轮询,当前状态: READY
任务已就绪,进入后续处理流程。nums = [x for x in nums if x % 2 != 0]。只有在多个地方共享同一个列表引用、必须在原地修改时,才需要使用上面的 while 索引控制法。
循环控制与 else 子句:容易混淆的细节
不论是 for 还是 while,在循环内部都可以使用 break(立即终止整个循环)和 continue(跳过当前轮剩余语句,直接进入下一轮)。不过,continue 在两种循环中有一个非常关键的差异。
在 for 循环中触发 continue 时,解释器会自动调用迭代器的 next() 进入下一个元素,绝不会卡在原地;而在 while 循环中触发 continue 时,程序会直接跳回开头的条件判断处。如果把状态更新语句(例如 i += 1)写在了 continue 之后,状态变量将永远无法更新,程序会立刻陷入无限循环。
另一个容易让读者困惑的语法是 Python 特有的 for...else 与 while...else 结构。很多人误以为 else 是在“循环一次都没执行”时触发,其实它的真实规则只有一条:只要循环是自然结束的(for 耗尽了所有元素,或 while 的条件自然变为 False),没有被 break 中途打断,就会执行 else 块中的代码。
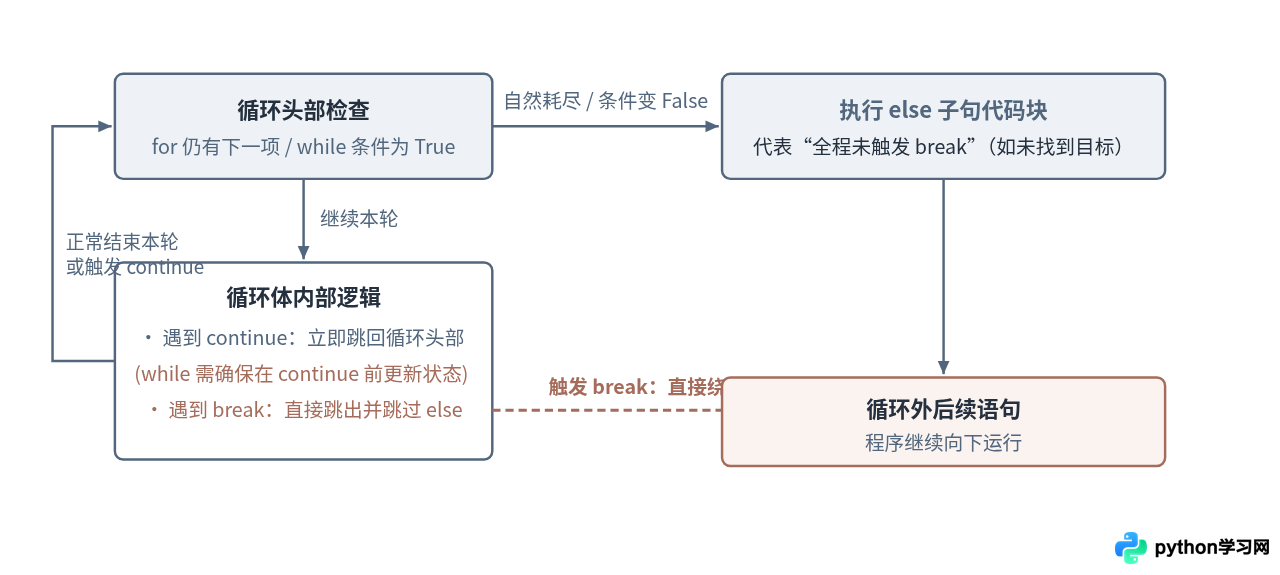
把循环后的 else 当作 no_break(未发生中断)来理解最为直观。比如在列表里搜索某个异常配置项,找到了就立刻 break 报错,如果整个列表翻了一遍都没触发 break,就会自动进入 else 分支输出“全部配置正常”,从而省去定义一个 found = False 标志变量的麻烦:
ports = [80, 443, 8080, 8443]

for port in ports:
    if port < 0 or port > 65535:
        print(f"发现非法端口配置: {port}")
        break
else:
    # 只有当上面所有的 port 都没有触发 break 时,才会执行到这里
print("所有端口均在合法范围内,校验通过。")所有端口均在合法范围内,校验通过。实际编码中的选择路径与总结
在日常编写 Python 代码时,绝大多数循环需求都可以用 for 循环解决。如果发现自己准备写 while,不妨先沿着下面这张决策图核对一遍核心条件,这样既能避免把简单的遍历写复杂,也能在真正需要动态控制时果断使用 while。
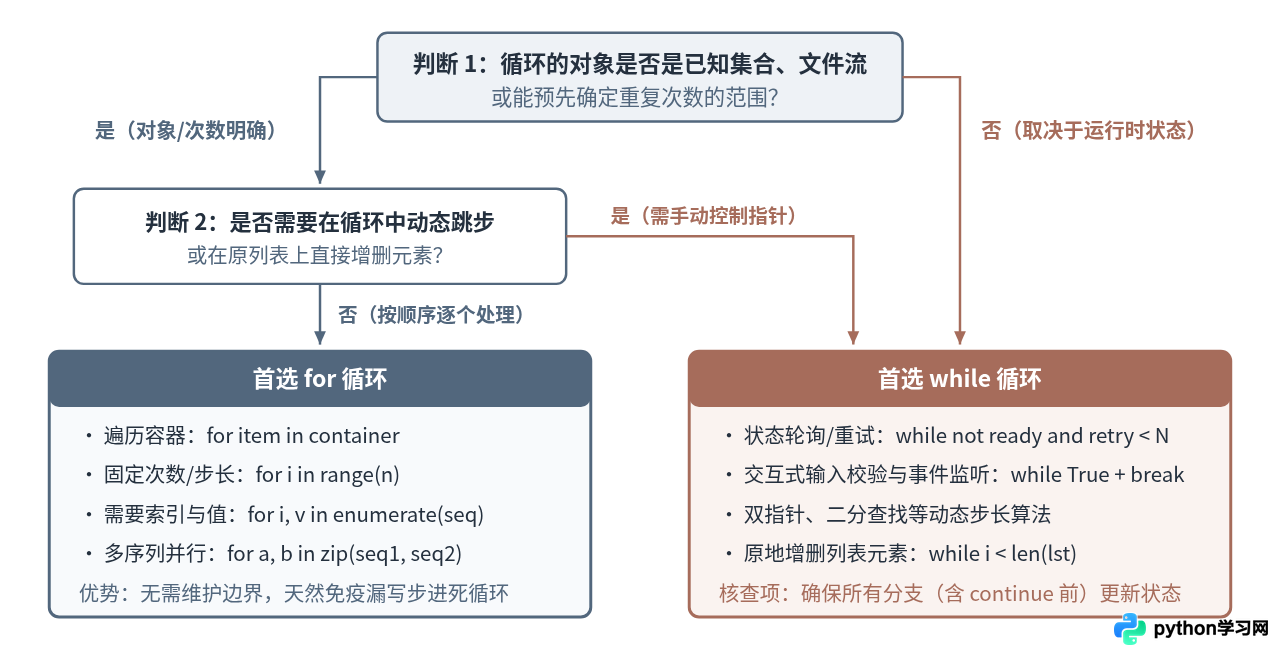
归纳起来,for 循环关注的是“集合里还有没有下一个元素”,把迭代过程交给对象自身管理,适合一切次数确定或数据源确定的遍历任务;while 循环关注的是“当前运行状态是否还满足继续的条件”,把推进权完全交给开发者,适合次数未知、步长动态变化或依赖外部反馈的场景。先看数据源是否确定,再看步进规则是否固定,就能在两者之间做出清晰、稳健的选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















