


Python怎么获取列表的元素个数
本文深入讲解在Python中获取列表元素个数的标准方法与进阶场景,涵盖内置len()函数的基本语法、底层CPython的O(1)复杂度原理、嵌套列表的元素展开统计、以及特定元素频次统计与常见易错点。
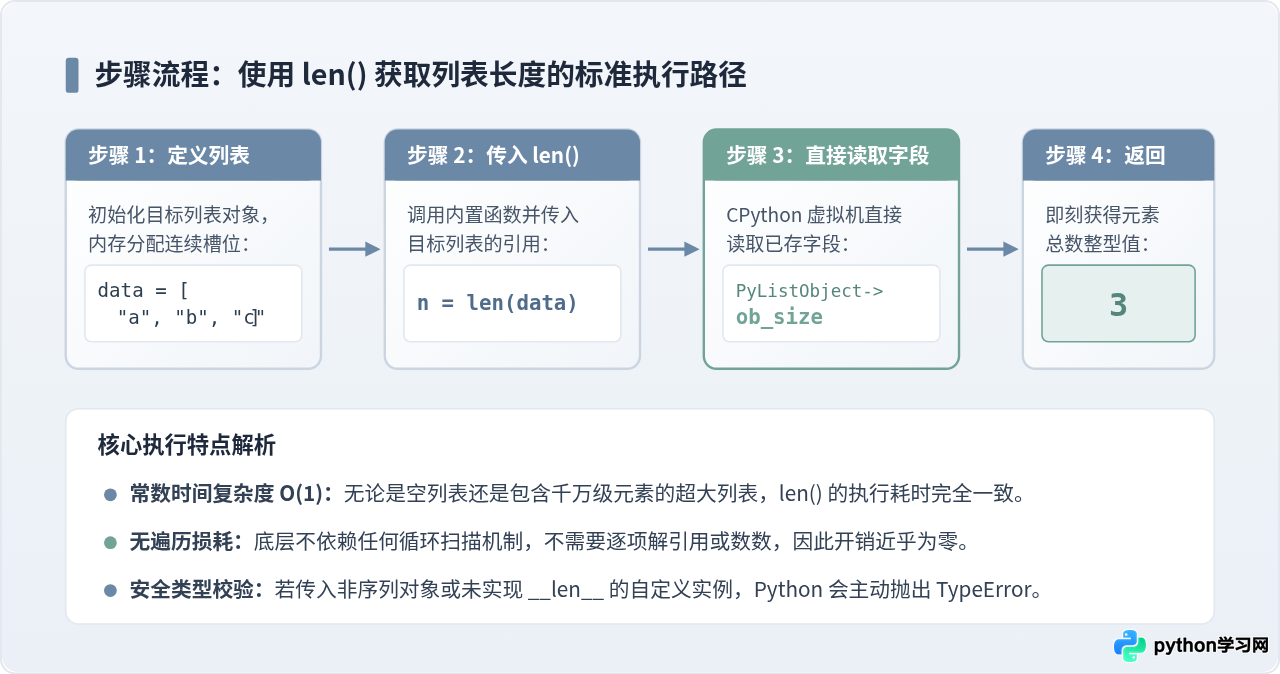
len(目标列表)。该函数直接返回列表中包含的元素数量整型值。无论列表中存放的是整数、字符串还是其他复合对象,甚至是一个空列表,len() 都能以常数时间复杂度 \(O(1)\) 瞬间给出准确结果。对于存在嵌套结构的二维或多维列表,则可以通过列表推导式配合 sum() 实现多层统计。
一、基础用法:使用内置 len() 函数
Python 为所有序列类型(包括列表 list、元组 tuple、字符串 str 等)提供了统一的内置函数 len()。获取列表长度的语法极其简洁:
# 示例 1:获取常规列表元素个数
fruits = ["apple", "banana", "orange", "grape"]
count = len(fruits)

print("水果列表的元素个数为:", count)
对于刚创建的空列表,或者经过清空操作后的列表,len() 会直接返回 0:
# 示例 2:空列表的长度判断
empty_list = []
print("空列表的长度:", len(empty_list))

# 实际开发中判断列表是否为空的推荐写法:
if not empty_list:
print("列表当前没有包含任何元素")列表当前没有包含任何元素
if not my_list: 进行布尔判断(PEP 8 推荐),而不是写成 if len(my_list) == 0:。但在需要精确获知元素具体数量时,len() 是唯一的标准方案。
二、底层原理解析:为什么 len() 执行速度极快?
许多初学者会有一个疑问:当列表中存放了数百万甚至上千万个数据项时,调用 len() 会不会耗费大量时间去逐个遍历?
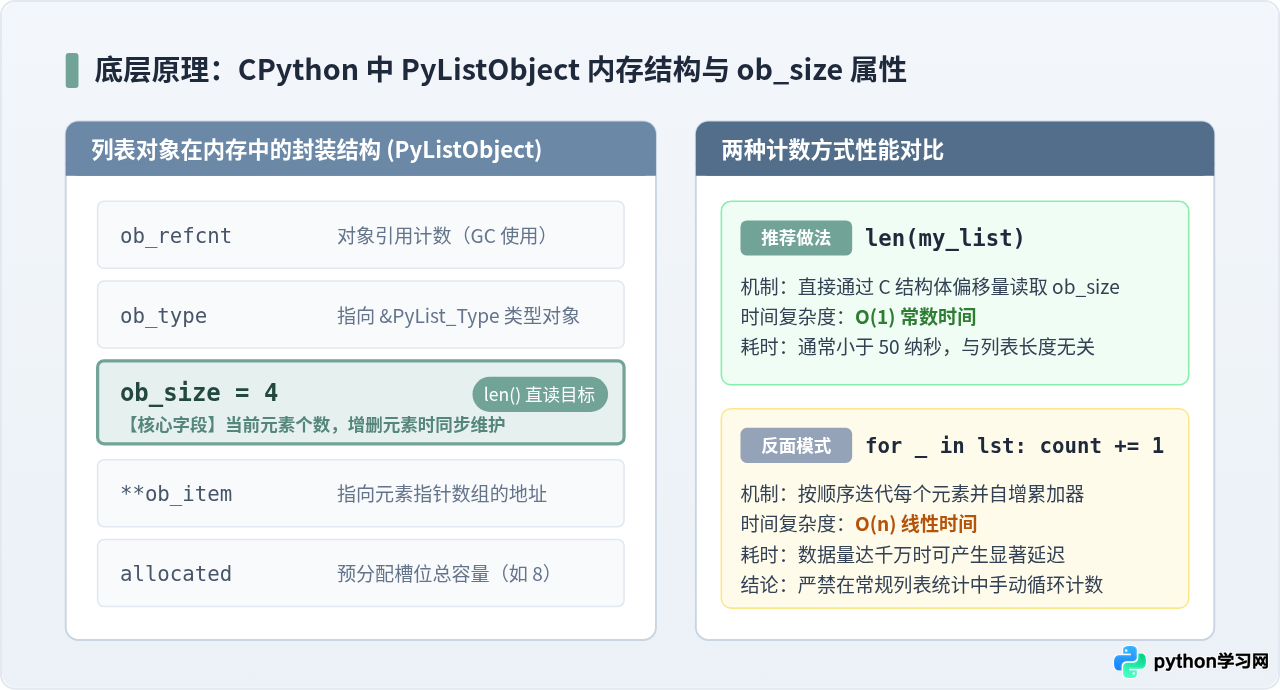
答案是:完全不会。在官方 CPython 实现中,列表底层由 C 语言结构体 PyListObject 表示。该结构体内部维护了一个名为 ob_size 的整型字段,专门用于实时记录列表当前的元素个数。
- 当通过
append()或extend()往列表中添加元素时,Python 会在分配内存后将ob_size的数值加 1。 - 当通过
pop()或remove()删除元素时,ob_size的数值随之减 1。 - 当调用
len(my_list)时,解释器不需要从头到尾数数,而是直接去读取结构体中的ob_size字段。
因此,获取列表长度的时间复杂度为 \(O(1)\)(常数时间)。无论列表包含 1 个元素还是 1 亿个元素,调用 len() 的耗时均在几十纳秒之内。
关于魔术方法 __len__() 的调用约定
当执行 len(my_list) 时,Python 内部实际上委托调用了该对象的特殊方法 my_list.__len__()。但在实际编码中,应当始终书写 len(my_list),而不是直接书写 my_list.__len__()。
原因在于:内置的 len() 函数针对 CPython 原生内置类型做了底层 C 宏级别的特化提速(直接提取 PyVarObject->ob_size),速度显著快于通过属性查找机制调用 __len__()。
三、嵌套列表的元素个数统计
在处理多维数组、表格数据或矩阵等复杂结构时,列表内部常常包含子列表。此时如果直接调用 len(),需要特别注意统计维度的差异。
1. 统计外层元素数量(直接使用 len)
默认情况下,len() 仅统计列表最外层的容器元素项。如果子项本身是一个列表,它依然只被计算为 1 个元素:
# 二维列表示例
matrix = [
    [10, 20, 30],
    [40, 50],
    [60, 70, 80, 90]
]

# 直接调用 len() 得到的是子列表的个数(行数)
outer_count = len(matrix)
print("外层子列表数量:", outer_count)2. 统计所有子列表的底层元素总和
若需求是计算整个二维列表中总共包含多少个具体数字,可使用生成器表达式配合 sum() 函数,对每个子列表分别求 len() 然后累加:
# 统计所有子列表包含的元素总数
total_elements = sum(len(row) for row in matrix)
print("二维矩阵中实际包含的数字总个数:", total_elements)3. 处理不规则的多层任意嵌套
若列表嵌套层级不固定,且深层可能混合标量与列表,则可以通过递归函数遍历所有叶子节点:
def count_leaf_elements(nested):
    total = 0
    for item in nested:
        if isinstance(item, list):
            total += count_leaf_elements(item)
        else:
            total += 1
    return total

mixed_data = [1, [2, [3, 4]], [5, 6], 7]
print("深层任意嵌套的叶子元素总数:", count_leaf_elements(mixed_data))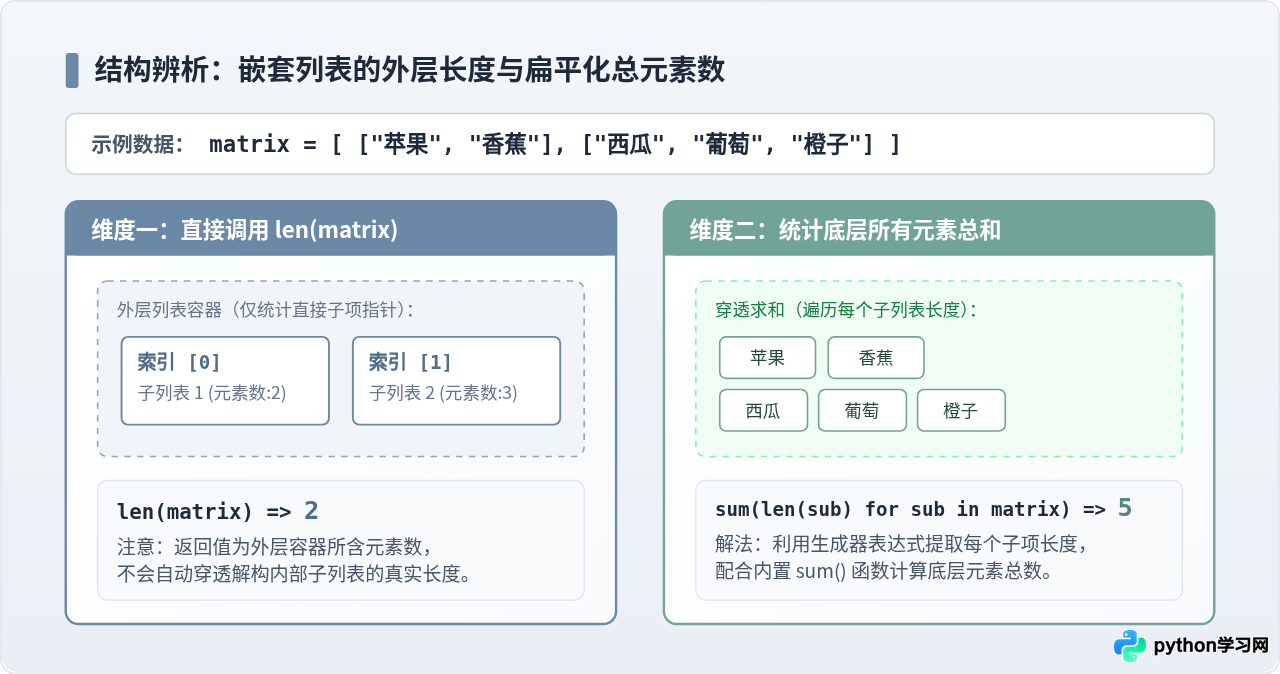
四、区分“元素总数”与“特定值频次”
在实际开发中,容易出现将“获取列表长度”与“统计某个特定值在列表中出现的次数”混淆的情况:
len(list): 统计列表整体的容量和总长度,返回所有元素的总和。时间复杂度为 \(O(1)\)。list.count(x): 统计元素x在列表中出现的频次。这需要线性扫描整个列表,时间复杂度为 \(O(n)\)。
scores = [85, 90, 85, 100, 85, 95]

# 1. 获取成绩总条数
total_records = len(scores)

# 2. 统计考了 85 分的频次
count_85 = scores.count(85)

print(f"总共有 {total_records} 条成绩记录,其中 85 分出现了 {count_85} 次。")五、常见易错点与注意事项
1. 误对生成器或迭代器调用 len()
在 Python 中,生成器(Generator)和迭代器(Iterator)是惰性计算的数据流,它们在运行时不会预先保存数据全量,因此没有实现 __len__ 协议。直接对其调用 len() 会触发 TypeError:
# 错误示例:试图对生成器求长度
gen = (x * 2 for x in range(5))

# 下面这行代码会抛出异常:
# len(gen)  # TypeError: object of type 'generator' has no len()

# 正确处理方案 1:先转化为列表(若内存允许)
gen_list = list(gen)
print("转换为列表后求长度:", len(gen_list))

# 正确处理方案 2:使用 sum 累加器遍历(不常驻内存)
gen2 = (x * 2 for x in range(5))
count_gen = sum(1 for _ in gen2)
print("通过生成器迭代求长度:", count_gen)通过生成器迭代求长度: 5
2. 避免在不需要循环计数的场景手动写循环
部分初学者因为习惯了其他语言的指针遍历,会编写如下代码:
# 不推荐的反面代码
count = 0
for _ in my_list:
    count += 1
这种写法不仅冗长,而且将原本依靠底层 C 结构体在 \(O(1)\) 时间内即可完成的操作,强行劣化为了 \(O(n)\) 的全局循环扫描。在任何常规 Python 列表中,都应坚决使用 len()。
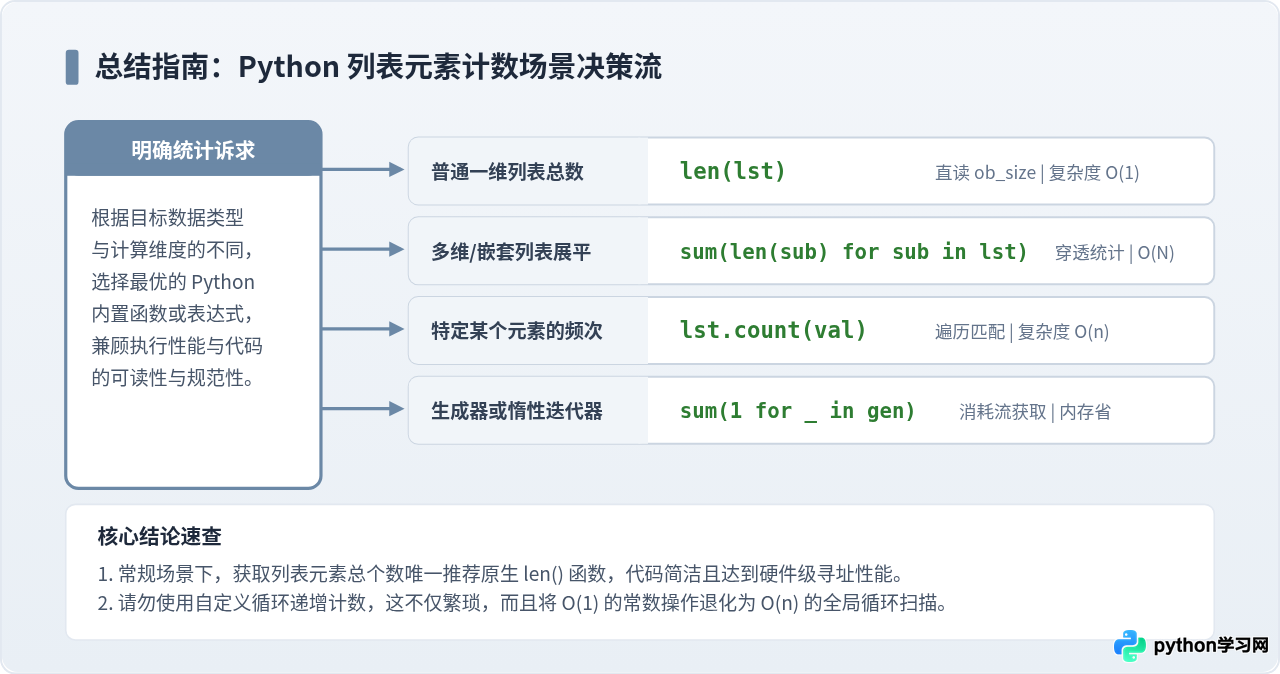
六、场景速查总结表
| 场景诉求 | 推荐方法 | 时间复杂度 | 返回结果示例 |
|---|---|---|---|
| 普通一维列表总个数 | len(lst) |
\(O(1)\) | 4 |
| 嵌套列表外层行数/项数 | len(matrix) |
\(O(1)\) | 2 |
| 二维嵌套列表展平总数 | sum(len(sub) for sub in matrix) |
\(O(n)\) | 5 |
| 特定元素值在列表中出现的频次 | lst.count(val) |
\(O(n)\) | 3 |
| 生成器 / 惰性数据流项数 | sum(1 for _ in gen) 或 len(list(gen)) |
\(O(n)\) | 根据流长度计算 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















