


Python字典报错SyntaxError:怎么检查中英文标点与括号匹配
针对Python字典常见的SyntaxError语法报错,详细剖析中英文标点混淆(全角冒号、逗号、引号)与括号不匹配的根因,提供报错滞后原理分析、四步排查流程及工程化防错方案。
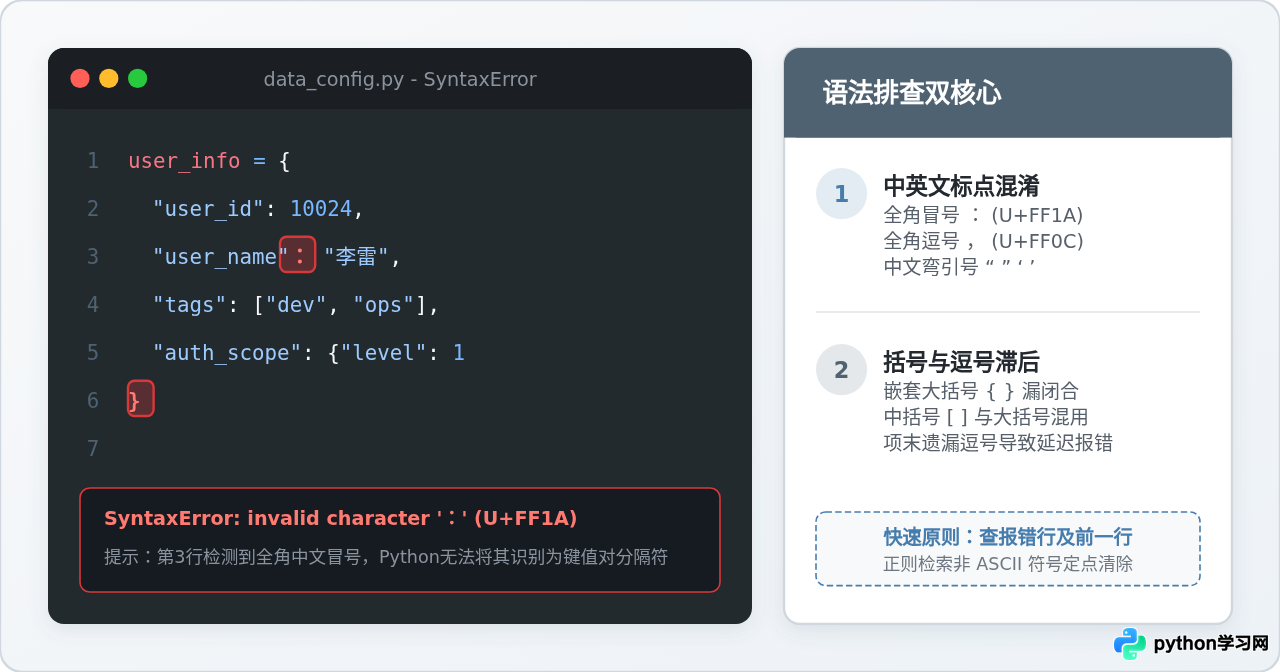
在编写 Python 字典时,遇到 SyntaxError: invalid syntax、SyntaxError: invalid character 或 SyntaxError: '{' was never closed,绝大多数情况并非复杂的逻辑错误,而是由两类极微小的疏漏引发:输入法切换遗留的全角中文标点(尤其是冒号与逗号),以及嵌套结构中的开闭括号不匹配或项末漏写逗号。由于 Python 解释器词法分析器的贪婪读取机制,终端提示的报错行往往落在此处之后的一行,容易给初学者造成“报错行明明没有错误”的困惑。本文围绕这一具体问题,系统梳理报错原因、排查方法与实用工具。
一、字典报错 SyntaxError 的典型表现与错误信息
当 Python 字典结构存在标点或闭合异常时,不同版本的解释器会抛出针对性不同的提示信息。准确识别这些报错内容,能够帮助我们在第一时间判断是符号编码问题还是结构闭合问题。
1. 全角字符报错(Python 3.10+ 增强提示)
在 Python 3.10 及以上版本中,解释器大幅强化了错误定位能力。如果字典中混入了全角标点,解释器会精确指出非法字符及其 Unicode 码位:
# 错误示例:使用了中文全角冒号
user = {"name": "Alice"}

# 解释器抛出:
  File "test.py", line 1
    user = {"name": "Alice"}
                  ^
SyntaxError: invalid character ':' (U+FF1A)
而在较旧的 Python 版本(如 Python 3.8/3.9)中,该错误通常仅显示为泛化的 SyntaxError: invalid syntax,光标直接指向全角字符所在的位置或紧接着的下一个有效 Token。
2. 括号未闭合与跨行截断
若字典左侧大括号 { 开启后未在合适位置配对右侧大括号 },Python 会一直向后扫描,直到遇到不合法的缩进、文件末尾(EOF)或另一个语法块,从而产生延迟报错:
# 错误示例:外层字典未闭合
config = {
    "host": "127.0.0.1",
    "port": 8080

def start_server():
    pass

# 解释器抛出:
  File "test.py", line 5
    def start_server():
    ^
SyntaxError: invalid syntax
在 Python 3.10+ 中,这通常会明确提示 SyntaxError: '{' was never closed,并指示到开启大括号的具体行号,这让反向追踪变得极为简单。
二、四步排查流程:快速定位并修复字典语法错误
面对庞大或多层嵌套的字典代码,逐行肉眼核对既耗时又容易漏看。按照以下由表及里的四个步骤排查,可以在数分钟内准确定位根因。
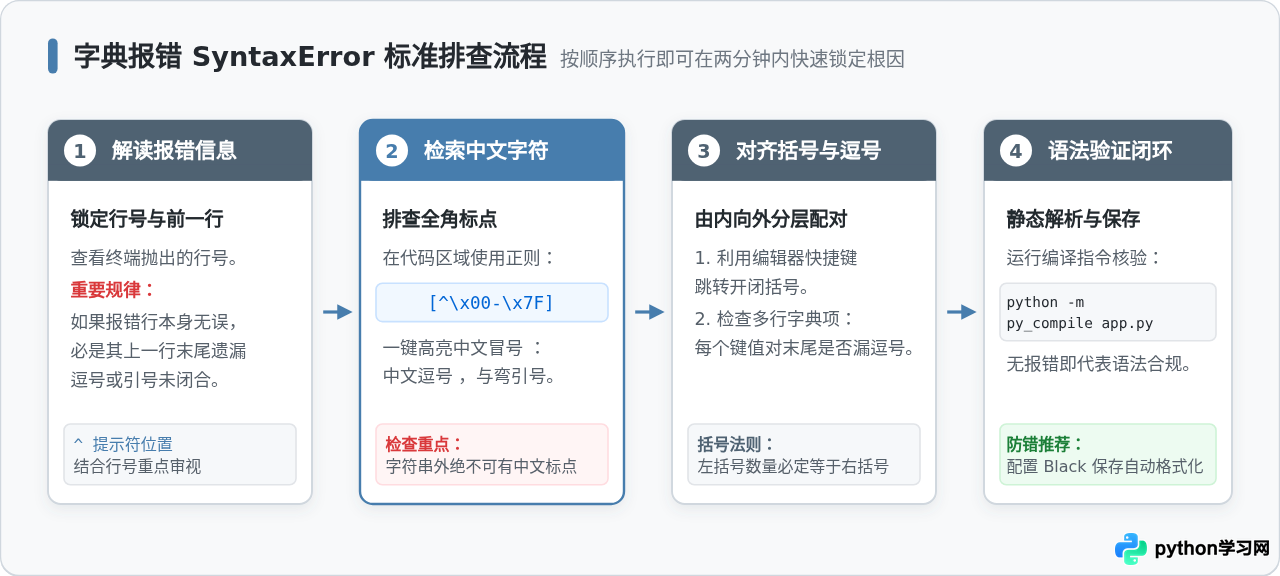
步骤 1:阅读 Traceback,务必兼顾检查上一行
查看终端给出的错误文件路径和行号。如果报错所在行看起来完全正确(例如仅是一个合法的键值对或变量定义),请立刻向上查看上一行代码的末尾。在多行字典中,上一行末尾漏写逗号 , 会导致解释器将当前行的键名视为上一行值的延伸,从而在当前行触发语法中断。
步骤 2:检索并剔除非 ASCII 中文全角标点
在编辑器中按下全局搜索快捷键(如 VS Code / PyCharm 的 Ctrl+F 或 Cmd+F),开启正则表达式模式,输入如下表达式搜索当前文件:
[^ -]该正则会直接高亮所有非标准 ASCII 字符。如果高亮出现在字符串双引号外部,则必然是非法的全角标点。重点观察以下三处:
- 键与值之间是否使用了中文冒号
:; - 元素与元素之间是否使用了中文逗号
,; - 包裹字符串的引号是否变成了中文弯引号
“ ”或‘ ’。
步骤 3:由内向外对称校验括号与层级闭合
对于包含嵌套列表 [] 或子字典 {} 的数据,建议从最内层的括号对开始核对:
- 每一对
{是否严格对应同级的}; - 是否存在把中括号
]错写为大括号}或小括号)的情况; - 多行字典中的每个换行键值对末尾是否都保留了半角逗号
,(Python 允许在最后一个元素后保留尾随逗号,这一习惯能有效减少增删项时的漏逗号风险)。
步骤 4:运行静态编译命令,形成闭环验证
修正符号后,无需启动整个可能带有庞大依赖的业务工程,可直接在终端中运行 Python 内置的编译检查模块:
python -m py_compile 你的文件名.py该命令仅对目标脚本进行语法分析(AST 构建),如果没有任何输出直接退出,说明语法错误已经彻底排除;如果仍有隐蔽错误,终端会精确输出下一个语法障碍点。
三、中英文标点辨析:视觉差异与编码底层
在编写含有中文注释或中文字符串值的字典时,输入法若未及时切回英文半角状态,便会在代码骨架中混入形似全角字符。下表详细比对了字典中最容易混淆的三组标点:
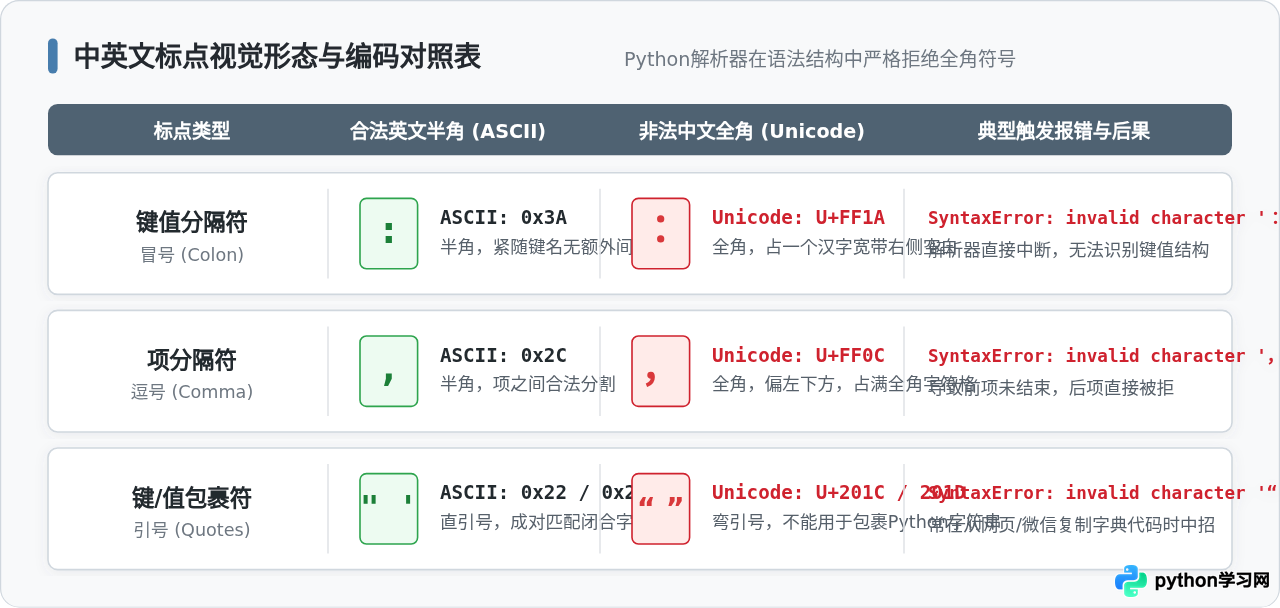
1. 冒号混淆:键值关联断裂
英文半角冒号 :(ASCII 0x3A)在标准等宽代码字体中占用半个字符宽度,其上下两个圆点位置居中;而全角中文冒号 :(Unicode U+FF1A)占据整整一个汉字宽度,且字符后侧通常带有较大的空白间距。Python 解释器读取字典时,依赖 0x3A 作为键与值的严格界定符,遇到 U+FF1A 会直接判定为非法标记。
2. 逗号混淆:元素分割失败
英文半角逗号 ,(ASCII 0x2C)用于切分字典内的独立元素。中文全角逗号 ,(Unicode U+FF0C)虽然也是逗号,但在 Python 词法解析器眼中属于常规 Unicode 字符,无法担当操作符职责,直接引发语法报错。
3. 引号混淆:从外部粘贴代码的常见隐患
许多开发者在从技术文档、聊天工具或网页博客中复制字典片段时,经常遇到 SyntaxError: invalid character '“' (U+201C)。这是由于排版系统将标准英文直双引号 " 自动替换成了具有倾斜方向的中文弯双引号 “ 与 ”。这些字符无法被 Python 识别为字符串边界符号,导致字符串未闭合并破坏后续结构。
四、嵌套字典括号匹配与“报错滞后”机制剖析
在实际开发中,字典经常包含列表或其他字典,形成多层嵌套。此时最令人头疼的往往不是报错本身,而是为什么 Python 报错指示的行号与真正出错的代码行不一致。
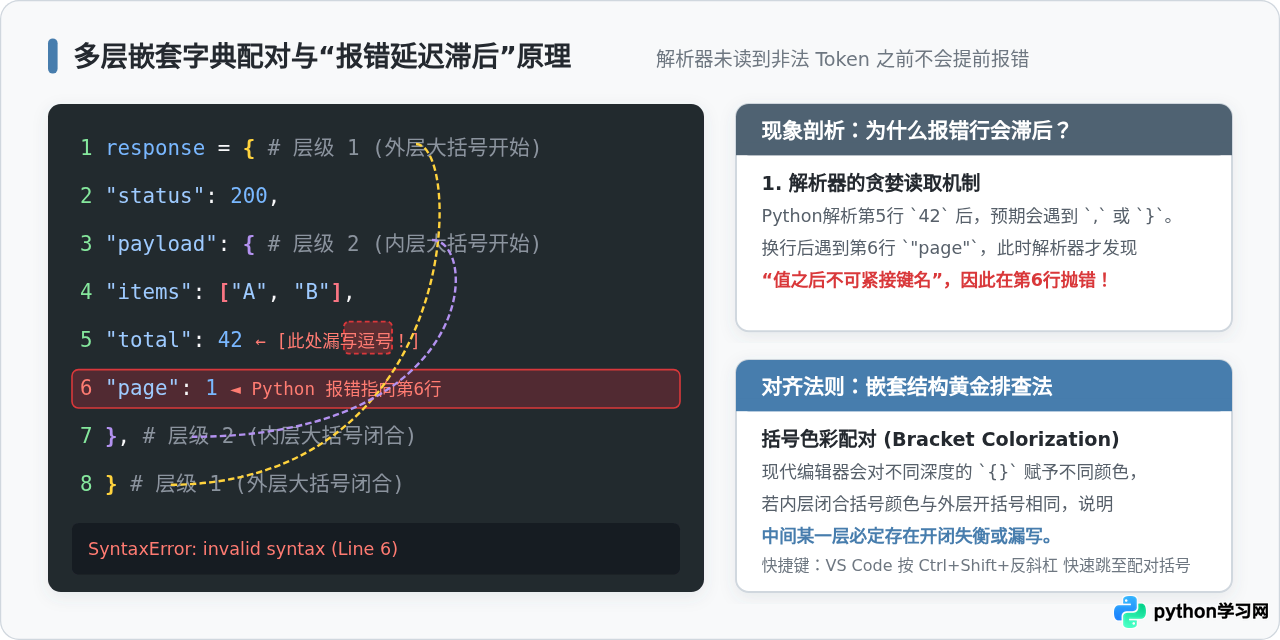
1. 为什么漏写逗号会导致下一行报错?
根据 Python 语法规范,字典中每个项由键和值构成。考虑以下代码片段:
data = {
    "category": "books"      # 注意:此处末尾遗漏了逗号 ,
    "price": 49.9
}
当 Python 解析器读完第 2 行的 "books" 时,根据上下文,接下来必须是一个逗号 , 或者字典结束符 }。然而解释器扫描到第 3 行时,遇到了另一个字符串 "price"。在 Python 语法中,两个字符串字面量相邻会自动进行字符串拼接(如 "a" "b" 等同于 "ab"),但紧接着解析器遇到了冒号 :,此时语法结构彻底崩塌——因为在一个表达式内部不可能出现孤立的冒号。因此,解释器只能在第 3 行冒号处停止并抛出 SyntaxError: invalid syntax。报错发生在第 3 行,但病根完全在第 2 行末尾。
2. 嵌套大括号未闭合与文件扫描终止
若内层字典缺少了右大括号 },外层代码在解析器眼里依然属于未结束的字典内容。此时解释器会跳过正常的语法块分界,直到遇到与当前字典完全冲突的语句(例如顶格书写的 def、class 或文件结束符号)才会抛出异常。如果遇到指示行位于文件末尾或函数定义处,应当立刻沿代码缩进反查最靠近该位置的字典定义区。
五、工程化防错与长期规避策略
反复依赖肉眼和手动搜索并不是高效的开发方式。通过将现代前端与后端开发成熟的防错工具链引入 Python 工作流,可以在编写代码的毫秒级时间内阻断绝大多数语法失误。
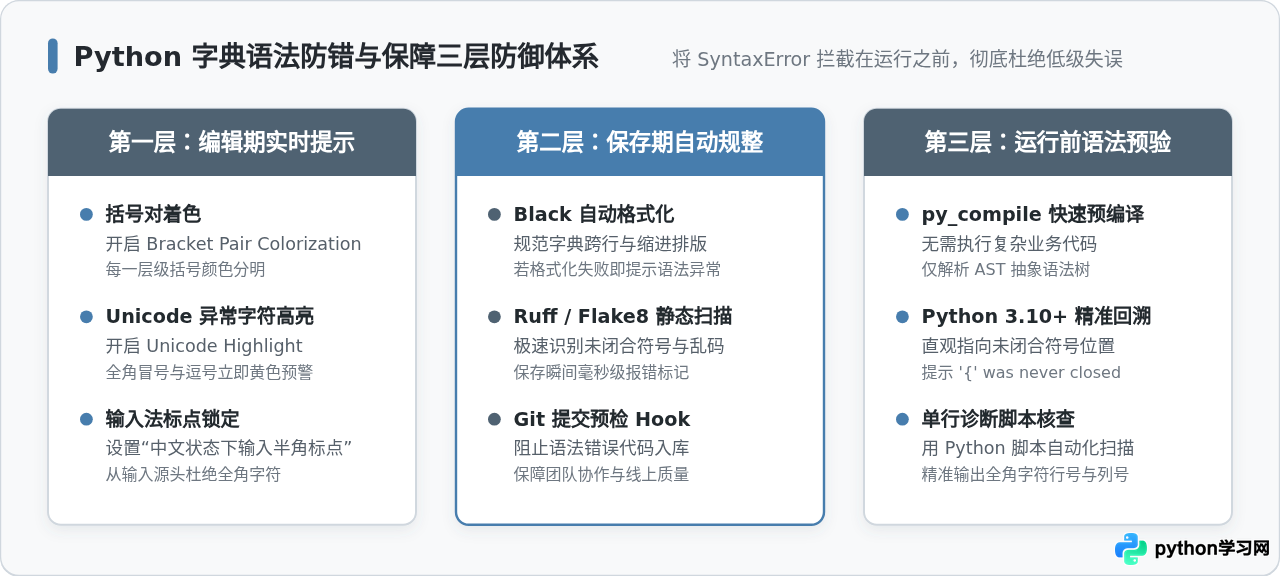
1. 第一层:配置编辑器实时视觉防护
- 开启括号对着色(Bracket Pair Colorization):在 VS Code 的
settings.json中确保"editor.bracketPairColorization.enabled": true。通过为不同深度的{}、[]和()分配不同颜色,层级对应关系一目了然。 - 熟练使用跳转匹配快捷键:光标置于括号一侧时,在 VS Code 中按下快捷键(Windows/Linux 下为 Ctrl+Shift+\,Mac 下为 Cmd+Shift+\),光标会直接跳至配对的另一半。若无法跳转或跳到异常位置,即可确认该括号缺乏闭合。
- 启用不可见字符与 Unicode 警告:开启
"editor.unicodeHighlight.ambiguousCharacters": true,让编辑器主动标注非 ASCII 标点。
2. 第二层:集成自动化格式化工具(Black / Ruff)
代码格式化工具是检测字典语法健康度的试金石。以广泛使用的 Black 或 Ruff Format 为例:
- 开启“保存时自动格式化”(Format on Save)。格式化工具会在每个多行字典项后自动补齐尾随逗号,规避未来新增键值对时的漏写风险;
- 如果保存文件时格式化程序静默未执行,或者控制台弹出解析失败警告,说明当前文件存在硬性 SyntaxError,提示你在运行代码前先处理好标点问题。
3. 第三层:自动化检测脚本(自检单行命令)
在维护含有大规模静态数据字典或配置字典的脚本时,可以编写一个极其简洁的 Python 预检脚本。将其放入终端别名或 CI 检查流水线中:
import ast
import sys

def check_file_syntax(filepath):
    try:
        with open(filepath, "r", encoding="utf-8") as f:
            source = f.read()
        ast.parse(source, filename=filepath)
        print(f"✅ {filepath}: 语法检查通过,无 SyntaxError。")
    except SyntaxError as err:
        print(f"❌ 语法错误定位: {err.filename} 第 {err.lineno} 行,第 {err.offset} 列")
        print(f"   错误详情: {err.msg}")
        if err.text:
            print(f"   出错代码行: {err.text.strip()}")

if __name__ == "__main__":
    if len(sys.argv) > 1:
        check_file_syntax(sys.argv[1])
    else:
        print("请指定要检查的 Python 文件路径。")
六、排查速查清单与总结
当 Python 字典再次弹出 SyntaxError 时,请按照以下速查清单逐项核对:
- 看行号:终端指示哪一行?该行本身有没有明显的冒号、逗号缺失?
- 查前行:指示行前一行的末尾是否有且仅有一个英文字符半角逗号
,? - 搜全角:全局正则搜索
[^ -],重点排查冒号:、逗号,和弯引号“”; - 数括号:从最内层开始利用快捷键跳转配对,确保
{与}数量绝对对等,且无交叉错位; - 末尾留逗号:养成在多行字典每行末尾保留半角逗号的好习惯,既清晰又防错。
只要理清“全角字符引起非法 Token”与“未闭合符号导致延迟报错”这两大核心机制,字典语法错误便能迎刃而解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















