


Python函数基础教程:def定义、参数传递与返回值
系统讲解Python函数的核心要素:def关键字定义与编译机制、位置与关键字参数传递、可变对象默认值陷阱、按对象引用传递内存模型以及return返回值与控制流中断设计。
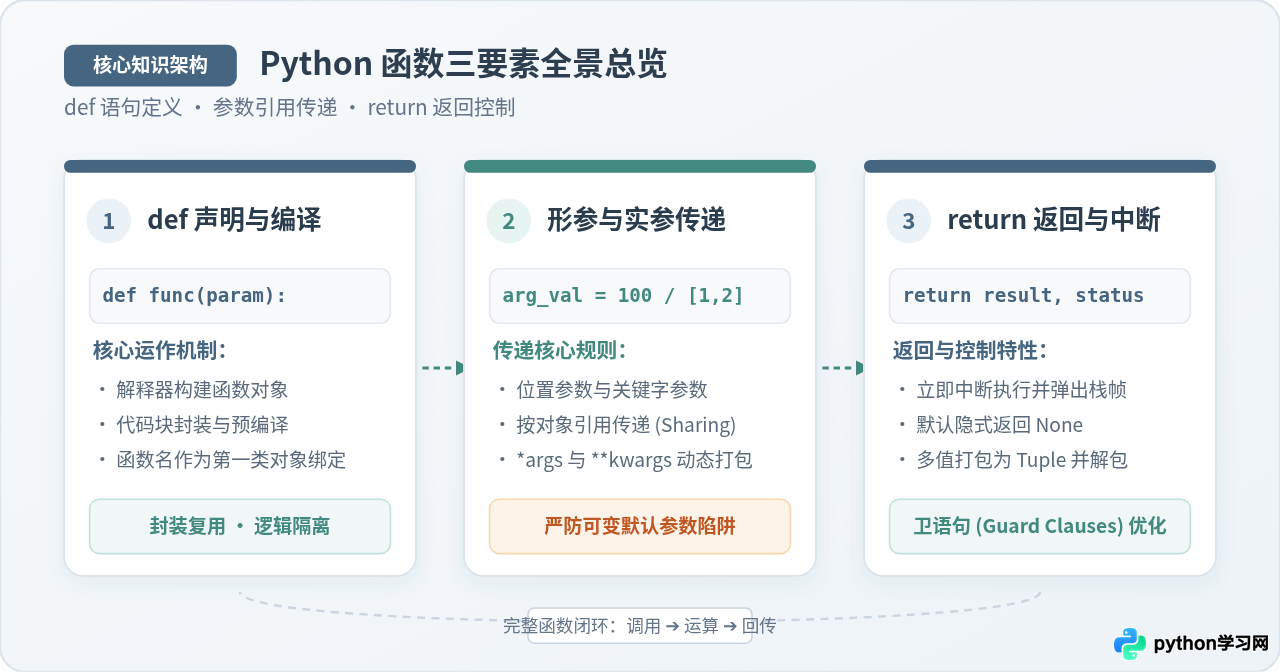
def 关键字声明语法结构,更要透彻理解形参与实参之间“按对象引用传递”的内存机制,以及 return 语句在终止执行与回传数据时的控制流规律。本文从定义语法与生命周期、参数匹配与内存引用模型、到返回值路由与防御性编码,层层递进完成完整剖析。
一、函数的基本定义与调用生命周期
在 Python 中,函数并非单纯的代码文本块,而是在解释器运行到 def 语句时动态创建的一等公民对象(First-Class Object)。这意味着函数本身可以被赋值给变量、作为参数传入其他函数,甚至作为另一个函数的返回值。
1. 基础语法规范与结构拆解
定义函数使用 def(define 的简写)关键字,后接函数名、一对圆括号(用于容纳形参声明)和英文冒号 :。函数体内的具体逻辑必须保持统一的缩进(推荐 PEP 8 规定的 4 个空格):
# 基础函数定义与类型注解示例
def calculate_tax(income: float, rate: float = 0.1) -> float:
    """计算给定收入与税率下的应纳税额。

    :param income: 总收入金额(正浮点数)
    :param rate: 适用税率,默认为 10%
    :return: 计算出的纳税金额
    """
    if income < 0:
        raise ValueError("收入金额不能为负数")
    tax_amount = income * rate
    return tax_amount
上述代码包含了现代 Python 函数设计的四个良好习惯:
- 清晰的动词命名:函数名
calculate_tax直观表达操作行为,遵循小写下划线命名法(snake_case)。 - 类型注解(Type Hints):使用
income: float和-> float标明预期类型,便于静态检查与 IDE 自动补全。 - 文档字符串(Docstring):函数体首行的多行字符串可通过
calculate_tax.__doc__或内置函数help(calculate_tax)查看。 - 健壮的边界检查:在正式执行计算前对不合理输入进行前置拦截。
2. 函数调用与执行生命周期
当执行到 def 时,Python 解释器只负责语法检查、编译字节码并生成一个 PyFunctionObject 绑定到对应变量名,此时函数内部的代码并不会执行。只有在遇到带圆括号的调用表达式 func() 时,解释器才会正式开辟执行栈帧。
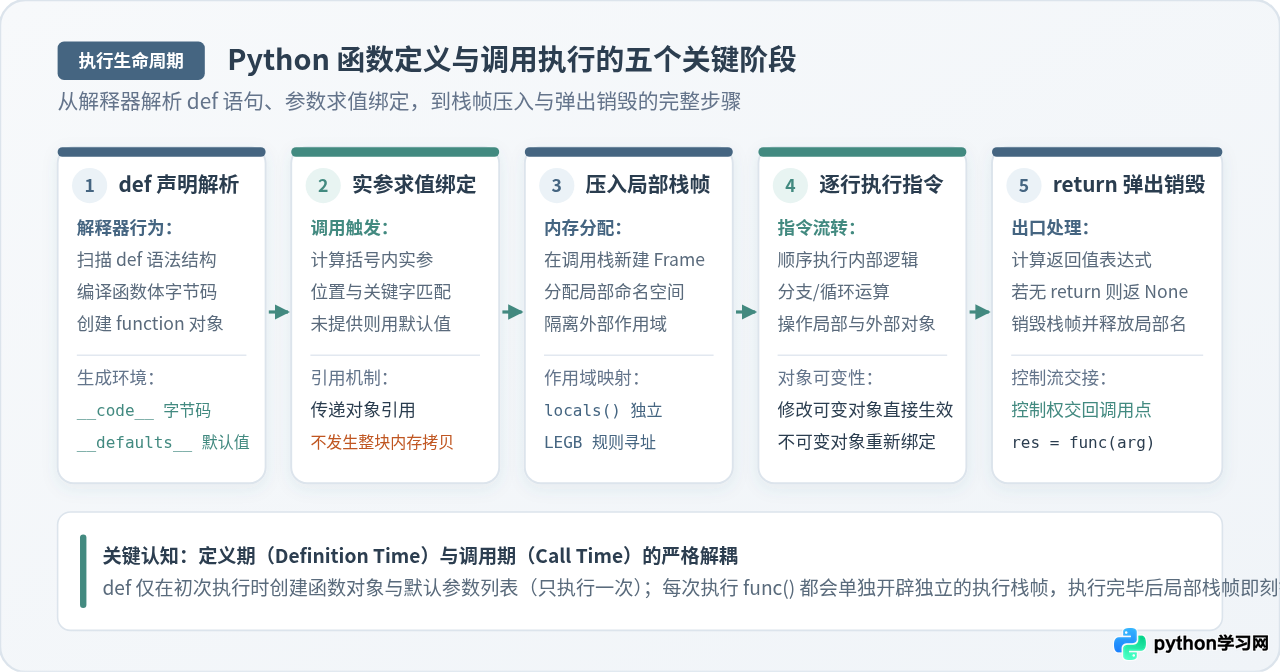
如上图所示,一个函数的完整执行生命周期包括五个明确阶段:
- def 声明解析:构建代码对象(Code Object),分配
__code__、__defaults__属性。 - 实参求值绑定:在函数调用处自左向右计算传入的实参表达式,并按照形参签名建立指针绑定。
- 压入局部栈帧:在 Python 进程调用栈上压入属于当前函数的
FrameObject,为其提供专属的局部命名空间(locals())。 - 指令逐行执行:CPU 在当前栈帧内运行操作码,产生的局部变量仅在此命名空间内可见。
- return 弹出销毁:遇到
return语句后计算回传结果,弹出并销毁局部栈帧,所有未被引用的局部对象交由垃圾回收器(GC)处理。
二、形参与实参传递:规则、语法与内存机制
许多初学者容易对“形式参数(Parameter)”与“实际参数(Argument)”产生混淆:形参是函数定义括号中的变量名称,相当于待填入数据的占位符;实参是调用函数时实际注入的具体数据或变量。
1. 位置参数与关键字参数
传递参数主要有两种基础模式:
- 位置参数(Positional Arguments):实参按照函数定义时的位置顺序一一对应传入。顺序一旦颠倒,数据语义就会错乱。
- 关键字参数(Keyword Arguments):以
param_name=value的形式明确指定将值传给哪个形参。关键字参数允许打乱顺序传入。
def create_profile(name: str, age: int, role: str):
    return f"[{role}] {name}, 年龄: {age}"

# 1. 纯位置参数调用(必须严格保持 name, age, role 顺序)
msg1 = create_profile("李四", 28, "工程师")

# 2. 纯关键字参数调用(顺序无关,可读性极高)
msg2 = create_profile(role="主管", name="王五", age=35)

# 3. 混合调用(关键语法规则:位置参数必须全部在关键字参数之前!)
msg3 = create_profile("张三", role="助理", age=22)

# 错误写法示例:位置参数出现在关键字参数之后,将触发 SyntaxError
# create_profile(name="张三", 22, "助理")  # 语法错误!
2. 可变长参数:*args 与 **kwargs
当预先无法确定调用者会传入多少个参数时,Python 提供了 * 和 ** 语法:
*args:将所有超额的位置实参按顺序打包为一个元组(tuple)。**kwargs:将所有未在形参中明确列出的key=value关键字参数打包为一个字典(dict)。
def log_event(event_type: str, *args, **kwargs):
    print(f"事件类型: {event_type}")
    print(f"位置参数元组 args: {args}")
    print(f"关键字字典 kwargs: {kwargs}")

# 调用示例
log_event("USER_LOGIN", 1001, "成功", ip="192.168.1.1", device="Mobile")
# 输出:
# 位置参数元组 args: (1001, '成功')
# 关键字字典 kwargs: {'ip': '192.168.1.1', 'device': 'Mobile'}
3. 核心内存本质:按对象引用传递(Call by Object Reference)
Python 的参数传递既不同于 C 语言的“纯值拷贝(Pass by Value)”,也不同于某些引用语言的“变量别名传递(Pass by Reference)”。官方称其为按对象引用传递(Call by Object Reference)或共享传递(Call by Sharing):
- 实参传递时,是将实参变量所指向的内存对象地址赋值给形参变量。
- 形参在函数内部最初与外部实参指向同一个内存对象。
- 传递不可变对象(int, float, str, tuple):任何对形参的重新赋值操作(如
n += 1),都会在内存中创建新的数值对象并将形参重新绑定到新地址,外部原变量毫发无损。 - 传递可变对象(list, dict, set):如果通过形参调用其内部变异方法(如
.append()、.update()),直接修改的是该内存对象本身,外部调用者的实参会同步受影响!
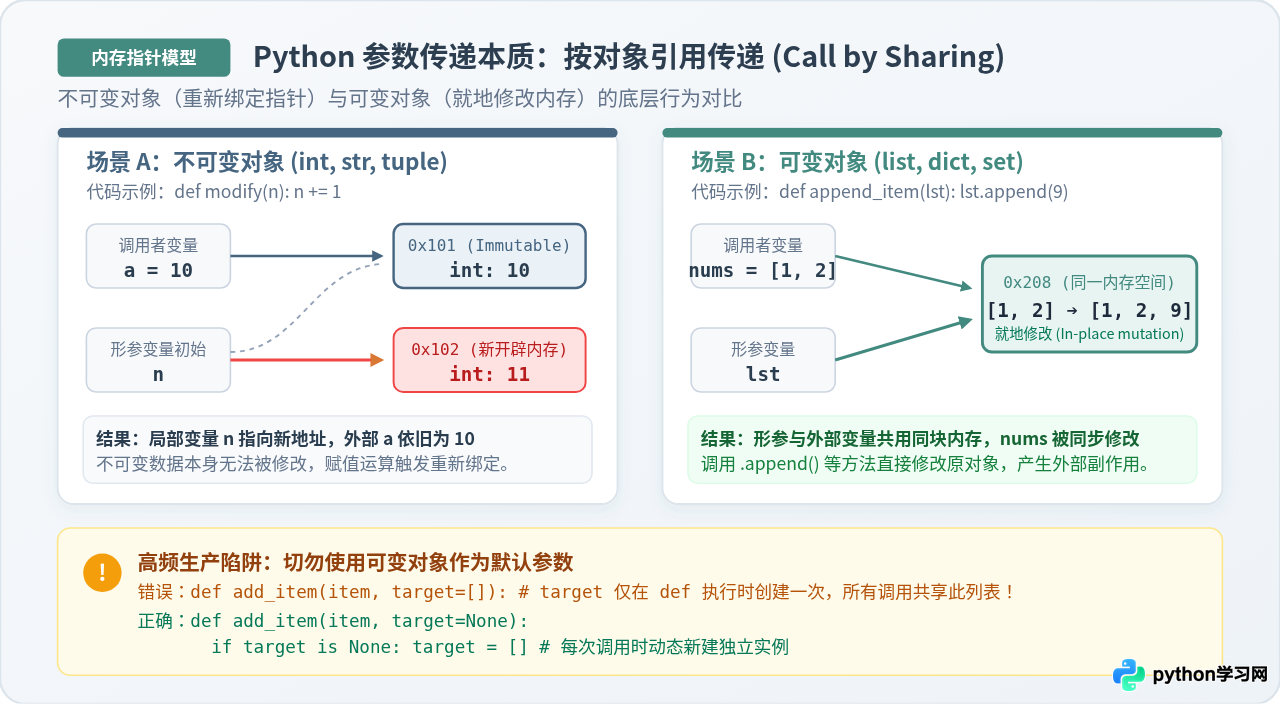
Python 中的默认参数只在
def 语句执行时求值一次,并存放在函数对象的 __defaults__ 元组中。如果默认值是一个可变列表 def add(x, lst=[]),后续每次省略该参数的调用,都会共享同一个列表实例,导致数据隐蔽残留!黄金解决方案:永远使用
None 作为哨兵默认值,在函数体内部动态新建实例:
def add_item(item, target_list=None):
    if target_list is None:
        target_list = []  # 每次调用独立创建崭新列表
    target_list.append(item)
    return target_list
三、函数的返回值与执行控制流(return 机制)
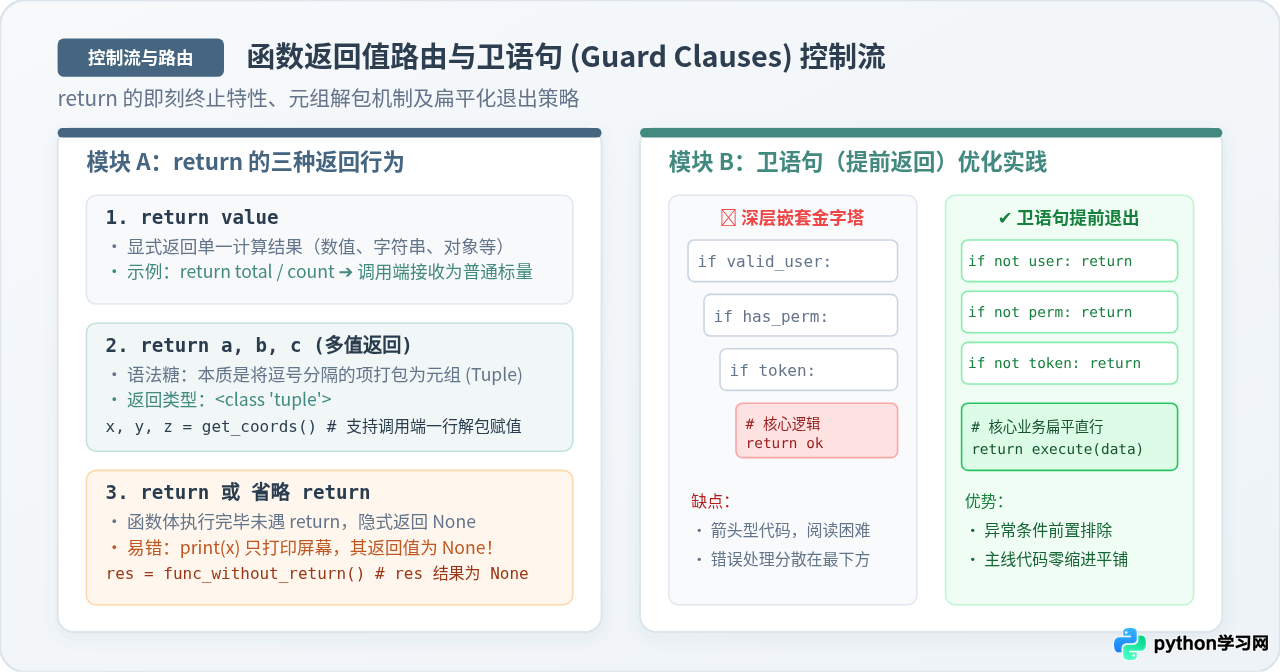
return 语句承担着两项核心使命:将计算数据交付给调用者,以及立刻终止当前函数的运行并弹出调用栈帧。
1. return 的终止特性与隐式返回 None
一旦函数执行流触及 return,该行之后的任何代码都会被跳过。若函数体执行完毕未遇到 return,或者单独执行了一个空的 return,Python 会隐式返回内置单例 None。
def process_order(status: str):
    if status == "CANCELLED":
        return  # 立即退出,隐式返回 None
    print("正在执行扣款与发货...")
# 正常流程末尾若无 return,同样默认返回 Noneprint() 的职责仅仅是将字符输出到终端标准输出流(stdout)供人观察,其自身的返回值永远是 None;而 return 是将数据返回给程序逻辑上下文。若在函数内只写了 print(res) 而未写 return res,调用者用变量接收结果将得到空值 None,无法在后续业务中进行二次运算。
2. 多值返回与元组自动解包
在 Python 中,可以在 return 之后使用逗号隔开多个表达式。这在语法上看起来像是同时返回了多个独立变量,其实质是 Python 自动将其打包成了一个不可变的元组(Tuple):
def get_dataset_statistics(numbers: list[float]):
    if not numbers:
        return 0, 0.0, 0.0  # 打包为元组 (0, 0.0, 0.0)
    count = len(numbers)
    total = sum(numbers)
    average = total / count
    return count, total, average  # 实际返回元组 (count, total, average)

# 方式 1:利用序列解包,分别接收各个字段
cnt, sm, avg = get_dataset_statistics([10.0, 20.0, 30.0])

# 方式 2:用单一变量接收完整的元组结果
summary_tuple = get_dataset_statistics([10.0, 20.0, 30.0])
print(type(summary_tuple))  # <class 'tuple'>
3. 提前返回优化:卫语句(Guard Clauses)
在编写复杂业务函数时,多重条件校验容易导致代码陷入多层 if-else 嵌套,形成难以维护的“金字塔代码”。利用 return 的即刻退出特性,采用卫语句(Guard Clauses)可以在函数起始位置迅速排除异常条件,使核心主线逻辑保持扁平:
四、作用域辨析与参数定义优先级链
函数的设计不仅关乎输入输出,还直接决定了变量的生命周期与可见性范围。在函数内部,Python 严格按照 LEGB 规则(Local ➔ Enclosing ➔ Global ➔ Built-in)由近及远查找变量名。
1. 函数形参定义的严格顺序法则
在设计包含多种参数特性的复杂函数时,参数定义的排列顺序必须严格遵循 Python 解释器的语法优先级,顺序颠倒将无法通过语法编译:
| 优先级 | 参数类型 | 语法形式 | 功能说明 |
|---|---|---|---|
| 1 | 仅限位置参数 | arg, / |
斜杠 / 前的参数只能按位置传入,不可使用关键字(Python 3.8+) |
| 2 | 标准位置/关键字参数 | arg |
可按位置传入,也可按关键字传入 |
| 3 | 默认值参数 | arg=default |
必须紧随无默认值参数之后,若未显式传参则使用默认预设值 |
| 4 | 可变位置参数 | *args |
收集后续所有超出的位置参数并打包为 tuple |
| 5 | 命名关键字参数 | *, kw_only |
* 或 *args 之后的参数,强制只能以关键字形式传入 |
| 6 | 可变关键字参数 | **kwargs |
放置在形参列表的最末位,收集所有未被匹配的关键字实参打包为 dict |
2. 全局变量与 UnboundLocalError 陷阱
函数内读取全局变量是完全合法的;但如果在函数体内对一个与全局同名的变量进行赋值运算,Python 会在编译时直接将其标记为局部变量。如果在该赋值语句之前尝试读取该变量,就会触发经典的 UnboundLocalError: local variable referenced before assignment。
counter = 100

def broken_increment():
    # 错误排查:下面这一行会抛出 UnboundLocalError
    # 原因:解释器发现函数内有 counter = ... 赋值,故将 counter 判为局部变量
    # 但在计算 counter + 1 时,该局部变量尚未被赋值!
    # counter = counter + 1
    pass

def correct_increment():
    global counter  # 明确声明引用并修改全局作用域的 counter
    counter += 1
return counterglobal 关键字修改全局状态。优先编写纯函数(Pure Functions):将所需数据全部通过实参显式传入,计算完毕后通过 return 显式交回,避免函数对外部环境产生隐蔽的副作用。
五、核心知识体系与工程速查总结
为了便于在实际开发与代码重构中快速对照核验,下图汇总了 Python 函数从 def 命名规范、参数优先级序列、内存指针模型到返回值工程准则的完整架构速查表:
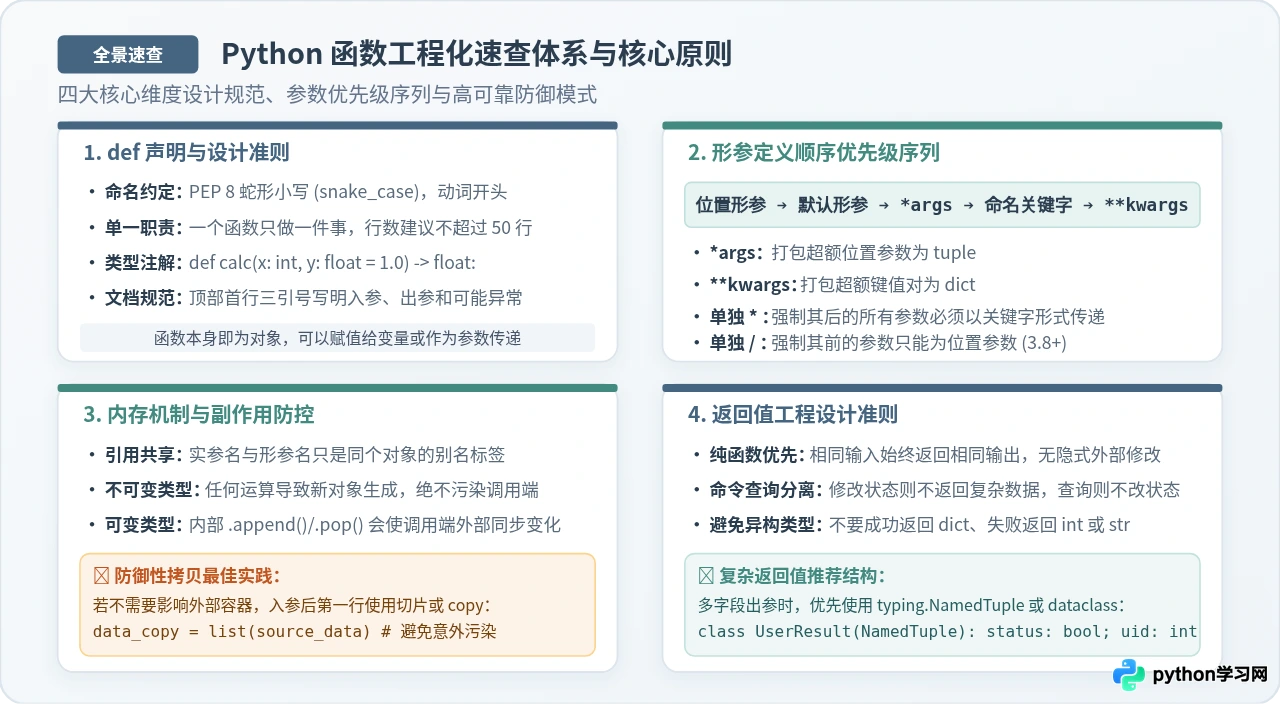
理解 Python 函数的本质,关键在于跳出语法层面的表面形式,理解其底层数据流向:
def是执行期的声明动作,创建唯一的函数对象;- 参数传递本质是变量引用的绑定,对可变对象就地修改会产生外部副作用,默认参数绝对不能使用可变对象;
return负责终结当前执行栈帧并回传单值或打包元组,配合卫语句能有效保持代码架构扁平与清晰。
遵循上述设计规范,能够帮助你在编写 Python 脚本与大型业务框架时,写出逻辑严谨、执行高效、易于维护与测试的高质量函数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















