


怎么解决Python多线程读取文件的数据乱序问题
深入解析Python多线程读取文件时导致数据乱序与指针竞争的根本原因,提供利用全局序号标记、ThreadPoolExecutor.map及as_completed重排的完整保序解决方案与对比指南。
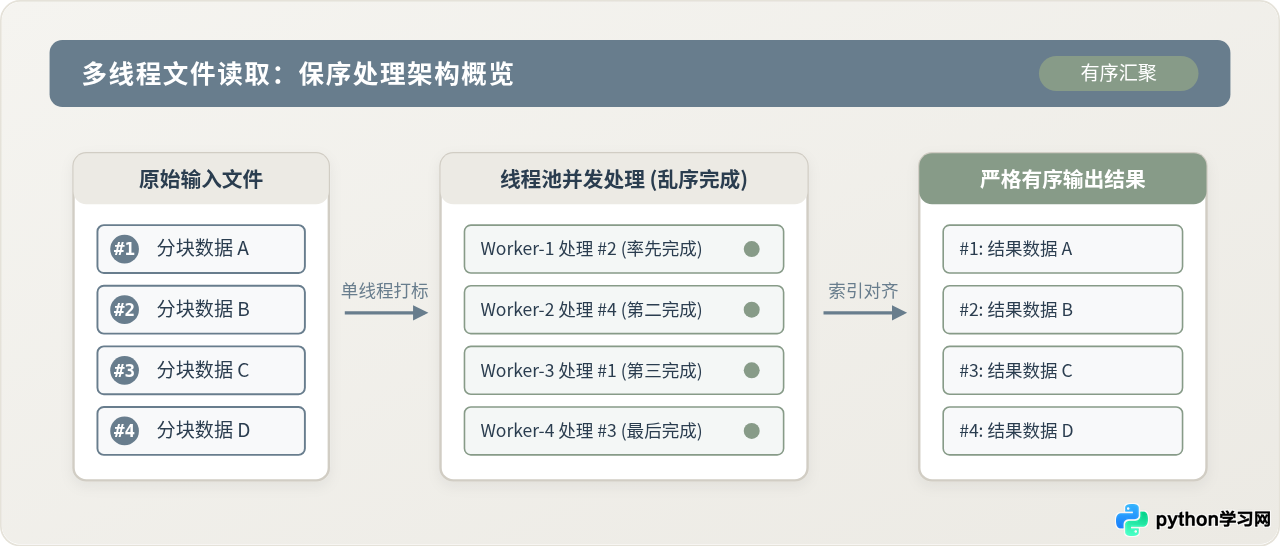
(index, chunk_data),交由线程池并发执行;最终通过 concurrent.futures.ThreadPoolExecutor.map() 自动按原序返回结果,或在 as_completed 汇聚阶段依据序号完成预排与还原。
一、为什么多线程读取必然面临乱序与竞争
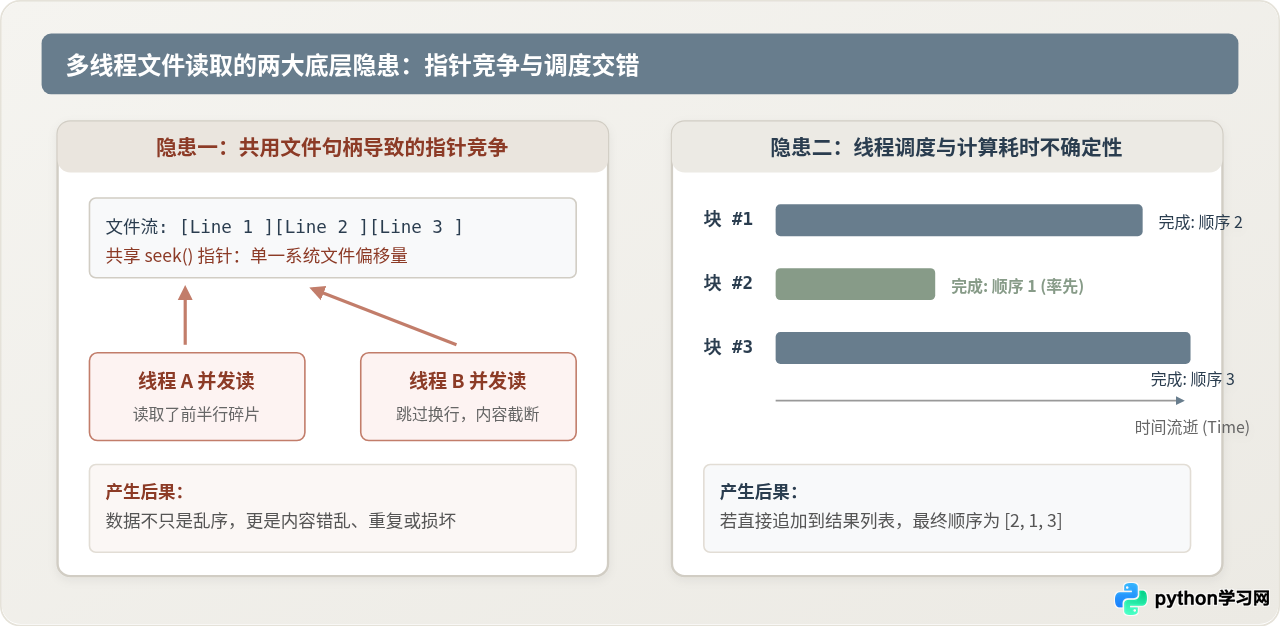
很多开发者在初次尝试提升文件处理吞吐量时,容易直观地让多个工作线程同时对同一个文件句柄调用 f.readline() 或 f.read()。这种做法在多线程环境下会引发两个层面的严重故障:文件指针竞争导致的数据撕裂,以及操作系统调度差异导致的结果乱序。
在底层实现中,打开的文件对象拥有一个共享的内部游标(File Offset)。当线程A刚读取了一部分字节、尚未遇到换行符时,操作系统的CPU时间片若轮转到线程B,线程B就会接着当前游标继续读取。结果不仅行内容被截断打碎,甚至会出现重复消费和数据丢失。因此,绝不能让多个线程共享同一个文件对象进行并发读取。
即使每个线程各自分配独立的文件句柄并读取不同分片,由于各工作线程分配到的计算复杂度不同、I/O耗时存在波动、以及操作系统的抢占式调度,各任务完成的物理时间先后顺序必然不再等于原本文件中的行顺序。如果处理完直接追加到普通列表,最终输出顺序就会彻底被打乱。
二、核心解决路径:解耦读取与处理并绑定序号
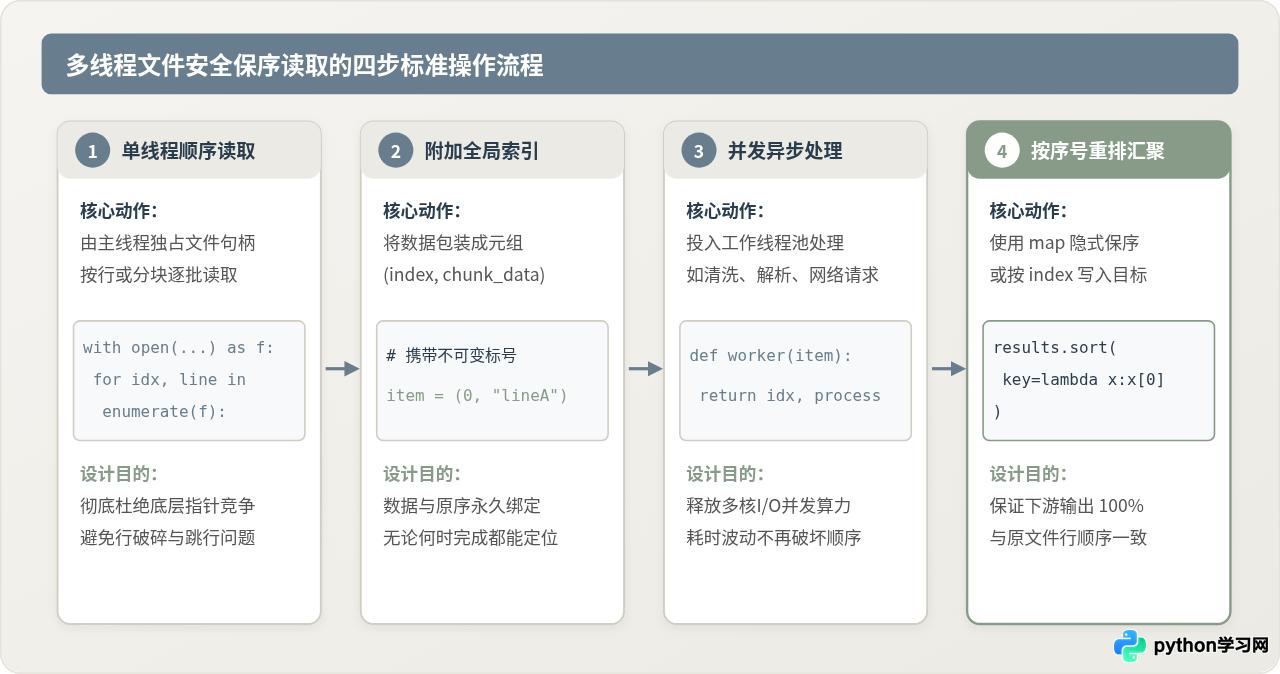
要彻底根治这一问题,行之有效的工程原则是单线程顺序读,多线程并发算,序号伴随全程,出口对齐还原。具体实施可遵循以下标准化步骤:
- 主线程安全分片:由主线程单独打开文件,通过流式生成器逐行或逐块扫描,绝不让子线程接触共享的文件指针。
- 附加全局不可变序号:借助
enumerate将每一项包装成(index, data)元组。序号作为逻辑排位凭据,在并发网络请求、复杂正则解析等耗时运算中始终与数据捆绑。 - 分发至工作线程池:将打包好的任务提交给
concurrent.futures.ThreadPoolExecutor进行并行处理。工作函数接收并透传该序号。 - 汇聚端保序重构:在主线程收集结果时,采用内置保序接口(如
executor.map)或利用序号在内存中快速索引回填,恢复原始物理顺序。
三、方案一:使用 ThreadPoolExecutor.map() 隐式保持顺序
如果后续任务的处理耗时相对平稳,推荐优先使用 Python 标准库 concurrent.futures 中的 ThreadPoolExecutor.map()。该方法在接口语义上严格模拟内置的 map(),内部虽然并发调度各个工作线程,但其返回的生成器在被迭代时,会强制按照输入参数的原始排列顺序依次产出结果。
这种做法的最大优点是代码极为精炼,无需开发者手动维护排序逻辑。以下是标准示例:
from concurrent.futures import ThreadPoolExecutor
import time

def process_line(line_tuple):
    idx, content = line_tuple
    # 模拟耗时差异(例如针对特定行产生不同时延)
    time.sleep(0.05 if idx % 2 == 0 else 0.01)
    return f"Line[{idx}]: {content.strip().upper()}"

def read_and_process_ordered(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        # 单线程流式生成 (index, line) 元组
        indexed_items = enumerate(f)

        with ThreadPoolExecutor(max_workers=4) as executor:
            # executor.map 内部严格维持入参顺序
            for result in executor.map(process_line, indexed_items):
                print(result)
当通过 executor.map 迭代结果时,如果第 0 个任务的处理耗时显著慢于后续任务,主线程循环会在提取第 0 项时发生阻塞,即使第 1 到 100 项已经全部算完也无法提前返回。对于耗时严重不均的场景,需谨慎权衡该特征。
四、方案二:基于 as_completed 与显式索引重排
当任务的耗时极度离散(例如包含重试机制、网络调用失败等),或者需要实时展示总体进度条、支持中间任务落盘时,使用 submit() 配合 as_completed() 是更具弹性的选择。
在这种模式下,任何一个任务只要完成,主线程就能立刻解除等待并拿到返回对象。只要我们在工作函数返回的结构中保留全局 index,就能在最终通过简单索引定位或者快速排序,轻而易举地还原正确次序:
from concurrent.futures import ThreadPoolExecutor, as_completed
import time

def worker_task(idx, text):
    # 任务执行耗时不均
    time.sleep(0.08 if idx == 1 else 0.02)
    processed_text = text.strip()[::-1]  # 示例处理:字符串反转
    return idx, processed_text

def run_with_as_completed(file_path):
    futures = []
    with open(file_path, "r", encoding="utf-8") as f:
        with ThreadPoolExecutor(max_workers=4) as executor:
            for idx, line in enumerate(f):
                futures.append(executor.submit(worker_task, idx, line))

            # 方式 1:利用预分配大小的数组直接根据索引填入结果(O(1)定位)
            ordered_results = [None] * len(futures)

            for future in as_completed(futures):
                item_idx, data = future.result()
                ordered_results[item_idx] = data
                # 此处可立即更新总体进度百分比

    return ordered_results
在已知任务总数时,预先分配空列表 [None] * total_count 并在结果返回时执行 ordered_results[item_idx] = data,省去了最后的列表全量排序,时间复杂度仅为 O(1),是非常高效的实战技巧。
五、关键差异对比:隐式保序 vs 显式重排的权衡
为了在实际项目中作出合理的选型,我们可以将 ThreadPoolExecutor.map() 与 as_completed + 索引重排 置于相同业务基准下对比其关键差异:
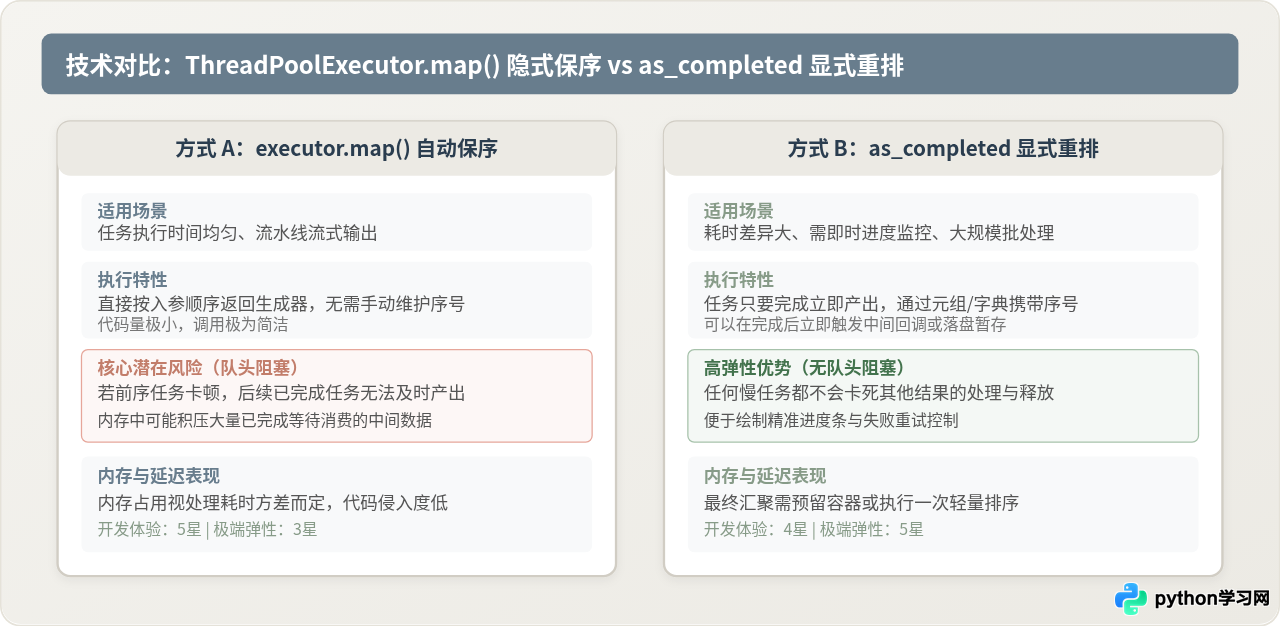
| 评估维度 | 方案一:executor.map() | 方案二:as_completed + 索引重排 |
|---|---|---|
| API复杂度 | 极简,类似内置 map 函数,无需管理 Future 对象。 | 适中,需要保存 Future 列表并手动迭代 result。 |
| 顺序保证形式 | 隐式保序,生成器按输入顺序逐步 yield。 | 显式重排,依赖元组序号与预分配容器对齐。 |
| 长尾任务影响 | 存在队头阻塞,首个慢任务卡死下游消费。 | 无队头阻塞,快任务即刻交由主线程释放或统计。 |
| 进度监控与异常捕获 | 难以直接计算剩余百分比,某项抛异常时在迭代到该项才抛出。 | 可即时统计已完成数量(如配合 tqdm),异常可针对性重试。 |
| 适用场景 | 处理逻辑轻量稳定、希望代码最少、直接流式消费。 | 各块处理耗时差异大、数据量大需要精准进度与错误容灾。 |
从对比可以看出,两者的差异本质上是“开发便捷度”与“运行期调度灵活性”的平衡。如果任务每个块耗时差不多,map 是最佳解;而如果任务耗时离散度高,as_completed 结合索引能大幅优化系统的实际吞吐体验。
六、完整可运行验证程序
下面提供一段包含文件模拟生成、两种并发模式验证及校验断言的完整可执行 Python 脚本,读者可直接运行验证数据顺序是否完全一致:
import os
import time
import random
from concurrent.futures import ThreadPoolExecutor, as_completed

def setup_sample_file(filename, line_count=10):
    with open(filename, "w", encoding="utf-8") as f:
        for i in range(line_count):
            f.write(f"record_payload_row_{i}\n")

def transform_worker(item):
    idx, raw_text = item
    # 注入随机耗时模拟真实波动
    time.sleep(random.uniform(0.01, 0.05))
    clean_text = raw_text.strip()
    return idx, f"PROCESSED({clean_text})"

def main():
    test_file = "data_test.txt"
    setup_sample_file(test_file, 12)

    try:
        # 1. 验证 map 模式
        with open(test_file, "r", encoding="utf-8") as f:
            inputs = list(enumerate(f))

        with ThreadPoolExecutor(max_workers=4) as pool:
            map_results = list(pool.map(transform_worker, inputs))

        map_indices = [idx for idx, val in map_results]
        print("[验证 1] executor.map 提取顺序:", map_indices)
        assert map_indices == list(range(12)), "map 模式顺序校验失败!"

        # 2. 验证 as_completed + 索引数组模式
        ordered_store = [None] * len(inputs)
        with ThreadPoolExecutor(max_workers=4) as pool:
            futures = [pool.submit(transform_worker, item) for item in inputs]
            for fut in as_completed(futures):
                idx, val = fut.result()
                ordered_store[idx] = (idx, val)

        ac_indices = [idx for idx, val in ordered_store]
        print("[验证 2] as_completed 重排后顺序:", ac_indices)
        assert ac_indices == list(range(12)), "as_completed 模式重排校验失败!"

        print("恭喜:两种保序模式全部校验通过,数据顺序与原文件 100% 一致!")
    finally:
        if os.path.exists(test_file):
            os.remove(test_file)

if __name__ == "__main__":
    main()
七、常见误区与避坑指南
在落地多线程处理文件时,除了乱序以外,还有以下三个极易被忽视的技术细节:
- 误区一:盲目加大线程数引发磁盘 I/O 抖动:如果单行处理逻辑不涉及外部网络请求或密集解码,性能瓶颈通常在磁盘物理 I/O 上。此时盲目将
max_workers提高到几十上百,不仅不会提速,反倒由于多线程竞争 GIL 及引发操作系统频繁上下文切换造成性能倒退。对于本地纯文件读取,建议线程数控制在 4 ~ 8 之间。 - 误区二:一次性将海量数据
list(f)装入内存:当处理数十吉字节(GB)的日志文件时,绝不能直接执行inputs = list(enumerate(f)),这会导致内存耗尽崩盘(OOM)。正确做法是编写一个批量生成器(Chunk Generator),每次仅读取并打包 1000 行,分批提交给线程池处理与写入。 - 误区三:忽略子线程异常导致死等:在使用
executor.map时,若某个任务抛出未捕获的异常,当生成器迭代到该项时会立即抛出并中断遍历;而若是自定义字典重排未做异常保护,可能导致目标数组中部分槽位始终为None。建议在worker内部显式包裹try...except,将异常作为返回值的一部分携带,交由主线程统一记录。
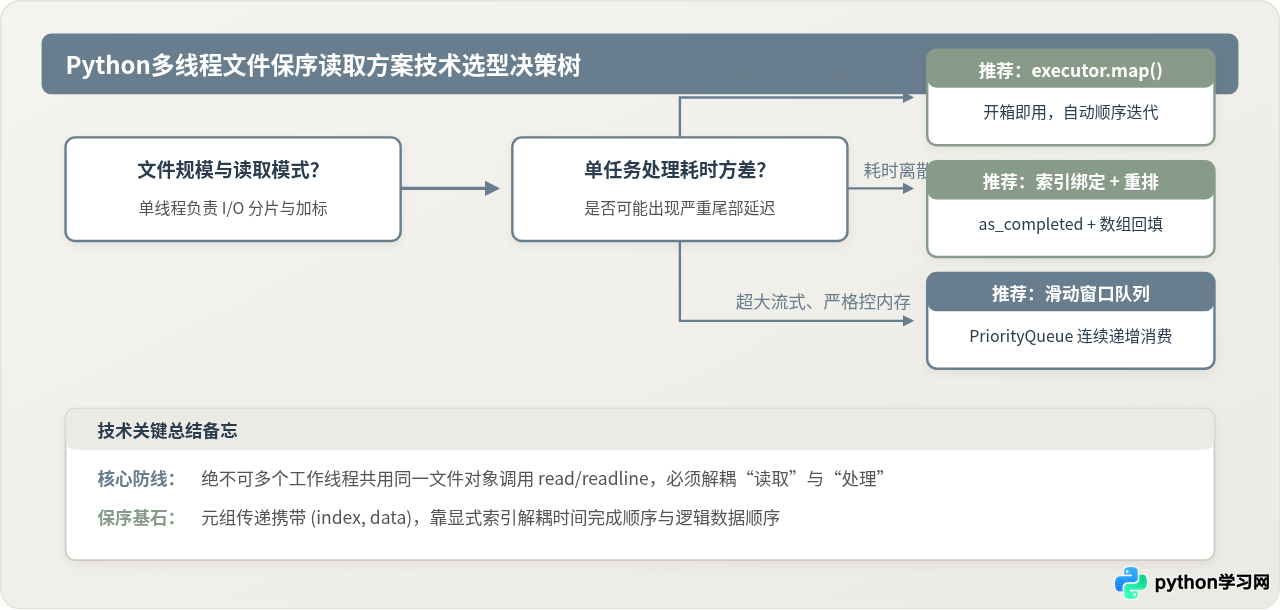
八、总结与选型指南
解决 Python 多线程读取文件乱序问题的关键,从不是在底层去强行同步多线程的时间节拍,而是通过显式的数据序号标识,将“时间层面的完成先后”与“空间层面的逻辑顺序”彻底解耦。
在工程选型中,请牢记这一简单结论:对于日常平稳的批处理或文本解析,优先选用 ThreadPoolExecutor.map(),享受简洁带来的高维护性;对于任务耗时长短不一、需要流式进度显示与精细异常恢复的大型场景,选用 as_completed 搭配预分配索引数组。遵循这两套模式,即可在享用多线程并发加速的同时,确保输出数据的次序万无一失。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















