


Python爬虫解析复杂HTML:XPath与CSS Selector高级用法
本文介绍在Windows环境下使用Python的lxml库解析HTML。通过对比XPath和CSS Selector,详解如何利用属性、层级关系精准定位嵌套复杂的DOM节点,并演示如何在选定容器内提取文本与链接,处理相对路径及缺失字段的情况。
解析复杂 HTML 时,核心难点往往不在于代码本身,而在于理清节点间的层级关系并选择稳定的定位条件。XPath 擅长沿节点树的关系进行查找和属性提取,而 CSS Selector 写法更为紧凑,适合按标签、类名及层级快速筛选。下面以 Windows 环境中的 Python 和 lxml 库为例,通过一段本地 HTML 代码,演示这两种方法在实际解析中的应用。
概述:先找到重复的内容单元
在开始编写选择器之前,先观察 HTML 结构。示例中,main 标签下包含两张 article.card 卡片,每张卡片内部都有标题和链接。解析的最佳实践是先选中这些重复的“卡片”作为独立单元,然后在每个单元内部提取具体字段。这样可以确保标题与对应的链接始终保持一致,避免数据错位。
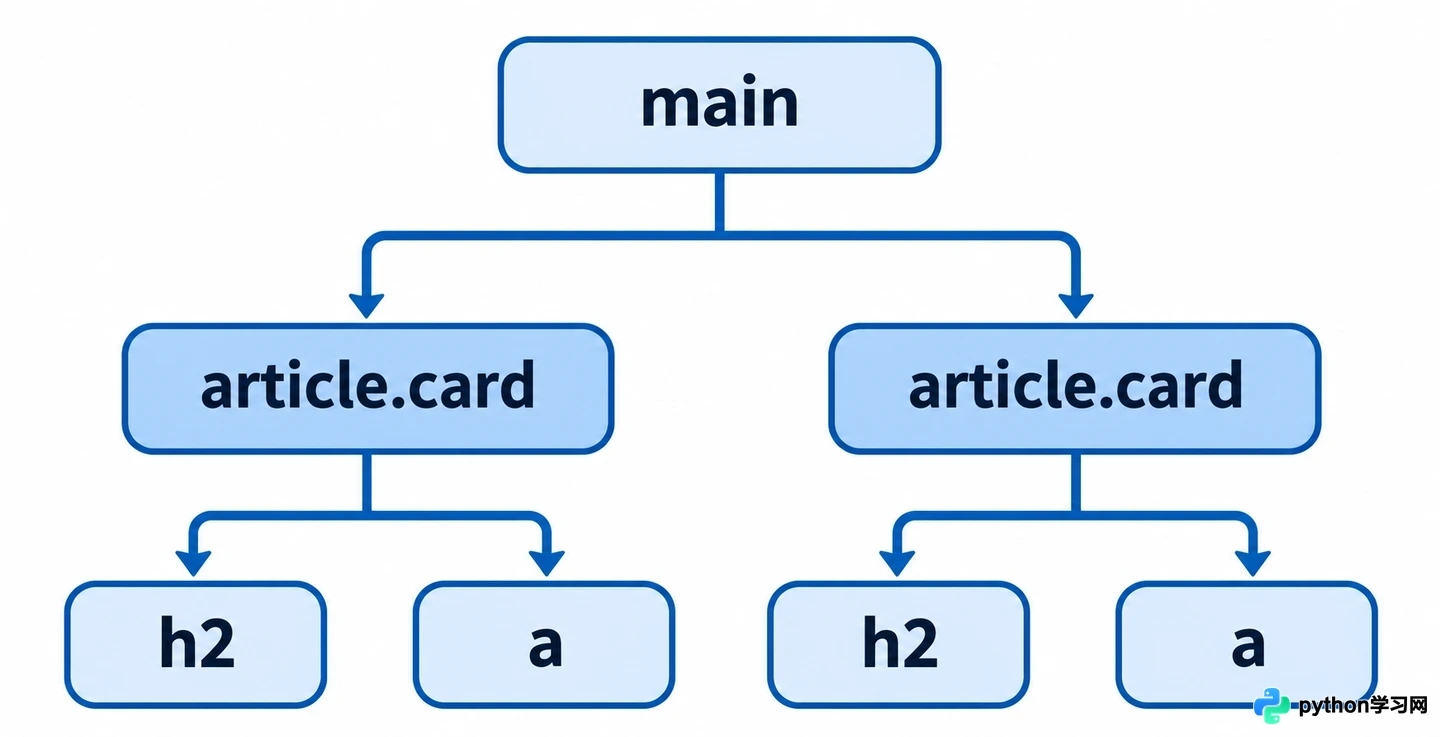
示例 HTML 的节点层级
在 Windows 终端中,首先安装必要的依赖库:
py -m pip install lxml cssselect
将以下代码保存为 parse_demo.py。为了便于专注练习选择器语法,这里直接解析字符串。在实际爬取网页时,需先确认获取到的是目标页面的完整 HTML,并严格遵守网站的 robots.txt 规则。
from lxml import html
from urllib.parse import urljoin

source = """<main>
  <article class="card featured" data-kind="guide">
    <h2>XPath 入门</h2><a href="/xpath">阅读</a>
  </article>
  <article class="card" data-kind="news">
    <h2>CSS 选择器</h2><a href="/css">阅读</a>
  </article>
</main>"""
root = html.fromstring(source)
执行后,root 即为解析后的元素树对象。需要注意的是,CSS 中的 article.card 表示同时具有 article 标签和 card 类的元素,其中的点号是类选择器的标志,并非 HTML 标签名的一部分。
XPath:按属性和层级筛选
XPath 使用路径表达式在 XML 或 HTML 文档中选取节点。// 表示在当前上下文中查找所有后代节点,/ 表示直接子级,而方括号 [] 则用于添加筛选条件。
例如,要查找特定属性的文章:
cards = root.xpath('//article[@data-kind="guide"]')
titles = root.xpath('//article[@data-kind="guide"]/h2')
在处理类属性时需格外小心。HTML 元素的 class 属性可能包含多个由空格分隔的类名(如 class="card featured")。如果直接使用 @class="card" 进行匹配,将会漏掉这类元素。推荐使用 XPath 1.0 的标准写法,通过空格边界来精确匹配完整的类名:
cards = root.xpath(
    '//article[contains(concat(" ", normalize-space(@class), " "), " card ")]'
)
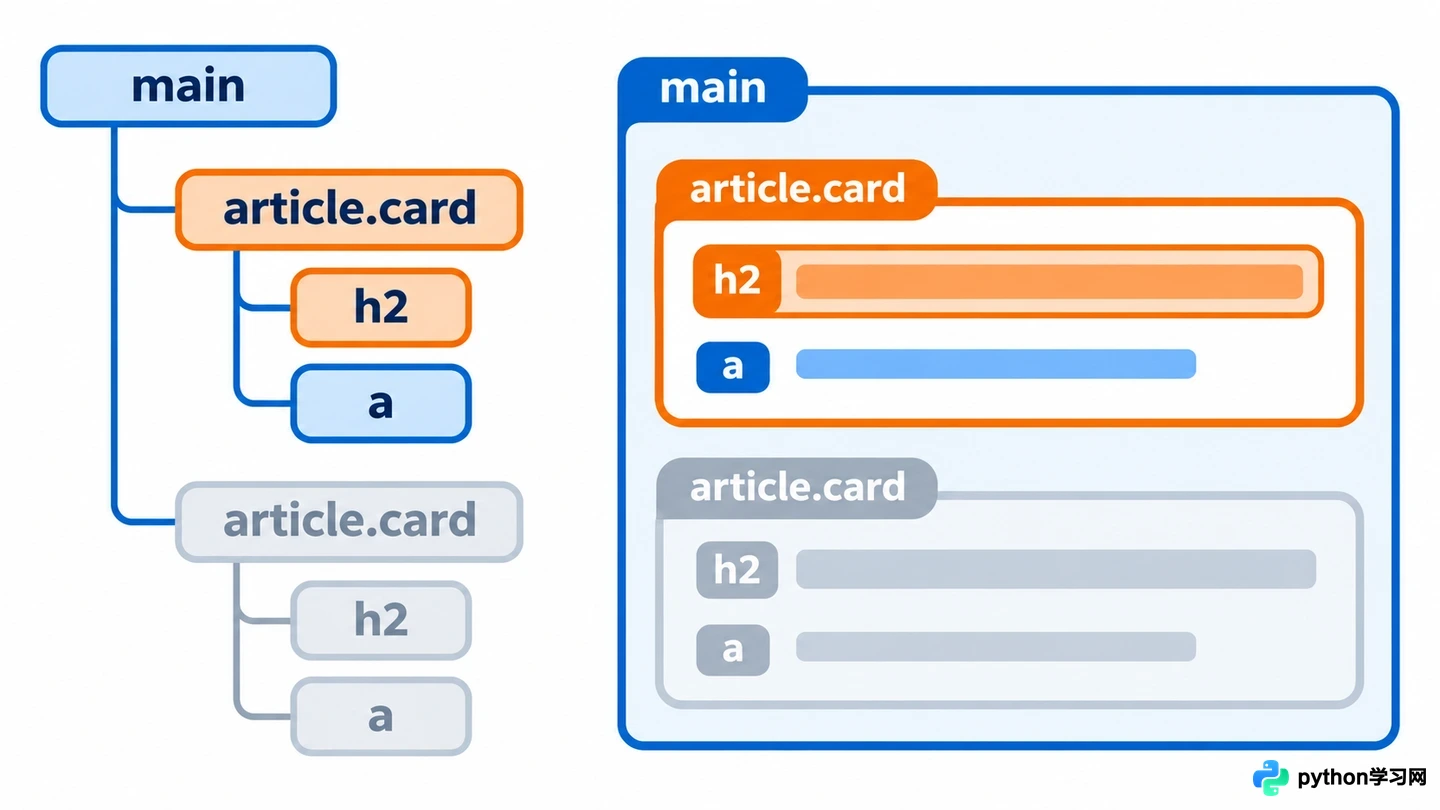
卡片节点及其标题的层级关系
XPath 返回的结果是一个列表。在访问具体元素前,务必确认列表非空。此外,需注意 XPath 索引从 1 开始。(//article)[1] 选取的是整个结果集中的第一个 article,而 //article[1] 的含义则是选取每个父节点下的第一个 article 子元素,两者语义不同,不应混用。
当需要在已选中的卡片内部继续查找时,应使用 .// 开头。这表示从当前节点向下查找,避免程序无意间再次搜索整棵文档树,从而提高效率并防止误选:
first = cards[0]
heading = first.xpath('.//h2')
if heading:
    print(heading[0].text_content().strip())
CSS Selector:组合类、属性和关系
对于同一棵元素树,CSS 选择器通常能更简洁地表达相同的筛选逻辑。lxml 结合 cssselect 库提供了强大的 CSS 选择支持:
cards = root.cssselect('main > article.card')
featured = root.cssselect('article.card.featured')
guides = root.cssselect('article.card[data-kind="guide"]')
在 CSS 选择器中,空格表示后代关系,> 表示直接子元素关系。多个类名连写(如 .card.featured)表示元素必须同时具备这些类。[data-kind="guide"] 则用于匹配指定属性值的元素。
需要注意的是,lxml 的 CSS 选择器支持范围取决于安装的 cssselect 版本,并非所有现代浏览器支持的选择器都能直接使用。对于复杂的表达式,建议在实际运行环境中进行验证。
在每张卡片内提取文本与链接
实际数据采集通常需要先遍历容器,再分别提取内部字段。以下代码演示了如何使用 CSS 定位元素,读取文本内容,并将相对链接转换为绝对地址:
base_url = 'https://example.com/'  # 示例基地址,使用时替换为实际页面地址
for card in root.cssselect('main > article.card'):
    headings = card.cssselect('h2')
    links = card.cssselect('a[href]')

    # 安全获取文本,处理可能为空的情况
    title = headings[0].text_content().strip() if headings else ''
    href = links[0].get('href') if links else None

    # 转换相对链接为绝对链接
    url = urljoin(base_url, href) if href else ''
    print(title, url)
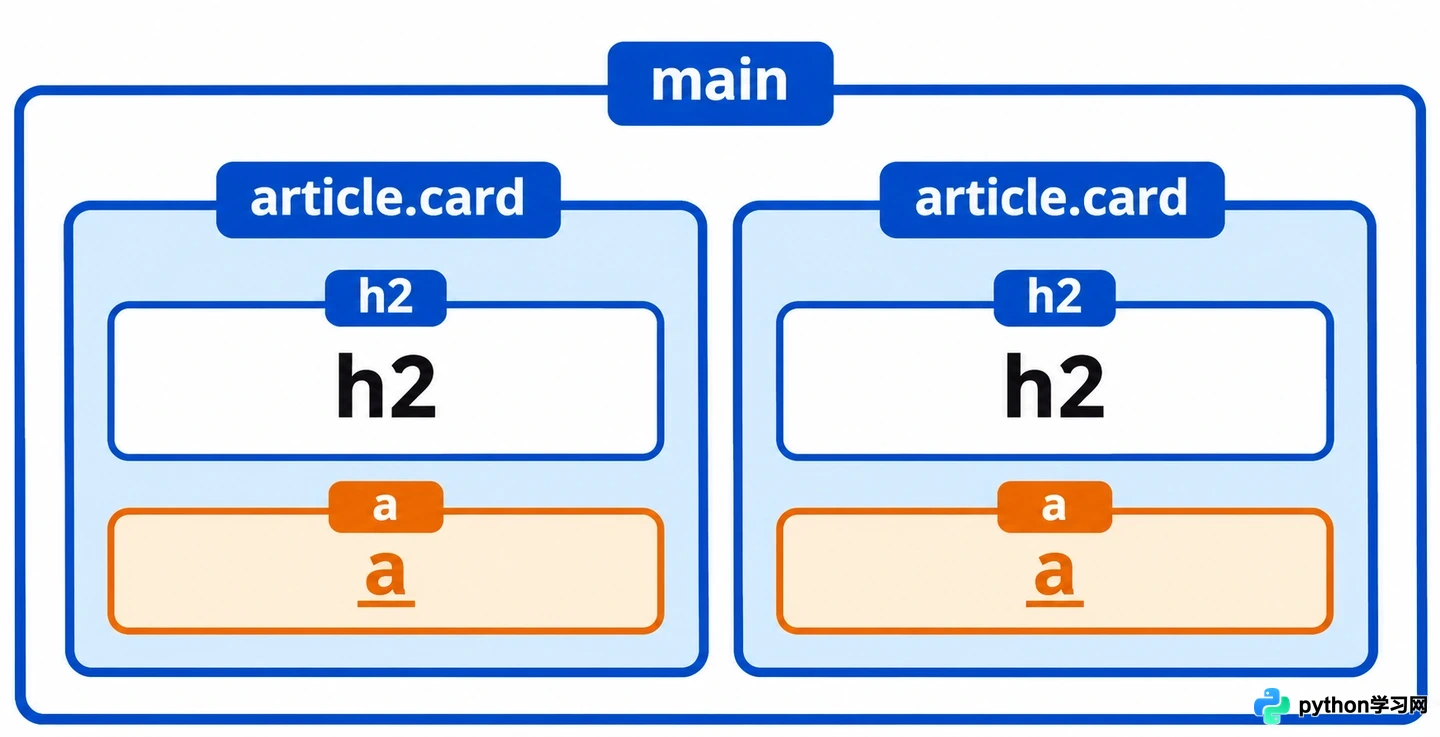
在各卡片内分别定位标题和链接
text_content() 方法会返回元素及其所有子元素的文本内容,strip() 仅去除两端的空白字符。如果文本中间存在多余的空格或换行,需要另行进行规范化处理。此外,代码中加入了空列表检查,因为实际页面中并非每条记录都拥有完整的字段,直接假设字段存在会导致程序报错。
选择器与实际页面的边界
浏览器开发者工具中的元素树是调试选择器的有力辅助,但需注意,浏览器在执行 JavaScript 后生成的 DOM 节点,不一定存在于直接下载的原始 HTML 中。如果选择器返回结果为空,应首先对比原始 HTML 源码与目标节点,检查类名变化、层级差异或命名空间问题。
在 XPath 中,可以使用变量传入需要比较的值,避免将不可信的字符串直接拼接到表达式中,从而提升安全性:
matches = root.xpath('//article[@data-kind=$kind]', kind='guide')
面对结构频繁变化的页面,优先选择语义明确且相对稳定的容器和属性作为锚点。同时,始终为字段缺失保留清晰的处理逻辑。记住,选择器找到的只是解析树中的节点,最终数据的准确性仍需结合来源页面进行核对。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















