


Python中r模式与rb模式打开文件有什么区别
深入解析Python中open()函数使用r模式(文本模式)与rb模式(二进制模式)的核心区别,涵盖数据返回类型、字符编解码机制、通用换行符折叠原理、PNG图片损坏实测及工程选型最佳实践。
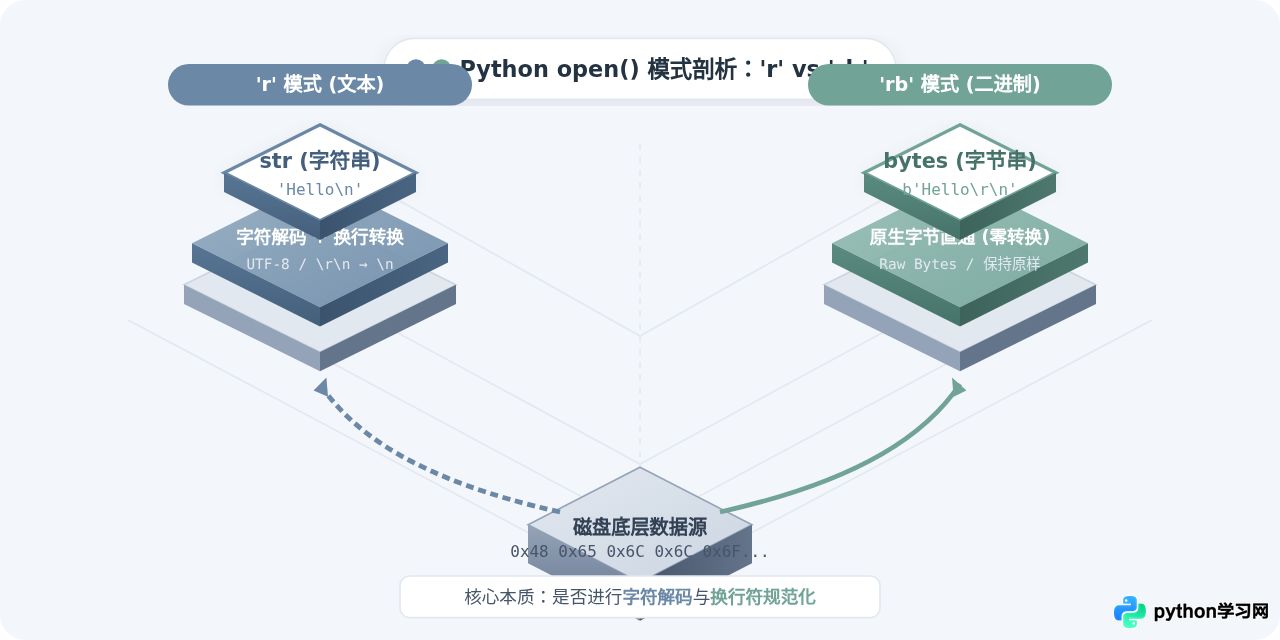
open() 打开文件时,'r'(文本读取模式)与 'rb'(二进制读取模式)的核心区别在于:'r' 模式将磁盘中的物理字节按照指定字符编码(如 UTF-8)自动解码为 Python 字符串对象(str),并在读取过程中统一转换换行符;而 'rb' 模式则原样透传磁盘中的物理字节,以原生字节串(bytes)的形式交付,既不进行字符解码,也不改动任何换行符。
一、底层机制对比:数据类型与解码流程
在操作系统的底层,磁盘上存储的任何文件本质上都只是一长串由 0 和 1 构成的原始字节流。区分文本还是二进制,是应用程序层面的逻辑抽象。Python 的 open() 函数通过模式参数决定了如何构建底层 I/O 流包装管道。
当指定为 'r' 模式时,Python 会在底层的原始文件句柄之上包装一层 io.TextIOWrapper。这个包装器承担两个核心任务:第一,根据指定的字符编码(如 UTF-8、GBK),查表将多字节序列翻译为 Python 的 Unicode 代码点;第二,开启通用换行符模式(Universal Newlines),将不同操作系统所使用的换行标志进行标准化。读取完成后,调用者拿到的直接是可读的 str 字符串类型。
而在 'rb' 模式下,Python 仅在底层句柄外保留缓冲层 io.BufferedReader,完全跳过 io.TextIOWrapper。底层磁盘读出什么字节,内存中就保留什么字节,直接输出为不可变的 bytes 对象。因此,在 'rb' 模式下传入 encoding 参数属于逻辑矛盾,Python 解释器会直接抛出 ValueError: binary mode doesn't take an encoding argument。
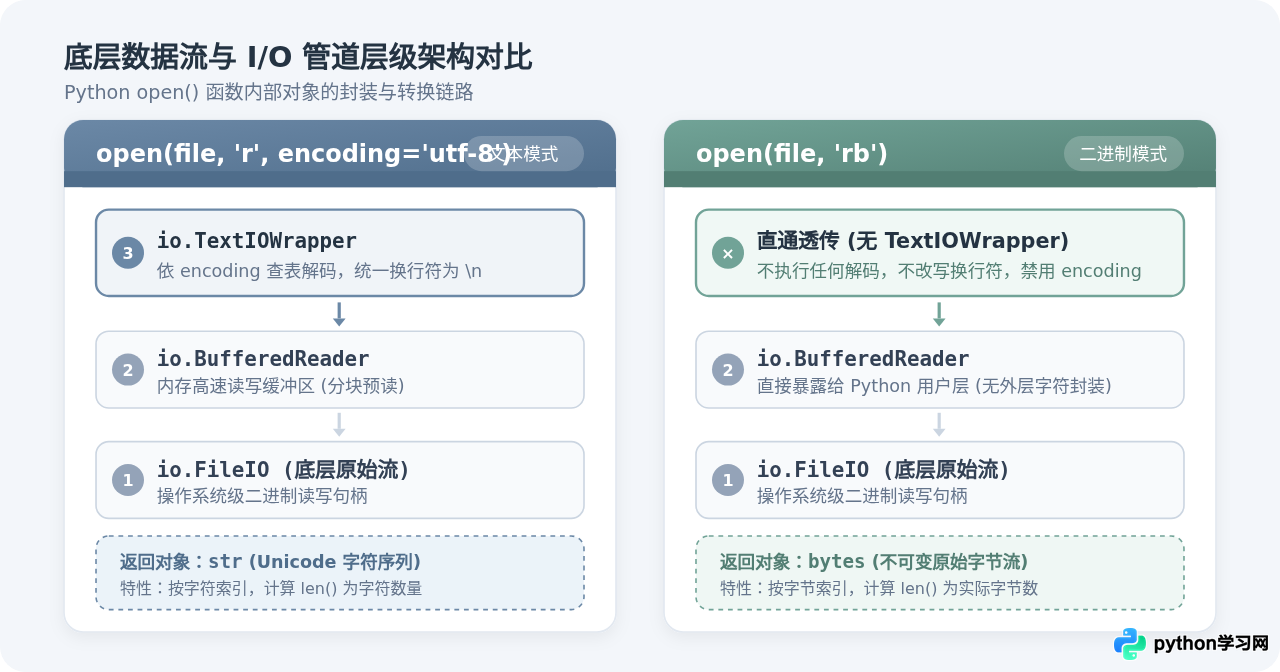
下表总结了两种模式在语言运行时层面的关键技术属性差异:
| 对比维度 | 'r' 模式 (文本读取) | 'rb' 模式 (二进制读取) |
|---|---|---|
| 返回对象类型 | str (Unicode 字符串) |
bytes (只读字节序列) |
| 编解码处理 | 必须解码(依据指定编码或系统默认编码) | 完全不解码(直接输出原始物理字节) |
| 换行符转换 | 自动将
或 折叠为
|
保持原样(0x0D 和 0x0A 分立保留) |
| 参数约束 | 支持 encoding, errors, newline |
传入 encoding 会直接报 ValueError |
长度计算 len() |
返回字符数量(如 len("中国") == 2) |
返回字节数量(如 len(b'ä¸...') == 6) |
| 典型适用文件 | .txt, .json, .csv, .py, .md, .html |
.png, .jpg, .mp3, .zip, .bin, .pkl |
二、深层细节:换行符转换机制与非文本损坏分析
许多初学者容易产生疑问:既然 'r' 和 'rb' 都能把数据读进内存,为什么绝对不能用 'r' 模式去读一张图片或一个压缩包?
这背后有两个极为关键的底层原因:非法字符解码失败与换行符误伤。
1. 通用换行符转换(Universal Newlines)
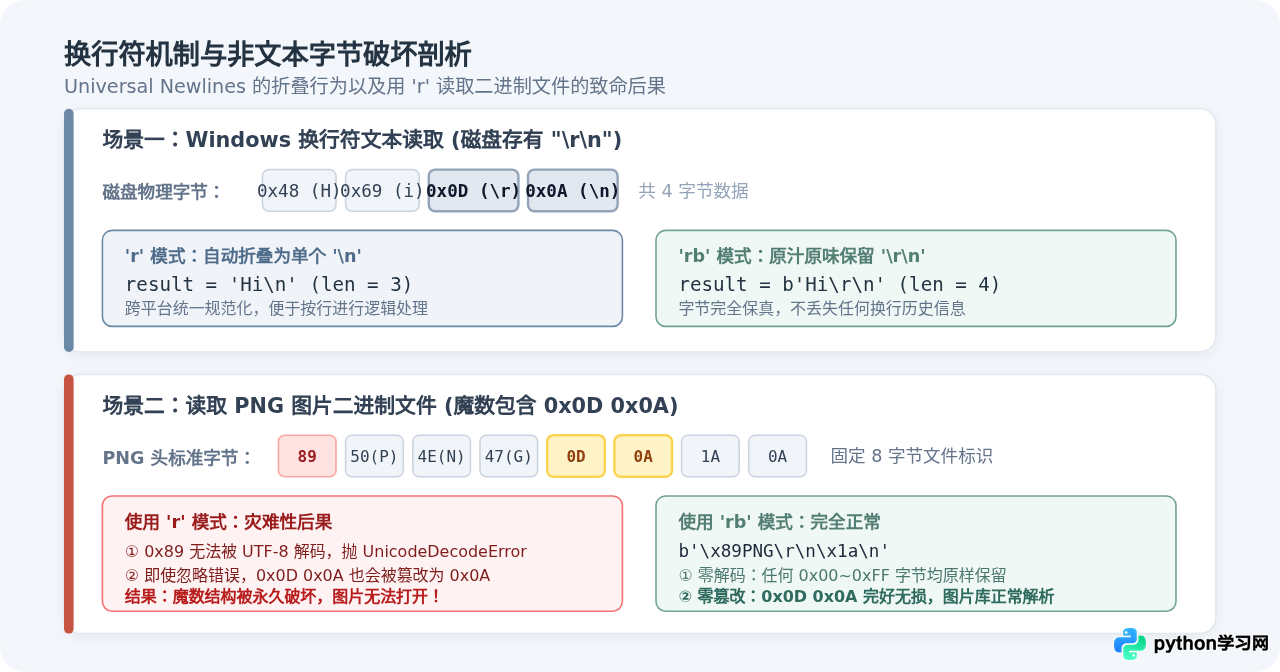
在历史发展中,不同的操作系统定义了不同的文本换行约定:Windows 使用两字节的 CRLF(回车换行,十六进制为 0x0D 0x0A),Unix/Linux/macOS 使用单字节的 LF(换行,十六进制为 0x0A),而旧时代的 Mac OS 则使用 CR(十六进制为 0x0D)。
为了让跨平台文本处理更加一致,Python 的 'r' 模式默认启用 Universal Newlines 机制。不论源文件在磁盘上是用
还是 换行,读取到 Python 内存字符串中时,都会被静默统一替换为单个
。这种便利在纯文本处理中非常有用,但在二进制数据中却是灾难性的。
2. 非文本文件的损坏过程
在二进制文件(如 PNG 图片)中,字节组合纯粹由文件格式规范决定。以 PNG 图片为例,其文件头前 8 个字节是严格规定的文件签名(魔数):
89 50 4E 47 0D 0A 1A 0A注意其中的第 5 和第 6 个字节正好是 0x0D 0x0A。如果错误地使用 'r' 模式打开:
- 首先,UTF-8 字符解码器在遇到首字节
0x89时,会发现它不是合法的 UTF-8 起始字节,随即直接抛出UnicodeDecodeError,程序立即中断崩溃。 - 即便使用
errors="ignore"强行跳过解码报错,Universal Newlines 机制也会误认为中间的0x0D 0x0A是换行标记,进而将其合并替换为单一的0x0A。这样一来,原本 8 字节的文件头缩减成了 7 字节,文件内部的数据索引完全错位,整个图片文件彻底报废。
三、实操指南:模式选择步骤与代码实践
在实际编码中,按照清晰的四步流程可以快速确定打开模式并写出安全可靠的代码。
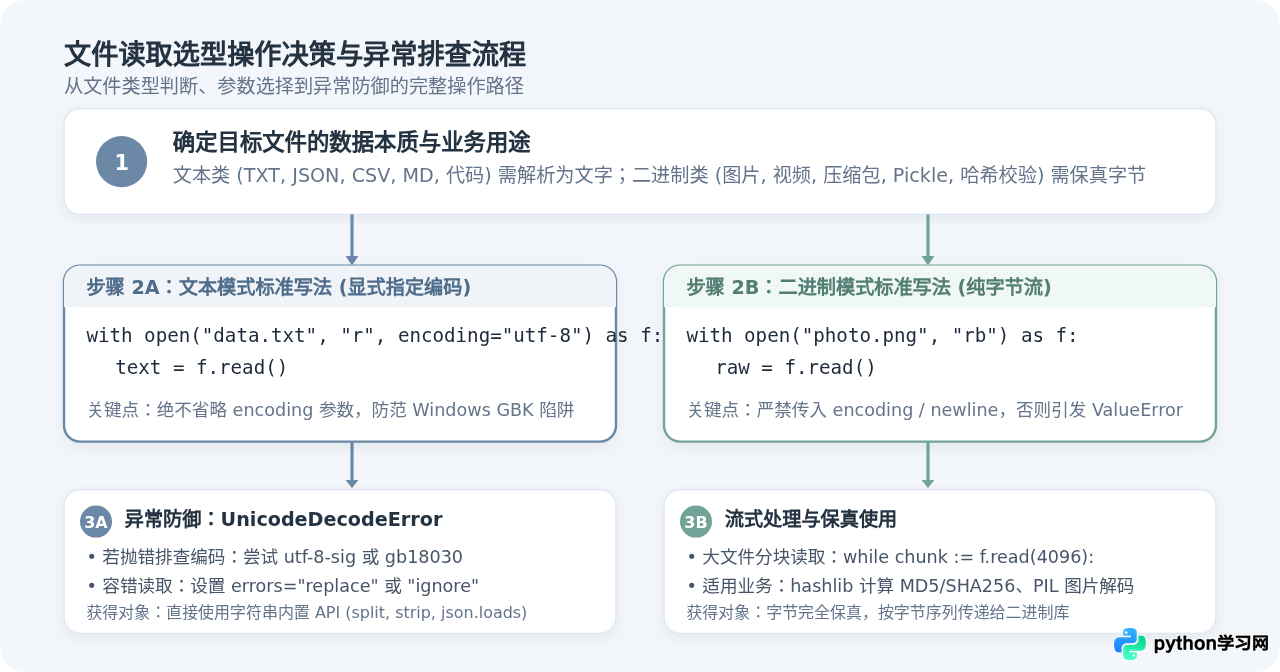
第一步:明确数据本质与处理目的
在敲击键盘前,首先明确要处理的内容是给人类阅读的文字,还是给机器直接加载的二进制流。如果是 JSON 配置、日志、Markdown 等,走文本路径;如果是多媒体、打包归档、通信数据包,走二进制路径。
第二步:规范书写读取代码
文本模式的标准写法:必须显式指定 encoding="utf-8"。在 Windows 系统上,若不指定 encoding,Python 会回退采用系统当前的 ANSI 代码页(通常是 GBK)。这会导致同一份 UTF-8 文件在 Linux 上运行正常,而在 Windows 上直接引发解码报错。
# 规范写法:显式指定 encoding
with open("config.json", mode="r", encoding="utf-8") as f:
    text_data = f.read()

# 示例输出:类型为 str,可直接使用字符串方法
print(type(text_data))  # <class 'str'>
print(text_data.startswith("{")) # True二进制模式的标准写法:不带任何编码参数。对于大文件,推荐采用固定大小的缓冲区进行流式分块读取,避免一次性吃满内存:
import hashlib

# 规范写法:分块读取大文件并计算哈希值
hasher = hashlib.sha256()

with open("package.zip", mode="rb") as f:
    while chunk := f.read(65536):  # 每次读取 64KB
        hasher.update(chunk)

# 示例输出:获得稳定一致的十六进制摘要
print("SHA256:", hasher.hexdigest())
第三步:异常排查与防御性编写
在开发过程中,最常见的与模式相关的报错有两个:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x...:表明以'r'模式读取了非 UTF-8 编码的文件(可能是 GB18030、带 BOM 的 UTF-8,或者误读了二进制文件)。如果是文本文件,应核对文件真实编码;如果确实无法获知编码,可先用'rb'读取原始字节,再借助第三方探测库判定。ValueError: binary mode doesn't take an encoding argument:表明在'rb'模式下错误传递了encoding='utf-8'或newline=''参数,直接移除多余参数即可恢复正常。
四、核心差异速查与开发实践建议
为了帮助读者在不同业务场景中快速抉择,下图归纳了四种典型高频开发场景的最佳实践方案:
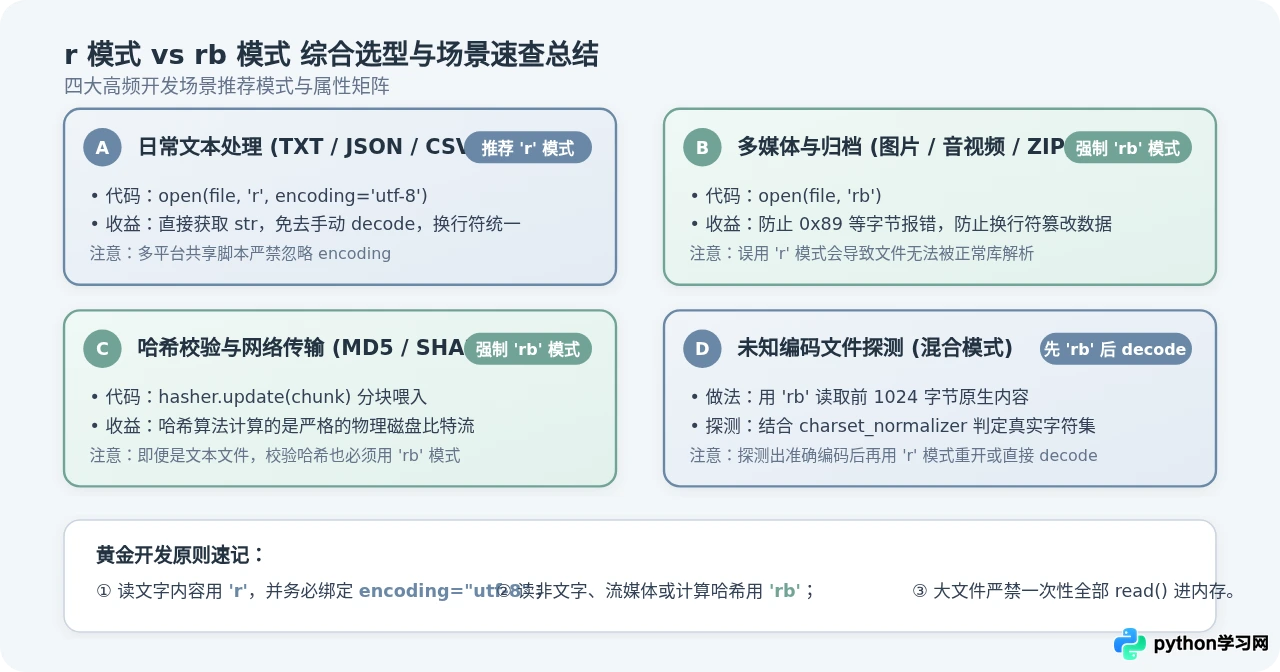
- 日常读写纯文本(TXT、JSON、CSV、YAML):使用
'r'模式,并且必须显式写明encoding="utf-8"。 - 计算文件哈希校验(MD5、SHA256):必须使用
'rb'模式。哈希算法校验的是磁盘底层的物理字节,即使是纯文本文件,如果使用'r'模式,换行符折叠会导致计算出的哈希值与原始物理文件不符。 - 网络下载存储与多媒体处理(图片、音视频、PDF、ZIP):必须使用
'rb'模式,确保字节全保真。 - 未知编码文本嗅探:先以
'rb'模式读取前 1024 个字节交给charset_normalizer判定,确认编码后再进行正确的解码处理。
'r' 模式严格指定 encoding,还是在需要精确控制字节流时果断选择 'rb',都是编写健壮 Python 代码的基本功。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















