


Python开发中何时使用函数,何时使用类?
深入解析在Python开发中选择函数还是类的核心标准与实践指南。通过具体的业务场景、代码对比、决策流程与反模式剖析,帮助开发者编写清晰、简洁且符合Pythonic原则的程序。
一、架构选型的核心判断步骤
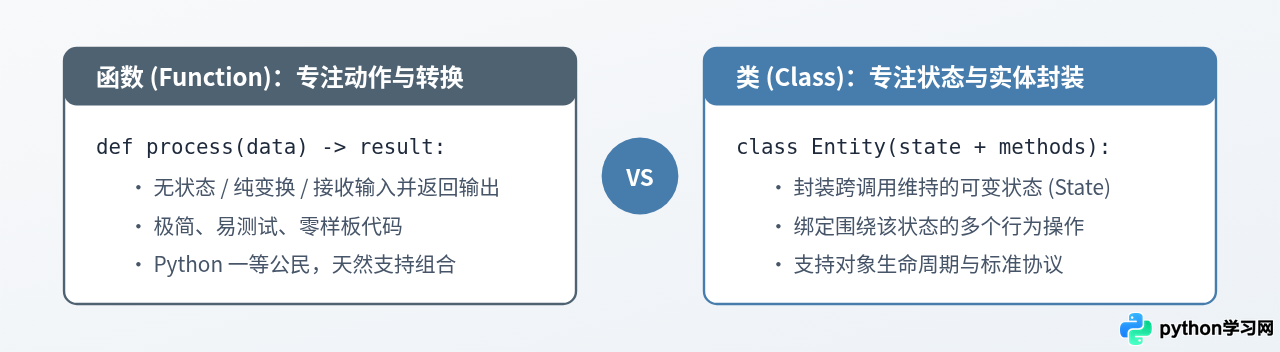
很多初学者甚至从 Java、C++ 转入 Python 的开发者,往往习惯于把所有逻辑都套进类(Class)中,导致代码中充斥着大量只有 __init__ 和一个 run() 方法的“空心类”。Python 是一门多范式编程语言,函数不仅是一等公民,更是构建程序的基础构件。
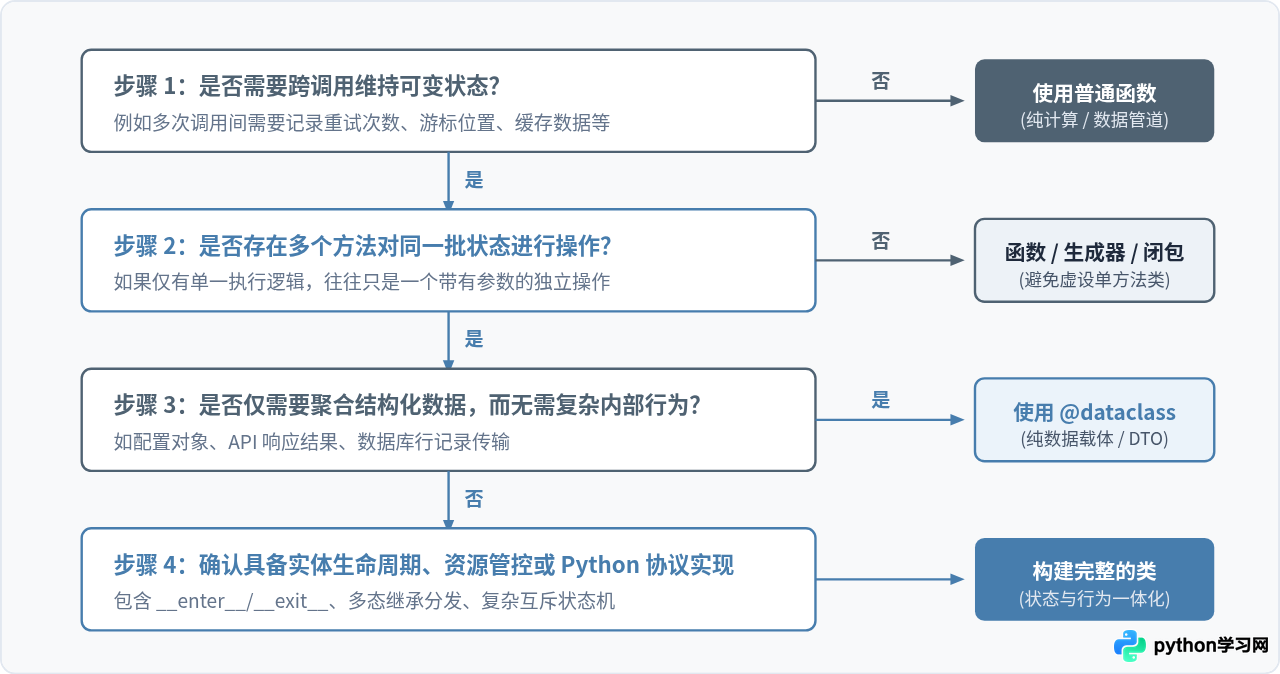
在决定是否要写一个 class 之前,可以按照以下四个标准步骤进行逐层排查:
二、优先使用函数的典型场景
当一段代码的功能可以概括为一个明确的“动词”时,它绝大多数情况下应该被实现为一个函数。函数具有天然的输入输出边界,无隐藏的共享状态,不仅排查问题极其直观,也更利于并发与组合。
1. 确定性的数据转换(纯函数与无状态逻辑)
如果一个操作接收参数,经过处理后返回新数据,且不产生任何外部可见的副作用(例如修改全局变量、更新类属性),纯函数是唯一推荐的形式。数学计算、字符串清洗、格式解析与数据过滤皆属于此类。
import re

def clean_phone_number(raw_phone: str) -> str:
    """提取纯数字并验证标准11位手机号码格式。"""
    digits = re.sub(r"\D", "", raw_phone)
    if len(digits) == 11 and digits.startswith("1"):
        return digits
    raise ValueError(f"无效的手机号码格式: {raw_phone}")

# 测试调用
phone = clean_phone_number(" +86 138-0013-8000 ")
print(f"清洗结果: {phone}")对于上述清洗逻辑,如果定义一个 PhoneNumberCleaner 类,并在 __init__ 中存入原始字符串,再调用 .clean() 方法,除了凭空增加实例化开销和阅读负担之外,没有任何架构收益。
2. 一次性业务流程与操作管道
针对批处理、脚本任务或顺序执行的业务流水线,通常由顶层函数组合多个底层函数即可实现。各函数之间通过参数传递数据,逻辑清晰透明。
from typing import List, Dict

def filter_active_users(users: List[Dict]) -> List[Dict]:
    return [u for u in users if u.get("is_active", False)]

def calculate_total_balance(users: List[Dict]) -> float:
    return sum(float(u.get("balance", 0.0)) for u in users)

def generate_financial_summary(raw_users: List[Dict]) -> Dict:
    active_users = filter_active_users(raw_users)
    total = calculate_total_balance(active_users)
    return {
        "active_count": len(active_users),
        "total_balance": round(total, 2)
    }
3. 高阶函数与逻辑组合
在 Python 中,函数可以作为参数传递、可以作为返回值,也可以动态嵌套。当需要修改或增强已有逻辑时,使用装饰器函数通常比使用继承或复杂的面向对象模板方法更轻巧易读。
三、核心原理:无状态数据流与状态封装对比
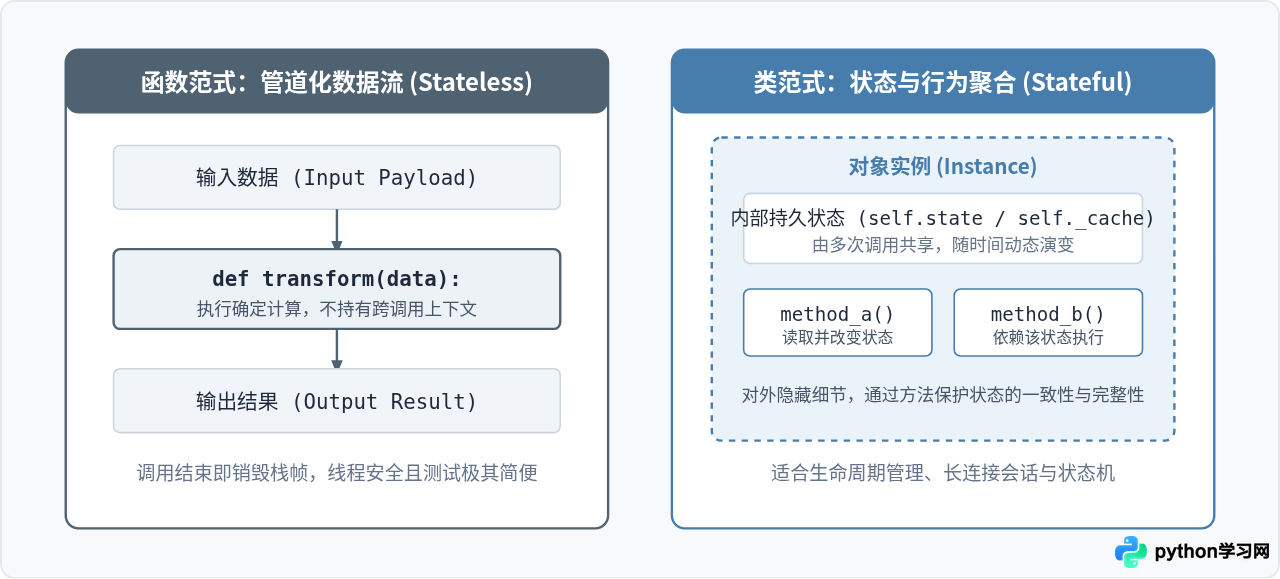
函数与类的本质差异,反映在内存模型和数据流动方式上。函数把数据作为参数引入,执行完毕后释放局部帧;类则在堆内存中维护一个持久的实例字典(__dict__),多个方法共享并持续修改这块内存区域。
四、必须或强烈推荐使用类的场景
类并非冗余的产物,当面对真正的状态演化、资源隔离与协议契约时,面向对象提供了其他结构难以替代的组织力。
1. 管理长期状态与实体生命周期
最典型的例子是外部资源客户端(如 HTTP 会话、数据库连接池、带缓冲的写入器)。这类实体需要维持连接句柄、追踪活跃请求数、并在结束时安全释放。
import time

class RateLimiter:
    """令牌桶限流器:通过类内部状态维持多次请求之间的时间戳与额度。"""

    def __init__(self, capacity: int, refill_rate_per_sec: float):
        self.capacity = capacity
        self.refill_rate = refill_rate_per_sec
        self.tokens = float(capacity)
        self.last_update = time.monotonic()

    def allow_request(self, tokens_needed: int = 1) -> bool:
        now = time.monotonic()
        elapsed = now - self.last_update
        self.last_update = now

        # 恢复令牌,但不超过容量上限
        self.tokens = min(self.capacity, self.tokens + elapsed * self.refill_rate)

        if self.tokens >= tokens_needed:
            self.tokens -= tokens_needed
            return True
        return False

# 测试实例:限制每秒最多补充 2 个令牌
limiter = RateLimiter(capacity=5, refill_rate_per_sec=2.0)
print(f"首次请求允许状态: {limiter.allow_request(3)}")
print(f"紧接着消耗3个令牌: {limiter.allow_request(3)}")首次请求允许状态: True
紧接着消耗3个令牌: False
在此场景中,tokens 和 last_update 必须在调用之间保持连续性。如果试图用函数实现,就必须依赖 global 变量或闭包,不仅破坏了封装性,也无法在一个进程内同时创建两个互相独立的限流器。
2. 实现 Python 数据模型协议(Magic Methods)
Python 的优雅很大程度上建立在“魔术方法”(Special Methods)之上。如果希望自定义对象能够原生支持 with 语句、len() 运算、for ... in 迭代或切片访问,构建类是标准且唯一的途径。
class ManagedTransaction:
    """利用 __enter__ 和 __exit__ 实现精准的事务生命周期管控。"""
    def __init__(self, tx_name: str):
        self.tx_name = tx_name

    def __enter__(self):
        print(f"[{self.tx_name}] 开启事务并获取锁")
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        if exc_type is not None:
            print(f"[{self.tx_name}] 捕获异常: {exc_val},执行事务回滚")
            return False  # 向外传播异常
        print(f"[{self.tx_name}] 事务顺利提交并释放锁")
        return True
3. 多态分发与可插拔策略
当系统支持多种平行的业务策略(例如不同支付通道、不同报表导出格式),且各策略拥有统一的接口规范时,通过抽象基类或鸭子类型实现多态是极佳的方案。
五、常见“类滥用”反模式与重构指南
许多团队的代码库之所以难以维护,并非因为类太少,而是因为存在大量“虚假的类”。Python 核心开发者 Jack Diederich 曾在著名演讲《Stop Writing Classes》中专门剖析这一现象。
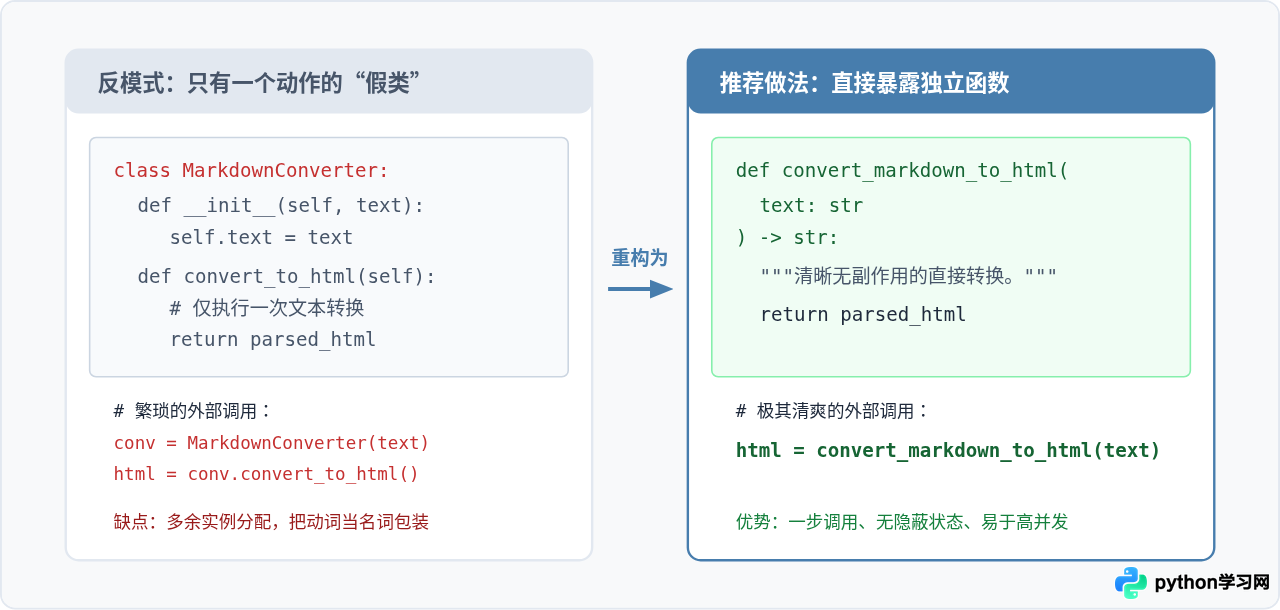
反模式排查清单
-
“两方法类”综合征:如果一个类仅包含
__init__和一个实际工作方法(如execute()、run()、process()),这通常是滥用类的红灯信号。直接将该方法重构成函数。 -
将类充当“命名空间”(Namespace Class):从其他语言转过来的开发者常喜欢写
StringUtils或MathHelpers这种全是@staticmethod的类。在 Python 中,模块(即单个.py文件)本身就是天然的命名空间。直接在utils/strings.py里写顶级函数,外部通过from utils import strings; strings.clean()引入才是正统用法。 -
参数过多反模式(何时该从函数升级):反向极端同样存在——如果一个函数需要接收 7、8 个参数,或者多个函数之间频繁将同一个元组、字典作为参数反复传递,这意味着你的系统中已经萌发了“业务实体”。此时不应急着写普通类,而是优先使用
@dataclass。
如果定义一个类的初衷只是为了让字典更有结构、拥有类型提示和属性自动补全,而没有复杂的内部校验方法,请使用标准库的 dataclasses.dataclass。它会自动生成 __init__、__repr__ 和 __eq__,免去手写样板代码的麻烦。
六、选型决策维度与综合对比
在工程实践中,代码组织往往不是非黑即白的二选一,而是函数、数据容器与行为类协同工作。以下图表汇总了不同代码组织形式的关键选型维度:
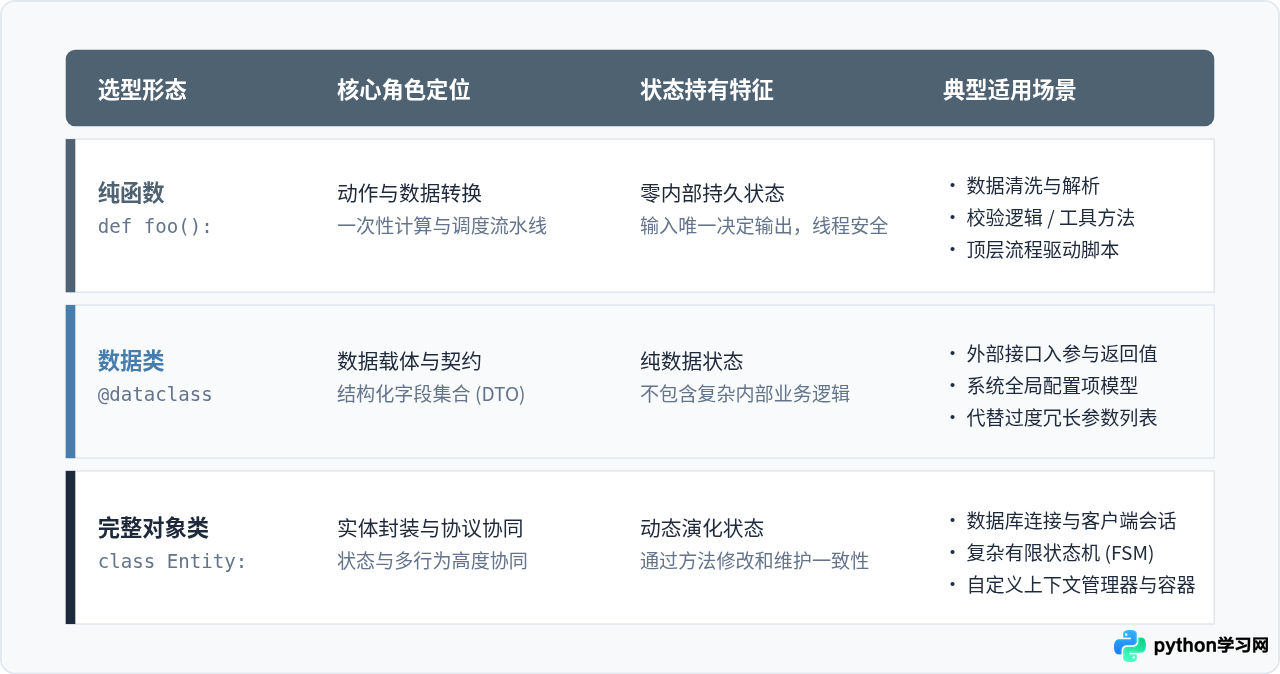
七、总结:何时用函数,何时用类?
要在日常编码中做出自然、地道的 Pythonic 决策,记住这三条简短法则:
- 优先以函数起步:在需求尚不确定时,从简单的独立函数开始。只要它能通过入参和返回值完成任务,就维持函数的形态。函数没有初始化开销,组合起来最灵活。
- 发现多函数共享同一组可变数据时,提炼为类:当你在多个函数间不断传递相同的 3 个以上参数,且这些参数在调用过程中会发生变动时,说明数据与行为已经产生内在绑定,这是将它们重构为一个类的时刻。
- 切勿把类当成动词的包装纸:如果写出的类只有一个方法,或者全部都是静态方法,请立即删掉这个类,释放出其中的函数,充分信任 Python 的模块命名空间机制。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















