


为什么列表不能作为字典的键而元组可以?详解Python哈希机制
深入解析Python中为什么列表不能作为字典的键而元组可以。从字典底层哈希表寻址原理、可哈希对象判定标准、嵌套可变元组的特例,到实际开发中的转换方案与自定义类哈希实现,提供完整代码示例与图文详解。
在 Python 中,字典(dict)通过哈希表实现快速查找,要求所有键(Key)都必须是“可哈希对象”(Hashable Object),即对象在整个生命周期内的哈希值固定不变。列表(list)由于允许增删改元素,若作为字典键并在存入后被修改,会导致哈希值变化、字典无法再次定位该键;而元组(tuple)本身不可修改,只要其内部不包含可变元素,就能提供稳定的哈希值。本文将拆解字典底层的哈希寻址过程、可哈希性的判定条件、包含可变元素的元组特例,以及如何把列表安全转换为字典键。
一、直接原因:列表与元组在哈希接口上的差异
当我们尝试把列表作为字典的键时,Python 解释器会立即抛出 TypeError: unhashable type: 'list';而将相同元素的元组作为键则能正常读写。这并非语法上的强行限制,而是取决于对象内部是否实现了有效的 __hash__ 方法。
在 Python 3.x 交互式终端或脚本中执行以下代码,可以直接观察两者的行为差异:
代码示例:验证元组与列表作为字典键的行为(Python 3.x)# 1. 使用元组表示坐标键:正常执行
grid_map = {}
coord_tuple = (10, 20)
grid_map[coord_tuple] = "起点仓库"
print("元组键读取结果:", grid_map[(10, 20)])
print("元组哈希值:", hash(coord_tuple))
# 2. 查看列表的 __hash__ 属性并尝试作为字典键
coord_list = [10, 20]
print("列表的 __hash__ 属性:", coord_list.__hash__)
grid_map[coord_list] = "起点仓库"元组键读取结果: 起点仓库
元组哈希值: -3550055125485641917
列表的 __hash__ 属性: None
Traceback (most recent call last):
File "demo_hash.py", line 11, in <module>
grid_map[coord_list] = "起点仓库"
TypeError: unhashable type: 'list'从输出可以看到,coord_list.__hash__ 的值为 None。Python 官方数据模型规定:内置的可变容器(如 list、dict、set)会将自身的 __hash__ 属性显式设为 None。当字典调用内置函数 hash(key) 计算键的位置时,一旦发现 __hash__ is None,就会直接拒绝并抛出 unhashable type 报错。
二、底层原理:字典如何通过哈希值定位数据
为什么要禁止可变对象计算哈希值?这要从 Python 字典的底层存储结构说起。字典之所以能在 $O(1)$ 的平均时间复杂度内完成查找,是因为它并不是按顺序挨个比对键,而是把键转换成一个整数(哈希值),再用这个整数直接换算出内存槽位(Bucket / Slot)的索引下标。
不管是向字典写入键值(d[k] = v)还是从字典读取值(d[k]),Python 都会按固定步骤寻址:
- 计算哈希值:调用
hash(k)得到一个固定位宽的整数。 - 映射槽位索引:将哈希值与当前哈希表长度掩码做按位与运算(如
index = hash(k) & mask),定位到具体的槽位编号。 - 核对键的相等性:检查该槽位存放的键是否与目标键相等(先比对内存地址或哈希值,再调用
k1 == k2即__eq__方法确认),防止不同对象撞上同一个槽位(哈希冲突)。
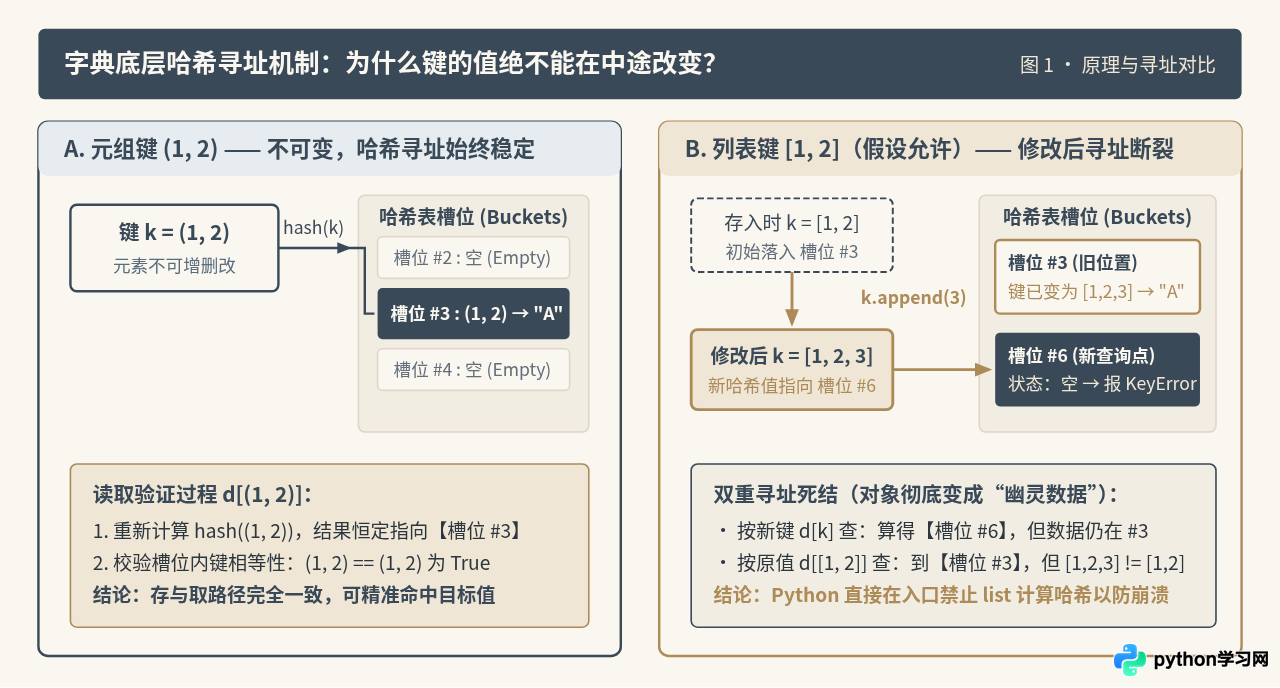
假设 Python 允许列表作为字典的键,并且按照列表当前的元素内容计算哈希值,就会立刻引发“数据丢失”的逻辑灾难:
- 存入阶段:创建列表
k = [1, 2],假设其哈希值映射到了槽位 #3,字典把k的引用和对应的值存入槽位 #3。 - 原地修改阶段:后续代码执行了
k.append(3),列表内容变成了[1, 2, 3]。因为是原地修改,槽位 #3 里保存的键对象同步变成了[1, 2, 3]。 - 查找失败阶段:此时无论你用
d[k](按新内容算出槽位 #6,但槽位 #6 是空的),还是用d[[1, 2]](虽然找到了槽位 #3,但在核对[1, 2, 3] == [1, 2]时返回False),都再也取不出原先存入的数据。
三、Python 判定对象“可哈希(Hashable)”的三条硬性标准
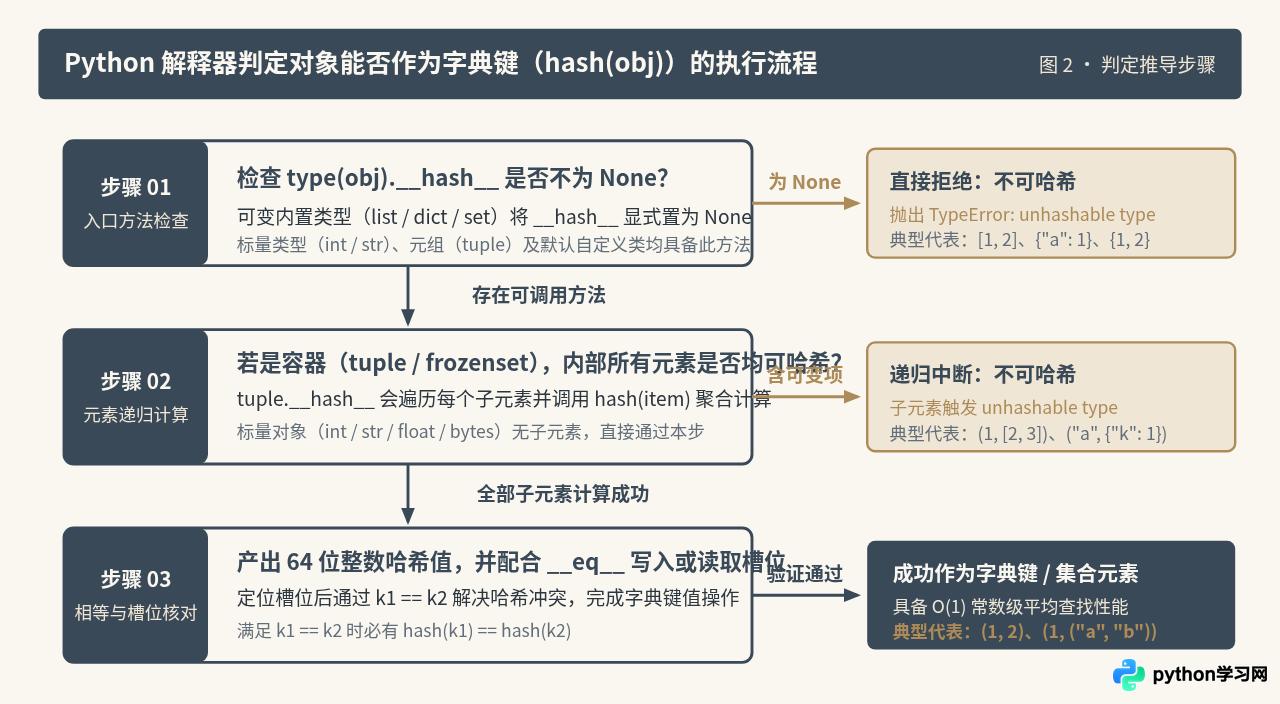
很多初学者会把“不可变(Immutable)”与“可哈希(Hashable)”直接画等号,但实际上“不可变”只是内置容器满足“可哈希”的手段。根据 Python 官方文档对 Hashable 的定义,一个对象能够作为字典的键(或集合 set 的元素),必须同时满足以下三条标准:
- 实现
__hash__()方法并返回一个整数:且该对象在生命周期内的哈希值永远不能改变。 - 实现
__eq__()方法用于相等性比较:因为不同对象的哈希值可能相同(哈希冲突),字典必须能通过a == b判断两个键是否为同一个逻辑键。 - 满足等价一致性铁律:如果两个对象比较相等(即
a == b为True),那么它们的哈希值必须完全相同(即hash(a) == hash(b))。
1、1.0 和 True 在字典里会被当成同一个键?这正是第三条标准的直接体现。在 Python 中,
1 == 1.0 == True 的结果为 True,因此它们的哈希值也全部被设计为 1(hash(1) == hash(1.0) == hash(True) == 1)。当你依次执行 d = {1: "整数"}; d[1.0] = "浮点数"; d[True] = "布尔值" 后,字典里只会保留一个键 1,其值被覆盖为 "布尔值"。
当我们面对任意一个 Python 对象,想要判断它能否放入字典作为键时,可以沿着解释器内部的检查路径一步步推导:
四、关键例外:为什么有些元组也不能作为字典的键?
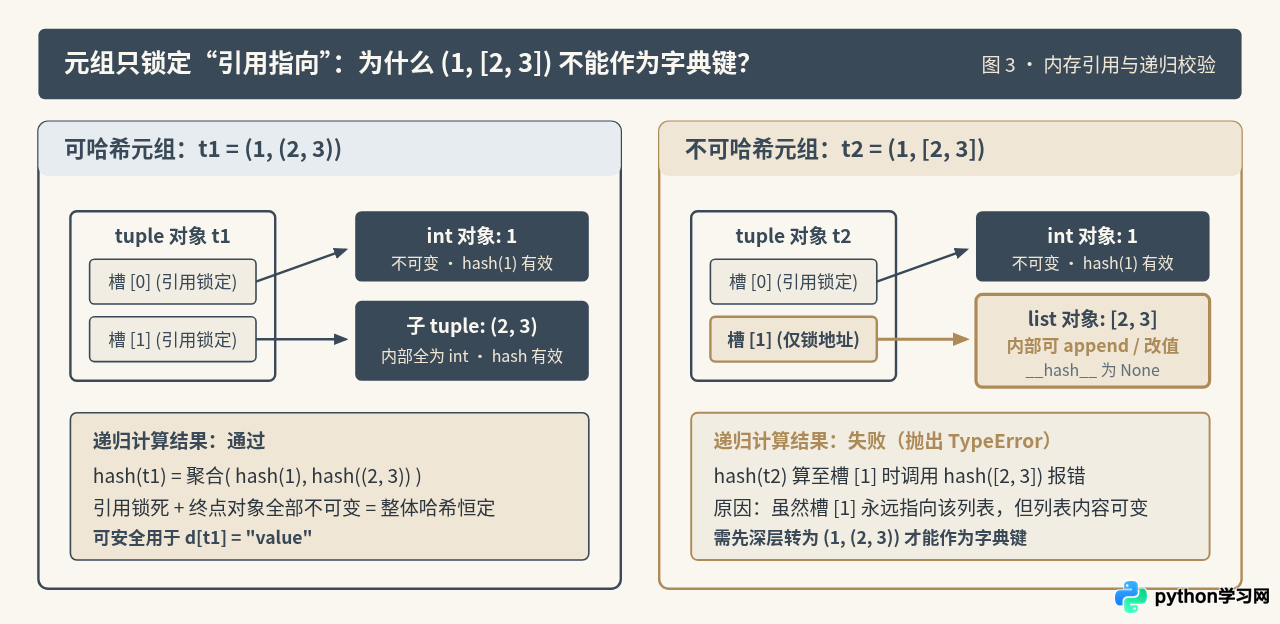
理解了图 2 中的“步骤 02(元素递归计算)”后,就能解释一个非常高频的易错点:并非所有元组都能作为字典的键。如果一个元组内部嵌套了列表、字典或集合等可变对象,那么这个元组同样无法作为字典的键。
原因在于,元组的“不可变”是指元组每个位置上存放的对象引用(内存地址指向)不可变,但元组无法阻止你去修改某个引用所指向的可变对象本身。而且元组计算自身哈希值的算法(在 CPython 3.8+ 中基于 xxHash 变体实现)需要依次取出内部每一个元素的哈希值进行混合运算:
代码示例:纯不可变元组与嵌套列表的元组对比(Python 3.x)# 情况 A:嵌套元组的元组,所有层级均为不可变对象
pure_tuple = (1, ("a", "b"))
print("纯不可变元组哈希值:", hash(pure_tuple))
# 情况 B:元组内部包含一个列表
nested_tuple = (1, [2, 3])
# 虽然不能给 nested_tuple[1] 重新赋值,但可以原地修改其中的列表:
nested_tuple[1].append(4)
print("修改内部列表后的元组:", nested_tuple)
# 尝试将该元组作为字典键
cache = {}
cache[nested_tuple] = "测试数据"纯不可变元组哈希值: -4169842371460895122
修改内部列表后的元组: (1, [2, 3, 4])
Traceback (most recent call last):
File "tuple_trap.py", line 13, in <module>
cache[nested_tuple] = "测试数据"
TypeError: unhashable type: 'list'注意看报错信息的最后一行:虽然我们传给字典的键是元组 nested_tuple,但报错提示的依然是 unhashable type: 'list'。这正是因为元组本身的 __hash__ 方法顺利启动了,但在遍历到第 2 个元素 [2, 3, 4] 并对其调用 hash() 时被列表拦截报错。
五、实用解决方法:如何把列表数据用作字典的键?
在实际开发中,我们经常需要把一组复合数据(比如网格坐标 [x, y]、多维筛选条件、分词后的词组列表)作为字典的键来做缓存或分组统计。根据数据的特点,有三种标准转换方案:
方案 1:一维列表直接用 tuple() 转换(保留顺序与重复项)
如果列表中的元素本身都是整数、字符串等基本不可变类型,且元素的先后顺序有意义(例如坐标 [10, 20] 与 [20, 10] 代表不同位置),直接使用内置的 tuple(my_list) 是开销最小、最直观的做法。
方案 2:无序去重列表用 frozenset() 转换(忽略顺序)
如果列表代表一组不区分先后顺序的标签(例如用户的权限组合 ["read", "write"] 和 ["write", "read"] 应当映射到同一个字典项),可以先将其转换为不可变集合 frozenset(my_list)。frozenset 和元组一样实现了稳定的 __hash__ 方法。
方案 3:多层嵌套列表使用递归函数转为嵌套元组
如果遇到像二维矩阵、多层配置列表(如 [[1, 2], [3, 4]]),仅在最外层调用一次 tuple() 只会得到 ([1, 2], [3, 4]),内部依然是列表。此时可以编写一个简短的递归转换函数,将所有层级的列表、集合一并冻结:
def to_hashable(obj):
    """递归将任意嵌套的 list / set / dict 转换为可哈希的不可变结构"""
    if isinstance(obj, (list, tuple)):
        return tuple(to_hashable(item) for item in obj)
    if isinstance(obj, set):
        return frozenset(to_hashable(item) for item in obj)
    if isinstance(obj, dict):
        # 将字典按键排序后转为 (key, value) 元组序列
        return tuple(sorted((k, to_hashable(v)) for k, v in obj.items()))
    return obj

# 场景 1:一维列表转元组(顺序敏感)
route = ["北京", "上海", "广州"]
route_prices = {tuple(route): 1280}
print("航线价格:", route_prices[("北京", "上海", "广州")])

# 场景 2:标签列表转 frozenset(顺序无关)
role_cache = {}
role_cache[frozenset(["editor", "reviewer"])] = "高级内容组"
# 颠倒顺序依然能命中同一个键
print("权限组查询:", role_cache[frozenset(["reviewer", "editor"])])

# 场景 3:多层嵌套结构转可哈希元组
matrix_block = [[1, 2], [3, 4]]
block_key = to_hashable(matrix_block)
matrix_dict = {block_key: "左上角分块"}
print("转换后的键结构:", block_key)
print("嵌套结构查询:", matrix_dict[((1, 2), (3, 4))])航线价格: 1280
权限组查询: 高级内容组
转换后的键结构: ((1, 2), (3, 4))
嵌套结构查询: 左上角分块六、进阶延伸:为什么自定义的 Python 类对象默认可以做字典键?
了解列表和元组的区别后,不少开发者会遇到另一个疑惑:自己用 class User: 定义的对象,属性明明可以随时修改(比如 user.age = 30),为什么它默认却能放进字典当键?
这是因为自定义类默认继承自基类 object,而 object 默认提供的 __hash__ 和 __eq__ 是基于对象的内存身份(即 id(self))计算的,与对象内部的属性值毫无关系。只要对象在内存里的地址不变,你再怎么修改它的属性,它的哈希值也不会变,且它只和自己相等(u1 == u2 仅在两者是同一个实例时为 True)。
但是,一旦你在自定义类中重写了 __eq__ 方法(例如规定两个 Point 实例只要 x 和 y 坐标相同就算相等),Python 3 就会自动把该类的 __hash__ 设为 None,使其变得和列表一样不可哈希!原因正是为了防止你改了 __eq__ 依赖的属性,却忘了同步维护哈希一致性。如果你希望按值比较的自定义类也能作为字典键,可以采用以下两种标准做法之一:
- 做法 A(推荐):使用标准库的
@dataclass(frozen=True)装饰器,Python 会自动将实例属性设为只读,并自动生成匹配的__eq__和__hash__。 - 做法 B(手动实现):在类内部同时实现
__eq__和__hash__,并在__hash__中将参与比较的不可变属性打包成元组返回,即return hash((self.x, self.y))。
from dataclasses import dataclass

# 方式 A:使用 frozen=True 的 dataclass(自动生成安全的 __hash__ 和 __eq__)
@dataclass(frozen=True)
class GridPoint:
    x: int
    y: int

# 方式 B:普通类手动实现 __eq__ 与 __hash__(依赖元组计算哈希)
class ManualPoint:
    def __init__(self, x: int, y: int):
        self._x = x
        self._y = y

    @property
    def x(self):
        return self._x

    @property
    def y(self):
        return self._y

    def __eq__(self, other):
        if not isinstance(other, ManualPoint):
            return NotImplemented
        return (self._x, self._y) == (other._x, other._y)

    def __hash__(self):
        # 将关键属性放入元组后计算哈希
        return hash((self._x, self._y))

p1 = GridPoint(3, 5)
p2 = ManualPoint(10, 20)
board = {p1: "A点", p2: "B点"}
print("Dataclass 键查询:", board[GridPoint(3, 5)])
print("手动实现类键查询:", board[ManualPoint(10, 20)])Dataclass 键查询: A点
手动实现类键查询: B点七、总结与选型对照
回顾全文,列表不能作为字典的键而元组可以,核心原因在于字典哈希表依赖键的哈希值来计算内存槽位下标。列表允许原地修改,一旦修改就会破坏哈希值与存储槽位的对应关系;而纯不可变元组保证了哈希值终生稳定。
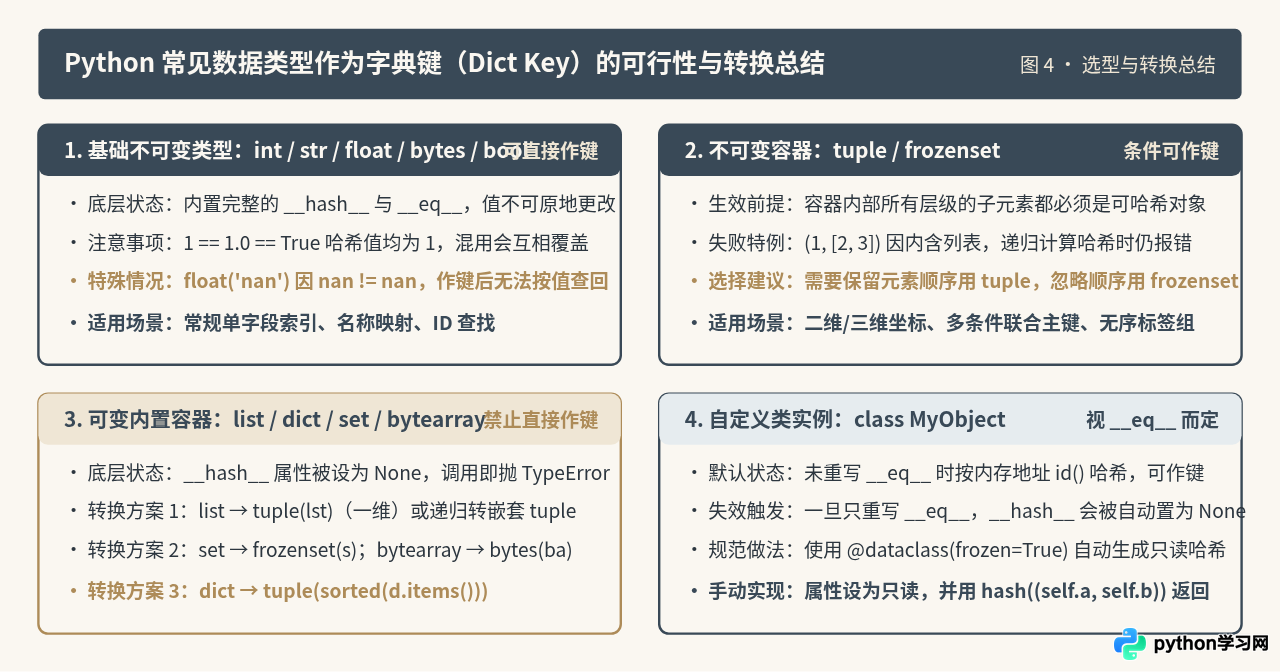
为方便日常写代码时快速查阅,下表整理了常见可变类型需要作为字典键时的直接替换写法:
| 原始数据类型 | 能否直接作为字典键 | 推荐转换写法 | 转换后特点与适用场景 |
|---|---|---|---|
一维列表 [10, 20] |
否(__hash__ is None) |
tuple(my_list) |
保留元素顺序与重复值,适合坐标、路径序列 |
无序集合 {"a", "b"} |
否(__hash__ is None) |
frozenset(my_set) |
自动去重且忽略顺序,适合标签组合、权限集合 |
嵌套列表 [[1, 2], [3, 4]] |
否(内层列表不可哈希) | tuple(tuple(x) for x in lst) |
所有层级均转为元组,适合棋盘状态、矩阵分块 |
字典 {"k1": 1, "k2": 2} |
否(__hash__ is None) |
tuple(sorted(d.items())) |
按键排序后冻结为键值对元组,适合参数缓存键 |
字节数组 bytearray(b"abc") |
否(__hash__ is None) |
bytes(my_ba) |
转为不可变的 bytes 对象,适合二进制报文摘要索引 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















