


Python异步数据库框架详解:Tortoise-ORM与SQLAlchemy 2.0异步用法
深入详解 Python 异步生态中两大主流 ORM 框架:Tortoise-ORM 与 SQLAlchemy 2.0 异步用法。从底层设计哲学(Active Record 与 Data Mapper)、初始化配置、强类型模型定义、异步 CRUD 操作、关联关系显式预加载到事务管理与选型决策,提供完整规范的生产实践指导。
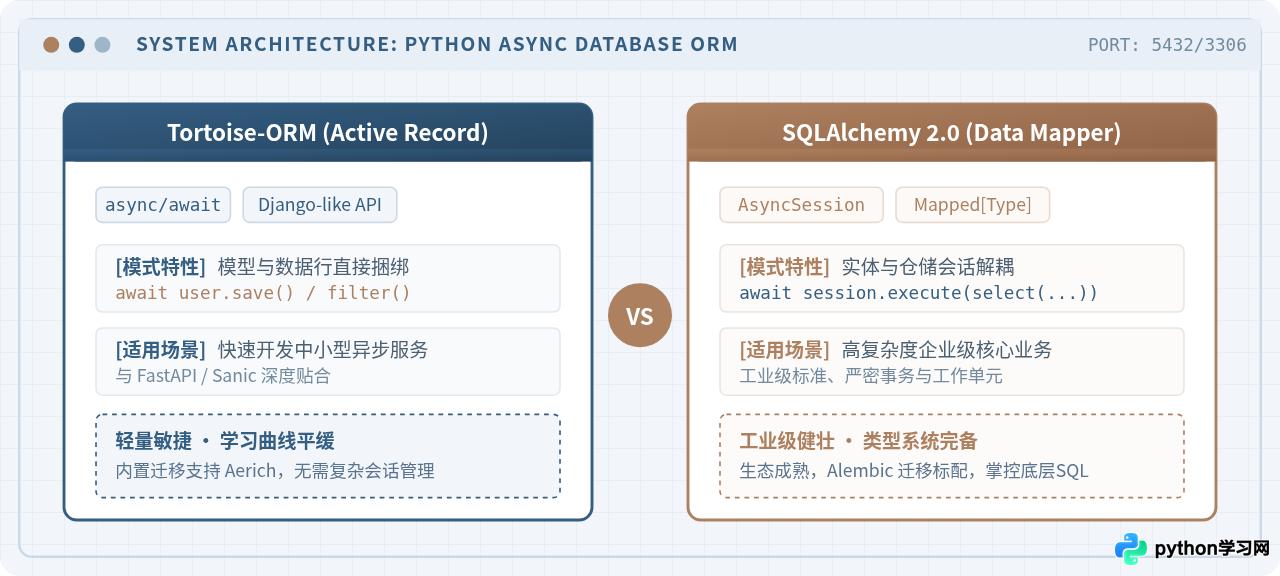
AsyncSession、select() 2.0 语法和完备的 PEP 484 强类型系统(Mapped[T])为支撑,将 Data Mapper 模式推向极致。本文将系统拆解两者的架构原理、配置流程、模型构建、异步 CRUD、关系加载及事务管理,并给出明确的选型决策依据。
一、底层架构设计理念:Active Record 与 Data Mapper
要透彻理解 Tortoise-ORM 与 SQLAlchemy 2.0 在使用方式上的根本分歧,首先必须厘清它们所采用的底层持久化设计模式。
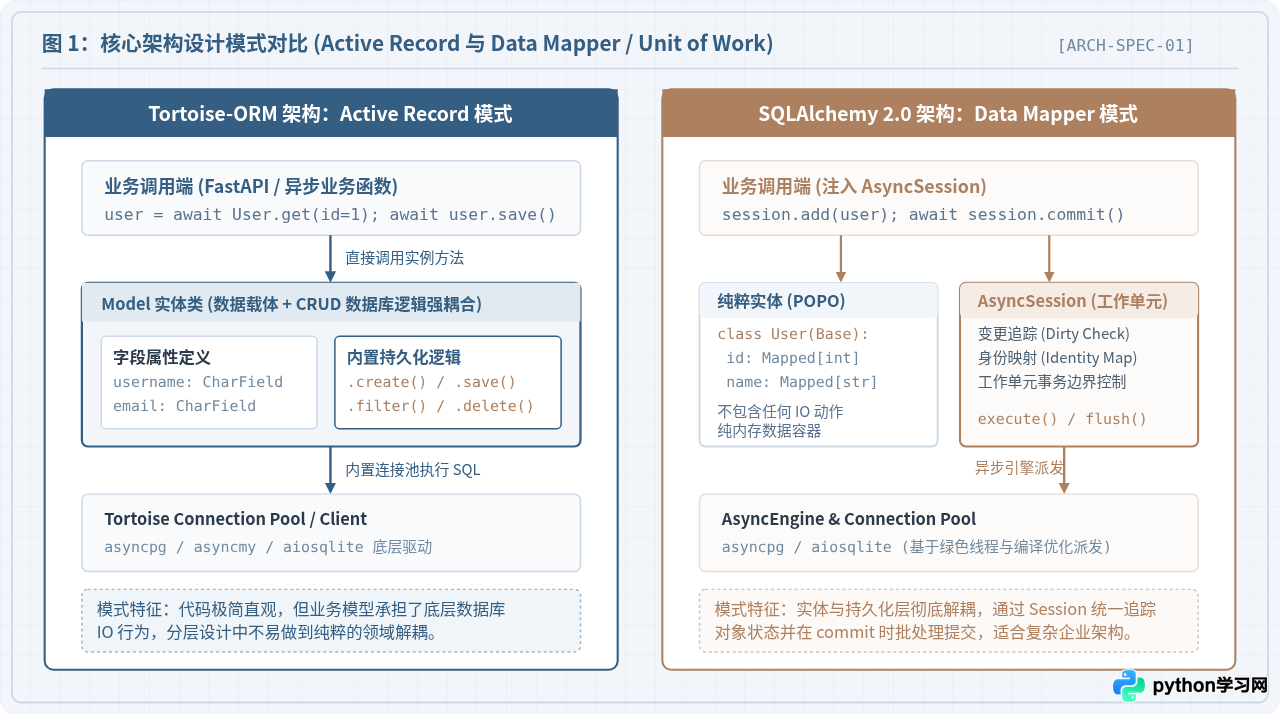
Tortoise-ORM 采用 Active Record(活动记录)模式。 在这种范式中,每一个模型类(Model Class)精确映射一张数据库表,而模型的每一个实例对象(Model Instance)直接映射表中的一条记录。更关键的是,持久化操作(如插入、修改、删除和查询)是直接内嵌在模型对象上的。例如调用 await user.save() 或 await User.get(id=1) 即可完成数据交换。其核心优势在于直观敏捷、调用链路极短,开发者无需显式管理复杂的会话(Session)与事务状态机。
SQLAlchemy 2.0 采用 Data Mapper(数据映射器)与 Unit of Work(工作单元)模式。 在该架构下,领域实体对象(Domain Entity)与底层的数据库持久化逻辑完全隔离。用户定义的模型类仅充当纯粹的内存数据容器,自身不具备任何直接调用 SQL 的方法。所有的持久化状态追踪、变更侦测(Dirty Tracking)以及事务提交均由 AsyncSession 负责统一编排。开发者将对象加入 session.add(user),直至执行 await session.commit() 时,Session 才会一次性解析内存中的变动并以最优顺序刷入数据库。这种解耦方式为复杂业务逻辑、高阶连表以及领域驱动设计(DDD)提供了强大的隔离保护。
二、运行环境准备与异步驱动配置
与传统的同步数据库操作不同,异步 ORM 必须依赖底层的异步客户端驱动程序(如基于 asyncio 协议实现的驱动)。如果配置了同步驱动(如 psycopg2 或 pymysql),引擎在建立连接时会直接抛出运行期异常。
1. 依赖库安装
针对主流数据库(PostgreSQL、MySQL、SQLite),需要安装对应的异步驱动与 ORM 依赖:
# Tortoise-ORM 异步驱动生态
pip install tortoise-orm[asyncpg]   # PostgreSQL 支持
pip install tortoise-orm[asyncmy]   # MySQL 支持
pip install tortoise-orm[aiosqlite] # SQLite 支持
pip install aerich                  # Tortoise 专用数据库迁移工具

# SQLAlchemy 2.0 异步驱动生态
pip install "sqlalchemy[asyncio]>=2.0.0"
pip install asyncpg                 # PostgreSQL 推荐异步驱动
pip install asyncmy                 # MySQL 异步驱动
pip install aiosqlite               # SQLite 异步驱动
pip install alembic                 # 工业级数据库迁移套件
2. Tortoise-ORM 的初始化与注销配置
Tortoise-ORM 采用集中式静态初始化设计,通常在应用程序启动时(如 FastAPI 的 lifespan 上下文)调用 Tortoise.init() 配置连接字典或数据库 URL,在服务关闭时调用 Tortoise.close_connections() 释放连接池。
from tortoise import Tortoise

TORTOISE_ORM_CONFIG = {
    "connections": {
        "default": "asyncpg://postgres:secret@127.0.0.1:5432/app_db"
    },
    "apps": {
        "models": {
            "models": ["models", "aerich.models"],
            "default_connection": "default",
        }
    },
}

async def init_tortoise():
    # 初始化连接池并加载模型元数据
    await Tortoise.init(config=TORTOISE_ORM_CONFIG)
    # 本地开发可自动生成物理表(生产环境推荐使用 aerich 进行版本迁移)
    await Tortoise.generate_schemas()

async def close_tortoise():
    # 优雅释放所有活跃连接
    await Tortoise.close_connections()
3. SQLAlchemy 2.0 的异步引擎与会话工厂配置
SQLAlchemy 2.0 通过 create_async_engine 构建异步引擎,并通过 async_sessionmaker 构造线程/协程安全的会话工厂。注意在连接串的方言协议中必须显式标明驱动名称(如 postgresql+asyncpg):
from sqlalchemy.ext.asyncio import (
    create_async_engine,
    async_sessionmaker,
    AsyncSession,
    AsyncEngine
)

DATABASE_URL = "postgresql+asyncpg://postgres:secret@127.0.0.1:5432/app_db"

# 1. 创建全局唯一的异步引擎,配置连接池参数
async_engine: AsyncEngine = create_async_engine(
    DATABASE_URL,
    echo=False,              # 生产环境关闭 SQL 详细回显
    pool_size=10,            # 常驻连接数
    max_overflow=20,         # 峰值可溢出连接数
    pool_pre_ping=True       # 连接健康检查,防止静默断开
)

# 2. 创建异步会话生成器
# expire_on_commit=False 是异步编程的关键参数,防止 commit 后访问属性触发隐式同步 I/O
AsyncSessionLocal = async_sessionmaker(
    bind=async_engine,
    class_=AsyncSession,
    expire_on_commit=False,
    autoflush=False
)

# 3. 依赖注入或上下文管理函数
async def get_async_session() -> AsyncSession:
    async with AsyncSessionLocal() as session:
yield sessionexpire_on_commit=False 在异步场景中至关重要。默认情况下(True),SQLAlchemy 在 session.commit() 后会令所有实体属性过期,当后续代码再次读取属性时会发起重新加载。而在异步运行期,这一重新加载行为若未经 await 驱动,便会立即抛出 MissingGreenlet 异常。
三、现代模型声明与强类型定义
模型声明负责建立 Python 类与底层数据库数据表的映射规范。SQLAlchemy 2.0 在该领域发生了革命性演进,全面推行 PEP 484 强类型注解;而 Tortoise-ORM 依旧保持着类似 Django 的紧凑定义模式。
1. Tortoise-ORM 模型定义
from tortoise import fields, models

class User(models.Model):
    id = fields.IntField(pk=True)
    username = fields.CharField(max_length=50, unique=True, index=True)
    email = fields.CharField(max_length=120, unique=True)
    is_active = fields.BooleanField(default=True)
    created_at = fields.DatetimeField(auto_now_add=True)

    class Meta:
        table = "users"

class Post(models.Model):
    id = fields.IntField(pk=True)
    title = fields.CharField(max_length=200)
    content = fields.TextField()
    # 建立外键关联,反向关联属性名为 posts
    author = fields.ForeignKeyField("models.User", related_name="posts", on_delete=fields.CASCADE)
    created_at = fields.DatetimeField(auto_now_add=True)

    class Meta:
        table = "posts"
2. SQLAlchemy 2.0 声明式强类型模型定义
SQLAlchemy 2.0 引入了基于 DeclarativeBase 与 Mapped[...] 的定义范式。结合 mapped_column(),静态分析器(如 Mypy、Pyright)能够在编写阶段直接推导各字段的真实 Python 类型与可空性:
from datetime import datetime
from typing import List, Optional
from sqlalchemy import String, Text, Boolean, DateTime, ForeignKey, func
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship

class Base(DeclarativeBase):
    pass

class User(Base):
    __tablename__ = "users"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(String(50), unique=True, index=True, nullable=False)
    email: Mapped[str] = mapped_column(String(120), unique=True, nullable=False)
    is_active: Mapped[bool] = mapped_column(Boolean, default=True)
    created_at: Mapped[datetime] = mapped_column(DateTime, server_default=func.now())

    # 声明关系映射,显式指明关联类型为 List[Post]
    posts: Mapped[List["Post"]] = relationship(back_populates="author", cascade="all, delete-orphan")

class Post(Base):
    __tablename__ = "posts"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    title: Mapped[str] = mapped_column(String(200), nullable=False)
    content: Mapped[str] = mapped_column(Text, nullable=False)
    author_id: Mapped[int] = mapped_column(ForeignKey("users.id", on_delete="CASCADE"), nullable=False)
    created_at: Mapped[datetime] = mapped_column(DateTime, server_default=func.now())

    # 反向关联回 User
    author: Mapped["User"] = relationship(back_populates="posts")
四、异步操作执行链路与生命周期流程
从用户发起数据库请求,到完成查询、修改并释放连接,异步 ORM 经历了一套严谨的生命周期调度。在异步协程环境下,每一次网络 I/O 等待都会让出主事件循环执行权,使其他并发请求得以无缝切入。
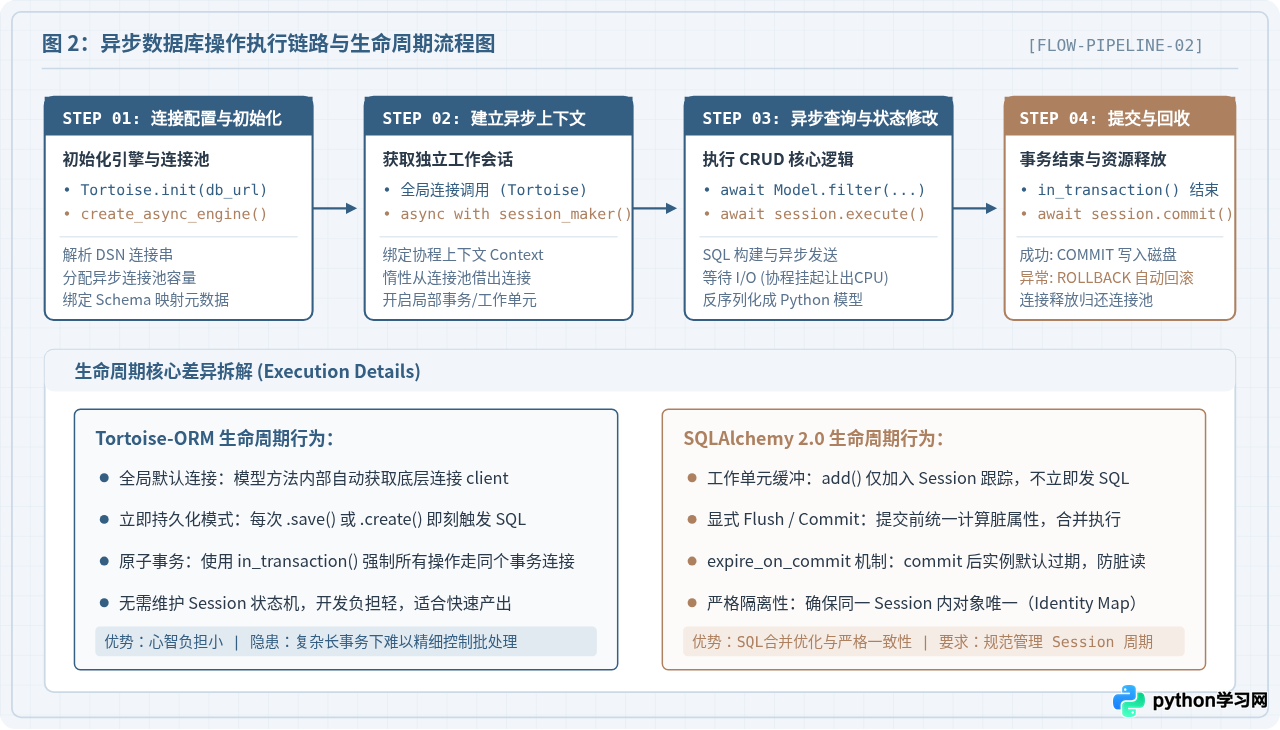
整个调用生命周期拆解为四个关键步骤:
- 初始化与连接池分配(STEP 01):解析数据库 DSN 连接串,预先拉起规定容量的异步连接池,并将模型元数据与引擎完成绑定。
- 协程上下文建立(STEP 02):在具体的异步请求生命周期内分配会话。Tortoise 在内部维护默认 client,而 SQLAlchemy 要求必须进入
async with AsyncSessionLocal()作用域,从连接池借出连接。 - 查询执行与对象反序列化(STEP 03):通过
await发送 SQL 指令,当前协程挂起,I/O 完成后将网络返回的数据字节流反序列化为模型对象。 - 工作单元归约与资源释放(STEP 04):根据业务结果触发 COMMIT 或 ROLLBACK。会话关闭后,连接清空脏数据并安全归还至连接池,杜绝连接泄露。
五、核心异步 CRUD 与高级查询实操对比
下面针对常见的增、删、改、查业务操作,给出两款框架在现代异步环境下的标准语法对照。
1. 数据创建(Create)
# --- Tortoise-ORM ---
# 方式 1:调用 create 一步到位持久化到数据库
user = await User.create(username="zhangsan", email="zhangsan@example.com")

# 方式 2:实例化后调用 save()
user_alt = User(username="lisi", email="lisi@example.com")
await user_alt.save()

# --- SQLAlchemy 2.0 ---
# 实例化模型对象(纯内存数据),交由 session 追踪后提交
async with AsyncSessionLocal() as session:
    new_user = User(username="zhangsan", email="zhangsan@example.com")
    session.add(new_user)
    await session.commit()
    # commit 后 new_user.id 已被数据库生成的主键回填
    print(f"Created user id: {new_user.id}")
2. 数据读取与条件过滤(Read)
# --- Tortoise-ORM ---
# 查询单条记录,不存在则返回 None
user = await User.filter(username="zhangsan").first()

# 复杂条件过滤与切片分页
active_users = await User.filter(is_active=True).order_by("-created_at").offset(0).limit(10)

# --- SQLAlchemy 2.0 ---
from sqlalchemy import select

async with AsyncSessionLocal() as session:
    # 构造 2.0 风格的 select 语句
    stmt = select(User).where(User.username == "zhangsan")
    result = await session.execute(stmt)
    # scalar_one_or_none 取出单个对象实体或 None
    user = result.scalar_one_or_none()

    # 列表分页查询
    list_stmt = (
        select(User)
        .where(User.is_active == True)
        .order_by(User.created_at.desc())
        .offset(0)
        .limit(10)
    )
    result = await session.execute(list_stmt)
    active_users = result.scalars().all()
3. 数据更新(Update)
# --- Tortoise-ORM ---
# 单实例更新:直接修改属性并 save
user = await User.get(id=1)
user.email = "new_email@example.com"
await user.save(update_fields=["email"])  # 支持指定仅更新特定字段

# 批量条件更新:无需查出实体,直接下发 UPDATE 语句
await User.filter(is_active=False).update(is_active=True)

# --- SQLAlchemy 2.0 ---
from sqlalchemy import update

async with AsyncSessionLocal() as session:
    # 模式 1:查出实体后修改(利用工作单元 Dirty Check 自动识别变动)
    user = await session.get(User, 1)
    if user:
        user.email = "new_email@example.com"
        await session.commit()  # commit 时自动下发针对修改字段的 UPDATE

    # 模式 2:下发批量 UPDATE 语句
    batch_stmt = update(User).where(User.is_active == False).values(is_active=True)
    await session.execute(batch_stmt)
    await session.commit()
4. 数据删除(Delete)
# --- Tortoise-ORM ---
user = await User.get(id=1)
await user.delete()

# 批量条件删除
await User.filter(is_active=False).delete()

# --- SQLAlchemy 2.0 ---
from sqlalchemy import delete

async with AsyncSessionLocal() as session:
    # 实体删除
    user = await session.get(User, 1)
    if user:
        await session.delete(user)
        await session.commit()

    # 批量条件删除语句
    del_stmt = delete(User).where(User.is_active == False)
    await session.execute(del_stmt)
    await session.commit()
六、关联关系建模与异步预加载(Eager Loading)防坑指南
在异步编程模式中,关系查询是最容易引发生产事故的重灾区。在以往传统的同步 ORM(如经典 Django ORM 或 SQLAlchemy 1.4 同步模式)中,开发者普遍习惯了“隐式延迟加载(Implicit Lazy Loading)”:查询出 user 后,直接在模板或循环中读取 user.posts,ORM 会在后台自动发送查询。但在异步编程中,这一机制被视为致命缺陷。
user.posts)是同步的,不可能直接嵌入 await。如果 ORM 试图在属性读取时触发数据库 I/O,必须借由底层 hack 手段(如 greenlet)甚至直接产生同步阻塞。在 SQLAlchemy 2.0 异步模式下,对未预先加载的关联关系进行访问会直接引发致命的 sqlalchemy.exc.MissingGreenlet 报错!
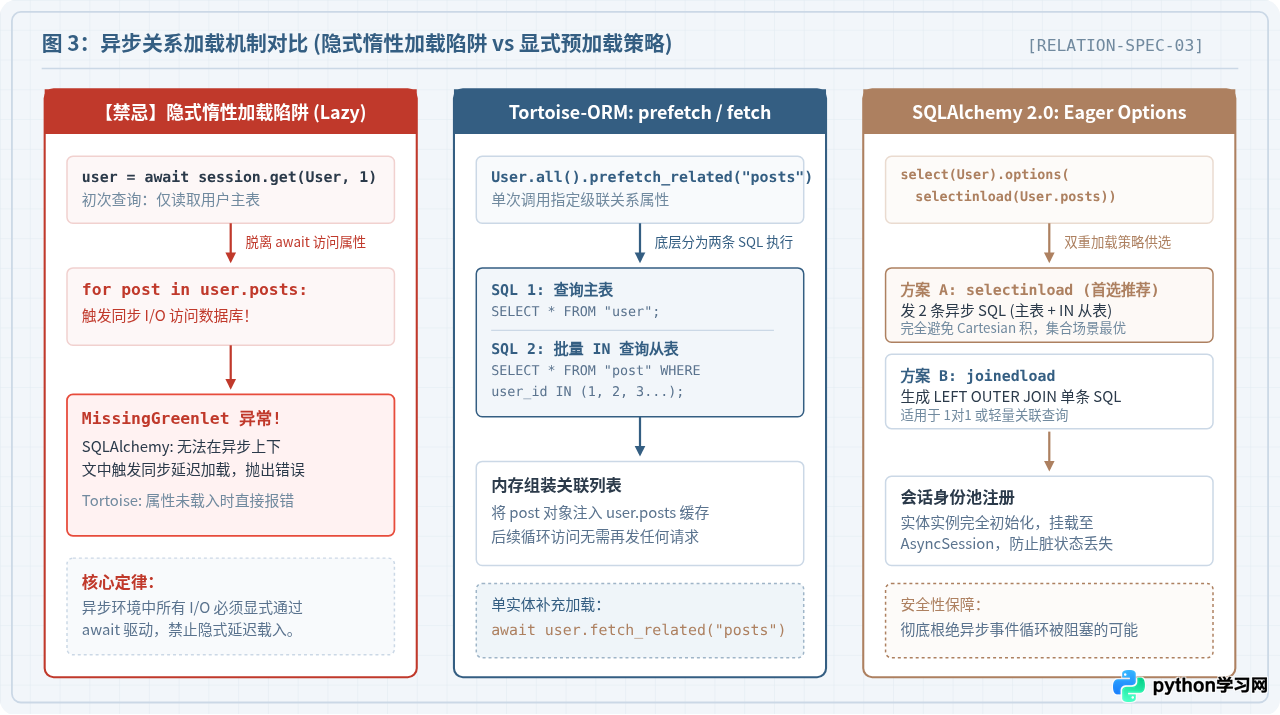
1. Tortoise-ORM 预加载实操
Tortoise-ORM 提供了 prefetch_related() 方法以及手动补查的 fetch_related() 方法:
# 查询用户的同时,预加载其发布的文章列表
users = await User.all().prefetch_related("posts")
for u in users:
    # 此处可以直接安全访问 u.posts,无需 I/O
    for p in u.posts:
        print(f"Post Title: {p.title}")

# 若手头已有单个 user 实体但尚未载入 posts:
single_user = await User.get(id=1)
# 显式使用 await 拉取关联字段
await single_user.fetch_related("posts")
print(len(single_user.posts))
2. SQLAlchemy 2.0 异步加载策略:selectinload 与 joinedload
SQLAlchemy 2.0 提供了高精度的显式预加载选项,最常用的是 selectinload 和 joinedload:
- selectinload(首选推荐):首先执行主表查询,随后利用
WHERE author_id IN (...)执行第二条查询拉取所有从表记录,并在内存中快速缝合。该方式完美规避了 Cartesian 乘积与重复行传输,在 1 对多(One-to-Many)集合关联中效率最高。 - joinedload:通过生成一条带有
LEFT OUTER JOIN的 SQL 查询,一次性连表带回主表与从表数据。适用于 1 对 1(One-to-One)或多对 1(Many-to-One)关系的紧凑加载。
from sqlalchemy.orm import selectinload, joinedload

async with AsyncSessionLocal() as session:
    # 针对 1对多 集合关联,使用 selectinload
    stmt = (
        select(User)
        .options(selectinload(User.posts))
        .where(User.is_active == True)
    )
    result = await session.execute(stmt)
    users = result.scalars().all()

    for user in users:
        # 安全遍历已载入的 posts,绝不产生 MissingGreenlet
        for post in user.posts:
            print(post.title)

    # 针对从表查主表(多对1),可使用 joinedload 单句连表
    post_stmt = (
        select(Post)
        .options(joinedload(Post.author))
        .where(Post.id == 1)
    )
    res = await session.execute(post_stmt)
    single_post = res.scalar_one_or_none()
    if single_post:
        print(single_post.author.username)
七、异步事务管理与并发安全
在涉及资金流水、订单创建等严苛场景下,多个写操作必须保持原子性(ACID)。异步环境下的事务管理必须严格限制在同一个底层物理连接内完成。
1. Tortoise-ORM 事务写法
Tortoise 提供异步上下文管理器 in_transaction() 以及 @atomic() 装饰器:
from tortoise.transactions import in_transaction

async def transfer_credits_tortoise(user_id: int, title: str):
    # 进入独立事务块,若发生未捕获异常自动 ROLLBACK
    async with in_transaction() as connection:
        user = await User.get(id=user_id).using_db(connection)
        post = await Post.create(title=title, content="...", author=user, using_db=connection)
        # 操作全部顺利完成,离开上下文时自动 COMMIT
2. SQLAlchemy 2.0 事务写法
在 SQLAlchemy 2.0 中,AsyncSession 本身就代表了一个工作单元,通过 session.begin() 能够以最优雅的方式包裹受事务保护的代码段:
async def create_post_transaction(user_id: int, title: str, content: str):
    async with AsyncSessionLocal() as session:
        # 使用 async with session.begin() 开启原子事务
        async with session.begin():
            user = await session.get(User, user_id)
            if not user:
                raise ValueError("用户不存在")

            new_post = Post(title=title, content=content, author=user)
            session.add(new_post)
            # 块内若抛出任何异常,上下文管理器将自动触发 await session.rollback()
            # 正常执行完毕则自动触发 await session.commit()
八、技术选型决策与全方位对比指南
面对具体的工程需求,选用 Tortoise-ORM 还是 SQLAlchemy 2.0,应当根据团队背景、系统规模以及维护周期进行理性权衡。
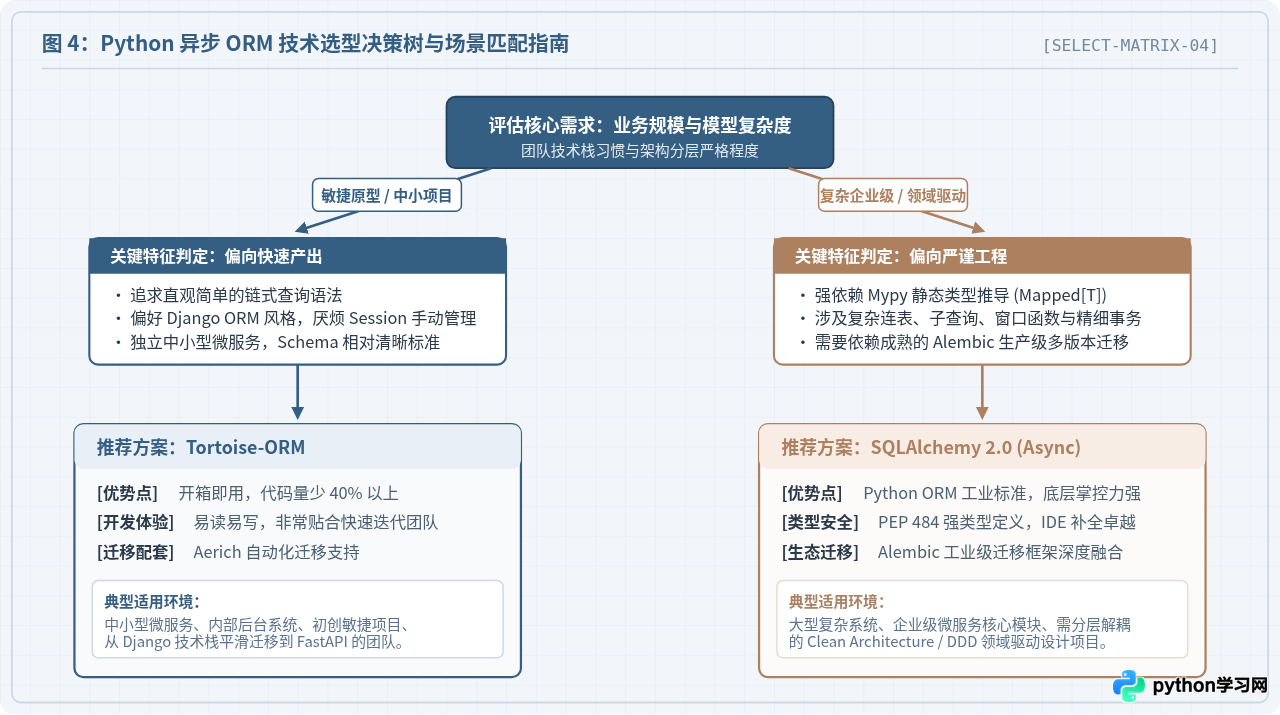
| 对比维度 | Tortoise-ORM | SQLAlchemy 2.0 (Async) |
|---|---|---|
| 核心设计模式 | Active Record(活动记录模式) | Data Mapper + Unit of Work(数据映射器与工作单元) |
| 静态类型支持 | 基础字段类定义,IDE 推断较弱 | 原生强类型(PEP 484),Mapped[T] 完美支持 Mypy |
| 学习与上手曲线 | 极度平缓,与 Django ORM 极其相似 | 陡峭,需深刻理解 Engine、Session、Loader Options 状态机 |
| 开发代码量 | 精简,CRUD 代码量较小 | 相对冗长,需显式构造 select、execute 及管理 session |
| 复杂 SQL 掌控力 | 适中,处理深度嵌套连表或窗口函数较吃力 | 工业级无上限,近乎能表达任意复杂的 SQL 语句 |
| 数据库迁移生态 | 基于 Aerich(轻量敏捷,满足常规表结构变动) | 基于 Alembic(行业绝对标配,支持高度定制与多分支迁移) |
| 典型适用工程 | 中小型微服务、内部工具系统、敏捷初创产品 | 大型核心商业系统、复杂领域模型(DDD)、长期演进项目 |
落地总结与选型建议
- 果断选用 Tortoise-ORM 的场景:团队技术栈以 Python 快速交付为主,成员多有 Django 背景;或者工程属于体量明确的轻量微服务,表结构多在 20 张以内,无需极其生僻复杂的 SQL 连表与精细工作单元调度。此时使用 Tortoise-ORM 配合 FastAPI 可以获得无与伦比的迭代效率。
- 果断选用 SQLAlchemy 2.0 的场景:属于公司级核心后端架构,业务模型错综复杂;对全工程静态类型检查(Type Checking)有硬性要求;或者团队需要利用 Alembic 处理数十人协作下的大规模数据库模式迁移。SQLAlchemy 2.0 尽管初期学习成本较高,但其强大的健壮性、架构解耦能力和工业级生态,能为系统的长久演进保驾护航。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















