


Python tuple常用内置方法count()和index()用法
详解Python元组(tuple)仅有的两个内置方法count()和index()的语法格式、参数作用、返回值规则、区间查找技巧以及常见异常处理方法。
假设你在编写一段配置检查脚本,把允许访问的端口号保存在一个不可修改的元组 allowed_ports = (80, 443, 8080, 80, 8443) 中。现在你需要确认两个问题:端口号 80 是否重复配置了几次?端口号 8080 排在第几个位置?在 Python 中,元组(tuple)专门提供了 count() 和 index() 这两个内置方法来直接解决元素频次统计与位置检索问题。本文将围绕这两个方法的语法规则、参数细节、边界行为和异常处理展开说明。
一、为什么 tuple 只有 count() 和 index() 两个常规内置方法
直接给出结论:因为元组(tuple)是不可变序列(Immutable Sequence),一旦创建就无法在原地增删或修改元素,所以它只保留了不改变自身数据的查询类方法,即用于统计次数的 count() 和用于查找下标的 index()。
与列表(list)对比更容易理解这一设计。列表支持 append()、extend()、insert()、remove()、pop()、sort() 等修改自身结构的方法;而元组的设计目标是保证元素顺序与引用固定不变,因此所有会改动元素的操作都被排除在外。在 Python 3.x 环境(如终端交互式解释器或任意 .py 脚本文件)中,可以通过内置函数 dir(tuple) 过滤掉双下划线开头的特殊方法进行验证。
# 查看 tuple 所有不以双下划线开头的公开内置方法
public_methods = [m for m in dir(tuple) if not m.startswith('__')]
print(public_methods)['count', 'index']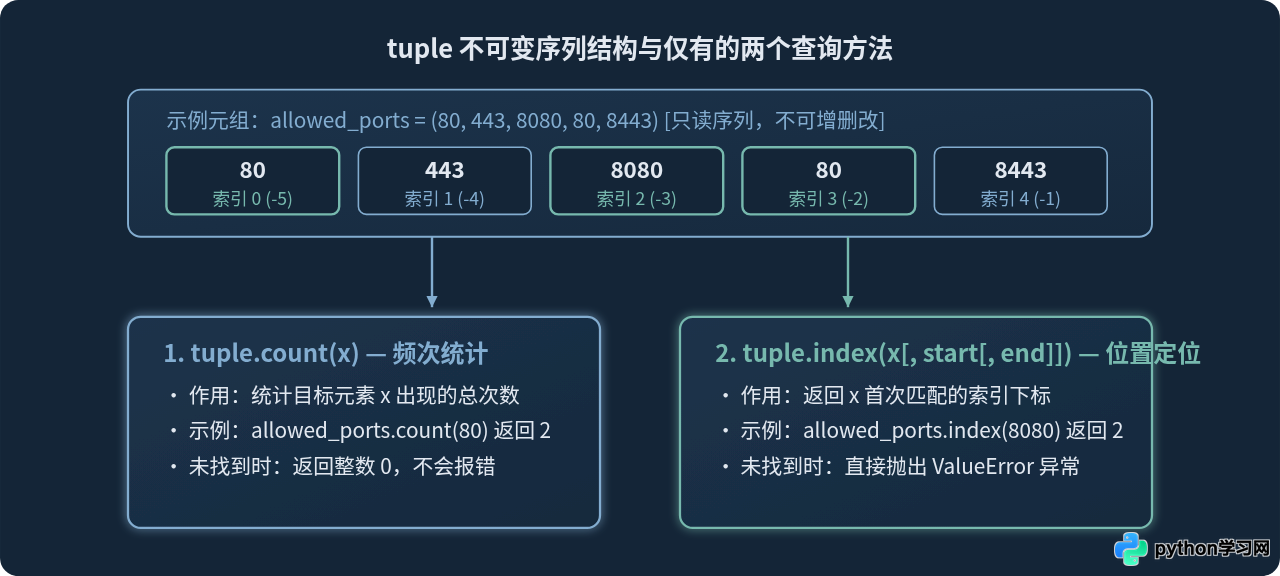
二、使用 count() 统计元素在元组中出现的次数
当你需要知道某个值在元组中一共出现了多少次,或者判断某个值是否存在时,使用 count() 方法。它会从头到尾扫描整个元组,并返回与目标值相等的元素个数。
1. 语法格式与参数说明
count() 的调用语法非常直接,只接收一个必填参数:
tuple_obj.count(x)x(必填):需要统计的目标元素,可以是数字、字符串、元组、列表等任意 Python 对象。- 返回值:返回一个非负整数(
int)。如果元素存在,返回实际出现次数;如果元素不存在,返回0,不会抛出异常。
2. 基础统计与不存在元素的处理
继续使用开篇提到的端口配置元组 allowed_ports,我们可以统计已存在端口和未配置端口的出现次数:
allowed_ports = (80, 443, 8080, 80, 8443)

# 统计出现多次的元素
count_80 = allowed_ports.count(80)
print("端口 80 出现次数:", count_80)

# 统计只出现一次的元素
count_443 = allowed_ports.count(443)
print("端口 443 出现次数:", count_443)

# 统计不存在的元素(安全返回 0)
count_22 = allowed_ports.count(22)
print("端口 22 出现次数:", count_22)端口 80 出现次数: 2
端口 443 出现次数: 1
端口 22 出现次数: 03. 容易出错的细节:布尔值与整数的等价匹配
在 Python 中,bool 类型是 int 的子类,且在相等性判断(==)中,True == 1、False == 0、1 == 1.0 均成立。由于 count()(以及后文的 index())底层依赖 == 运算符而非 is 身份运算符进行比较,当元组中混有布尔值、整数 0/1 或浮点数 0.0/1.0 时,它们会被合并计入统计结果。
1、1.0 和 True,直接调用 tuple.count(1) 或 tuple.count(True) 会将三者全部算作匹配项。若业务要求严格区分数据类型,不能直接使用 count(),而应配合 type(item) is target_type 进行统计。
mixed_data = (1, True, 0, False, 1.0, "1")

# 默认 count() 使用 == 比较,1、True、1.0 均被视为相等
print("默认 count(1) 结果:", mixed_data.count(1))
print("默认 count(True) 结果:", mixed_data.count(True))

# 若需严格只统计布尔值 True(排除整数 1 和浮点数 1.0)
strict_true_count = sum(1 for item in mixed_data if type(item) is bool and item is True)
print("严格统计 bool 类型 True 的结果:", strict_true_count)默认 count(1) 结果: 3
默认 count(True) 结果: 3
严格统计 bool 类型 True 的结果: 1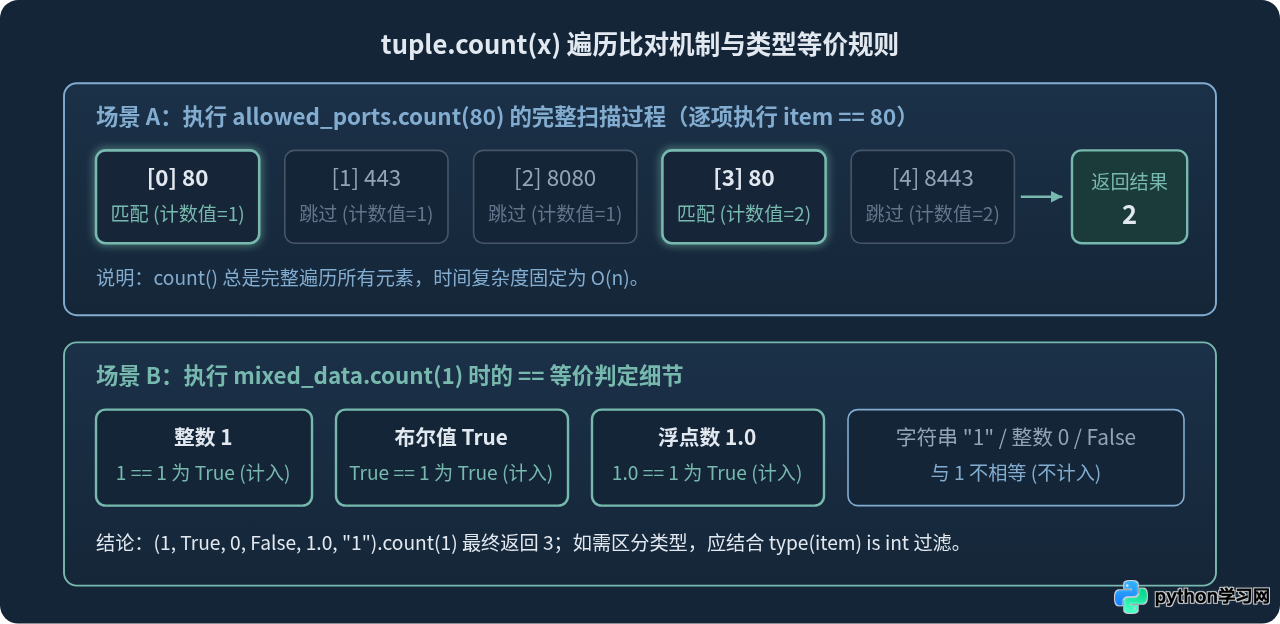
三、使用 index() 查找元素的索引位置
当你需要确定某个元素在元组中排在第几位(即获取从 0 开始的索引下标)时,使用 index() 方法。它会从左向右依次比对,一旦找到第一个相等的元素就立即返回其索引并停止搜索。
1. 语法格式与可选区间参数
与 count() 只能全量扫描不同,index() 除了目标元素外,还支持传入起始和结束位置,用来限定查找范围:
tuple_obj.index(x[, start[, end]])x(必填):需要查找的目标元素。start(可选,默认从索引0开始):查找的起始索引(包含该位置),支持负数索引。end(可选,默认到元组末尾):查找的结束索引(不包含该位置,遵循左闭右开区间[start, end)规则),同样支持负数索引。- 返回值:返回目标元素首次匹配时的原始元组索引(
int,始终以整个元组的0号位置为基准,而不是相对于start的偏移量)。
2. 首次匹配与指定区间查找示例
如果目标元素在元组中出现了多次,直接调用 index(x) 只会返回第一次出现的位置。若要查找后续重复出现的位置,可以把上一次找到的索引加 1,作为下一次调用的 start 参数传入:
allowed_ports = (80, 443, 8080, 80, 8443)

# 1. 查找 8080 的位置
idx_8080 = allowed_ports.index(8080)
print("8080 的索引位置:", idx_8080)

# 2. 查找重复元素 80 第一次出现的位置
first_80 = allowed_ports.index(80)
print("第一个 80 的索引位置:", first_80)

# 3. 从 first_80 + 1 开始继续向后查找第二个 80
second_80 = allowed_ports.index(80, first_80 + 1)
print("第二个 80 的索引位置:", second_80)

# 4. 限定在索引区间 [1, 4) 内查找 80(检查下标 1、2、3)
range_80 = allowed_ports.index(80, 1, 4)
print("区间 [1, 4) 内 80 的索引位置:", range_80)8080 的索引位置: 2
第一个 80 的索引位置: 0
第二个 80 的索引位置: 3
区间 [1, 4) 内 80 的索引位置: 3index(x, start, end) 中的 end 是开区间边界,下标为 end 的元素本身不会参与比对。例如在 allowed_ports = (80, 443, 8080, 80, 8443) 中调用 allowed_ports.index(80, 1, 3) 时,程序只检查下标 1(443)和下标 2(8080),不会检查下标 3(80),因此会触发 ValueError。
四、处理 index() 找不到元素时的 ValueError 异常
这是使用 index() 时最关键的注意事项:当目标元素不在元组中(或者不在指定的 [start, end) 区间内)时,index() 不会返回 -1 或 None,而是直接抛出 ValueError: tuple.index(x): x not in tuple 异常。如果不做防护,程序会在此处中断运行。
allowed_ports = (80, 443, 8080, 80, 8443)

# 查找不存在的端口 3306
print(allowed_ports.index(3306))Traceback (most recent call last):
File "demo.py", line 4, in <module>
print(allowed_ports.index(3306))
ValueError: tuple.index(x): x not in tuple安全的两种标准操作写法
在实际代码中,若不确定元素是否一定存在于元组内,应采用以下两种标准写法之一来避免程序崩溃:
- 先用
in运算符判断,再调用index():适合不限制start/end区间、且代码逻辑偏向条件分支的场景。 - 使用
try...except ValueError捕获异常:适合带有start/end区间参数,或者希望只扫描一次元组即可拿到索引的场景(先用in再用index()会在底层扫描两次,而try...except只需扫描一次)。
allowed_ports = (80, 443, 8080, 80, 8443)
target_port = 3306

# 方式一:先使用 in 判断(直观易读)
if target_port in allowed_ports:
    pos = allowed_ports.index(target_port)
    print(f"[方式一] 端口 {target_port} 位于索引 {pos}")
else:
    pos = -1
    print(f"[方式一] 端口 {target_port} 未配置,默认返回 {pos}")

# 方式二:使用 try...except ValueError(适合带区间参数或只需单次遍历)
try:
    pos = allowed_ports.index(80, 1, 3)
    print(f"[方式二] 区间 [1, 3) 内找到端口 80,索引为 {pos}")
except ValueError:
    pos = -1
print(f"[方式二] 区间 [1, 3) 内未找到端口 80,默认返回 {pos}")[方式一] 端口 3306 未配置,默认返回 -1
[方式二] 区间 [1, 3) 内未找到端口 80,默认返回 -1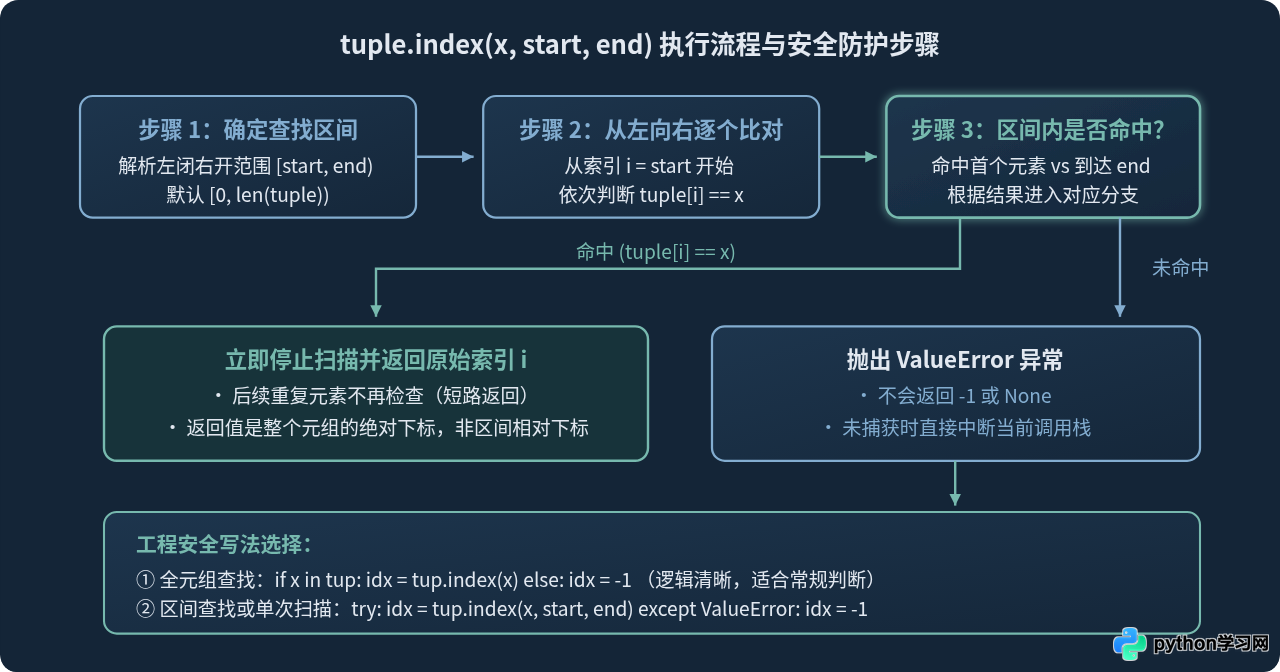
五、进阶实用技巧:获取重复元素的全部索引与嵌套元组查找
在日常开发中,除了基础的单次调用外,经常会遇到“找出某个重复元素的所有下标”以及“在嵌套元组中统计或定位子元组”这两类需求。
1. 获取某个元素在元组中的所有索引位置
由于 index() 每次只返回第一个匹配位置,如果你需要一次性拿到某个元素出现的全部索引列表,有两种常用写法:一种是结合 enumerate() 用列表推导式过滤(最简洁,只需遍历一次);另一种是利用 index(x, start) 循环推进起始位置。
allowed_ports = (80, 443, 8080, 80, 8443, 80)

# 方法 A(推荐):使用 enumerate 遍历一次获取所有匹配下标
all_indices_a = [i for i, port in enumerate(allowed_ports) if port == 80]
print("方法 A 获取全部 80 的索引:", all_indices_a)

# 方法 B:利用 index(x, start) 循环向后查找
all_indices_b = []
start_pos = 0
while True:
    try:
        found_idx = allowed_ports.index(80, start_pos)
        all_indices_b.append(found_idx)
        start_pos = found_idx + 1  # 下一次从当前命中位置的下一位开始
    except ValueError:
        break
print("方法 B 获取全部 80 的索引:", all_indices_b)方法 A 获取全部 80 的索引: [0, 3, 5]
方法 B 获取全部 80 的索引: [0, 3, 5]2. 在二维或嵌套元组中使用 count() 和 index()
count() 和 index() 只对元组的第一层元素进行比对,不会自动递归进入子元组内部。当元组的元素本身也是元组(如坐标点或数据库行记录)时,传入的参数必须是完整的子元组对象才能匹配成功。
# 嵌套元组:每个元素是一个 (主机, 端口) 二元组
endpoints = (
    ("10.0.0.1", 80),
    ("10.0.0.2", 443),
    ("10.0.0.1", 80),
)

# 传入完整子元组进行匹配(正常命中)
print("完整子元组出现次数:", endpoints.count(("10.0.0.1", 80)))
print("完整子元组首次索引:", endpoints.index(("10.0.0.2", 443)))

# 仅传入子元组内部的单个值(不会递归查找,因此返回 0)
print("单独查找 '10.0.0.1' 的次数:", endpoints.count("10.0.0.1"))完整子元组出现次数: 2
完整子元组首次索引: 1
单独查找 '10.0.0.1' 的次数: 0六、count() 与 index() 核心差异对比与使用总结
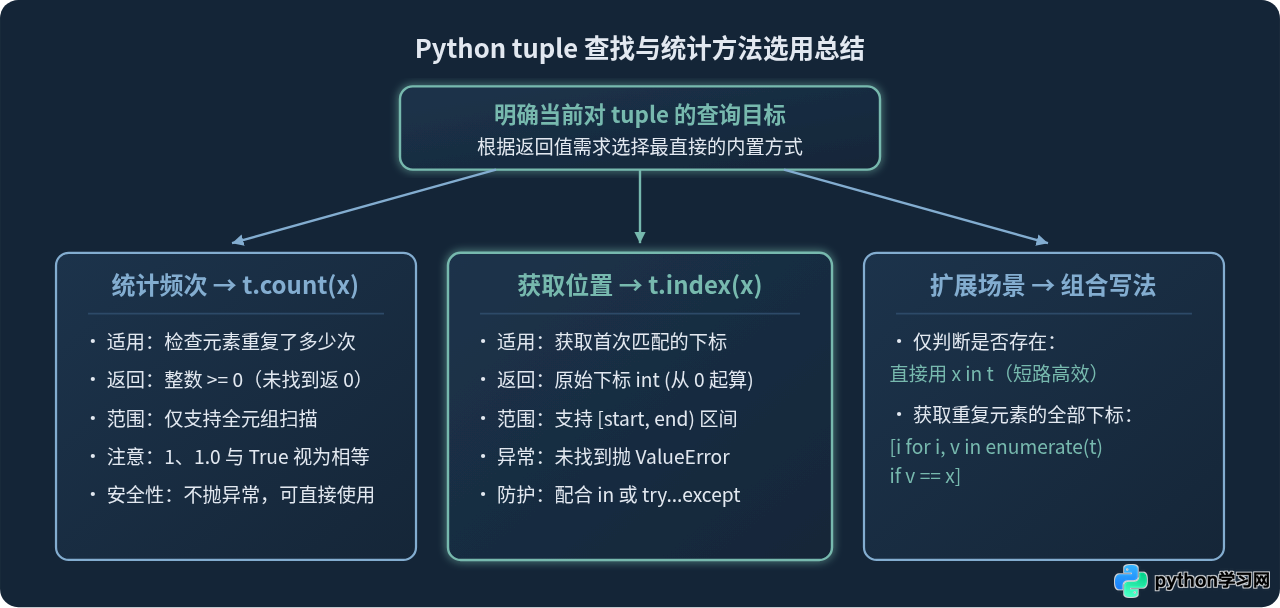
为了在实际编码时快速决定使用哪个方法或运算符,下面通过表格和总结图梳理 count()、index() 以及成员运算符 in 的适用边界。
| 对比维度 | tuple.count(x) |
tuple.index(x[, start[, end]]) |
x in tuple(补充对照) |
|---|---|---|---|
| 核心用途 | 统计元素 x 出现的总次数 |
获取元素 x 首次出现的索引下标 |
仅判断元素 x 是否存在 |
| 支持区间限制 | 不支持(始终扫描整个元组) | 支持 start 和 end 左闭右开区间 |
不支持(但一旦命中即停止扫描) |
| 元素不存在时 | 返回整数 0(不抛异常) |
抛出 ValueError 异常 |
返回布尔值 False(不抛异常) |
| 遍历开销 | 固定完整遍历,时间复杂度 $O(n)$ | 命中首个即停止,最坏时间复杂度 $O(n)$ | 命中首个即停止,比 count(x) > 0 更快 |
if x in my_tuple:,而不要写 if my_tuple.count(x) > 0:。因为 in 在遇到第一个匹配项时就会立即返回 True,而 count() 无论如何都会把整个元组遍历完。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















