


Python切片步长设为0会报错吗?常见误区与空结果分析

ValueError: slice step cannot be zero),而绝不会静默返回空列表或空字符串。许多开发者因为习惯了 Python 切片对起止索引越界的强大容错性,误以为步长为 0 也会返回空结果,这种认知混淆是引发线上意外中断的常见隐患。
一、实测验证:步长为0的具体报错行为
很多初学者在编写序列截取逻辑时,可能会产生一种直觉:“既然截取范围无效时切片会给出一个空序列,那步长为0是不是意味着什么都不取,或者返回空值?”在实际运行中,这种假设会立即碰壁。
无论操作的对象是内置列表、元组、字符串,还是通过显式 slice() 对象构造切片,只要步长取值为 0,Python 解释器都会在求值阶段立即报错:
# 示例 1:对列表进行切片
numbers = [10, 20, 30, 40, 50]
result = numbers[::0]
# 抛出异常:ValueError: slice step cannot be zero

# 示例 2:对字符串进行切片
text = "Python"
sub_text = text[1:4:0]
# 抛出异常:ValueError: slice step cannot be zero

# 示例 3:显式使用 slice 对象
s = slice(0, 3, 0)
numbers[s]
# 抛出异常:ValueError: slice step cannot be zero
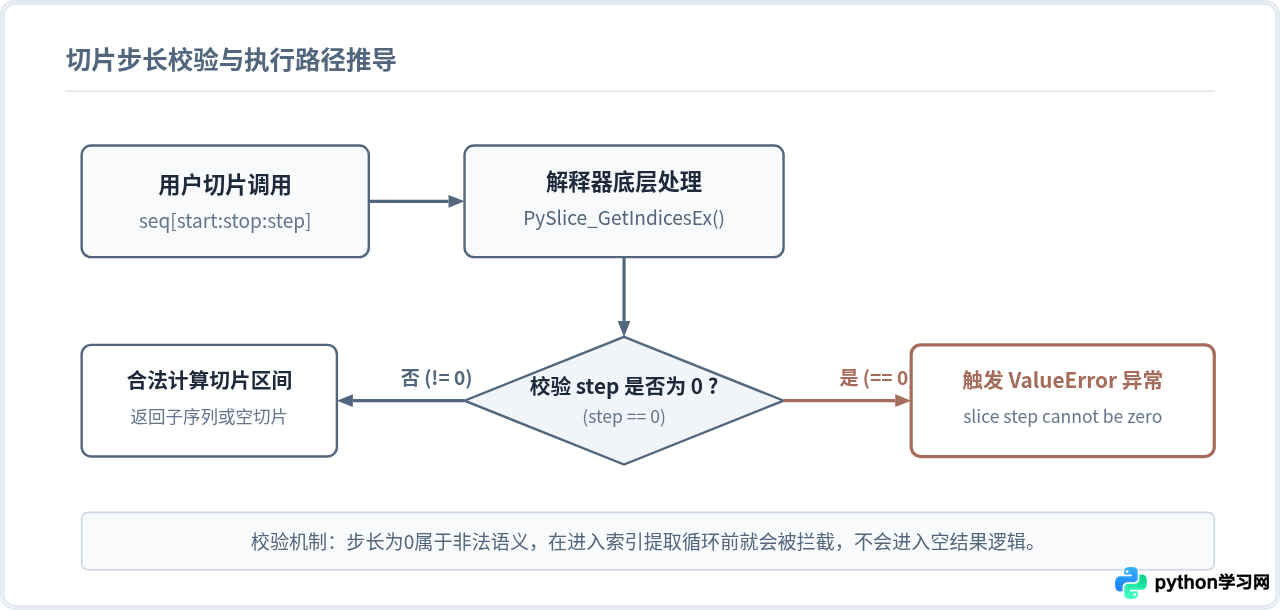
从调用栈信息可以看出,解释器不仅在语法层面接受 [::0] 的书写,但在执行切片内部求值的第一时间,就会主动检查 step 的有效性,并抛出不可忽略的 ValueError。
二、为什么步长为0不能设为默认空结果?
要理解 Python 为何对步长采取如此严厉的限制,需要从切片的位移模型与数学语义切入。
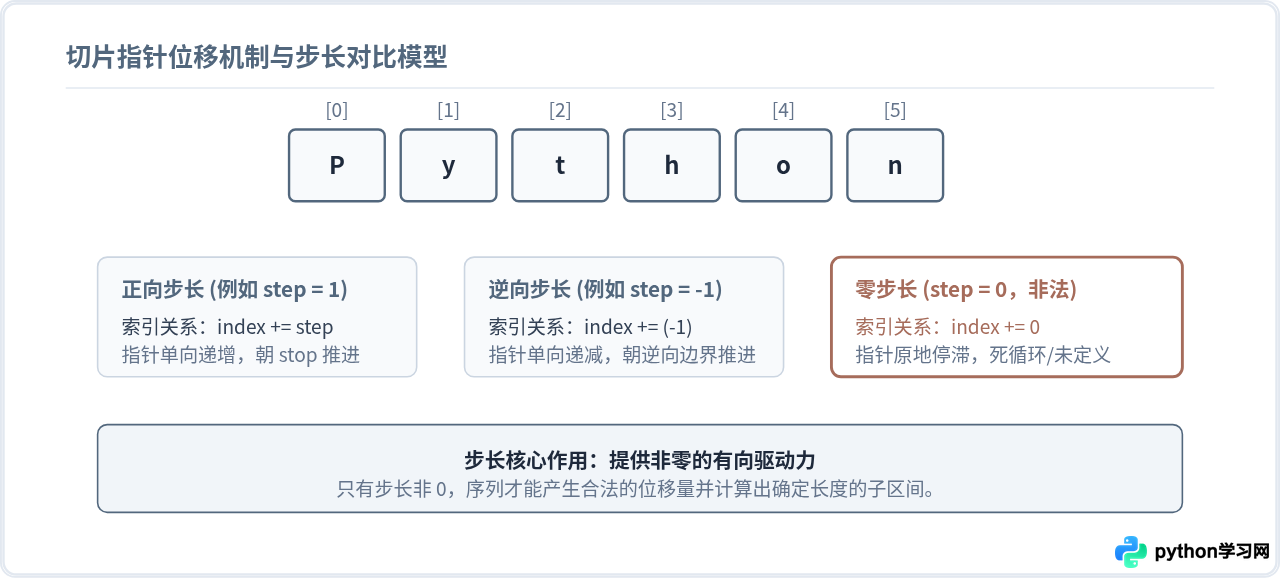
标准切片语法为 sequence[start:stop:step]。从迭代角度看,它的核心任务是从起始下标 start 开始,每次将指针加上 step,直到指针跨出 stop 划定的边界为止。也就是说,下一次访问的索引是:
index_next = index_current + step如果允许 step = 0,数学上就会出现严重死循环或零除问题:
- 指针永远停滞在起点:
index + 0 = index。无论循环多少轮,指针位置保持不变,永远无法向stop逼近。 - 结果长度无法计算:正常切片结果的长度大致由
ceil((stop - start) / step)决定。若step为 0,分母为 0 导致公式无数学意义。 - 语义矛盾:步长为 0 究竟代表“在当前位置无限原地取值”还是“什么都不取”?这两种推论都不符合切片“在有序集合上以固定步长提取子序列”的定义。
在 CPython 的核心实现文件 sliceobject.c 中,PySlice_GetIndicesEx 函数的首要断言便是:
if (step == 0) {
    PyErr_SetString(PyExc_ValueError, "slice step cannot be zero");
    return -1;
}
Python 设计哲学强调“面对模棱两可,拒绝猜测”。既然步长为0既无法合法递增,又存在严重歧义,抛出 ValueError 是最清晰、最负责任的做法。
三、常见误区:为什么有人会误以为切片会返回空结果?
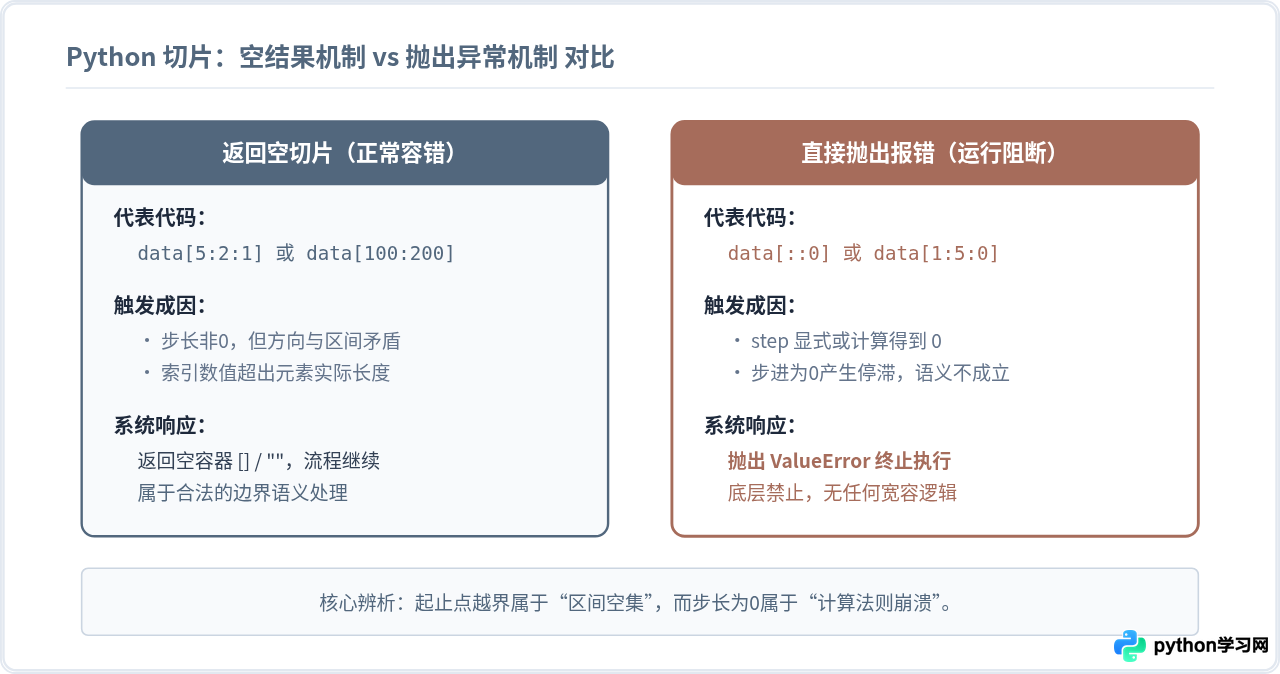
开发者之所以对 step=0 产生“会返回空结果”的误解,主要根源在于 Python 切片在处理 start 和 stop 时表现得极度宽容。许多人在潜意识中把对起止索引的宽容性,平移到了步长上。
1. 真正返回空切片的典型场景
在 Python 中,“切片返回空列表/空容器”是完全合法且常见的现象,但它们均满足步长合法(非0)的前提:
- 场景 A:正向步长下起点在终点之后或相同
例如numbers[3:1:1]或numbers[2:2]。因为从索引 3 无法通过+1到达索引 1,初始即超出终止条件,安全返回[]。 - 场景 B:逆向步长下起点在终点之前或相同
例如numbers[1:4:-1]。从索引 1 无法通过-1倒序逼近索引 4,同样安全返回[]。 - 场景 C:索引彻底越界
例如一个长度为 5 的列表执行numbers[10:20]。Python 会自动将起止位置规整到序列末尾边界,返回[]而不是抛出IndexError。
# 以下属于“空切片”,程序正常执行并安全返回 []
data = [1, 2, 3, 4]
print(data[3:1])      # 输出: [](step默认为1,起点大于终点)
print(data[1:3:-1])   # 输出: [](step为-1,起点小于终点)
print(data[100:200])  # 输出: [](越界容错)
2. 切片的宽容性与严格性对比
为了让区分更加直观,可以将切片各个参数在异常机制上的态度进行对比:
| 切片参数 | 异常场景举例 | Python 处理策略 | 最终运行表现 |
|---|---|---|---|
| start / stop 越界 | data[100:200] |
自动规范化(Clamp)至序列有效边界 [0, len] | 返回空容器 [],不报错 |
| start 与 stop 倒置 | data[4:2:1] |
循环判断初始即不满足终止条件 | 返回空容器 [],不报错 |
| step 设为 0 | data[::0] |
语义非法,底层拒绝执行 | 抛出 ValueError 终止程序 |
| step 为非整数类型 | data[::1.5] |
类型不兼容(切片步进必须为整数) | 抛出 TypeError 终止程序 |
四、工程实战:动态步长场景下的防御策略
在日常开发中,很少有人会显式写出 data[::0] 这样荒谬的硬编码。但在处理动态步长(例如按缩放比例抽取数据、分页步进计算、用户自定义采样率)时,步长变量由外部传入或算式计算生成,极容易在特定边界条件下算出 step = 0。
step = total // target_samples 计算采样间隔时,当 total < target_samples 时整除结果恰好为 0,随后直接传入切片就会引发线上程序崩溃。
安全防御方案一:显式边界截断与保底值
在将计算出的变量传入切片前,使用条件表达式或默认保底值,确保步长绝对不为0:
def safe_sample(data_list, raw_step):
    # 避免 raw_step 为 0 导致切片直接抛出异常
    step = raw_step if raw_step != 0 else 1
    return data_list[::step]
安全防御方案二:根据业务逻辑明确拦截
如果业务本身要求“步长为0代表无需抽取”,应当在进入切片语法前主动返回空集合,而不是等待解释器报错:
def fetch_window(items, start, stop, step):
    if step == 0:
        # 业务上定义为无位移则返回空结果
        return []
    return items[start:stop:step]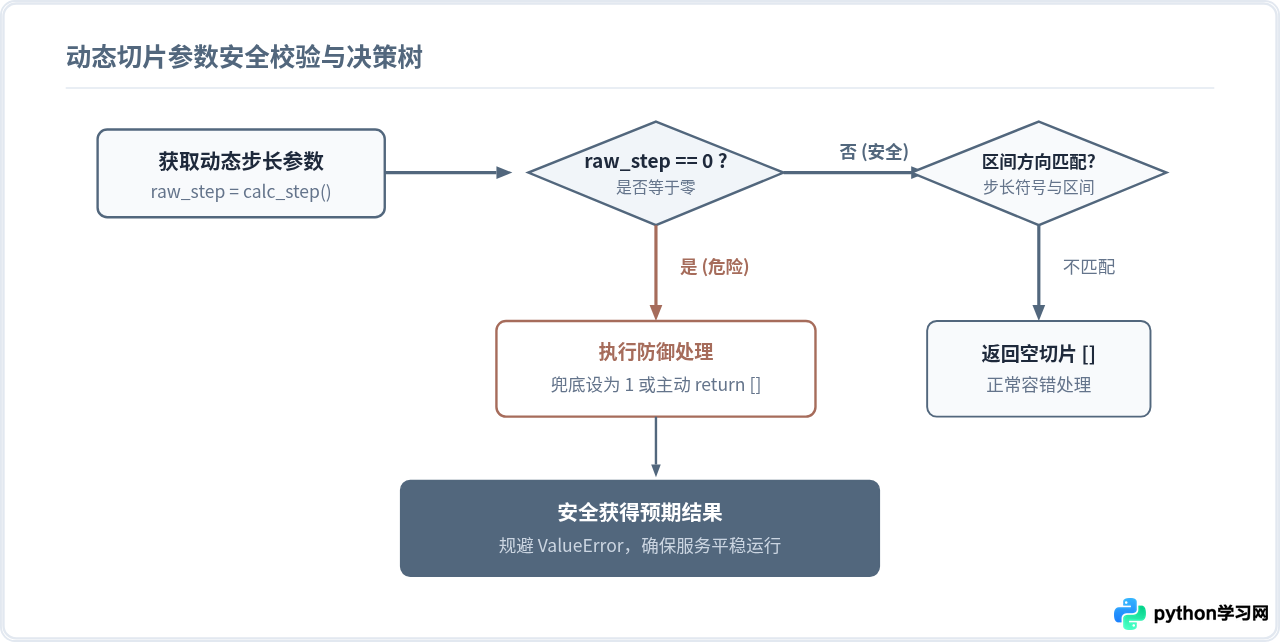
五、全文总结
回顾本文的核心问题与分析:
- 确定报错:Python 切片步长设为 0 绝对不会返回空序列,而是必定触发
ValueError: slice step cannot be zero。 - 设计原因:步长为 0 在数学上导致指针无法移动且切片长度公式分母为零,属于无明确语义的逻辑悖论,Python 底层选择显式中断而非盲目妥协。
- 误区根源:切片只对起始索引(
start)与终止索引(stop)具备越界自动规范化的宽容特性;对步长(step)的非零约束则是绝对严格的。 - 防范建议:在依赖计算产生动态步长的业务逻辑中,务必加入
step != 0的判断或兜底赋初值逻辑,避免线上发生不可控的崩溃。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















