


Python sklearn预测模型报错ValueError怎么解决?

model.predict())或拟合训练(model.fit())时,ValueError 是最常见的异常类型。与语法错误不同,ValueError 表明函数接口本身没有写错,但传入数据的“形状(Shape)”、“数值有效性(NaN/Inf)”、“数据类型(Dtype)”或“特征列名与数量”违反了估算器的输入规范。本文从报错信息的快速定位入手,系统拆解四类高频场景的发生根因与修复代码,并给出规范的防御性校验方案。
一、报错快速定位:从 Traceback 中提取核心线索
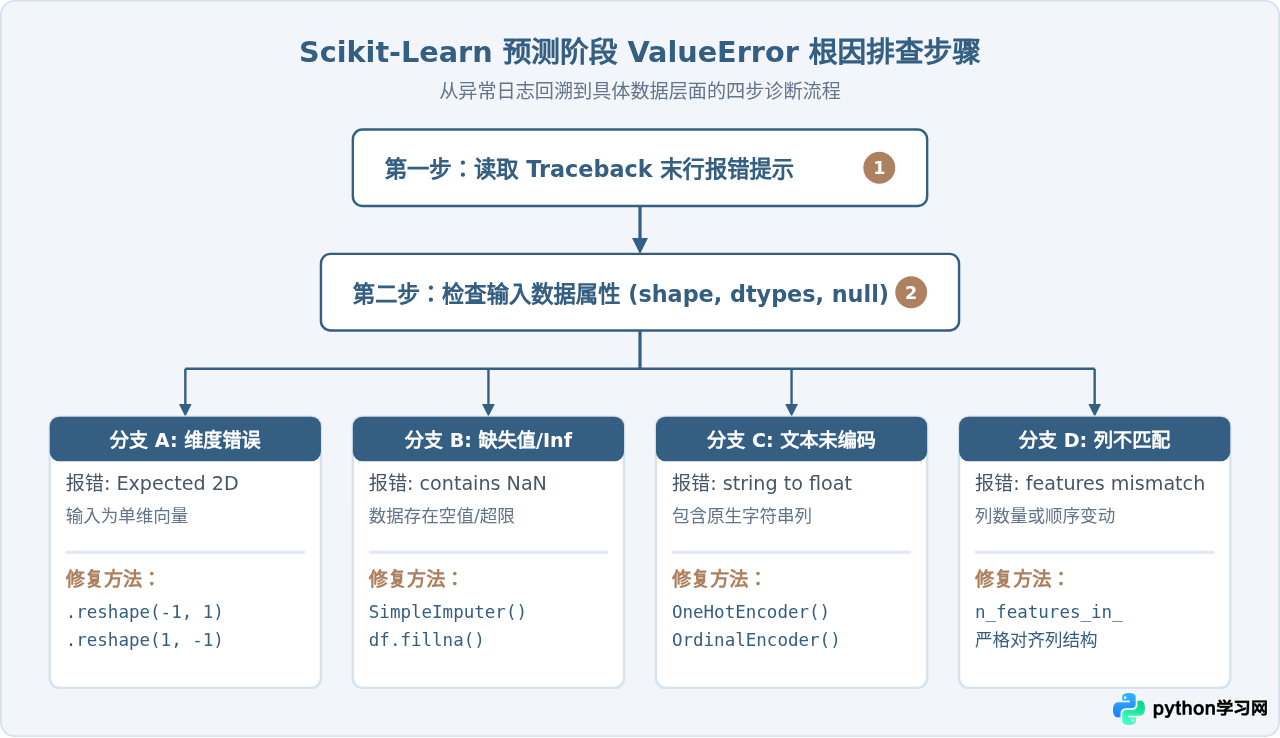
排查 sklearn 抛出的 ValueError,首先要跳过前段漫长库内部调用栈,直接查看报错信息的最后两行。根据最后一行提示文本,可以直接锁定问题所在的大类:
- 提示包含 “Expected 2D array, got 1D array instead”:数据维度不符,传入了一维向量而不是二维特征矩阵。
- 提示包含 “Input contains NaN, infinity or a value too large for dtype”:数据集中混入了缺失值(
NaN)、无穷大值(np.inf)或数值超出浮点数表示范围。 - 提示包含 “could not convert string to float”:输入特征中存在字符串类型的非数值列,且未被正确编码。
- 提示包含 “X has N features, but Estimator is expecting M features”:预测时输入的特征列数量与模型在
fit阶段训练的特征数量不一致。
二、场景一:维度不匹配(Expected 2D array, got 1D array)
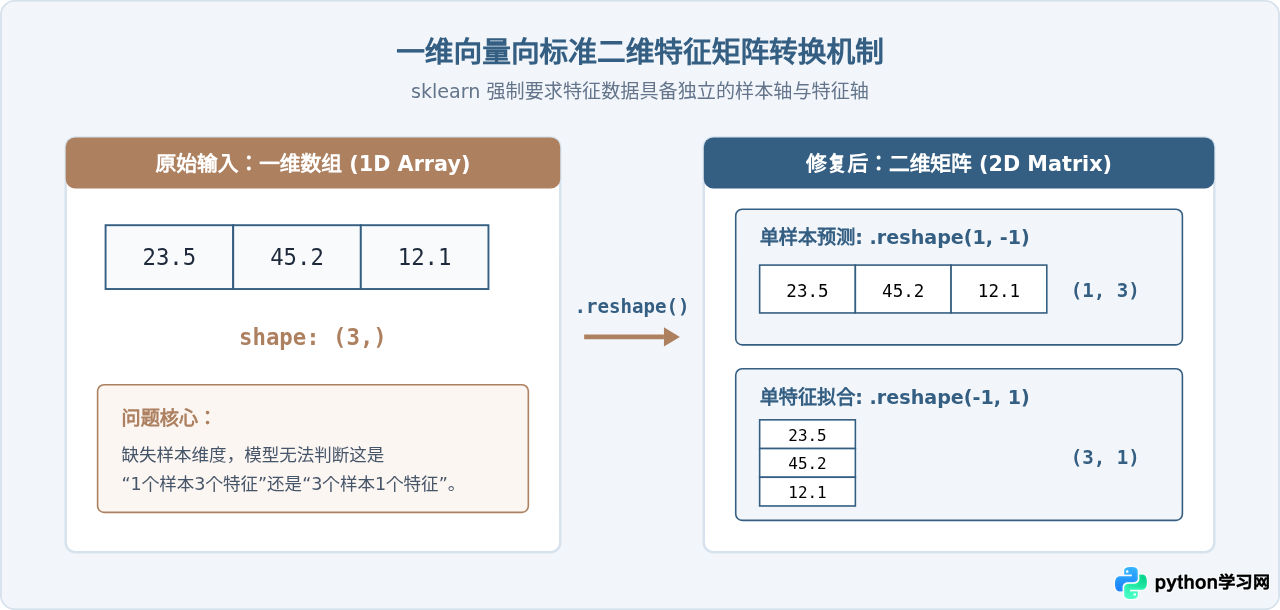
这是单条数据预测或单个特征拟合时最为常见的错误。sklearn 要求所有用于特征训练和预测的输入矩阵必须严格满足二维形状 (n_samples, n_features)。即使只预测单个样本,也必须以 (1, n_features) 的形式传入;即使数据只有单一特征,也必须以 (n_samples, 1) 的形式传入。
1. 典型报错示例
ValueError: Expected 2D array, got 1D array instead:
array=[23.5, 45.2, 12.1].
Reshape your data either using array.reshape(-1, 1) if your data has a single feature
or array.reshape(1, -1) if it contains a single sample.
2. 转换规则与原理
在 NumPy 中,一维数组的 shape 为 (N,),其只有一个轴,既没有明确的行(样本),也没有明确的列(特征)。必须通过明确的切片或 reshape 操作升维:
- 单个样本包含多个特征进行预测:使用
X.reshape(1, -1)。例如原本长度为 3 的数组(3,),转换后变为(1, 3),表示“1 个样本,具有 3 个特征”。 - 单特征多个样本进行拟合/预测:使用
X.reshape(-1, 1)。原本长度为 3 的数组转换后变为(3, 1),表示“3 个样本,每个样本各 1 个特征”。 - 从 Pandas DataFrame 中提取单列:如果使用
df['feature_name']会返回 Series(一维);应使用双层中括号df[['feature_name']]直接返回保持二维结构的 DataFrame。
3. 可运行的修复代码
import numpy as np
from sklearn.linear_model import LinearRegression

# 模拟一个训练完成的模型(假设模型训练时有 3 个特征)
X_train = np.array([[10, 20, 30], [15, 25, 35], [12, 22, 32]])
y_train = np.array([100, 150, 120])
model = LinearRegression().fit(X_train, y_train)

# 待预测的单条测试样本(原生为一维数组)
new_sample = np.array([14, 21, 31])

# 错误调用方式:直接传入一维数组将报错 ValueError
# model.predict(new_sample)

# 正确调用方式:使用 reshape(1, -1) 将其升维至 (1, 3)
new_sample_2d = new_sample.reshape(1, -1)
prediction = model.predict(new_sample_2d)

print("样本转换后形状:", new_sample_2d.shape)  # 输出: (1, 3)
print("模型预测结果:", prediction)             # 正常输出预测值
三、场景二:输入包含缺失值或非数值类型
大多数底层基于 C/Fortran 编写的经典机器学习算法(如线性模型、SVM、KNN 等)在计算距离或矩阵乘法时,不支持直接跳过缺失值,也不支持原生字符串。如果在 predict 阶段的数据集含有 np.nan、空字符或字符串分类字段,sklearn 会直接中断并抛出 ValueError。
1. 典型报错示例
# 缺失值或无效数值报错
ValueError: Input contains NaN, infinity or a value too large for dtype('float64').

# 字符串未编码报错
ValueError: could not convert string to float: 'East'
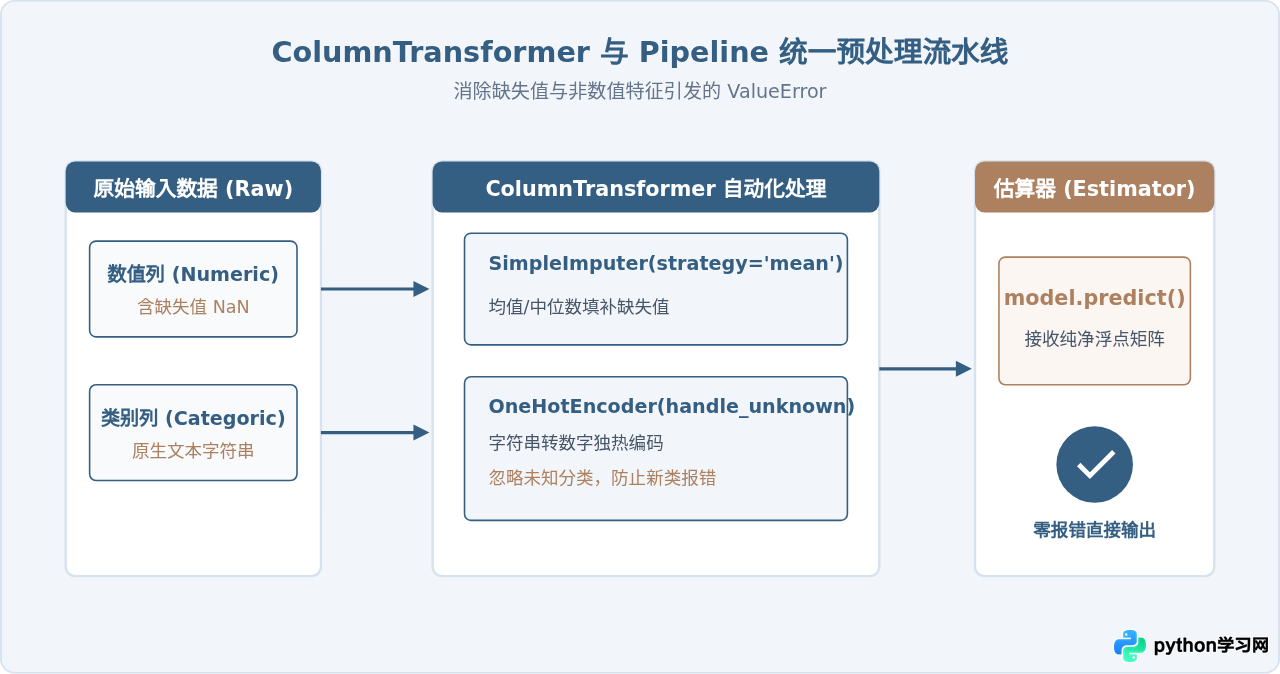
2. 修复方案:ColumnTransformer 与 Pipeline 固化预处理
针对此类问题,最稳健的做法不是在调用 predict 前手动执行临时修补,而是使用 sklearn.compose.ColumnTransformer 与 sklearn.pipeline.Pipeline 将特征清洗、转换与模型预测打包为一个整体对象。这能保证训练与预测时执行完全相同的填补策略与编码映射。
3. 可运行的修复代码
import pandas as pd
import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder
from sklearn.ensemble import RandomForestClassifier

# 1. 构造带有缺失值与分类字段的训练数据
train_df = pd.DataFrame({
    'age': [25.0, np.nan, 45.0, 32.0],
    'income': [50000.0, 60000.0, np.nan, 80000.0],
    'city': ['Beijing', 'Shanghai', 'Shenzhen', 'Beijing']
})
y_train = np.array([0, 1, 1, 0])

# 2. 定义特征子集
numeric_features = ['age', 'income']
categorical_features = ['city']

# 3. 构建数值分支与类别分支处理流程
numeric_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median'))
])

categorical_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='most_frequent')),
    ('onehot', OneHotEncoder(handle_unknown='ignore'))  # 关键:忽略未见过的类别
])

# 4. 合并为 ColumnTransformer
preprocessor = ColumnTransformer(
    transformers=[
        ('num', numeric_transformer, numeric_features),
        ('cat', categorical_transformer, categorical_features)
    ]
)

# 5. 绑定为整体 Pipeline
clf_pipeline = Pipeline(steps=[
    ('preprocessor', preprocessor),
    ('classifier', RandomForestClassifier(random_state=42))
])

# 拟合训练
clf_pipeline.fit(train_df, y_train)

# 6. 测试预测数据:同时存在缺失值以及未出现过的新城市
test_df = pd.DataFrame({
    'age': [np.nan],             # 缺失
    'income': [72000.0],
    'city': ['Guangzhou']        # 训练集未见过的类别,通过 handle_unknown='ignore' 安全兜底
})

# 无需手动转换,直接预测,内部自动清洗对齐
predictions = clf_pipeline.predict(test_df)
print("Pipeline 预测结果:", predictions)
四、场景三:特征数量或列名称不匹配
自 scikit-learn 1.0 版本开始,所有内置估算器在执行 fit 时都会自动记录两个内部属性:
model.n_features_in_:训练时输入的总特征数(整数)。model.feature_names_in_:当输入为 Pandas DataFrame 时,记录所有特征列的名称及严格顺序。
如果在调用 predict(X_test) 时,X_test 的特征列总数与 n_features_in_ 不符,或者列名次序被打乱,就会立即抛出 ValueError。
1. 典型报错示例
# 特征数量不符
ValueError: X has 4 features, but RandomForestClassifier is expecting 5 features as input.

# 列名或列顺序不匹配
ValueError: The feature names should match those that were passed during fit.
Feature names unseen at fit time:
- col_x
Feature names seen at fit time, yet now missing:
- col_a
2. 原因与解决方案
产生该错误的主要场景有两个:
- 独立对测试集执行了
pd.get_dummies:如果测试集缺少某个分类项,get_dummies生成的列数就会比训练集少,破坏了特征维度。解决办法是改用上文提到的OneHotEncoder并在测试集上只调用transform,绝不能调用fit或fit_transform。 - 生产环境接口参数传漏或字段排序变动:接收到的 JSON 数据解析为 DataFrame 时列顺序发生了变化。
在传入模型之前,必须按照模型的 feature_names_in_ 强制对其进行列对齐:
# 校验与列对齐范例
def safe_predict(model, input_df):
    # 1. 检查是否存在缺失列
    expected_cols = list(model.feature_names_in_)
    missing_cols = [c for c in expected_cols if c not in input_df.columns]
    if missing_cols:
        raise ValueError(f"输入数据缺失训练时的关键列: {missing_cols}")

    # 2. 严格按照训练时的列顺序重排 DataFrame,并丢弃冗余外部列
    aligned_df = input_df[expected_cols]

    # 3. 执行预测
    return model.predict(aligned_df)
五、防御性编程与生产环境校验清单
为彻底避免在上线服务或批量预测脚本中遭遇非预期的 ValueError,应在预测函数入口处加入防御性前置校验。以下清单涵盖了最核心的四道防线:
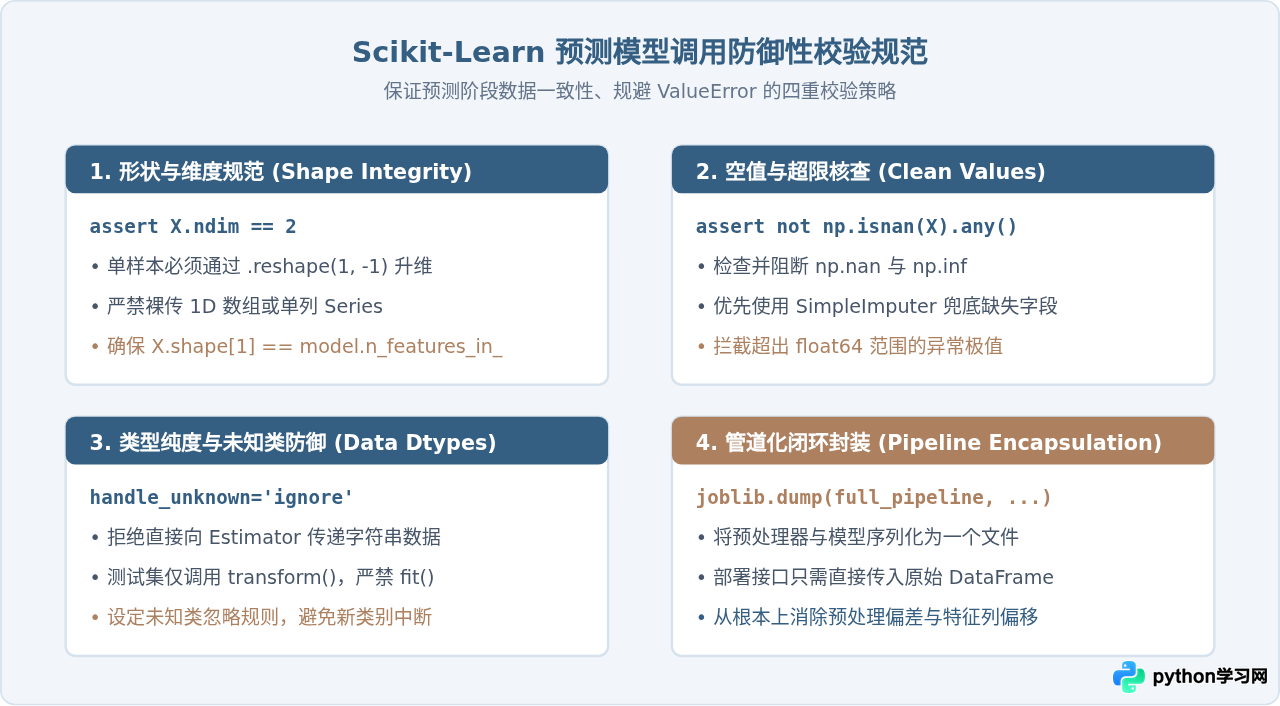
ValueError 最根本也是最高效的策略,是将数据预处理(包括缺失值填充、离群值处理、分类特征编码、标准化)与估算器通过 Pipeline 打包保存。在预测阶段,直接将原生输入送入 pipeline.predict(),避免任何零散的外部手动转换,从而彻底杜绝维度不符与特征列丢失的问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















