


Python 3学习路线图:从基础语法到全栈开发的进阶路径
一份结构化、面向实际工程落地的 Python 3 全栈开发进阶指南。从核心语法、面向对象与工程规范,到后端 API、数据库 ORM,再到前端协作联调与容器化部署,提供清晰的阶段路径、架构图示与代码示例。
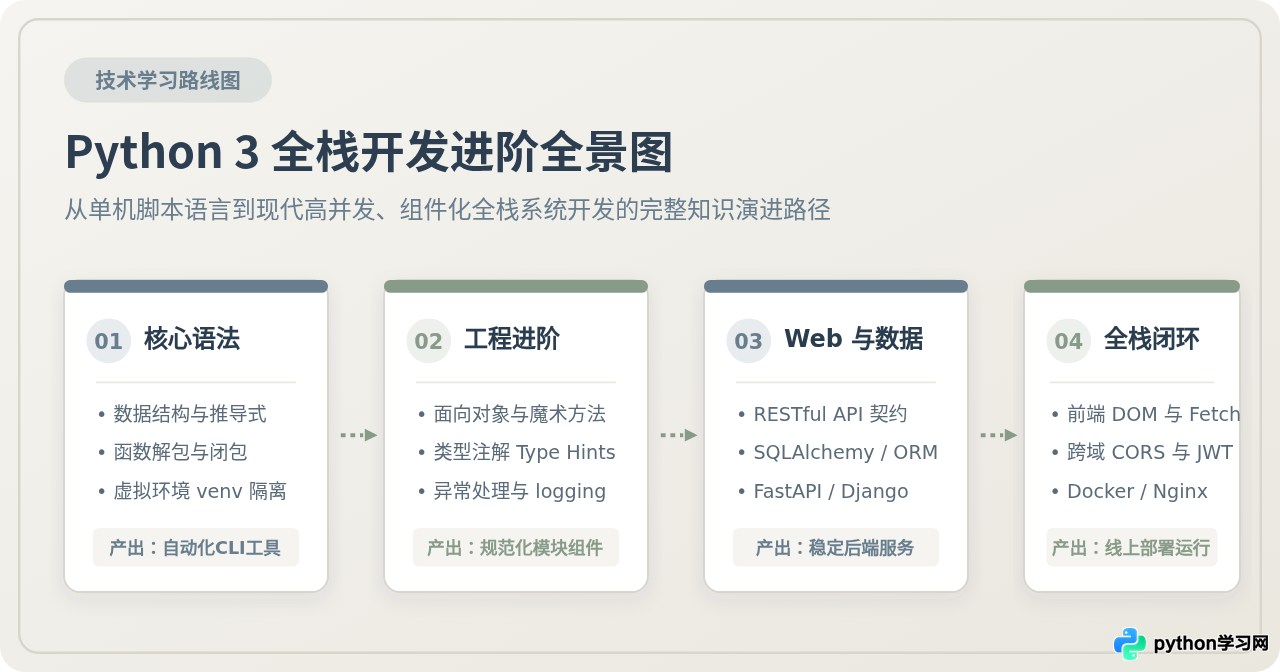
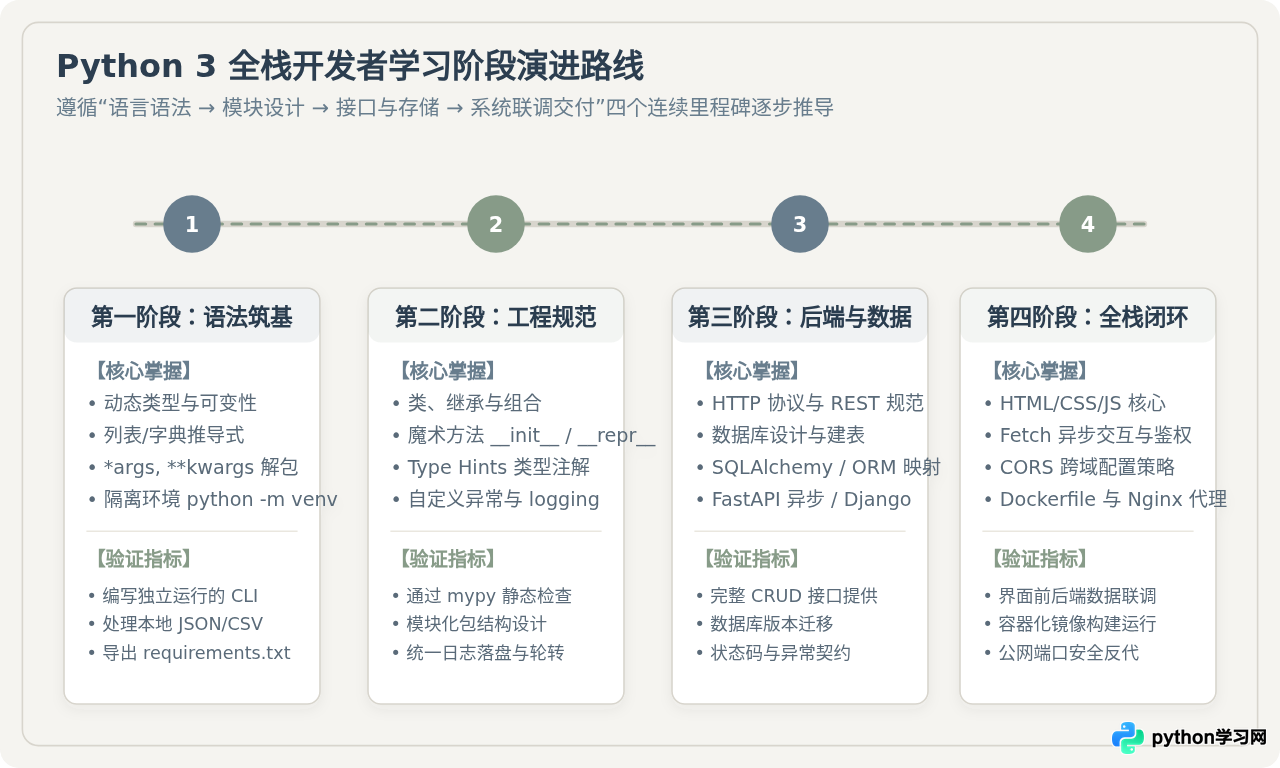
将 Python 3 作为主要开发语言并走向全栈开发,核心在于掌握从“单机语法与标准库应用”、“面向对象与工程化规范”,跨越到“后端 API 与数据库交互”,最终闭环至“前端协同联调与线上部署”的递进链条。本文按照这一演进顺序,梳理出四个由浅入深的阶段,提供明确的学习重点、验证项目与实践示例,帮助读者建立连贯清晰的全栈工程思维与落地能力。
一、阶段一:Python 3 核心语法与编程思维筑基
初学 Python 3 时,最常见的偏差是将时间过度消耗在简单的语法糖练习上,而忽视了底层数据模型和运行机制。全栈开发要求服务端程序不仅要“能跑通”,更要对内存占用、执行逻辑与环境隔离有清晰预期。
1. 掌握核心数据模型与可变性
在 Python 中,“一切皆对象”,变量本质上是指向对象内存地址的标签引用。区分可变对象(如 list、dict、set)与不可变对象(如 int、str、tuple)是规避绝大多数隐蔽 Bug 的基础。例如在函数传参或数据赋值时,如果不理解浅拷贝与引用的区别,极易在多人协作或数据处理过程中导致意外的原地修改。
熟练掌握列表推导式(List Comprehension)与字典推导式,不仅能让代码更加精炼,还能借助底层 C 实现获得更高的遍历效率;同时,掌握 *args 与 **kwargs 的解包传递机制,是后续理解 Web 框架路由装饰器和中间件包装的必备基石。
2. 建立虚拟环境与依赖隔离习惯
全栈工程开发严禁将第三方包全局安装到操作系统 Python 环境中。全局安装会导致不同项目间的库版本冲突,并破坏系统依赖。必须养成每一个项目独立创建虚拟环境的标准操作习惯。
在项目根目录下创建并激活虚拟环境的操作步骤如下:
# 1. 创建名为 .venv 的独立虚拟运行环境
python3 -m venv .venv

# 2. 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate
# Windows PowerShell 对应命令为: .\\.venv\\Scripts\\Activate.ps1

# 3. 升级当前虚拟环境内的 pip 并安装第三方依赖
python -m pip install --upgrade pip
pip install requests

# 4. 固化当前依赖清单至文本文件
pip freeze > requirements.txtargparse 解析终端参数,使用推导式过滤 JSON 或 CSV 文件内的非法数据行,并将清洗结果分类归档。若能在完全激活的虚拟环境中稳定运行且输出符合预期,即代表阶段一过关。
二、阶段二:面向对象编程与工程化进阶
当代码规模从几十行的单文件脚本扩展为包含多个功能模块的工程时,面向过程的写法会导致代码迅速失控。第二阶段的目标是借助面向对象(OOP)与模块化机制,将业务逻辑抽象为高内聚、低耦合的软件结构。
1. 深入面向对象与魔术方法
掌握类的封装、继承与多态,更重要的是理解 Python 的魔术方法(Magic Methods,亦称双下划线方法)。例如通过实现 __repr__ 获得清晰的调试字符串,通过 __eq__ 定义对象间的业务相等性判断,使用 @property 装饰器在不破坏外部接口调用的前提下封装属性计算与数据合法性校验。
2. 静态类型注解(Type Hints)与静态检查
现代 Python 3 已经全面拥抱类型标注体系。在函数签名中明确指定参数与返回值类型,不仅是最好的动态文档,更是后续使用 FastAPI 等现代框架进行自动化数据校验(Pydantic)的核心依赖。
from typing import Optional
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class UserProfile:
    def __init__(self, username: str, email: str, age: int, role: str = "member") -> None:
        if age < 0:
            raise ValueError("年龄不能为负数")
        self.username = username
        self.email = email
        self._age = age
        self.role = role

    @property
    def is_adult(self) -> bool:
        """根据年龄动态计算是否成年"""
        return self._age >= 18

    def __repr__(self) -> str:
        return f"<UserProfile username='{self.username}', role='{self.role}'>"

def register_user(username: str, email: str, age: int) -> Optional[UserProfile]:
    """带有明确类型标注的用户注册处理函数"""
    try:
        user = UserProfile(username=username, email=email, age=age)
        logging.info("用户创建成功: %s", user)
        return user
    except ValueError as err:
        logging.error("用户注册数据非法: %s", err)
return Noneprint() 打印调试信息是极不规范的做法。print 输出无法控制级别、缺失时间戳且缺乏上下文。应当使用标准库 logging,按 DEBUG、INFO、WARNING、ERROR 分级记录,为后续生产环境的错误排查提供清晰追踪。
三、阶段三:后端服务开发与数据持久化
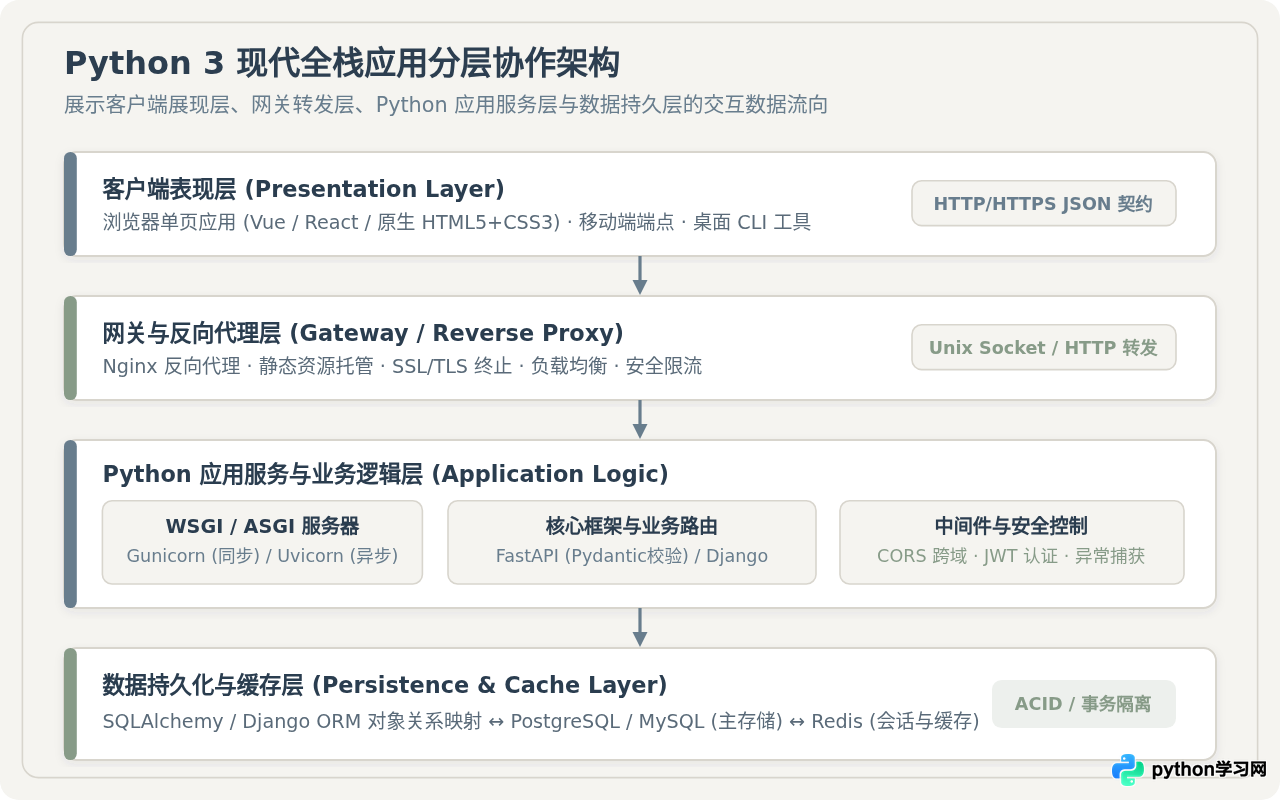
全栈开发的核心枢纽在于服务端。在这一阶段,开发者需要从单机本地逻辑转向网络环境,理解客户端与服务器之间的请求-响应生命周期,并掌握数据的结构化存储与检索。
1. 网络协议与 RESTful API 设计规范
Web 通信建立在 HTTP/HTTPS 协议之上。全栈开发者必须清晰理解 HTTP 请求方法(GET 读、POST 增、PUT/PATCH 改、DELETE 删)的语义边界,掌握常见状态码(200 OK、201 Created、400 Bad Request、401 Unauthorized、404 Not Found、500 Internal Server Error)的准确含义,并能输出格式规范的 JSON 接口契约。
2. 关系型数据库与 ORM 映射
生产级 Web 应用离不开关系型数据库(如 PostgreSQL 或 SQLite)。直接拼接原生 SQL 字符串不仅容易导致 SQL 注入漏洞,而且难以维护数据映射。使用对象关系映射(ORM,如 SQLAlchemy 2.0 或 Django ORM)能够以 Python 类来定义数据表结构,把数据行映射为实例对象。
需要特别注意 N+1 查询问题:在查询包含关联外键的数据集时,如果不采用 joinedload 或 selectinload 进行预加载,会导致数据库执行成百上千次额外的查询操作,造成接口延迟剧烈增加。
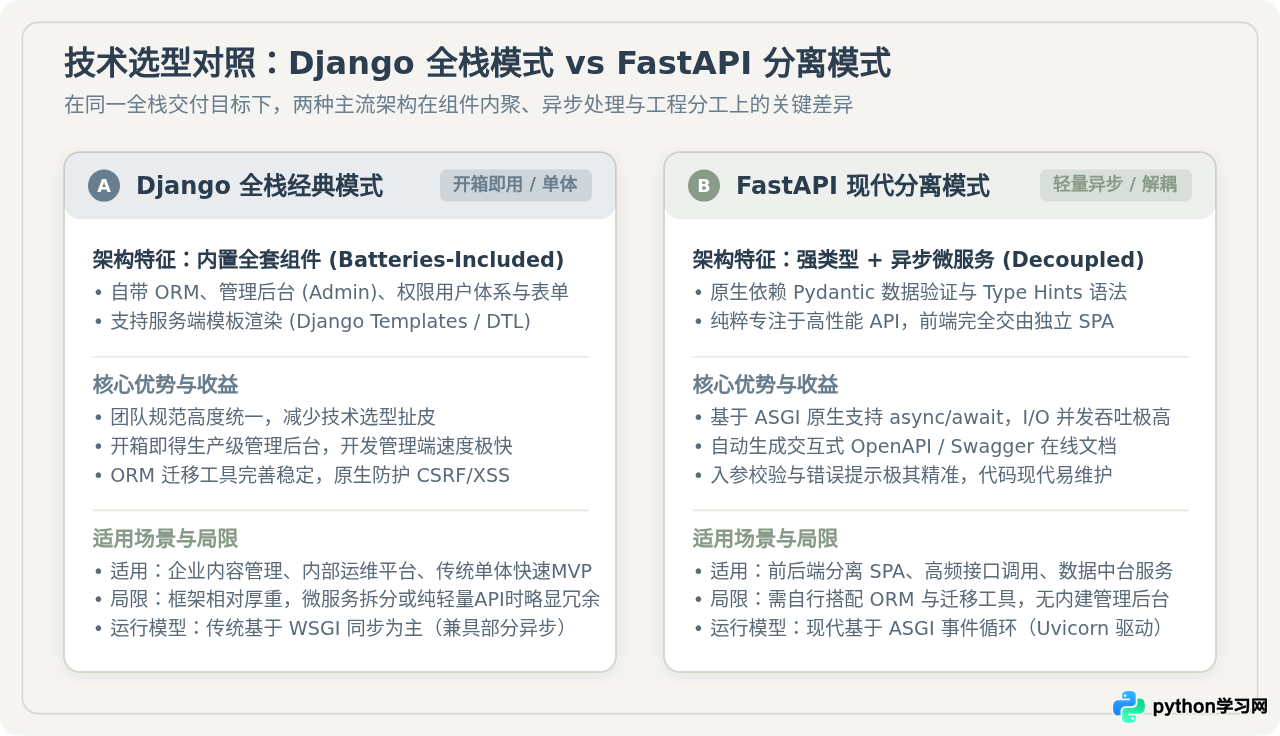
3. 架构选型深度对照:Django 全栈模式 vs FastAPI 分离模式
在 Python 后端生态中,Django 与 FastAPI 代表了两种不同的技术演进路线。很多初学者困惑于该选哪一个,关键在于理解两者在“组件集成度”与“运行模型”上的核心差异:
| 比较维度 | Django 全栈经典模式 | FastAPI 现代分离模式 |
|---|---|---|
| 核心理念 | Batteries-Included(开箱即用,自带全套组件) | Micro-Framework(聚焦于高性能 API 与解耦) |
| 运行机制 | 基于 WSGI 同步模型(兼具 ASGI 扩展) | 原生基于 ASGI 异步事件循环(uvloop + httptools) |
| 类型与校验 | Django Forms / Serializers (手动定义表单校验) | 原生结合 Python 3 Type Hints 与 Pydantic |
| 内建后台 | 自带极其完善的 Django Admin 管理后台 | 无内置后台,但自动生成交互式 OpenAPI/Swagger 文档 |
| 首选适用场景 | 企业后台管理系统、内容管理网站、需要快速成型的单体项目 | 现代前后端分离单页应用、移动端 API 服务、高吞吐微服务 |
为什么这一差异至关重要? 如果你的项目主要目标是快速构建带有复杂权限控制的企业内部管理系统,Django 的开箱即用(内建 Admin 与 ORM 迁移)能为你节省数周的前后端开发时间;但如果你面对的是现代前后端分离项目(前端使用 Vue/React),或者需要承受高并发 I/O 请求,FastAPI 原生支持的异步 async/await 与强类型校验将带来极佳的性能与开发体验。
4. 实践示例:基于 FastAPI 构建标准化异步 API
以下示例展示了使用 FastAPI 定义结构化入参、类型自动转换、以及错误处理的典型模式:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="任务管理服务", version="1.0.0")

class TaskCreate(BaseModel):
    title: str = Field(..., min_length=1, max_length=100, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")

class TaskResponse(TaskCreate):
    id: int
    completed: bool = False

# 模拟内存数据存储
fake_db = {}

@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskCreate):
    task_id = len(fake_db) + 1
    new_task = TaskResponse(id=task_id, **payload.model_dump())
    fake_db[task_id] = new_task
    return new_task

@app.get("/api/v1/tasks/{task_id}", response_model=TaskResponse)
async def get_task(task_id: int):
    if task_id not in fake_db:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail=f"任务 ID {task_id} 不存在"
        )
return fake_db[task_id]启动服务命令:uvicorn main:app --host 0.0.0.0 --port 8000 --reload。启动后访问 http://127.0.0.1:8000/docs 即可获得全自动生成的交互式 Swagger 文档。
四、阶段四:前端协作与全栈工程闭环
真正的“全栈开发”不要求在前端工程的每个细分领域(如复杂打包器底层优化)都达到专家水准,但必须具备完整实现页面结构、样式排版、异步数据联调与端到端交付的能力。
1. 前端基础与异步交互
开发者需要熟练掌握 HTML5 语义化标签、CSS3 Flexbox / Grid 响应式布局,以及现代 JavaScript(ES6+)语法特性(const/let、箭头函数、解构赋值、Promise 与 async/await)。
在前后端交互中,浏览器通过 fetch() 向 Python 后端发送异步网络请求,并将返回的 JSON 数据动态渲染到 DOM 树中:
// 前端发起异步数据请求并处理响应
async function fetchAndRenderTasks() {
  try {
    const response = await fetch('/api/v1/tasks', {
      method: 'GET',
      headers: {
        'Accept': 'application/json',
        'Authorization': 'Bearer ' + localStorage.getItem('token')
      }
    });

    if (!response.ok) {
      throw new Error(`HTTP 异常状态: ${response.status}`);
    }

    const tasks = await response.json();
    console.log("成功获取任务列表:", tasks);
  } catch (error) {
    console.error("数据联调失败:", error);
  }
}
2. 解决联调首要痛点:CORS 跨域资源共享
在前后端分离开发中,前端开发服务器(如 http://localhost:5173)与后端接口服务(如 http://localhost:8000)源不一致。当浏览器发起非简单请求时,会自动先发送一个 OPTIONS 预检请求。若后端未配置跨域允许头,浏览器会直接拦截响应并抛出 CORS 错误。
在 FastAPI 中,必须通过注册 CORSMiddleware 明确授权受信任的前端源:
from fastapi.middleware.cors import CORSMiddleware

# 明确列出受信任的前端域,严禁在包含 Cookie/Token 凭据时使用通配符 "*"
origins = [
    "http://localhost:5173",
    "https://myapp.example.com",
]

app.add_middleware(
    CORSMiddleware,
    allow_origins=origins,
    allow_credentials=True,
    allow_methods=["GET", "POST", "PUT", "DELETE", "OPTIONS"],
    allow_headers=["Authorization", "Content-Type"],
)
3. 生产部署与容器化上线
全栈开发的最后一步,是将整个系统稳定托管在生产服务器上。生产部署的标准链路通常包含:
- 应用进程守护:使用 Gunicorn 配合 Uvicorn worker 运行 Python 异步应用,自动管理多进程工作池;
- 反向代理与静态资源托管:Nginx 监听 80/443 端口,处理 SSL 证书加密,将静态资源直接分发,并将
/api/请求代理转发给 Python 应用; - 容器化编排:编写
Dockerfile封装应用环境,保证开发、测试与生产环境的一致性。
# 标准 Python 3 后端生产 Dockerfile
FROM python:3.11-slim

WORKDIR /app

# 先拷贝依赖文件并安装,利用 Docker 镜像缓存加速构建
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# 拷贝应用代码
COPY . .

# 生产环境以非 root 用户安全运行
RUN useradd -m appuser && chown -R appuser /app
USER appuser

EXPOSE 8000

# 使用生产级进程管理器启动应用
CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000", "--workers", "4"]
五、全栈进阶避坑指南与自测验收清单
在向全栈迈进的过程中,有几个常见的设计陷阱会反复困扰开发者。在实际开发中应当设立明确的检查红线:
- 陷阱一:默认参数使用可变对象。如
def append_item(val, container=[]),此container会在模块生命周期内共享状态,引发灾难性串数据。应当始终使用container: Optional[list] = None。 - 陷阱二:裸写异常捕获
except: pass。这会吞噬所有底层系统中断和意料之外的类型错误,使排查彻底陷入黑暗。必须精准捕获特定异常类并写入日志。 - 陷阱三:SQL 参数手动拼接。任何用户可控的输入均严禁使用
f"SELECT ... WHERE id = {user_input}",必须依赖 ORM 或参数化占位符。 - 陷阱四:在前端硬编码后端全路径。避免在 JS 中直接写
http://192.168.1.100:8000,应当使用环境变量(如import.meta.env.VITE_API_BASE)或配置前端构建代理。 - 陷阱五:生产环境开启 Debug 模式。Django 或 FastAPI 的
debug=True会将详细的环境变量、代码调用栈和数据库连接信息直接泄露在网页报错页面中,造成重大安全隐患。
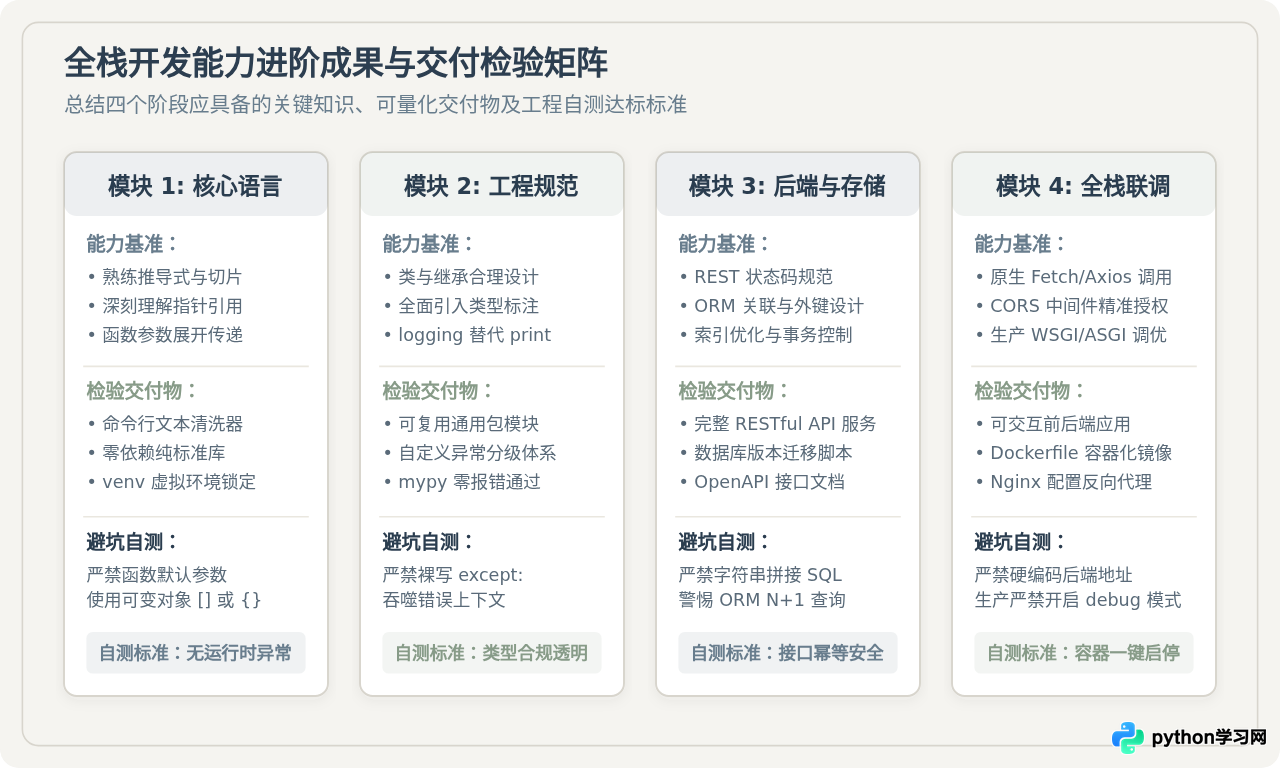
检验自己是否真正完成了全栈进阶,最可靠的方式是独立交付一个带持久化存储的小型端到端系统:
一个简单的备忘录或订单系统:用户通过浏览器界面填写表单并提交,前端通过异步 Fetch 携带认证凭据发送至 FastAPI/Django,后端通过 Pydantic/Serializer 进行严格参数校验,经由 ORM 安全写入 PostgreSQL 数据库,并在列表区即时无刷新更新状态。最后将整个工程通过 Docker Compose 一键启动运行。只要能独立走通这一完整闭环,就标志着你已成功跨入 Python 3 全栈开发之门。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















