


Python按字符串长度排序的方法
详细讲解Python中按字符串长度排序的方法,深入解析sorted()与list.sort()的key=len用法、底层单次计算机制与稳定排序特性,并介绍处理相同长度多条件排序与Unicode字节排序的实用技巧。
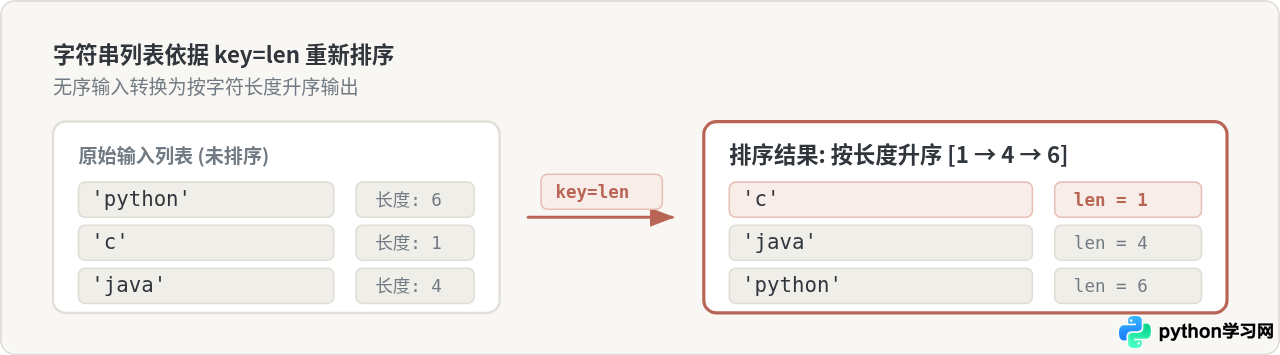
在 Python 中,按字符串长度排序最直接、标准的方法是使用内置函数 sorted() 或列表的 list.sort() 方法,并传入参数 key=len。Python 默认会对传入的字符串执行字典序比较,而一旦指定了 key=len,排序算法就会以每个字符串的实际字符数量作为比较凭据,从而实现由短到长(或结合 reverse=True 由长到短)的精准排列。
一、两种核心方法:sorted() 与 list.sort()
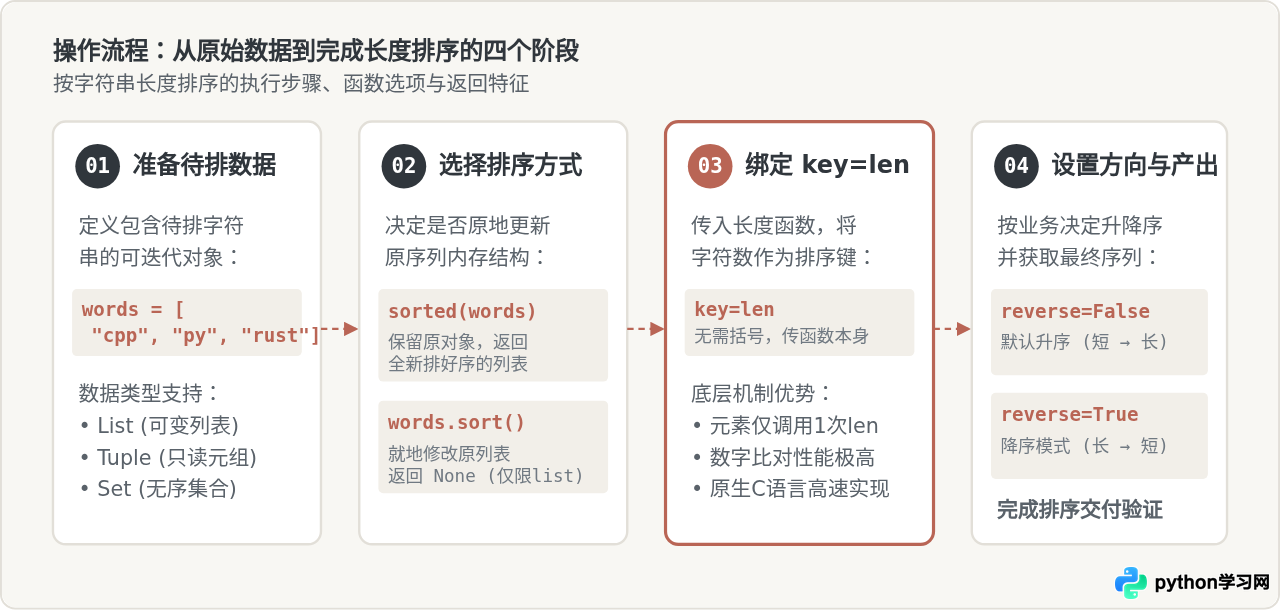
Python 提供了两个内置的排序入口。它们的共同点是均支持 key 参数,核心差异在于是否产生新对象以及对原数据类型的要求。
1. 使用 sorted() 函数生成新列表
sorted() 是 Python 的全局内置函数,它接收任意可迭代对象(列表、元组、集合等),在完成长度比对后返回一个全新的排好序的 list,原数据保持完全不变。
# 示例代码:使用 sorted() 进行长度升序与降序排序
words = ["python", "c", "javascript", "go", "rust"]

# 默认升序:由短到长
asc_result = sorted(words, key=len)

# 降序:由长到短
desc_result = sorted(words, key=len, reverse=True)

print("原列表:", words)
print("升序结果:", asc_result)
print("降序结果:", desc_result)升序结果: ['c', 'go', 'rust', 'python', 'javascript']
降序结果: ['javascript', 'python', 'rust', 'go', 'c']
2. 使用 list.sort() 方法就地修改列表
如果待排序的数据本身就是 list 类型,且业务逻辑不需要保留原有的元素排列顺序,可以直接调用列表自带的 .sort() 方法。此操作直接在列表原有内存地址上重新排布,避免了额外创建新列表的内存开销。需要特别注意:list.sort() 的返回值为 None。
# 示例代码:使用 list.sort() 就地修改
tech_stack = ["django", "flask", "fastapi", "tornado"]
tech_stack.sort(key=len)

print("原地排序后:", tech_stack)list.sort() 返回 None,切忌写出形如 words = words.sort(key=len) 的代码,这会导致 words 被意外赋值为 None。
二、底层工作原理:键值单次提取与排序稳定性
初学者常会担心:列表如果有上万个元素,每次两两比对都调用 len() 会不会造成性能浪费?深入理解 Python 的底层机制有助于消除这种顾虑。
1. 键函数(Key Function)的单次提取机制
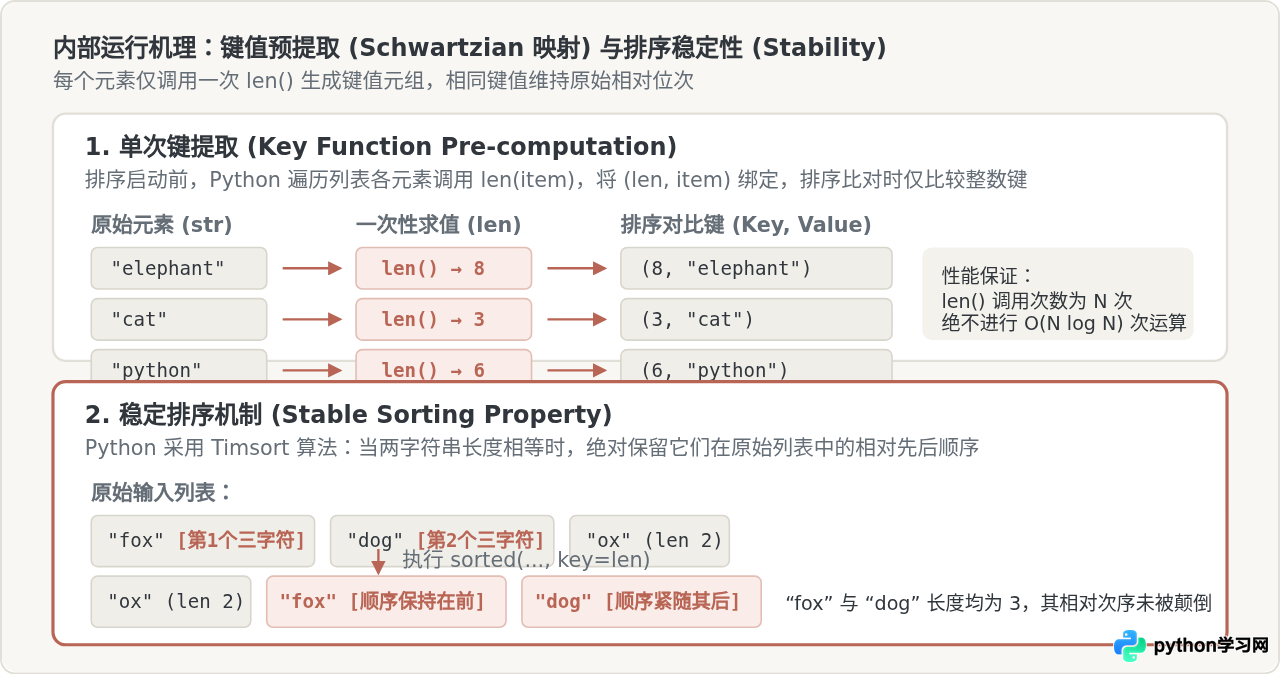
Python 采用类似 Schwartzian 变换的策略:在排序开始前,底层引擎会完整遍历一次列表,对每个元素调用一次 len(element),并将计算得到的整数长度与对应元素组合为内部键值对。随后的所有比较操作,实际上都是直接比对预先提取好的整数键(C 语言层面的数字比对),而不会重复触发 Python 层面的 len() 函数。因此,对于长度为 \(N\) 的列表,len() 仅被调用精确的 \(N\) 次。
2. Timsort 的稳定性保障
Python 标准实现采用高度优化的 Timsort 算法,该算法属于稳定排序(Stable Sort)。
所谓稳定性,指的是:当两个元素的键值(字符串长度)完全相同时,它们在排序后的结果中,将严格保留排序前出现的先后相对位次。例如在输入列表 ["fox", "dog"] 中,两者的长度均为 3。经过 key=len 升序排序后,"fox" 依然位于 "dog" 之前,绝对不会发生毫无规律的颠倒。
三、进阶场景:长度相同下的多条件(多级)排序
默认的稳定排序虽然能保留输入先后顺序,但在实际业务开发中,我们往往需要更明确的规则。例如:优先按长度由短到长排序;当遇到长度相同的字符串时,再按字母字典序升序排列。
1. 利用元组(Tuple)构建多级比较键
Python 原生支持元组之间的比较运算。元组比较遵循从左到右逐项对比的原则:只有当第一项相等时,才会比对第二项。因此,我们可以通过 lambda 表达式为每个字符串构造一个元组键 (len(s), s):
# 示例代码:长度相同时按字母升序排序
fruits = ["banana", "pear", "apple", "plum", "kiwi", "fig"]

# 先比长度 len(s),长度平局则比字符串字典序 s
result = sorted(fruits, key=lambda s: (len(s), s))

print("多条件升序:", result)
在上述结果中,长度为 4 的水果有 'kiwi', 'pear', 'plum'。由于启用了第二级字典序比较,它们严格按照首字母 k < pe < pl 排列。
2. 混合方向:长度降序 + 字母升序
若要求“越长的字符串排越前面,长度相同者按字母升序”,不能直接使用 reverse=True(这会导致第二级的字母序也被一并反转为降序)。正确做法是对元组中表示长度的数值取相反数:
# 示例代码:长度由长到短,平局按字母 A-Z 升序
mixed_result = sorted(fruits, key=lambda s: (-len(s), s))

print("混合方向排序:", mixed_result)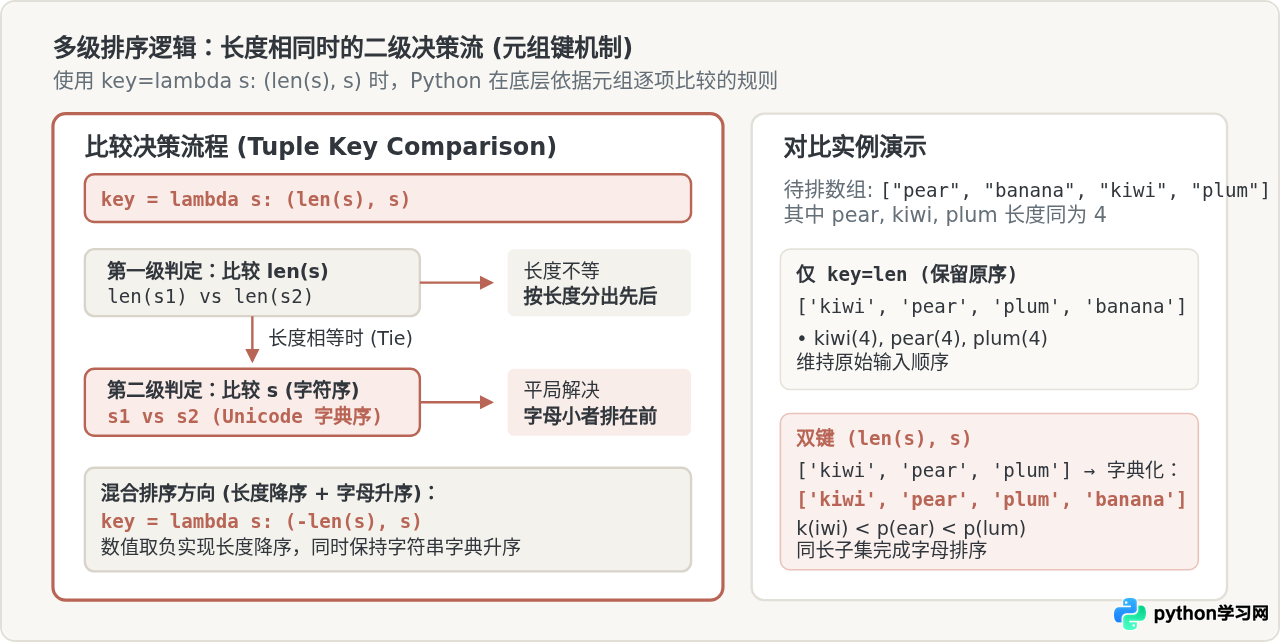
四、边界细节与实用注意事项
在生产环境中处理异构文本或多语言字符时,还需注意以下细节:
1. Unicode 字符与字节长度的差异
Python 3 中的 len("中国") 返回值为 2,因为 len() 计算的是 Unicode 字符(码点)的数量。如果需求是根据存储占用的 UTF-8 真实字节数进行排序,则需要先编码再求长:
# 示例代码:字符数 vs 字节数排序对比
mixed_words = ["a", "中", "ab", "中国"]

# 按字符数量排序 (len): 'a'(1), '中'(1), 'ab'(2), '中国'(2)
by_char = sorted(mixed_words, key=len)

# 按 UTF-8 字节数排序: 'a'(1B), 'ab'(2B), '中'(3B), '中国'(6B)
by_byte = sorted(mixed_words, key=lambda s: len(s.encode('utf-8')))

print("按字符数排序:", by_char)
print("按字节数排序:", by_byte)按字节数排序: ['a', 'ab', '中', '中国']
2. 空字符串与非字符串元素防御
- 空字符串
"":其len("")为 0。在升序排列时,空字符串总是稳居最前列;在降序排列时则退居最后。 - 类型一致性:
key=len仅适用于实现了__len__协议的对象(如str、list、bytes等)。如果列表中混杂了None或数字123,会直接抛出TypeError: object of type 'int' has no len()。在处理未清洗的数据时,建议先执行类型过滤或转换。
3. 性能优化建议
在只需要按长度单条件排序的常见场景下,直接传入内置函数 key=len 比使用 key=lambda s: len(s) 执行速度更快。因为直接传递内置函数名能够直接由底层的 C 扩展调用,规避了解析和执行额外 Python 匿名函数帧的字节码开销。
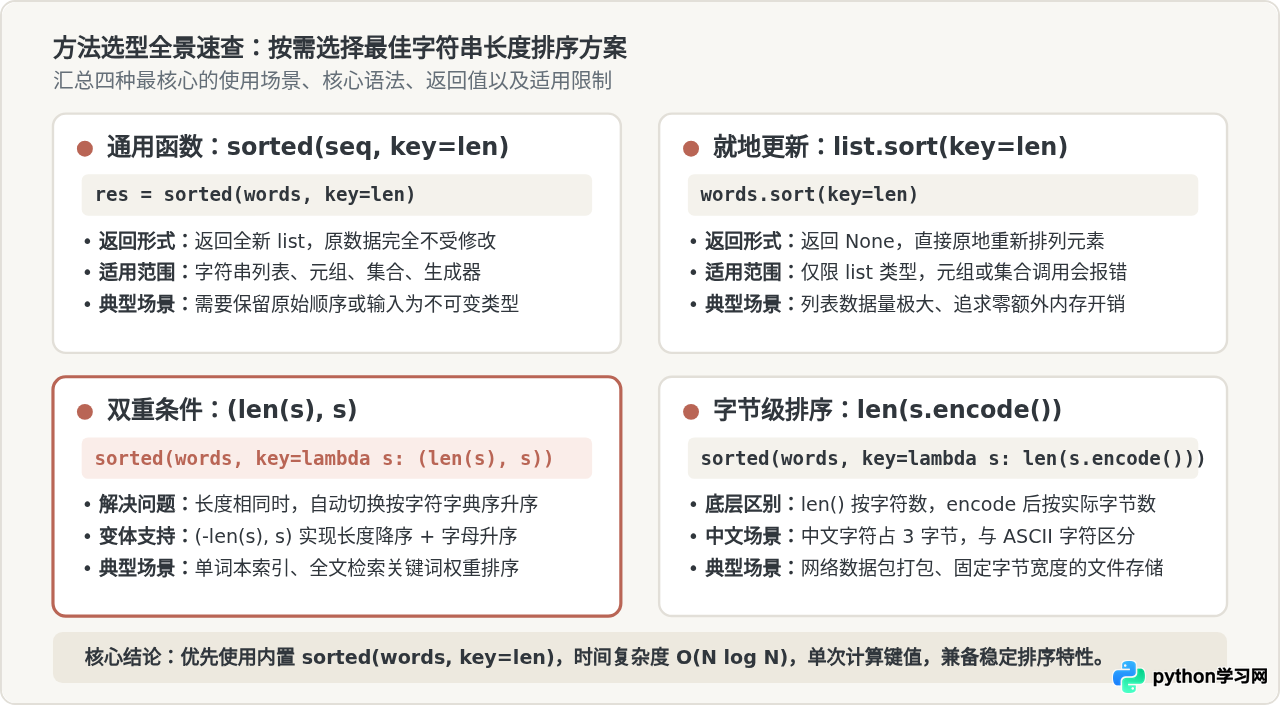
五、方法选型与速查总结
为方便日常开发时快速选取合适方案,下表总结了各类场景的技术选择依据:
| 需求场景 | 推荐写法 | 修改方式 | 返回值类型 |
|---|---|---|---|
| 需要保留原对象 / 通用可迭代对象 | sorted(seq, key=len) |
无副作用,生成新对象 | list |
| 超大列表 / 严格追求内存利用率 | list.sort(key=len) |
原地直接修改原列表 | None |
| 长度降序排列(由长到短) | sorted(seq, key=len, reverse=True) |
生成新列表或原地翻转 | list |
| 长度相同按字母升序二次排定 | sorted(seq, key=lambda s: (len(s), s)) |
元组二级决策机制 | list |
| 按网络传输 / 磁盘占用字节数排序 | sorted(seq, key=lambda s: len(s.encode())) |
基于真实编码字节计算 | list |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















